H3 -World 扩展跳跃与开门:新动作怎样进入训练数据?
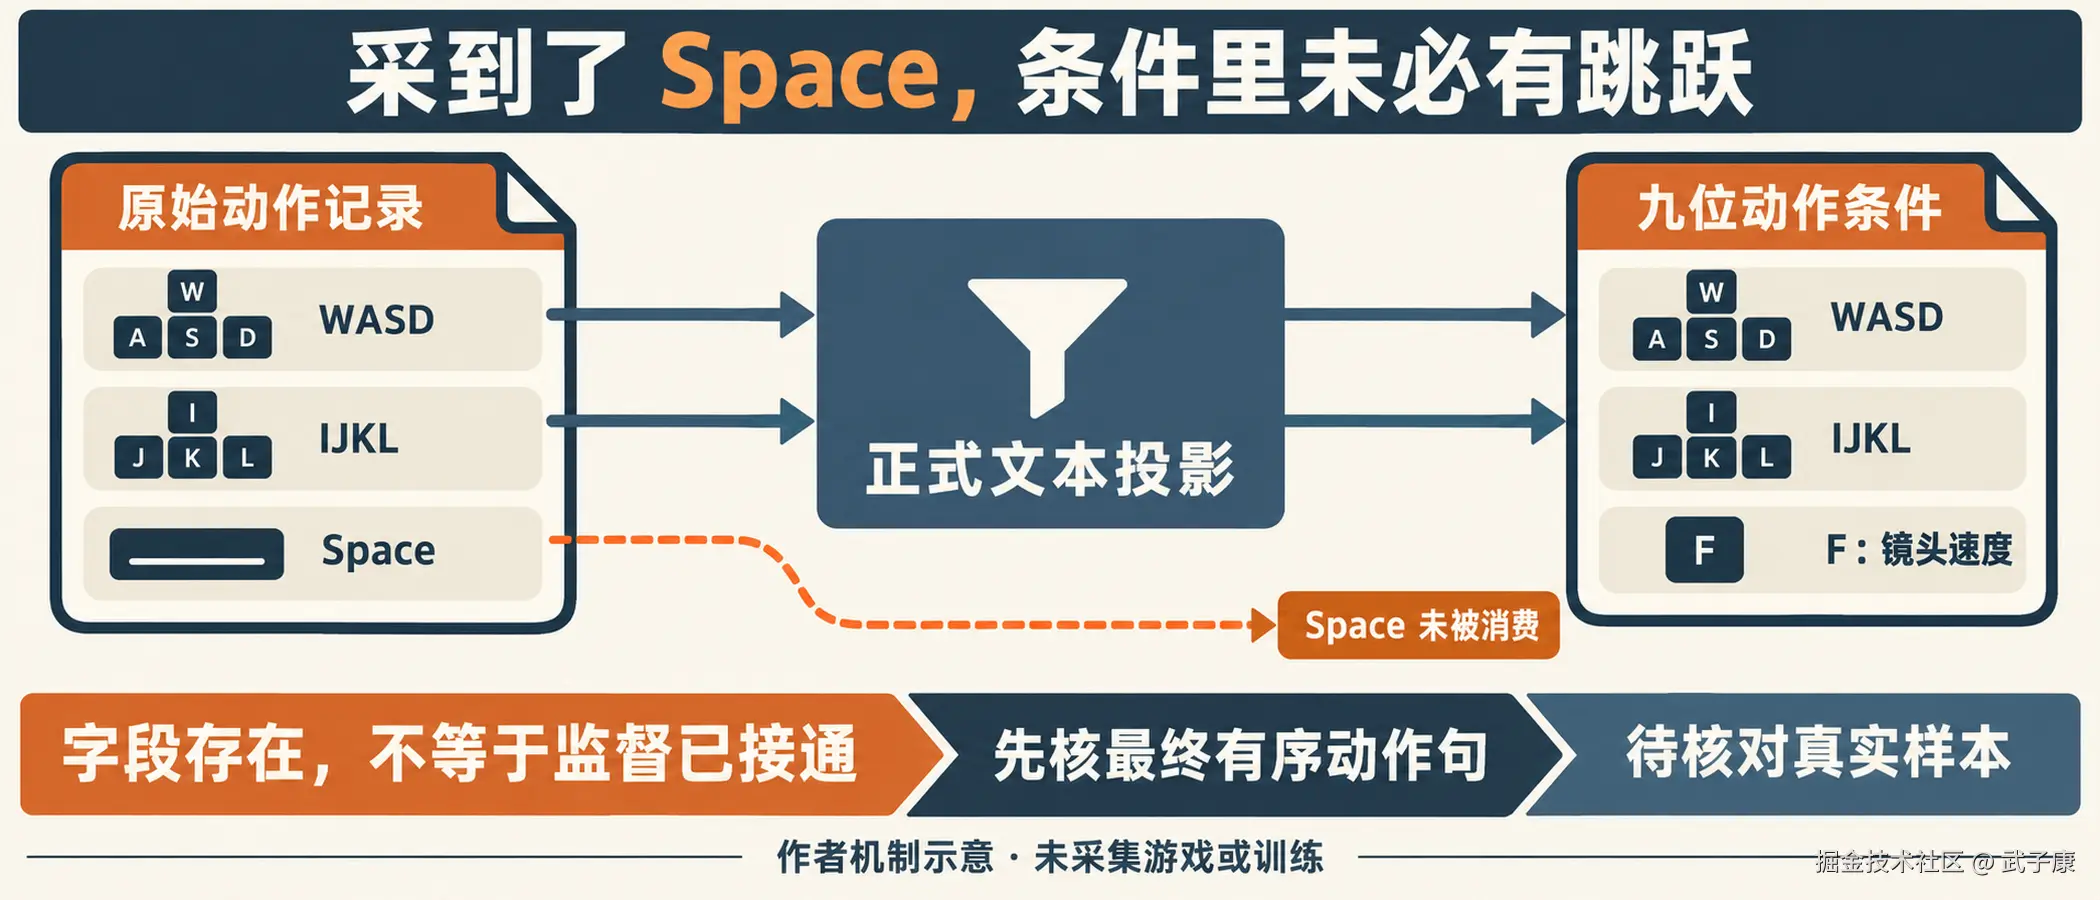
作者机制示意或待执行语义对齐安排;没有游戏、模型或训练实测。
你给自采集器加上了 Space 键,录到角色跳起,也在 提示词 里写了"the man jumps"。如果仍把这批数据交给原来的 H3-World 动作标注脚本,训练真的能看到这次跳跃吗?
固定官方源码中有一个很容易漏掉的细节:原始动作 矩阵 保留了 Space 列,但正式文本路径只选择 WASD、IJKL 八个键,再补一个表示快速转镜头的 F 位。Space 没有进入这九位。后面的移动词表也只有前后左右。于是,原始文件里存在一个字段,不等于它已经成为模型收到的动作条件。 你可能增加了视频和日志,却仍在用"角色静止、镜头不动"的条件训练跳跃画面。
这给自定义训练提出了比"换哪些 LoRA 参数"更靠前的问题:跳跃、开门和连续转镜头,各需要保留什么可观测信息,怎样确认它没有在数据转换中消失,最后又用什么结果判断模型学到的确实是要求的控制?
本文以 H3-World 官方提交 f0c7be2acbbde8256b2473f6e7b088f58272acae 为基线,核对日期为 2026 年 10 月 17 日。下面把源码事实与作者提出的扩展试验分开说明。没有采集游戏、运行模型或完成新增动作训练;文末记录是待执行方案,不能当成效果报告。
Space 列保留下来了,跳跃条件却没有跟着走
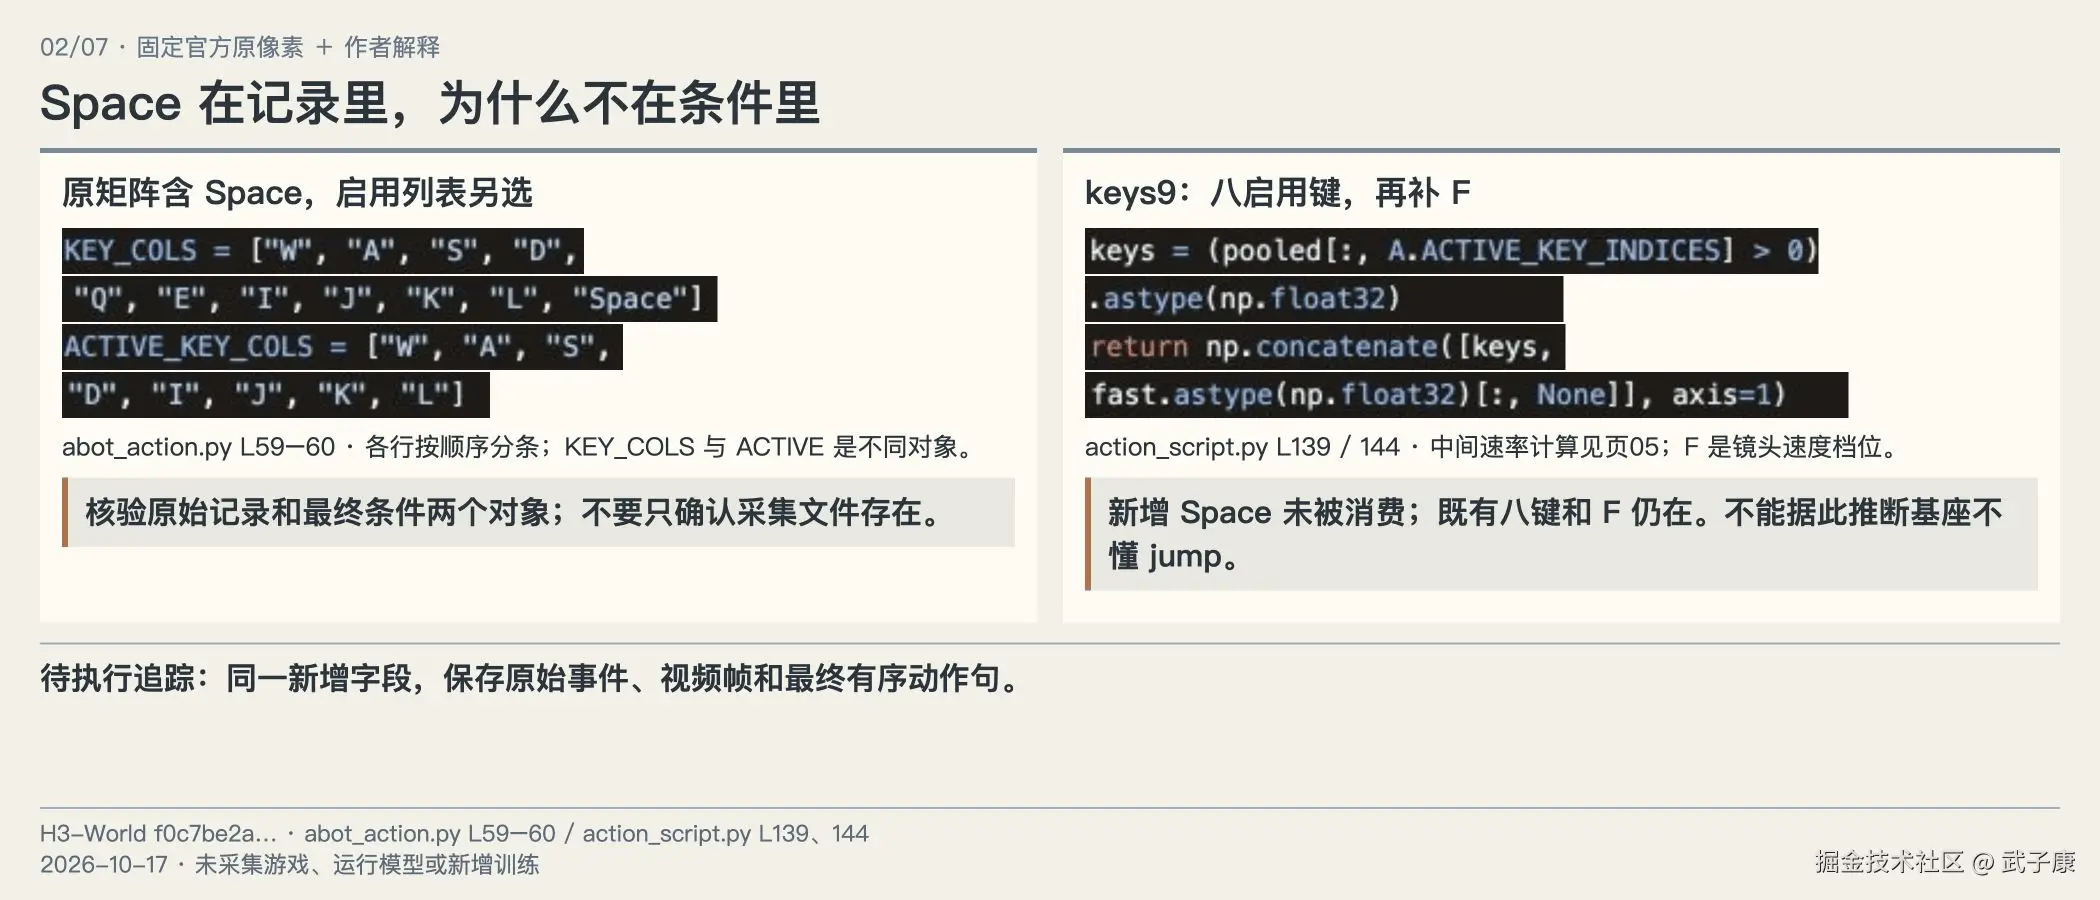
固定官方页面聚焦原像素;证明局部源码职责,不是游戏、模型或训练结果。
官方 abot_action.py 的原始键定义包含 Space,但启用列表是另一份对象:
python
KEY_COLS = ["W", "A", "S", "D", "Q", "E", "I", "J", "K", "L", "Space"]
ACTIVE_KEY_COLS = ["W", "A", "S", "D", "I", "J", "K", "L"]
原始矩阵还有旋转、平移通道。正式 action_script.py 的 keys9() 从启用列取八个键,再根据测得的转镜头速率生成 F 位;annotate_from_keys9() 才把这九位转成逐 latent 动作句。F 的含义是镜头转动速度档位,不是通用的第九个交互动作。固定动作通道定义和固定文本映射
从这段代码可以得出一个范围明确的判断:在这个正式九位动作标注路径里,仅改变原矩阵的 Space 列,不会让输出句子增加跳跃信息。不能据此说整个 H3 基座不懂"jump",也不能说任意自定义动作句都不能输入。 语言模型 和视频基座可能已有相关先验,但"能生成一次像跳跃的画面"与"按指定输入、时机和游戏条件稳定跳起"是不同的验证对象。
本次检查只读取固定代码,并抽取原始纯函数进行标准库验证,没有导入 NumPy、读取动作载荷或调用模型。向原移动与镜头词句函数提供全静止键值,分别附加 Space=False 与 Space=True,输出都是 the man stands still, camera holds steady。这个小例子证明的是所核对映射不会消费 Space,不能证明一批真实数据已经产生了多少错误标签。
官方源码中还写到 Q/E/Space 在作者的一个抽样中没有被按下。那是作者对有限样本的报告,不是本次重新统计,更不能推广为整个数据集没有跳跃。对新采集数据来说,真正需要检查的是同一条记录经过原始事件、帧索引、聚合动作和最终句子后还剩下什么。若新字段已经在映射里被丢弃,增加训练时长无法补回这项监督。
第一项改动因此应当很小:取一个有明确起跳事件的短段,保存原始按下与释放、相应视频帧,以及最终交给模型的有序动作句。确认这些句子真的表达了那次起跳,再考虑批量缓存与训练。这一步无需先改主干网络;如果现有语言条件足以表达离散事件,先把数据和标注接通,通常比同时新增多条分支更容易归因。
跳跃需要保留"发生一次",而不只是"某个窗口按过"
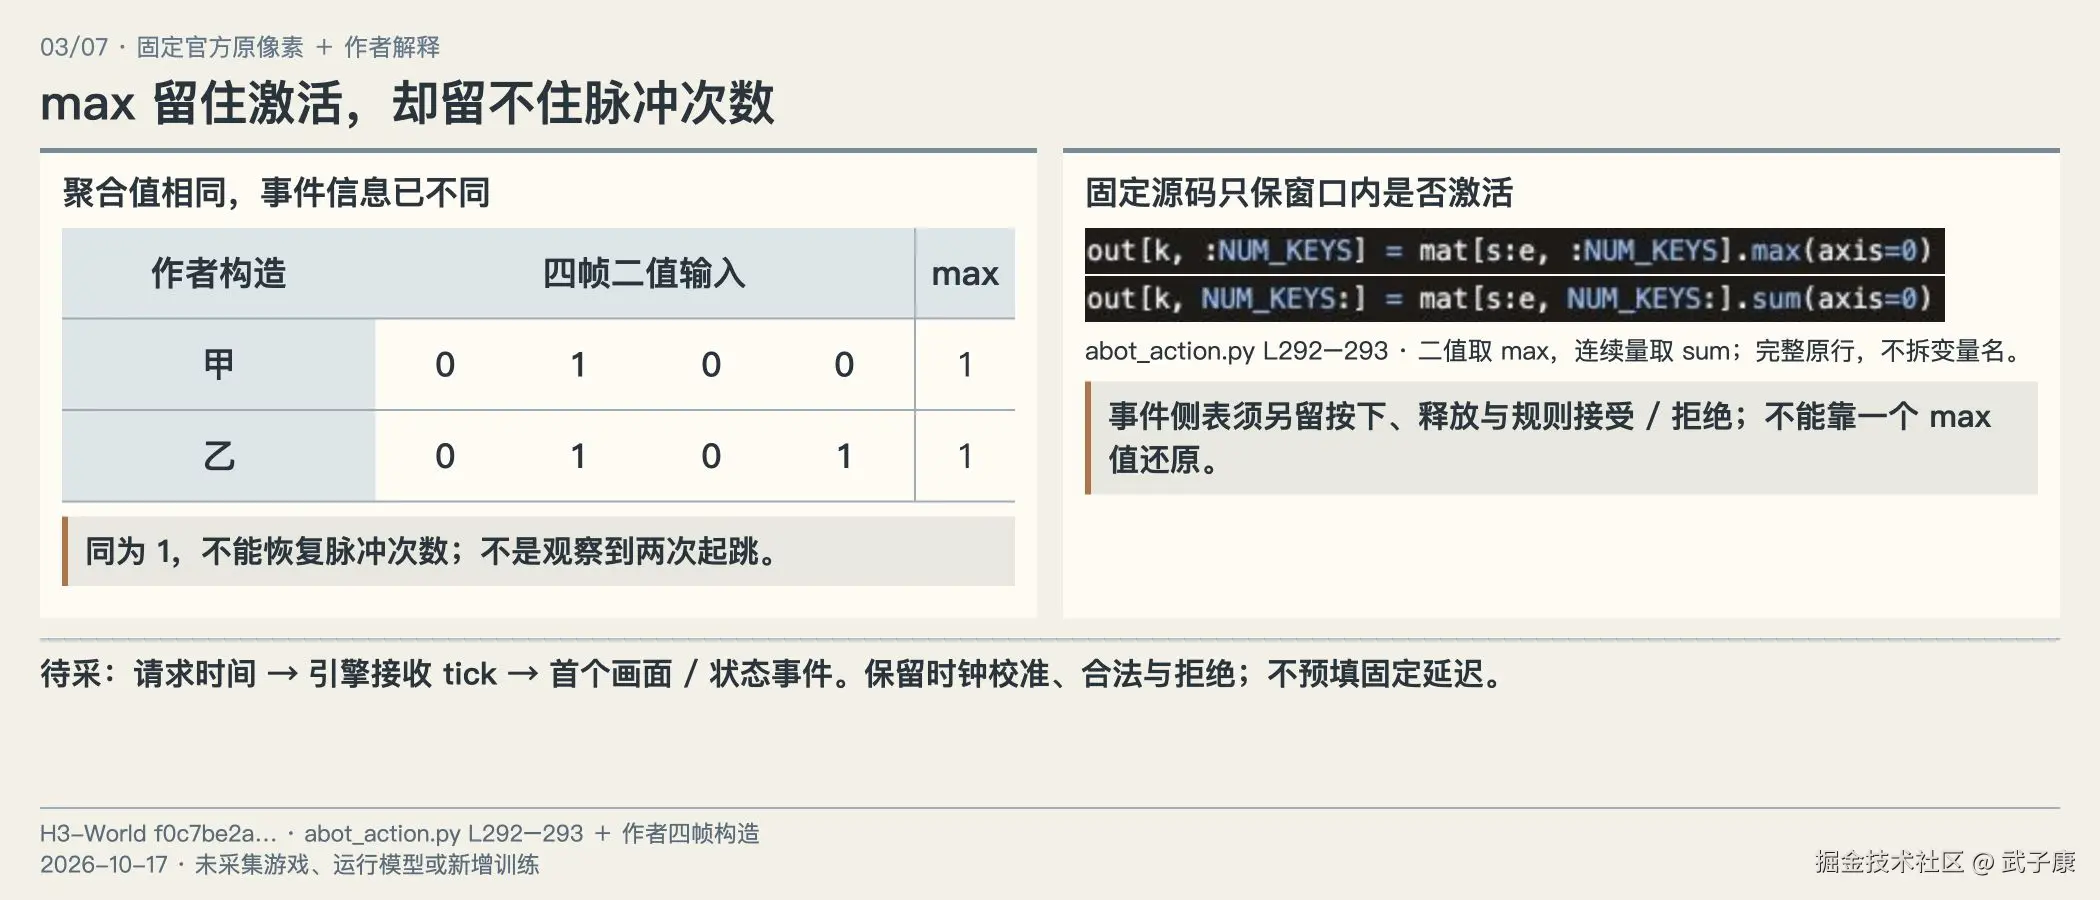
固定官方页面聚焦原像素;证明局部源码职责,不是游戏、模型或训练结果。
九位列表扩容以后,还会遇到第二个问题。现有动作聚合对二值按键取窗口最大值:窗口内按过就算激活。这个办法适合表达某时段是否有移动输入,但按下、持续和重复按下在事件型动作里可能含义不同。
以一个作者构造的四帧例子说明:[0, 1, 0, 0] 与 [0, 1, 0, 1] 的最大值都是 1,前者可能只有一次按下,后者可能有两次。这个例子没有使用真实游戏,也不暗示所有游戏都会按每个脉冲起跳;它说明单个二值聚合值已经无法恢复脉冲次数。若游戏有"按住连续跳""只在落地后再触发"或按住影响跳高等机制,需要先依据具体游戏定义条件,而不能把不同输入统一标成一句 jumps。
采集时应同时记录三类时间:请求何时发送,仿真在哪个 tick 接收,首个相应画面或状态何时出现。它们不一定同时发生。画面捕获时间也不一定等于模拟状态时间。用同一单调时钟记录可行的事件,并保存跨时钟对照;无法直接共享时钟时,留下校准方法与误差范围。不要把某台机器测到的平均偏移复制给另一台,也不要预填"固定延迟几帧"。
对跳跃,作者建议把一次试验的目标写得具体:在允许起跳的初态中发送一次触发,记录 jump_requested、引擎接受或拒绝、离地、落地,以及其间的输入保持状态。没有引擎状态时,可以用可复核的画面事件标注起跳与落地,但应把它叫视觉观察,不能称为物理状态真值。关键是保留失败或拒绝:角色在空中再次收到按键却没有起跳,可能是正确规则,不能自动作为漏动作标签删除。
模型收到的条件则由试验目标决定。若只测试"按一次产生一次可见起跳",可以先扩展逐时段语言句并保留事件侧表;若要控制按住时长与跳高,单个跳跃词可能不足,需要显式定义持续时间或强度如何进入条件。二者不应在同一个首次试验里混成一个"支持跳跃"的结论。
评价也需要对应这份定义:一次请求触发几次起跳,起跳相对引擎接受时间偏移多少,空中无效请求是否被正确处理,以及落地后第二次合法请求能否再次触发。时间容差应结合仿真 tick、可见事件标注误差和实际 latent 时间范围确定。H3 的时间分组不是每个 latent 都覆盖同样帧数,不能把所有动作窗口一律写成 166 毫秒,再据此判断训练对齐成功。原帧区间与二值聚合实现
开门把问题从事件推进到了目标与状态
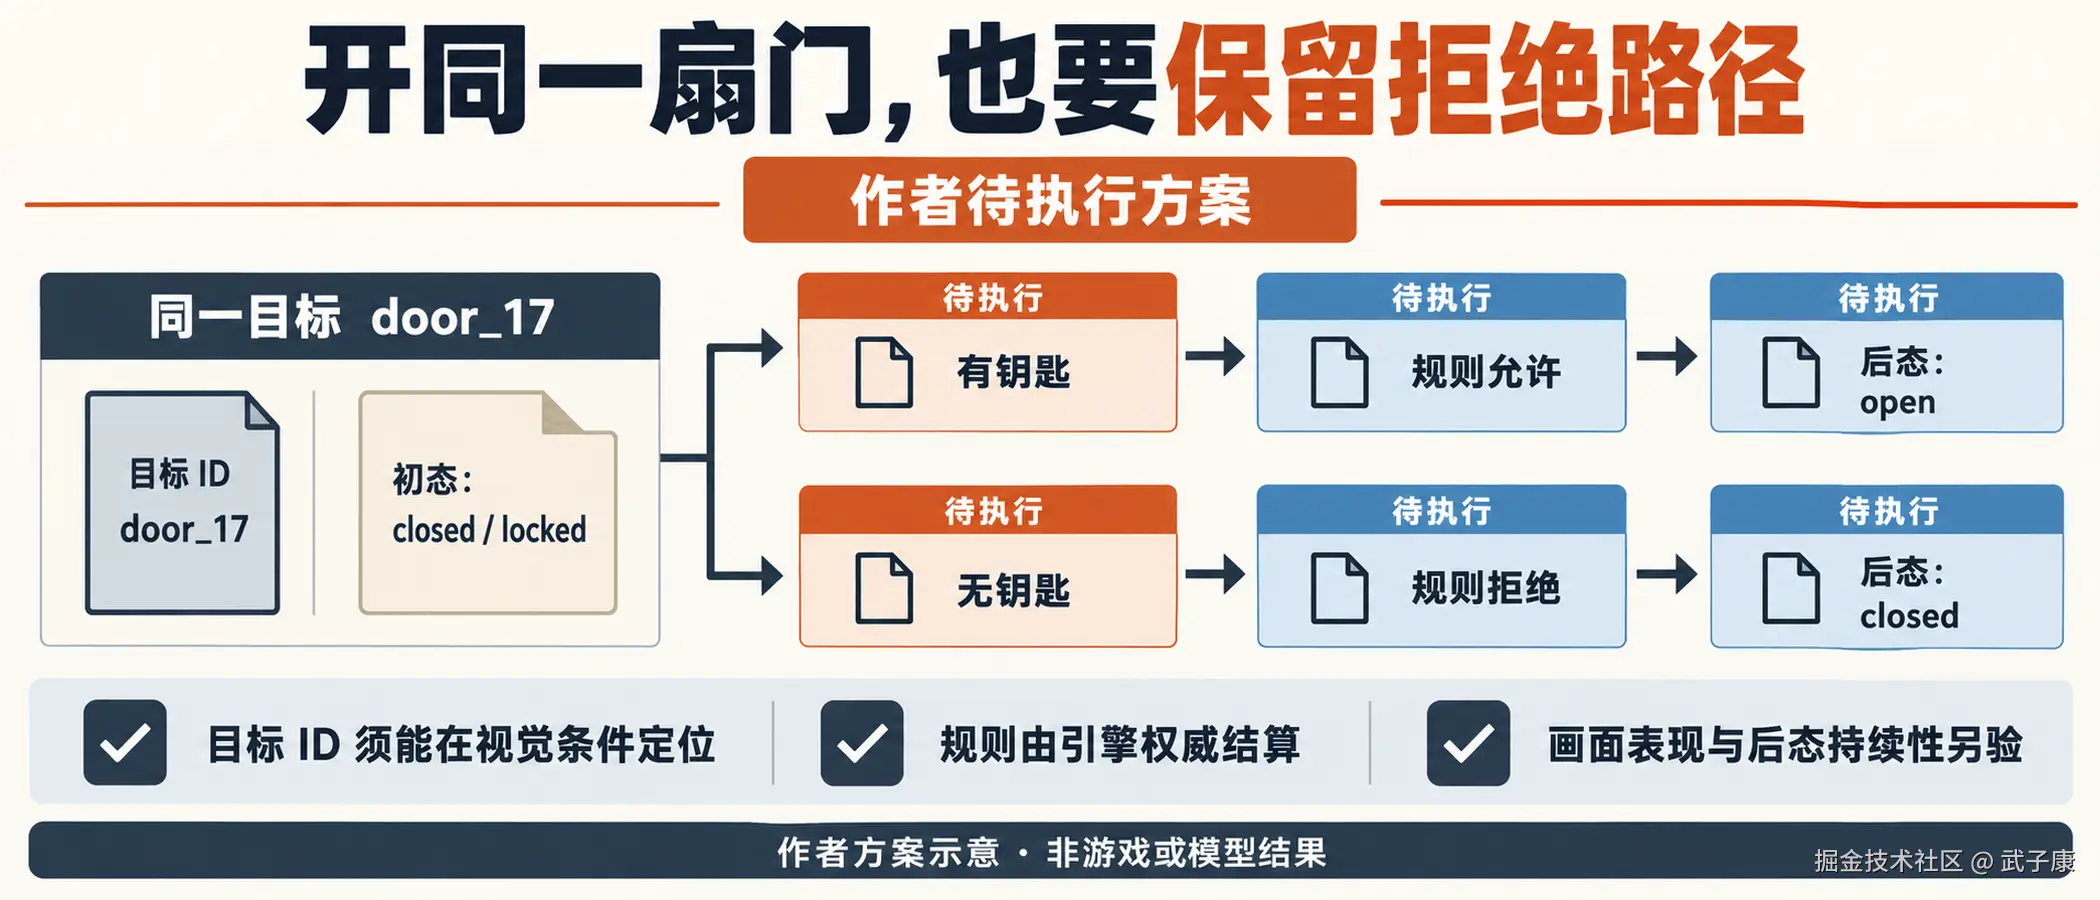
作者机制示意或待执行语义对齐安排;没有游戏、模型或训练实测。
跳跃主要让我们看见事件信息可能丢失。开门多出一个无法由"动作词出现过"代替的条件:究竟是哪扇门,在什么初态下,为什么允许打开?
两段视觉上近似的开门视频,可以对应完全不同的任务:角色拥有钥匙时门打开,角色没有钥匙时门拒绝,或者门原本已经打开。若训练表只记录"按了交互键",而没有目标和初态,这些结果在条件侧可能看起来完全相同。继续加视频可以增加画面覆盖,却不能保证模型学会了钥匙、锁与目标之间的规则。
因此,作者提出的开门数据记录应保留稳定实体标识、门的初态、角色是否具备条件、请求动作、引擎结算结果和后续状态。open door_17 中的 door_17 必须能关联到这个场景的实体;随意把编号插入提示词,不会自动给模型赋予定位能力。视觉条件中若没有目标位置、标记或其他可识别对象,数据侧有 ID 也仍可能无法把目标传到生成器。
一条最小待执行记录可以写成:场景版本固定;目标为门 17;初态 closed、locked;角色没有钥匙;交互请求被拒绝;后态仍为 closed。与之配对的是同一机制下具备钥匙的允许样本。这里不要求每个训练样本都有完全相同的视角,而是要求允许与拒绝的区别能在记录中被解释,避免把所有失败都筛掉以后,只剩"交互必定成功"的偏置。
规则结算由谁负责也要提前定。若目标是接入一个真实游戏,游戏引擎应继续作为门锁、库存和碰撞的权威来源,生成器接收已结算的条件来表现变化。若研究目标是让模型预测状态,则必须另建可监督的状态输出和评估,承认可能出错,并说明如何与外部真实状态纠偏。这已经超出原九位语言动作路径;状态分支、目标定位与额外损失都属于待实现设计,不能把示意结构写成 H3-World 已提供的功能。
对开门的验收,至少应在同一条轨迹里关联"请求目标、条件成立、权威结果、画面表现、后续持续性"。一扇门打开之后下一段又无故关闭,或画面打开而引擎仍锁定,都不能被一帧"像是开了"的截图掩盖。没有真实状态接口时,结论只能限定为视觉动作,不宣称掌握游戏规则。
连续转镜头还需要量纲,不能只增加更多速度词
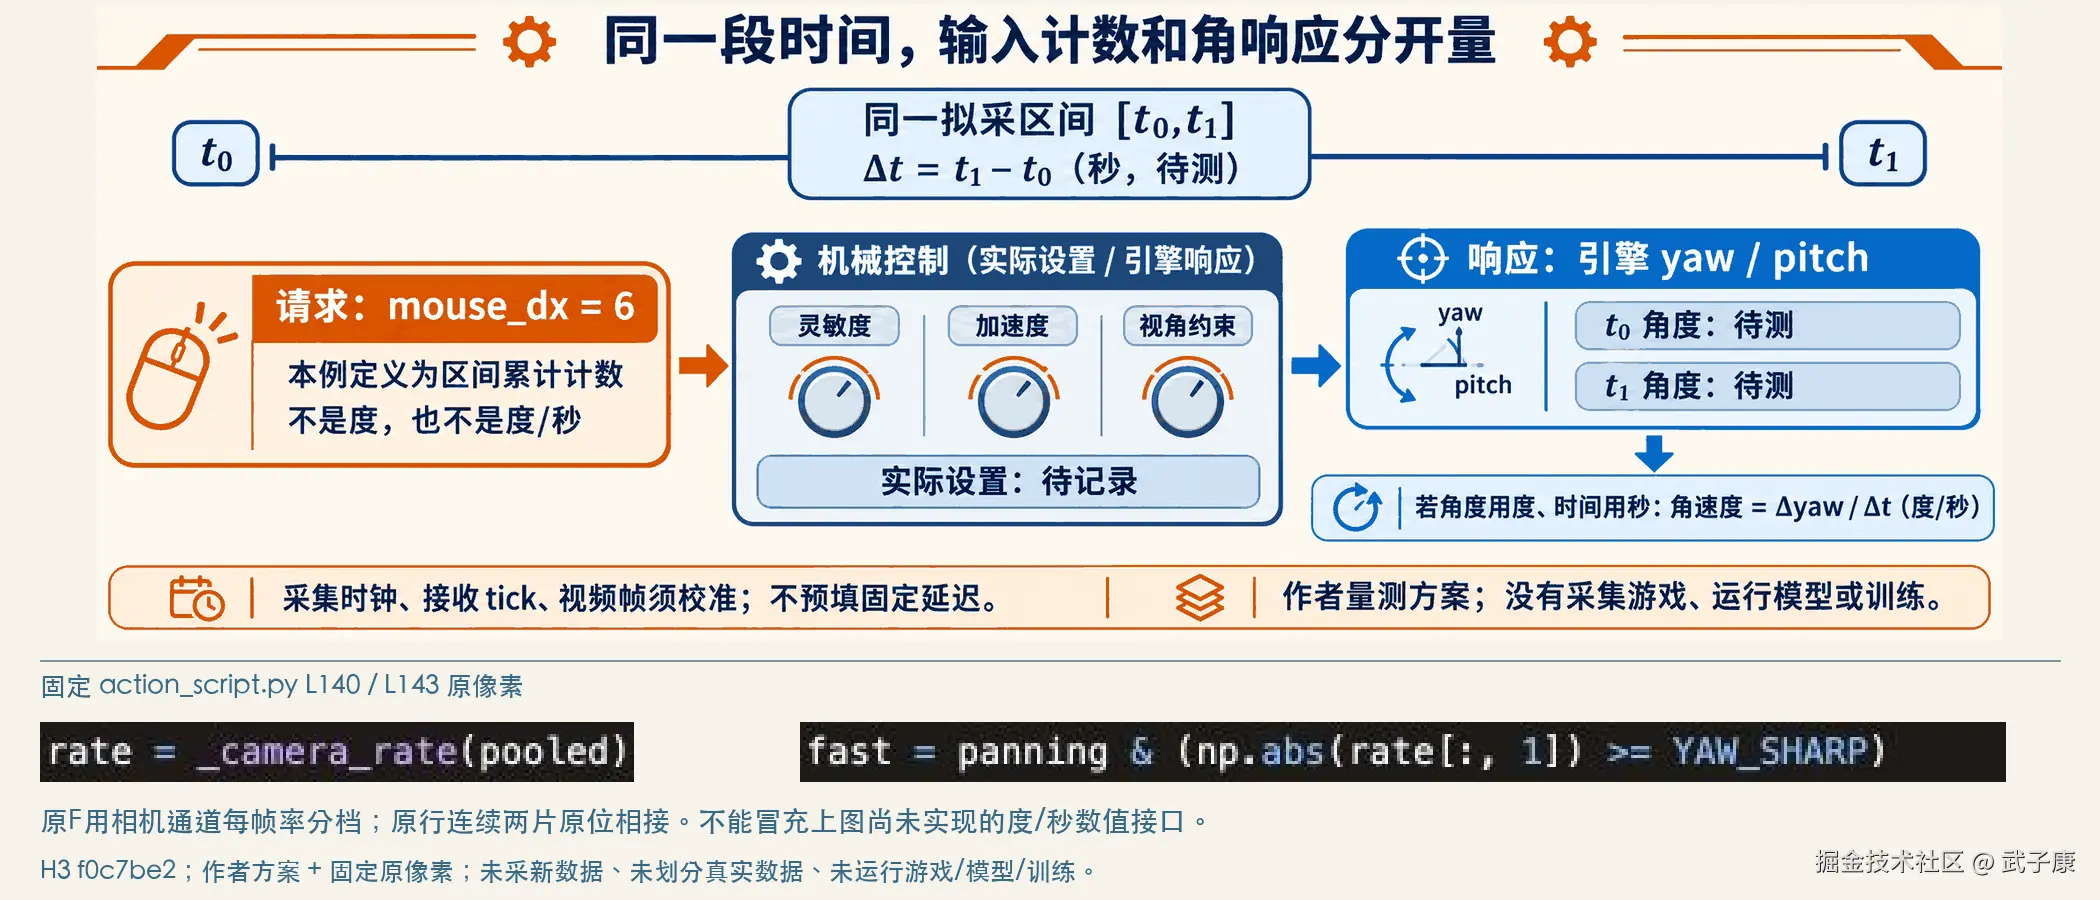
固定官方页面聚焦原像素;证明局部源码职责,不是游戏、模型或训练结果。
固定 H3 动作文本已经区分慢速和快速转镜头,但这不是任意角速度的数值控制接口。其 F 位由测量出的转镜头速率阈值生成;训练数据里的测量结果与用户提交的原始输入量,也不能直接当成同一个变量。固定速率处理与 F 位
例如,mouse_dx=6 可能表示一帧内的鼠标计数、累计位移或别的设备量。它不是天然的"每秒转六度"。灵敏度、帧间隔、输入加速度和游戏的视角约束都会影响结果。自定义采集应保存输入量的单位、时间跨度、灵敏度等设置,并另存引擎实际 yaw/pitch 变化。输入是控制请求,测得的角变化是响应;把它们混成一列,会让训练目标和部署时能提供的条件不一致。
若业务只需要慢、中、快三档,继续使用离散语言可能已经足够,代价是不能承诺档位内部的精确速度。若要在规定区间内控制角速度,可以先测试带单位的数值文本,但文本编码器能读到数字不等于生成结果已经按数值变化。需要把输出角变化与所请求值配对,再检验顺序、误差和跨场景表现。
只有简单表示确实不足,再考虑语言加数值的混合条件:语言描述动作类型,数值向量提供角速度与持续时间。此时需要实现数值归一化、编码器、与相应视频时段的绑定以及训练目标;不能只在 JSON 增加 yaw_rate,就认为现有 pipeline 已消费它。本文没有实现数值分支,也不预设把向量与动作 token 相加一定优于其他注入位置。
验证插值时,可以由作者预先选定若干训练幅度,再留出中间幅度检查。但只做一次"10 和 30 训练,20 测试"不构成普遍插值能力证明。还要固定单位、响应测量与允许区间,检查转向符号、饱和、静止漂移和不同初态。没有实际运行的数据,本文不填写误差、单调性或成功率。
把三种缺口写进同一份扩展试验记录
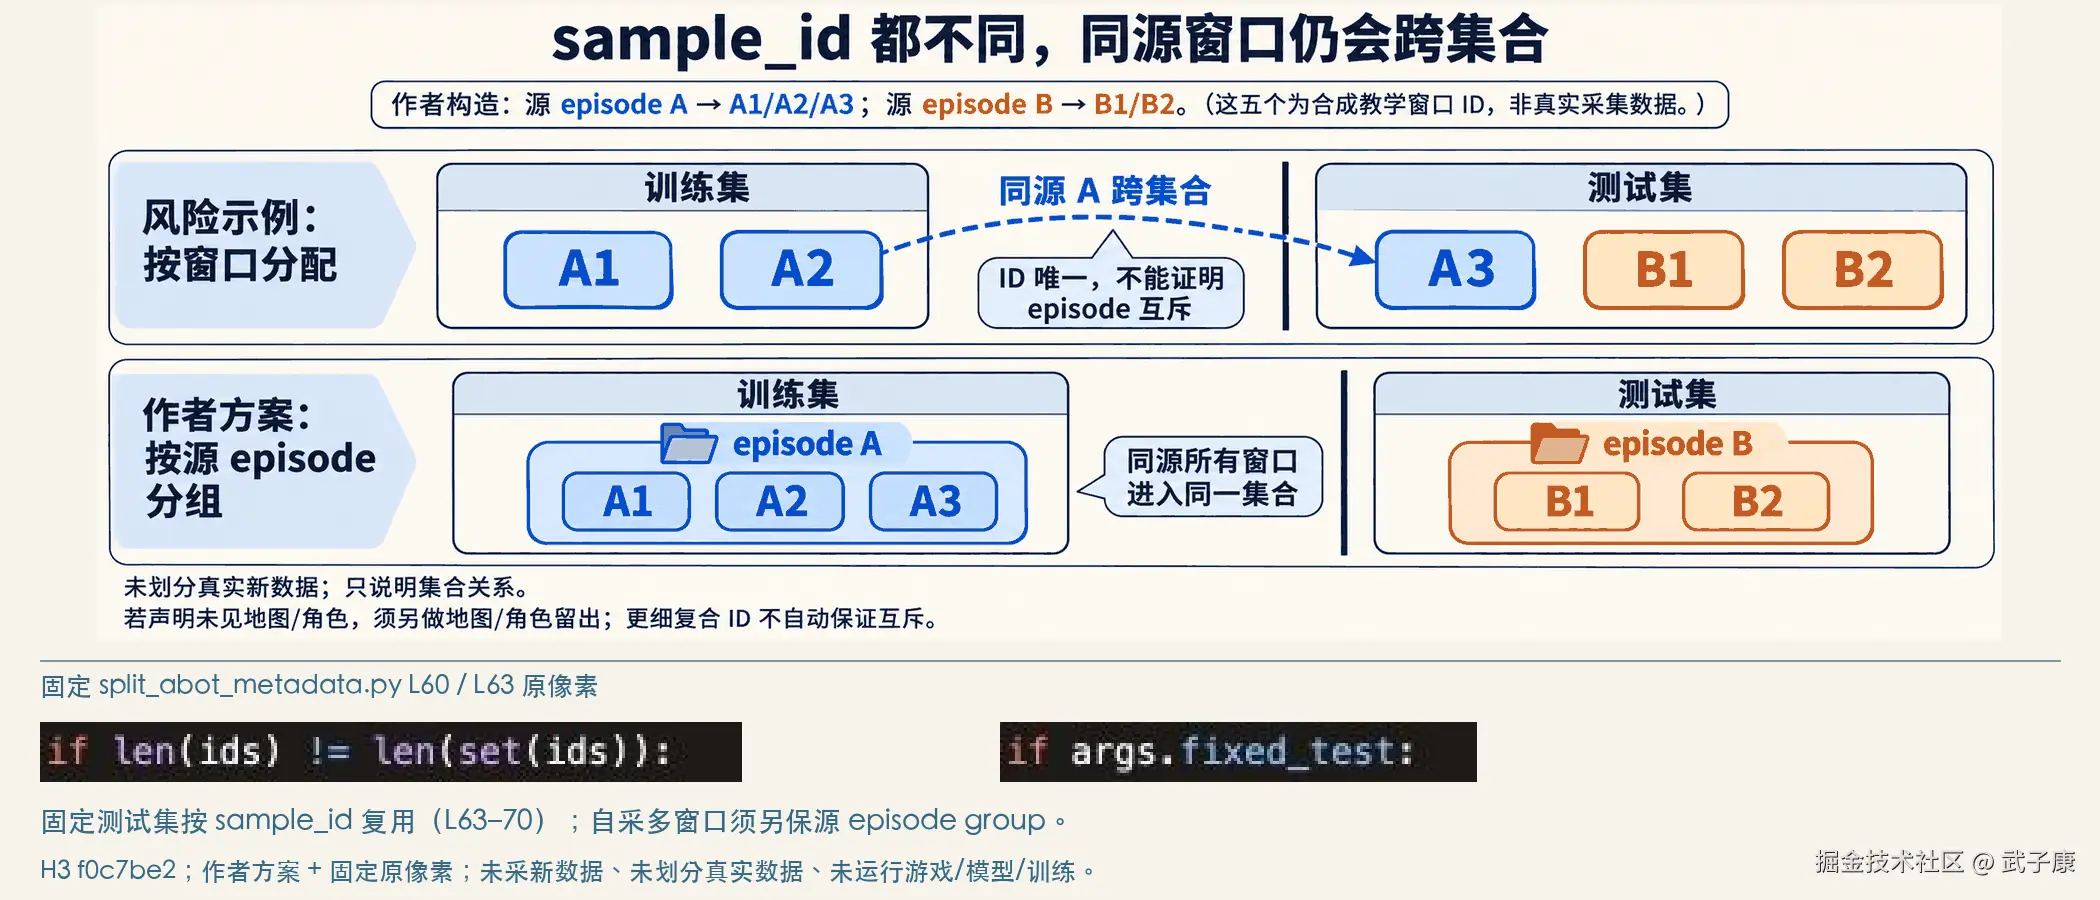
固定官方页面聚焦原像素;证明局部源码职责,不是游戏、模型或训练结果。
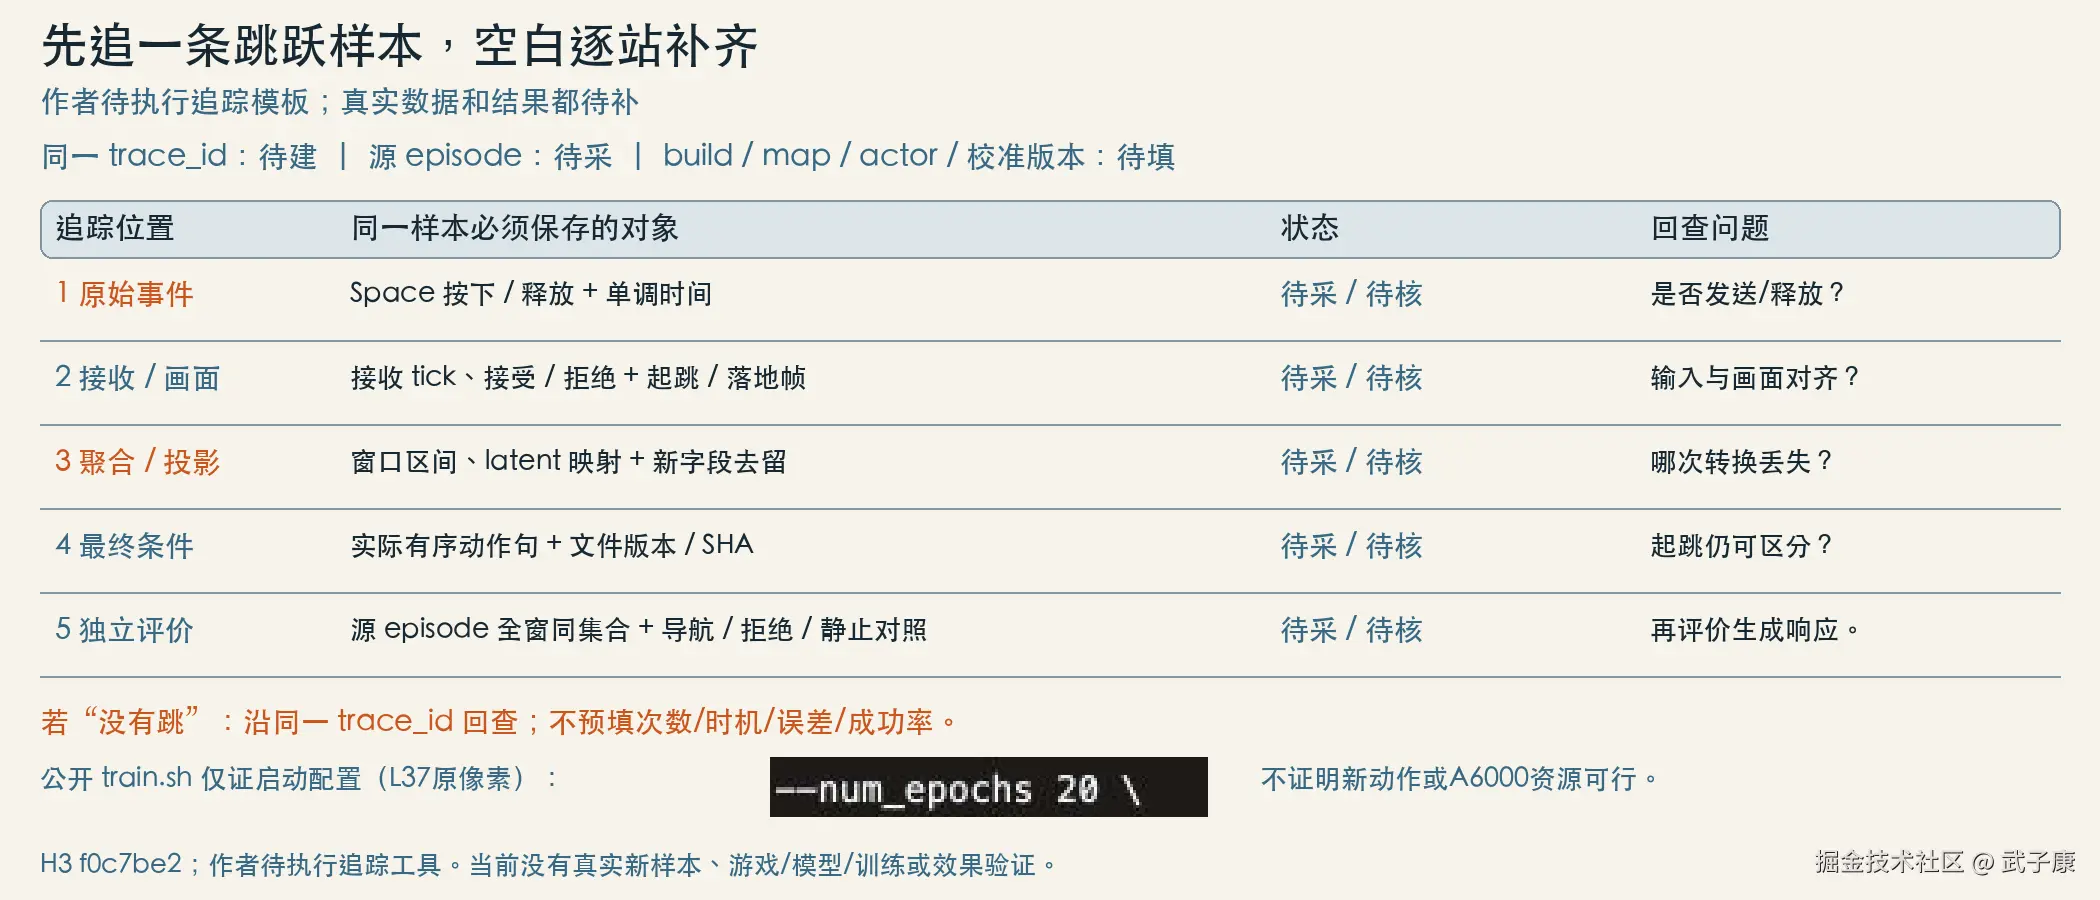
前面的差异最终应落在一项可以交接的产物上。以下是作者设计的对照记录,每行是一种不同扩展要求,不能把完成第一行概括为后两行也已完成。当前所有模型与游戏结果都未执行。
| 扩展目标 | 原始记录必须新增或确认 | 最终条件必须能表达 | 待执行的判定 | 当前证据 |
|---|---|---|---|---|
| 单次跳跃 | 按下/释放、接收 tick、离地与落地、合法与拒绝事件 | 一次触发的位置,必要时附持续时间;核对新字段未被原映射丢弃 | 合法请求的次数与时机,非法请求处理,旧移动能力 | 已核源码 Space 不在九位文本路径;无新数据或训练 |
| 对指定门交互 | 实体、初态、钥匙等前提、权威接受/拒绝及后态 | 可被视觉条件定位的目标和已明确的状态条件 | 目标、规则结果、画面与后续状态是否一致 | 仅扩展设计;未接引擎或状态分支 |
| 数值转镜头 | 输入单位与跨度、灵敏度、实际 yaw/pitch、采集时间关系 | 所请求的量值、单位、时段;若用数值分支须证明它被消费 | 幅度变化、符号、误差与未见幅度,外加静止检查 | 已核现有速度分档;数值控制未实现 |
实际建立记录时,每个试验实例还应关联源 episode、游戏 build、地图、角色、时钟校准版本、视频与输入文件,以及最终条件文件的版本或 SHA。它们不是为了堆字段,而是让一条"模型没跳"的反馈能够回到原始请求:究竟没有被游戏接受,视频晚了,转换丢掉了事件,还是条件已经正确而生成响应失败?
数据划分要与这种追踪一致。一个 episode 切成多段后,不能让相邻段分别进入训练和测试,再把记住同一场景说成新场景泛化。官方划分脚本要求 sample_id 唯一,并提供固定测试集复用入口;它不是任意多窗口自采集数据的通用分组器。对于新数据,应显式保留源 episode 的 group,同一源 episode 的所有窗口进入同一集合。若还要声明未见地图或角色,需要另外按地图或角色留出;把多个字段拼成更细的复合 ID,并不会自动保证地图之间互斥。固定划分脚本
先看新字段能否走到最终条件,再看测试组是否独立,最后才启动昂贵训练。第一轮可只选择单次跳跃,以已有导航样本做保留能力对照,并保留合法、拒绝与静止样本。本文不规定新增多少小时就足够,也不把若干 seed 数当统计保证。评价样本数、失败标准和容差应在看结果之前写下,结果同时报告分母、场景分布及不确定性。
训练启动以后,结论仍按实际完成的范围写
作者机制示意或待执行语义对齐安排;没有游戏、模型或训练实测。
官方 train.sh 给出了 rank-32、qkv_proj/out_proj、20 epochs、梯度检查点及默认四卡等具体设置。这证明公开基线有一份训练启动配置,不能证明它已适配新的事件、状态或连续数值,也不能推出单张 A6000 的峰值与速度。只训练 LoRA 仍要处理反向所需的激活、梯度和优化器状态;资源可行性应由目标配置的真实记录回答。固定训练脚本
本篇不提供一串据称能跑通的新增分支参数。对尚未实现的动作类型,先留一份从原始事件到最终条件的可核查样本,再用独立 episode 评价。若损失下降但 Space 仍被过滤,只能说明旧条件下的训练目标得到优化;若能在指定时机跳起,但门的权限与后态还没接入,就只报告该跳跃试验。连续数值接口实现以后,同样要拿实际响应说明量值含义。
从原始数据里的 Space 列,到模型真正消费的一句动作,中间每次投影都可能删去信息。扩展 H3-World 的第一步,是确认新增控制在这条路径上仍可被区分;跳跃需要事件,开门需要目标与状态,连续控制需要量纲与响应。先把这份扩展试验记录中的空白补成真实样本,再决定下一次训练应改动哪里。