在之前的文章中,我们分别介绍了 Agent Loop 和工具调用,这次,我们继续深入 Pi 源码,聊聊 Agent 的另一个核心模块:上下文管理系统。
什么是上下文管理系统?
听起来有些抽象,但其实它解决的都是非常实际的问题。
比如,Agent 是如何管理历史对话的?每次请求 LLM 时,究竟会发送哪些内容?当对话越来越长,Token 即将超过 Context Window 的限制时,又该如何处理?
这些问题,都是上下文管理系统需要解决的。
本文依然以 Pi 为例,从源码出发,看看一个优秀的 Agent 上下文管理系统,是如何设计和实现的。
一、整体架构
Pi 的上下文管理系统由哪些核心模块组成?
只有3部分:
Message、Session、Context。
Session、Message、Context 之间有什么区别和联系?
我们先来简单介绍下这三个东西,分别是啥,
Message
首先介绍Message,
简单来说,
Message只有四类:
js
export type Message = SystemMessage | UserMessage | AssistantMessage | ToolResultMessage;含义非常清晰,就不一一解释了,其实在这里看不懂,也没有关系,只是让你有一个大体概念。
Session
Session的类型,就比较多了:
js
export type SessionEntry =
	| SessionMessageEntry
	| ThinkingLevelChangeEntry
	| ModelChangeEntry
	| UsageEntry
	| CompactionEntry
	| BranchSummaryEntry
	| CustomEntry
	| CustomMessageEntry
	| ContextEditEntry
	| LabelEntry
	| SessionInfoEntry;
简单来说,
Message 可以被封装为 SessionMessageEntry,持久化到 Session 中。但 Session 不只是 Message 的集合,还包含其他事件。
比如模型切换、思考等级切换等等。
Context
Context,有很多层次的概念,
但整体的层次大概是这样:
js
SessionProjection → AgentContext → TranscriptContext至于是什么含义,也可以先不用管。
大概的关系是这样:
Session(完整历史)
  → 选择当前分支、应用 Compaction
  → Context(本次有效消息)
  → LLM
  → 新 Message
  → 写回 Session
上下文管理系统与 Agent Loop 是如何协作的?
可以把它们理解为:
上下文管理系统负责准备"模型这次能看到的资料",而Agent Loop负责拿着这些资料去调用模型、执行工具
大概流程是
markdown
1. 用户发送消息
2. 上下文管理从 Session 中整理当前有效历史,并转换为Context
3. Agent Loop 把 Context 发给 LLM
4. LLM 返回回答或 Tool Call
5. Agent Loop 执行工具,得到 Tool Result
6. 新消息或工具结果写回 Session
7. 下一轮重新构建 Context
代码侧的流程,大概是这样:
js
SessionEntry[]
    ↓ 分支选择、compaction、context edit
SessionProjection
    ↓
AgentMessage[]
    ↓ 加入可执行工具
AgentContext
    ↓ transformContext
AgentMessage[]
    ↓ convertToLlm
Message[]
    ↓ normalizeContext
TranscriptContext
    ↓
Provider
但现在看不懂也没关系,一头雾水也正常,因为现在我啥都没说,只是从宏观上讲了讲上下文管理系统的组成。
你就记住,上下文管理系统,由3部分组成:Message、Session、Context。
接下来,我们依次来介绍。
二、Message
Message 是上下文管理系统的基本数据单元,Session 和 Context 都围绕 Message 工作。
总共有下面几类,
标准Message
表达的是 LLM 能理解的消息,
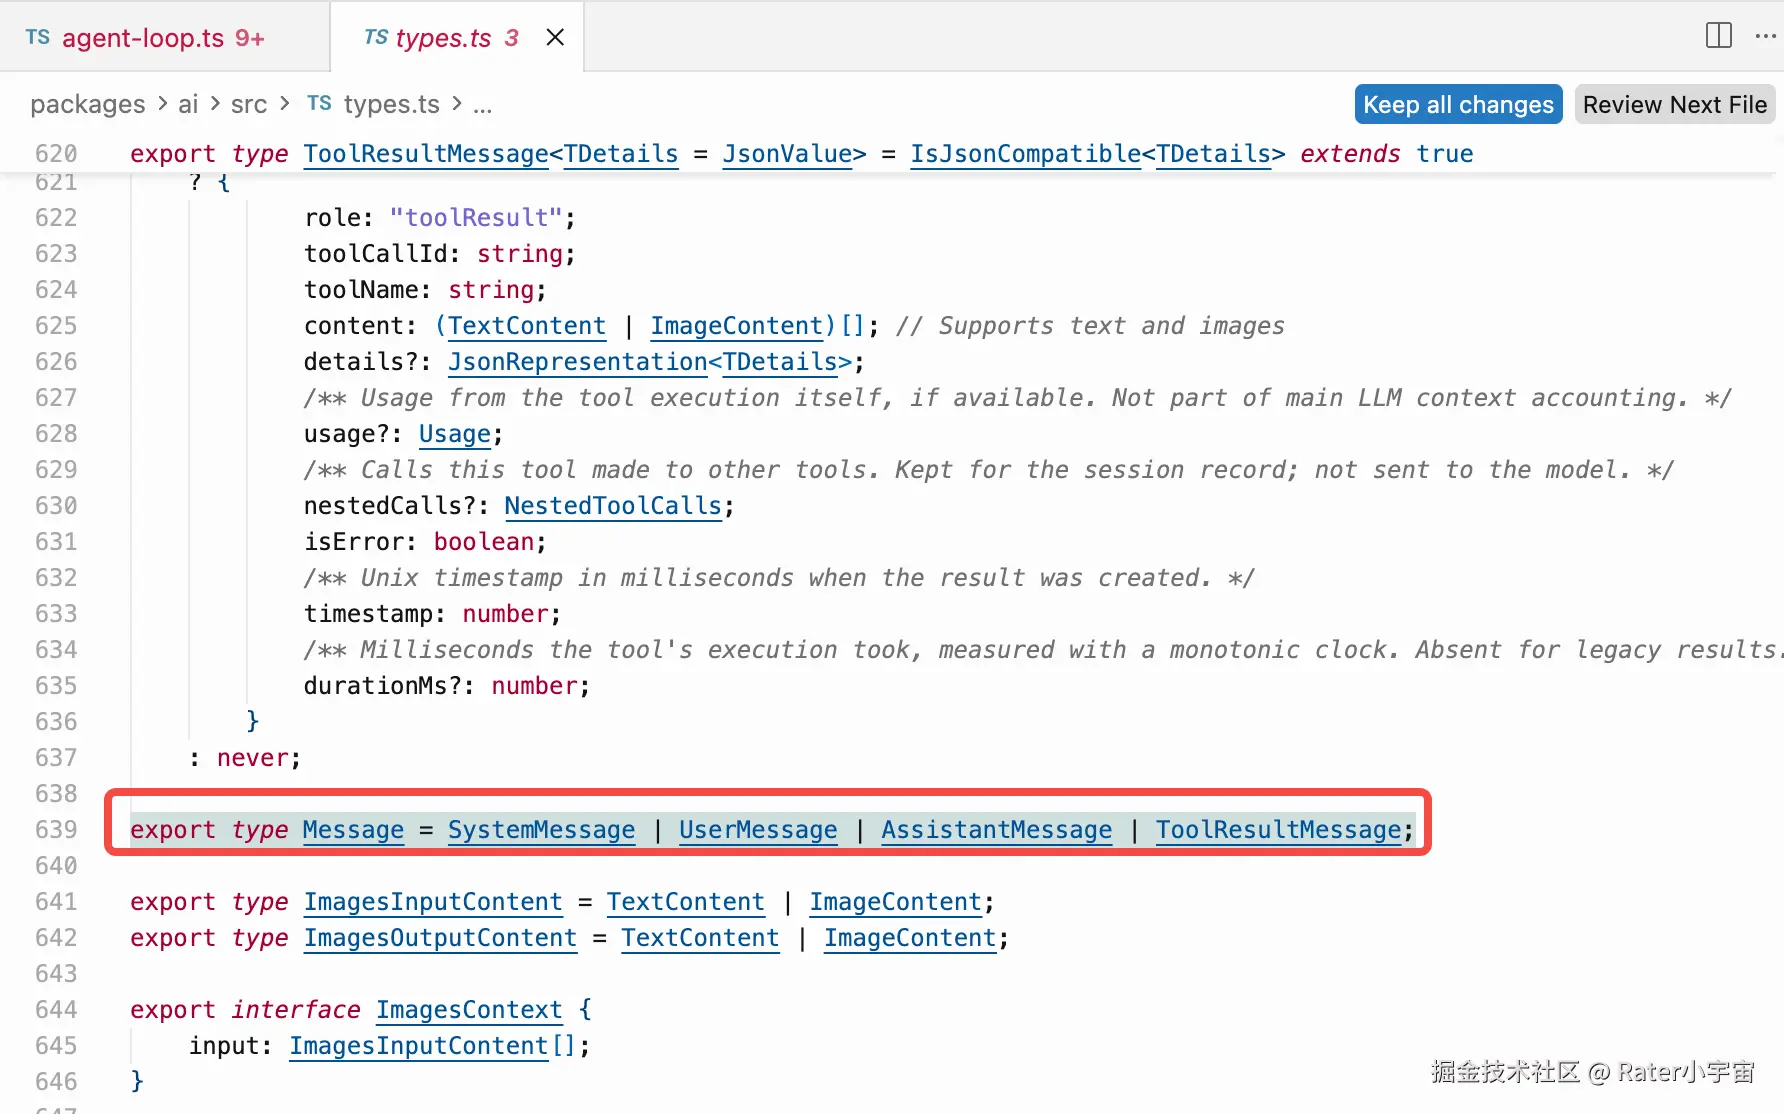
分别含义是:
go
`SystemMessage`:承载系统提示词及其增量变更,并可记录工具声明的变化。
`UserMessage`:用户输入。
`AssistantMessage`:模型回答、思考内容、Tool Call。
`ToolResultMessage`:工具执行结果。下面,我们着重介绍下SystemMessage和UserMessage
SystemMessage
主要用于记录:System Prompt 变化、工具增加或删除
生成SystemMessage的过程,分成2种情况,第一轮对话和后续对话
第一轮的生成链:
scss
AgentSession.prompt()
→ _startRun()
→ _prepareRun()
→ _preparePromptAndToolLoadout()
→ agent.prompt(messages)
→ runAgentLoop()
→ declareToolChanges()
→ message_end
→ prepareRequest()
→ 第一次 LLM 请求
后续每一轮的生成链:
scss
runLoop()
→ prepareNextTurn()
→ AgentSession._installAgentNextTurnRefresh()
→ _preparePromptAndToolLoadout()
→ 必要时生成新的 SystemMessage
→ declareToolChanges()
→ 发出 message_end
→ 持久化
→ 下一次 LLM 请求所以核心就是_preparePromptAndToolLoadout()方法和declareToolChanges()方法,后者其实在第一篇文章有介绍了。
关于这2个方法的功能,关键是理解这三个东西:
js
`agent.state.tools`:真正可以执行的工具代码。
`SystemMessage.sections`:给模型看的文字说明。
`SystemMessage.toolsAdded/toolsRemoved`:给模型的工具 JSON Schema 声明。
_preparePromptAndToolLoadout() 主要处理前两个,第三个稍后由 declareToolChanges() 处理。
我们依次来介绍,
首先,_preparePromptAndToolLoadout()方法
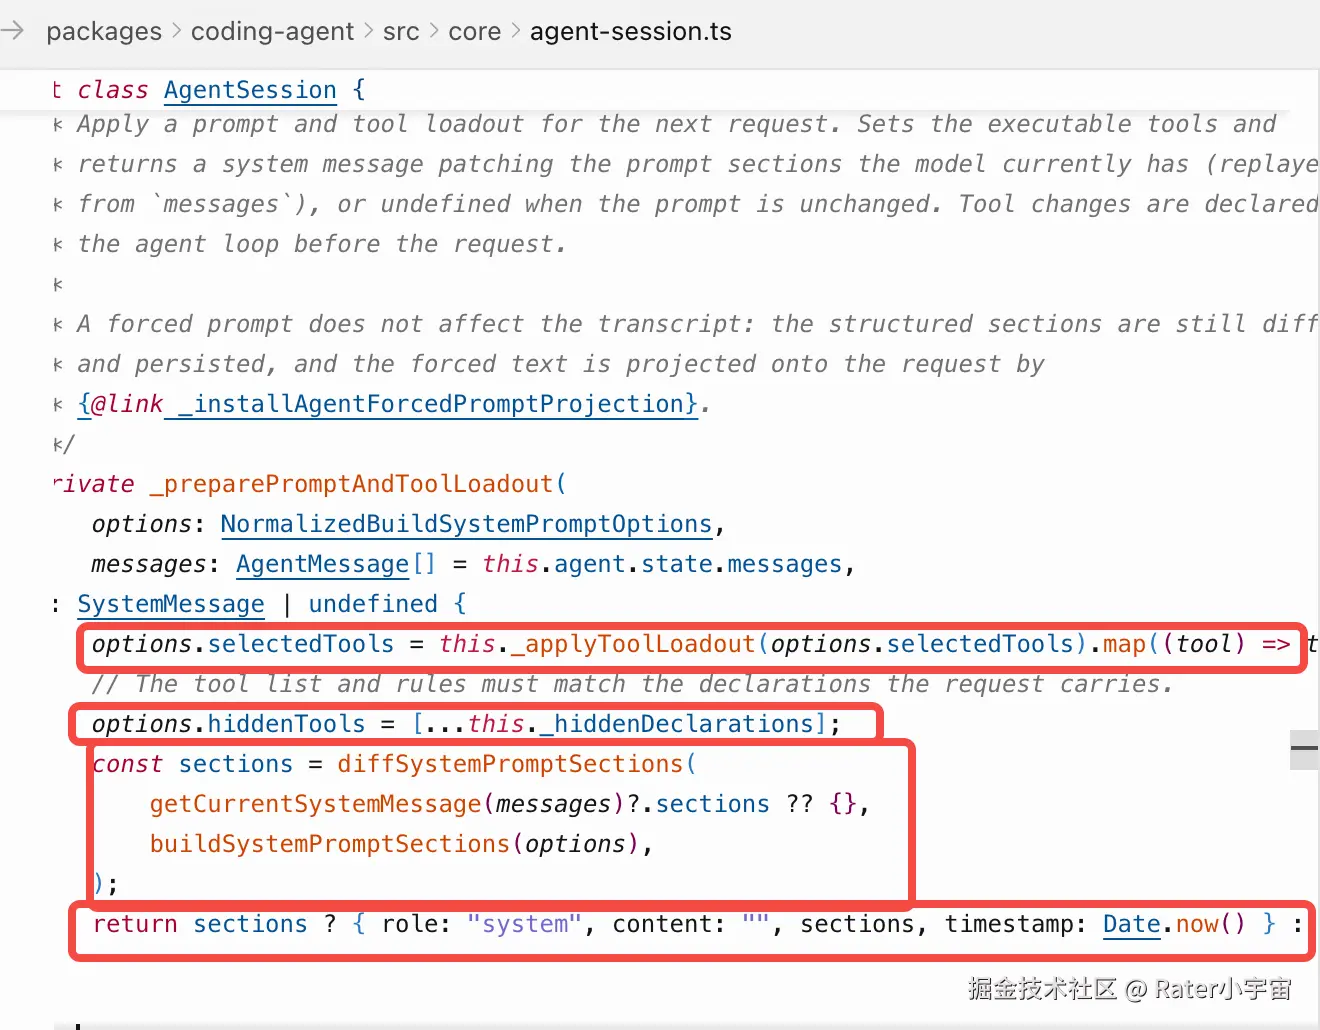
做了什么事呢?
假设调用前状态如下:
arduino
历史 SystemMessage:
- 模型知道工具:read

本次 options:
- selectedTools:["read", "bash", "unknown"]第一步:this._applyToolLoadout(options.selectedTools)
它会从工具注册表查找工具:
arduino
read    → 存在
bash    → 存在
unknown → 不存在,过滤掉
执行后的产物:
ini
agent.state.tools = [
  read 的可执行实现,
  bash 的可执行实现
]

options.selectedTools = ["read", "bash"]
这一步解决的是:
Agent Runtime 到底能执行哪些工具?
第二步:options.hiddenTools = [...this._hiddenDeclarations]
作用:确定哪些工具对模型可见
正常情况下:
ini
options.hiddenTools = []因此模型可见:
css
["read", "bash"]假设某个扩展隐藏了 bash:
ini
options.selectedTools = ["read", "bash"]
options.hiddenTools = ["bash"]
那么结果是:
arduino
模型只能看到:read这一步解决的是:
可执行工具中,哪些应该直接告诉模型?
因为有些工具,是不能直接让模型知道的,需要对模型屏蔽。
第三步:diffSystemPromptSections(previous, current)
先调用getCurrentSystemMessage(messages)?.sections ,从历史 Message 中计算模型当前知道的内容:
假设得到:
css
当前 sections:
{
  tools: "read",
  rules: "使用 read 读取文件",
  cwd: "/old"
}然后调用buildSystemPromptSections(options),根据新的 options 构建目标 sections:
结果类似:
css
目标 sections:
{
  preamble: "You are an expert coding assistant...",
  tools: "read、bash",
  rules: "使用 read 读取文件;使用 bash 执行命令",
  docs: "Pi documentation...",
  cwd: "/new"
}
接着比较新旧内容:
scss
diffSystemPromptSections(previous, current)只保留发生变化的部分:
css
差异:
{
  tools: "read、bash",
  rules: "使用 read 读取文件;使用 bash 执行命令",
  cwd: "/new"
}
preamble 和 docs 如果没有变化,就不会重复发送。
这一步解决的是:
相比模型已经知道的内容,这次有哪些 Prompt 内容发生了变化?
第四步:生成增量 SystemMessage
最终返回:
css
{
  role: "system",
  content: "",
  sections: {
    tools: "read、bash",
    rules: "使用 read 读取文件;使用 bash 执行命令",
    cwd: "/new"
  },
  timestamp: Date.now()
}
注意:这不是完整 System Prompt,而是一个补丁。
历史状态加上补丁:
ini
旧 SystemMessage
+ 新 SystemMessage patch
= 当前完整 System Prompt如果没有任何变化,则返回undefined
下面,开始介绍:declareToolChanges()
上面生成的 sections.tools 只是给模型看的文字说明。
进入 Agent Loop 后,declareToolChanges() 会发现新增了 bash,于是补充toolsAdded:
css
{
  role: "system",
  content: "",
  sections: {
    tools: "read、bash",
    rules: "...",
    cwd: "/new"
  },
  toolsAdded: [
    {
      name: "bash",
      description: "...",
      parameters: {/* JSON Schema */}
    }
  ]
}
完整调用链
scss
_preparePromptAndToolLoadout()
→ 生成 Prompt sections 补丁
→ declareToolChanges()
→ 计算实际工具变化
→ 合并 toolsAdded/toolsRemoved
→ 得到最终 SystemMessage
→ message_end
→ 写入 Session
→ 进入第一次 LLM 请求所以declareToolChanges()的作用,一个是补充工具变化,再一个是补充工具执行的schema
Ok。
对于SystemMessage,我花了很多篇幅来介绍,因为SystemMessage很重要,理解了它的生成流程,对理解上下文管理系统,有很大的帮助,
而且,我觉得这也是一个蛮有意思的机制。
UserMessage
表示用户的输入。
它其实有2个来源:
- 正常的用户输入
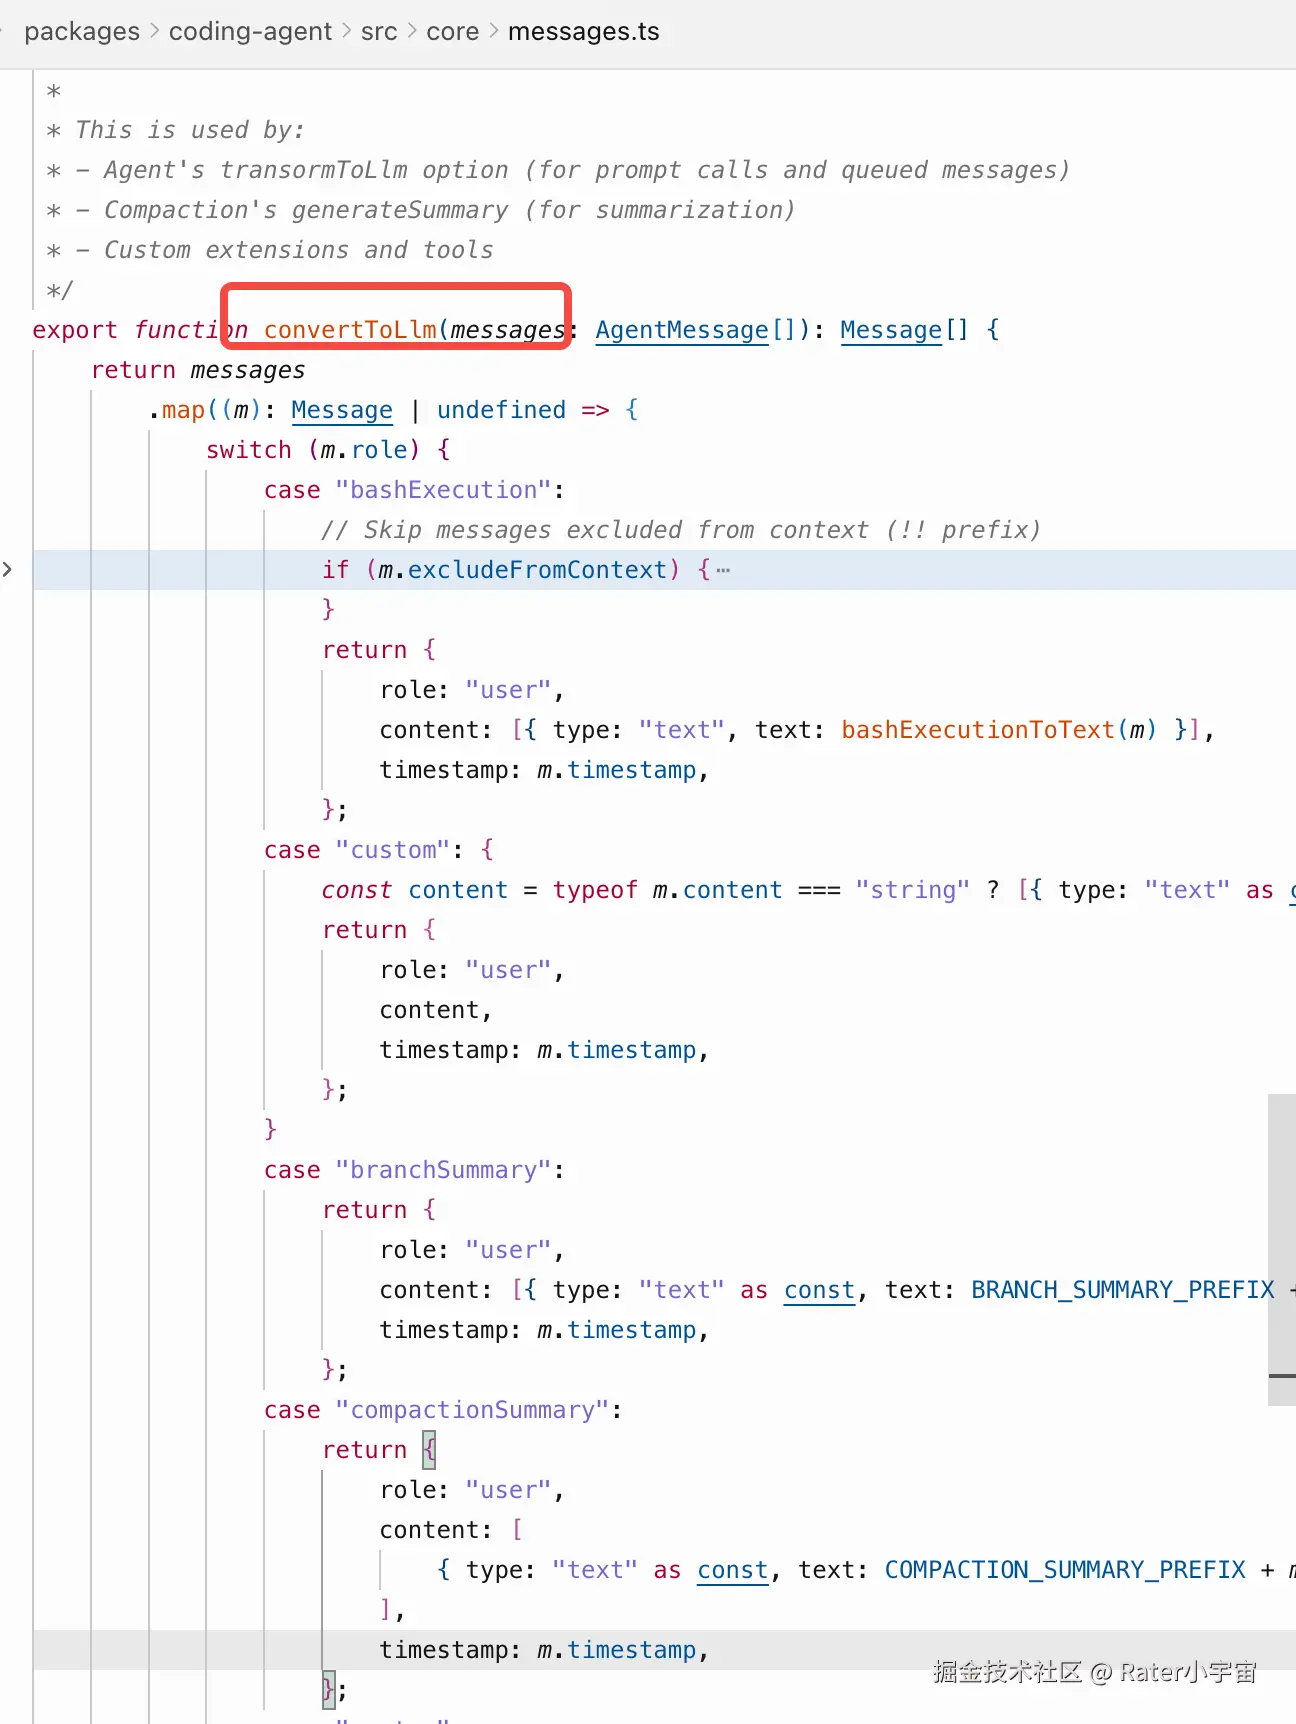
- 原本是其他 AgentMessage,发送给 LLM 时转换成
UserMessage
首先看1:
它的生成链是这样的:
scss
AgentSession.prompt()
→ _startRun()
→ _prepareRun()
→ 创建 UserMessage
→ agent.prompt()
具体是在_prepareRun()中创建的
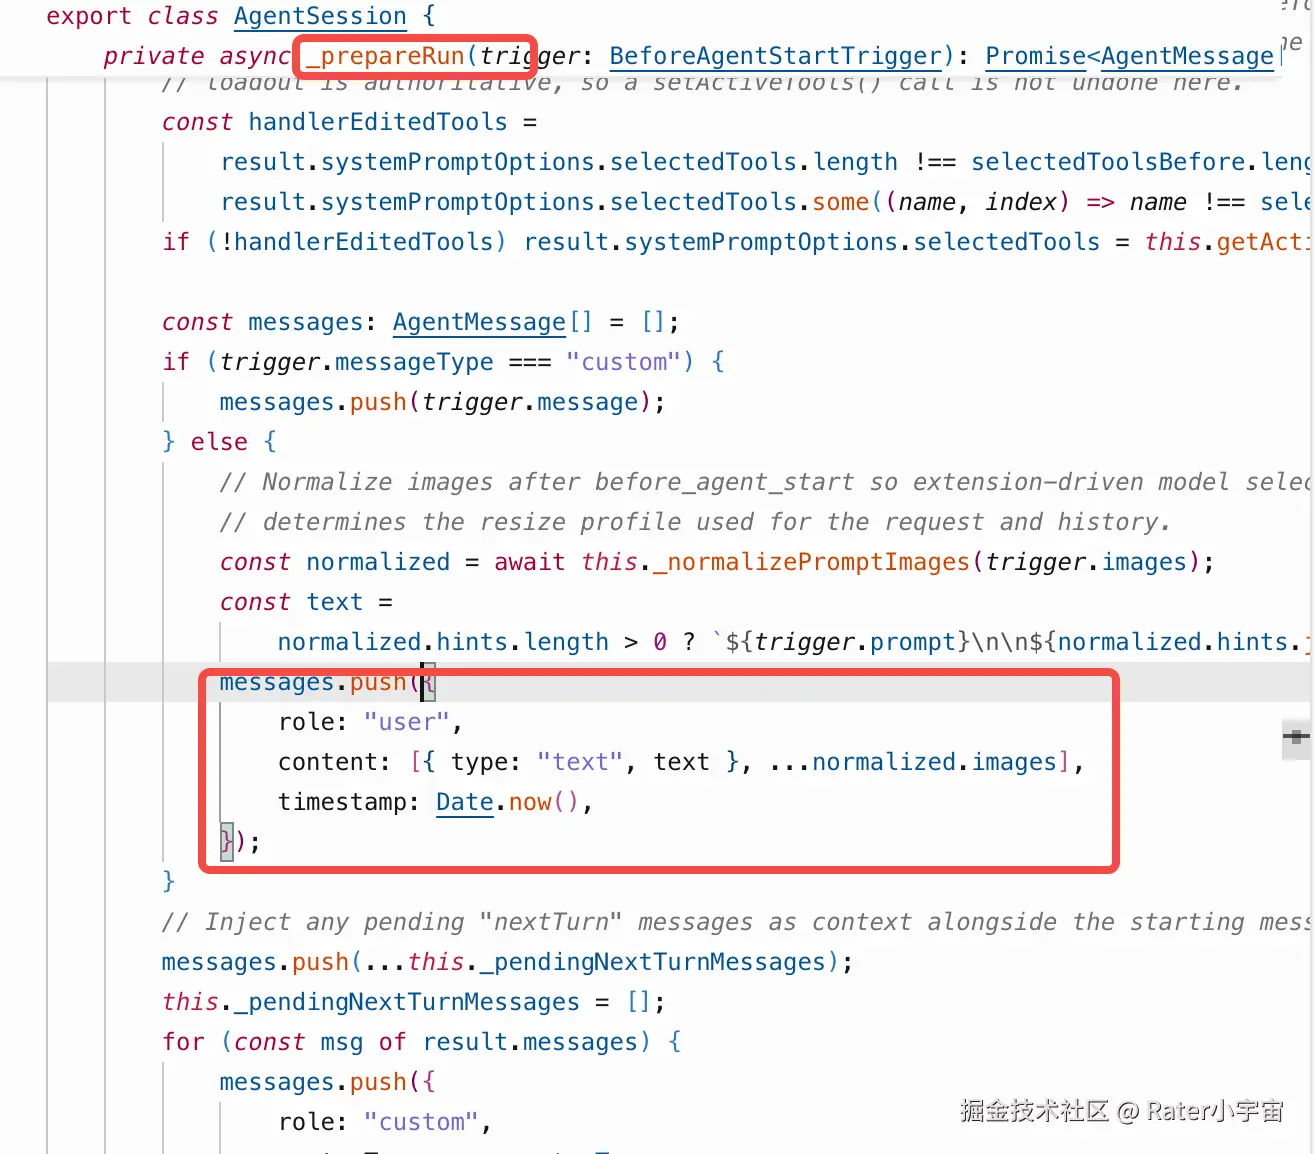
然后看2:
至于AssistantMessage和ToolResultMessage,都比较简单了,没啥好说的,直接略过了。
AgentMessage
它包含标准 Message,和扩展的特殊消息:
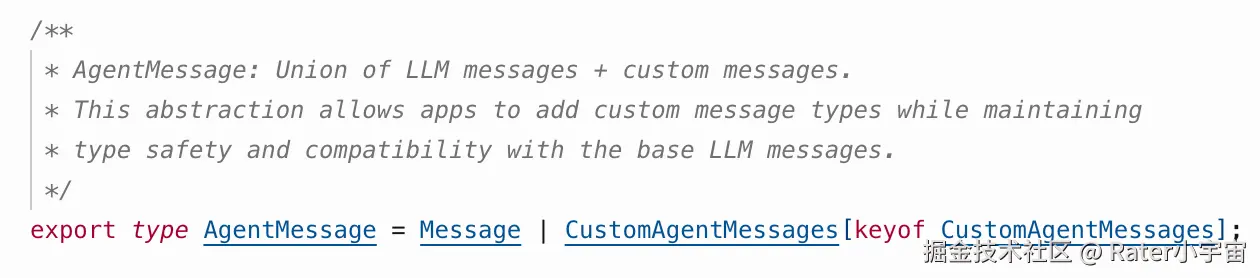
扩展的消息中,主要包含以下这些自定义Message:
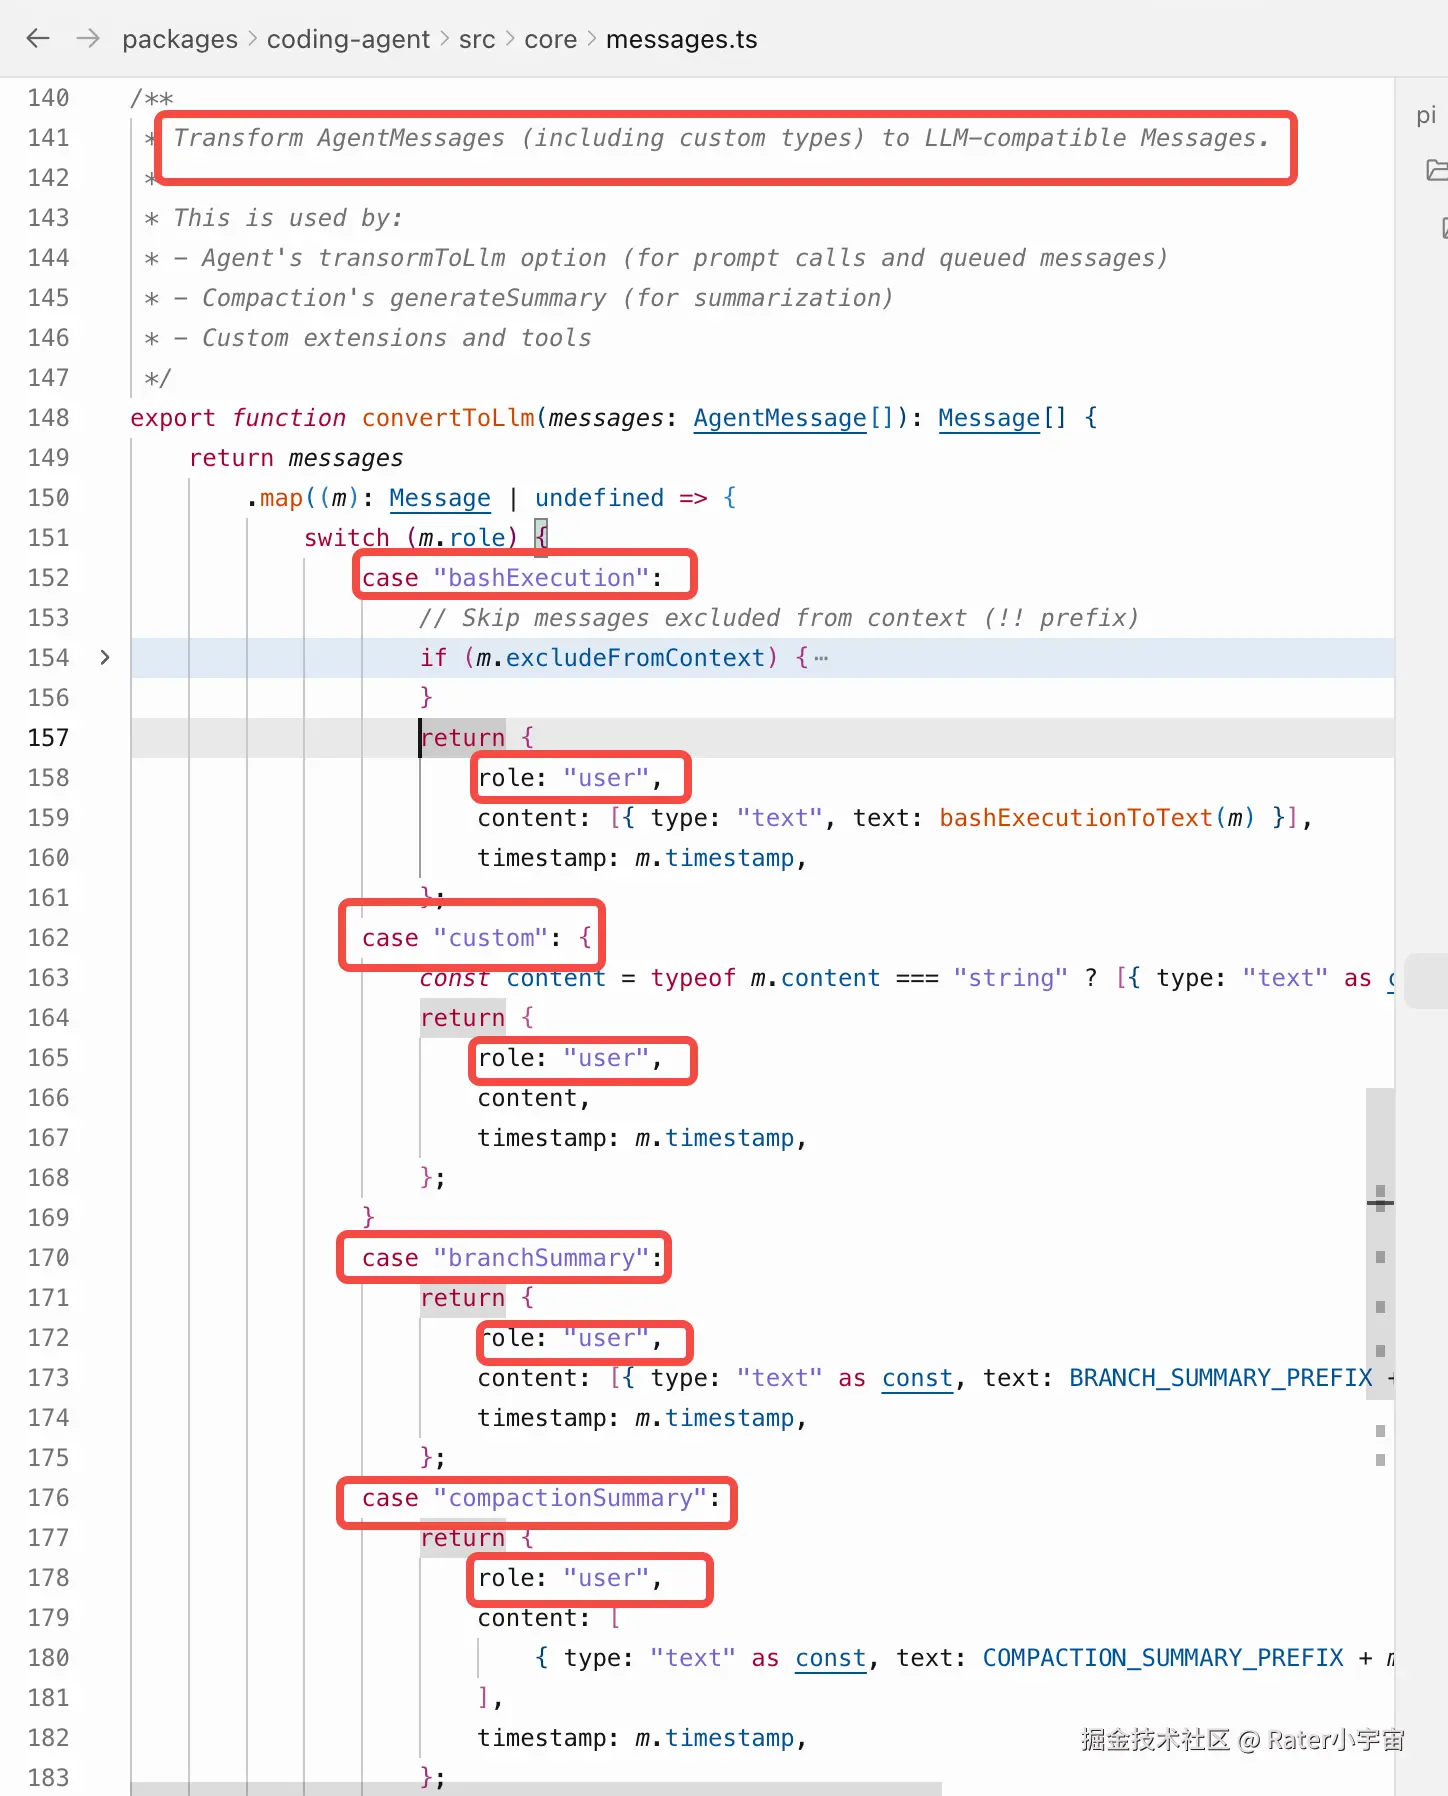
go
`BashExecutionMessage`:表示用户通过 `!` 命令执行 Bash 的记录,包括命令、输出、退出码和是否截断。
`CustomMessage`:表示扩展注入的自定义消息。
`BranchSummaryMessage`:表示切换分支时,对离开分支内容的摘要,使模型知道被放弃分支中发生过什么。
`CompactionSummaryMessage`:表示旧历史经过 Compaction 后生成的摘要,包含摘要文本和压缩前 token 数。
这些最终都会转换成UserMessage
因此:
markdown
AgentMessage
  = 标准 Message
  + bashExecution
  + custom
  + branchSummary
  + compactionSummary
转换逻辑在:
SessionEntry
这其实属于是Entry层的概念,
Message 持久化时会被包装为 SessionEntry:
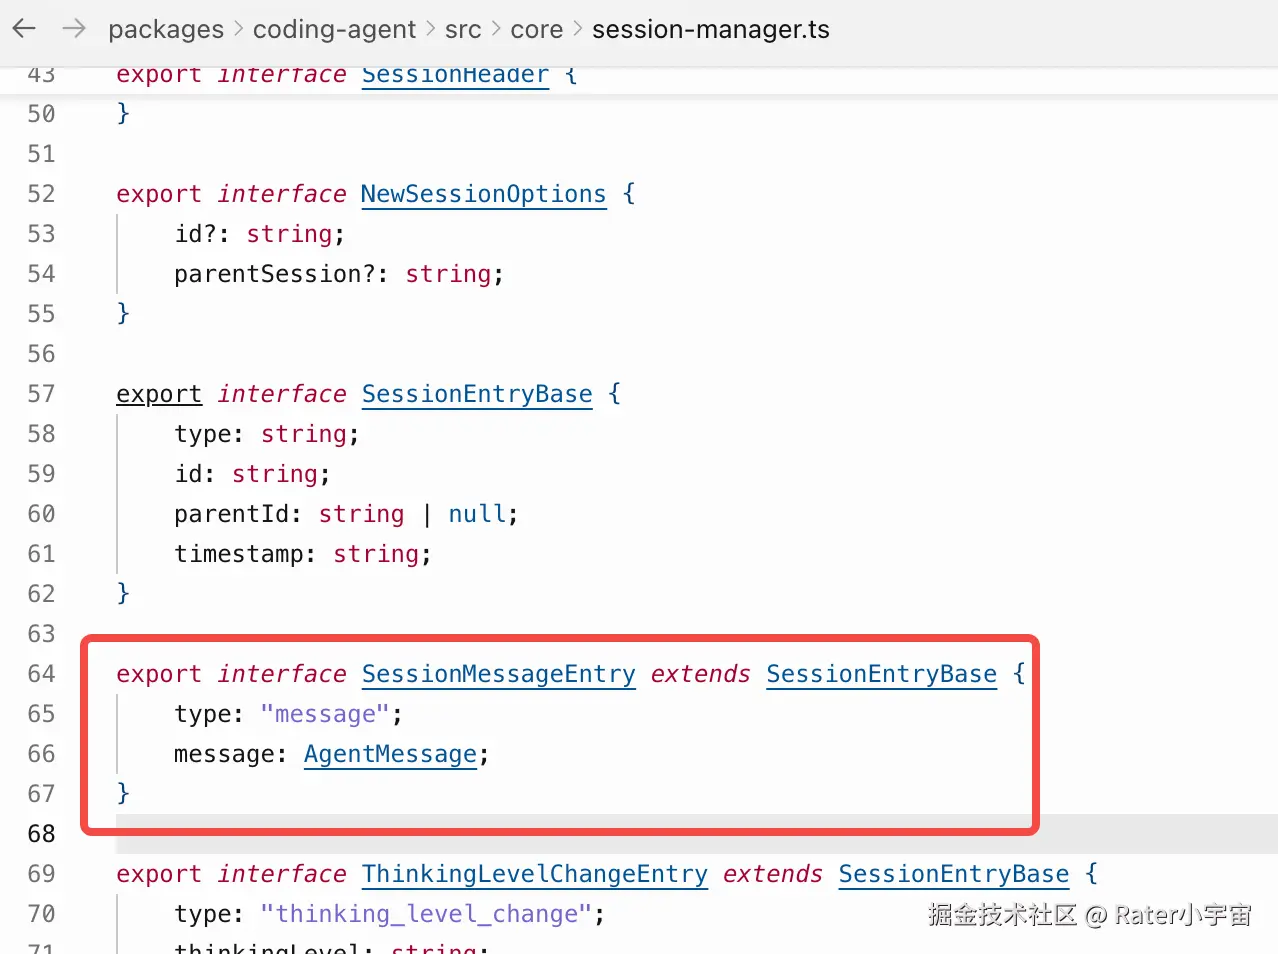
概括一下,就是
css
AgentMessage
  → 被包装为 SessionEntry,持久化到 Session
  → SessionManager 选择当前分支
  → 得到 AgentMessage[]
  → 转换为标准 Message[]
  → 组成 LLM Context
三、Session 管理
下面来介绍下Session,
先给出核心结论:
Pi 的 Session 是一个存储在 JSONL 文件中的 append-only 事件树。每条记录通过 id + parentId 连接,当前 leafId 决定正在使用哪条分支。
Session 的核心数据结构是什么?
主要是SessionHeader和SessionEntry。
JSONL 第一行是 SessionHeader,主要记录Session的一些文件信息:
typescript
export interface SessionHeader {
	type: "session";
	version?: number;
	id: string;
	timestamp: string;
	cwd: string;
	parentSession?: string;
}
SessionHeader 后面的每一行都是 SessionEntry,记录具体的Session节点信息。
typescript
export interface SessionEntryBase {
	type: string;
	id: string;
	parentId: string | null;
	timestamp: string;
}
具体有这些类型
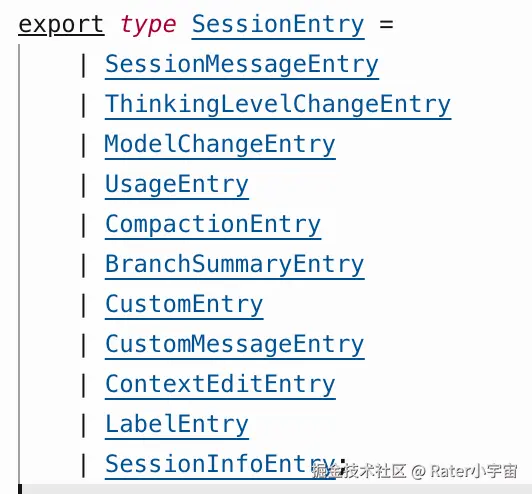
因此,
Session 不只是 Message 列表,而是完整的会话事件日志。
Session由SessionManager来管理,
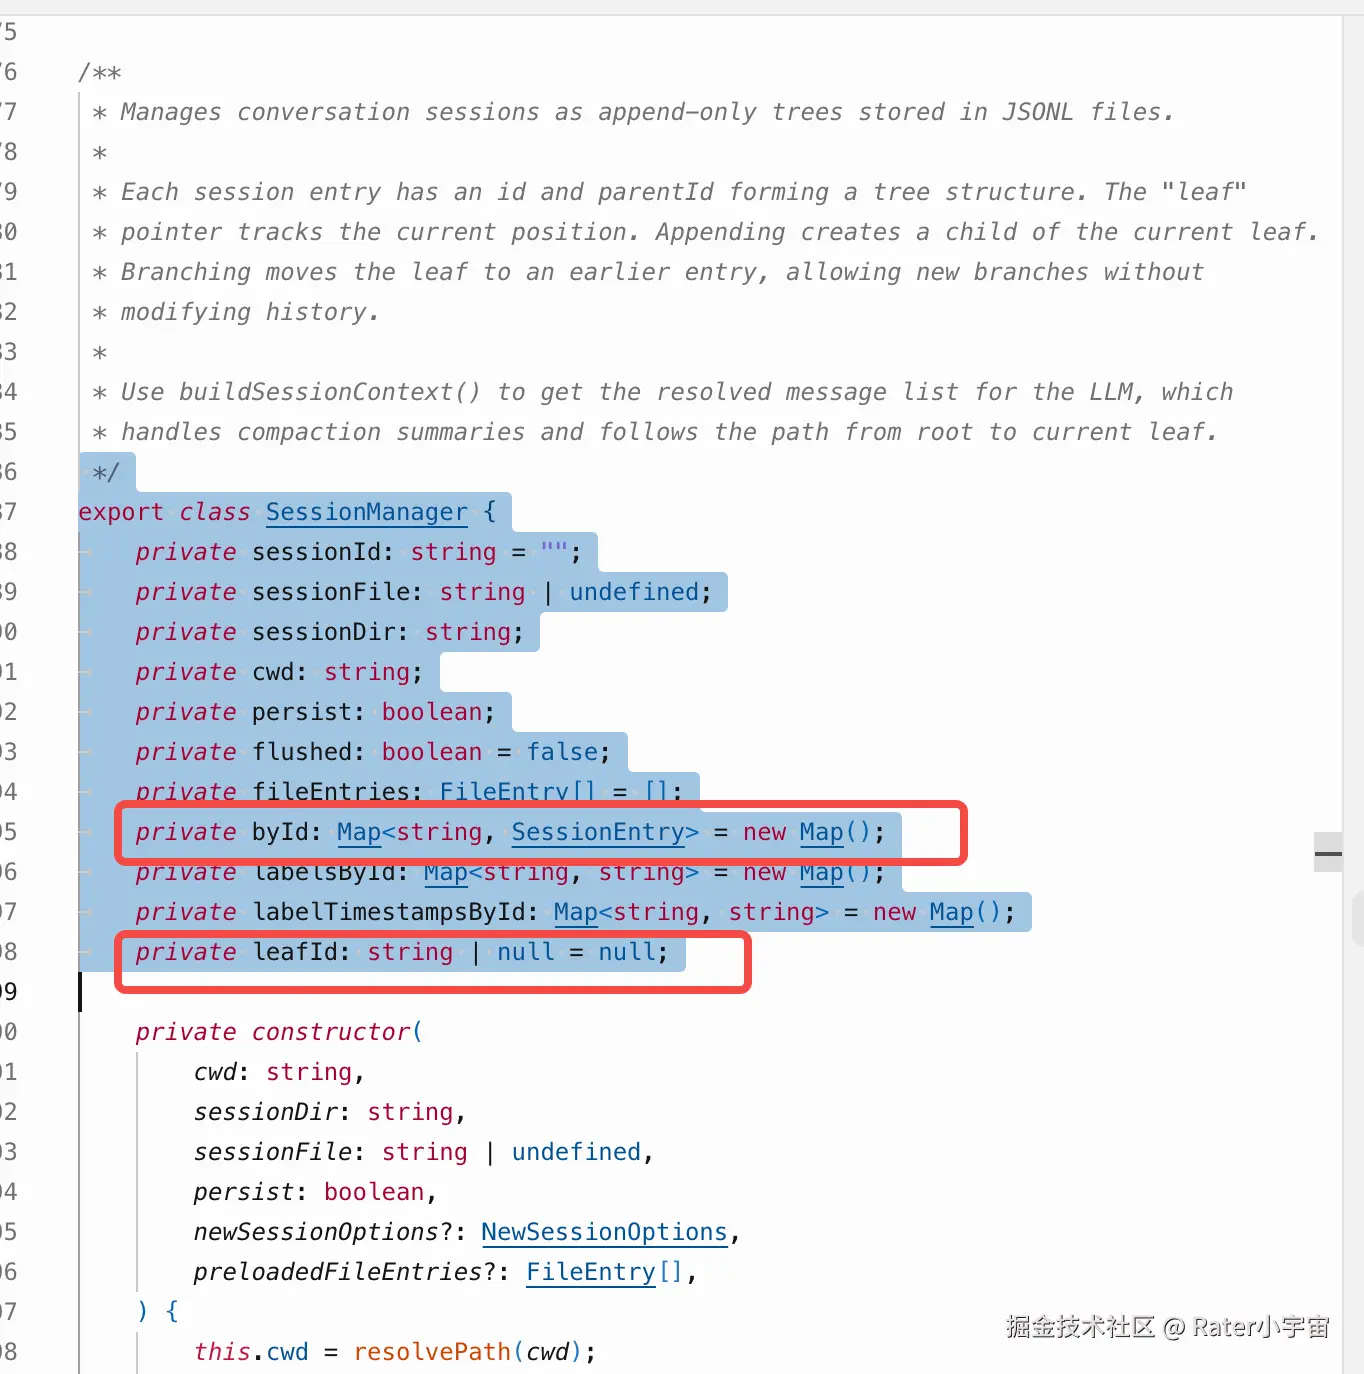
其中最关键的是:
byId 和 leafId: byId 用来快速找父节点;leafId 表示当前所在位置。
JSONL 文件示例
简化后可能如下:
ruby
{"type":"session","version":3,"id":"session-1","cwd":"/project"}
{"type":"model_change","id":"a1","parentId":null,"provider":"anthropic","modelId":"model-a"}
{"type":"message","id":"a2","parentId":"a1","message":{"role":"system","content":"..."}}
{"type":"message","id":"a3","parentId":"a2","message":{"role":"user","content":"读取 package.json"}}
{"type":"message","id":"a4","parentId":"a3","message":{"role":"assistant","content":[]}}
{"type":"message","id":"a5","parentId":"a4","message":{"role":"toolResult","content":[]}}
虽然物理文件是线性的,但 parentId 表达的是树结构。
消息如何持久化和恢复?
首先看如何持久化的,
Agent Loop 产生消息后,会发出: message_end事件。
以工具调用完为例:
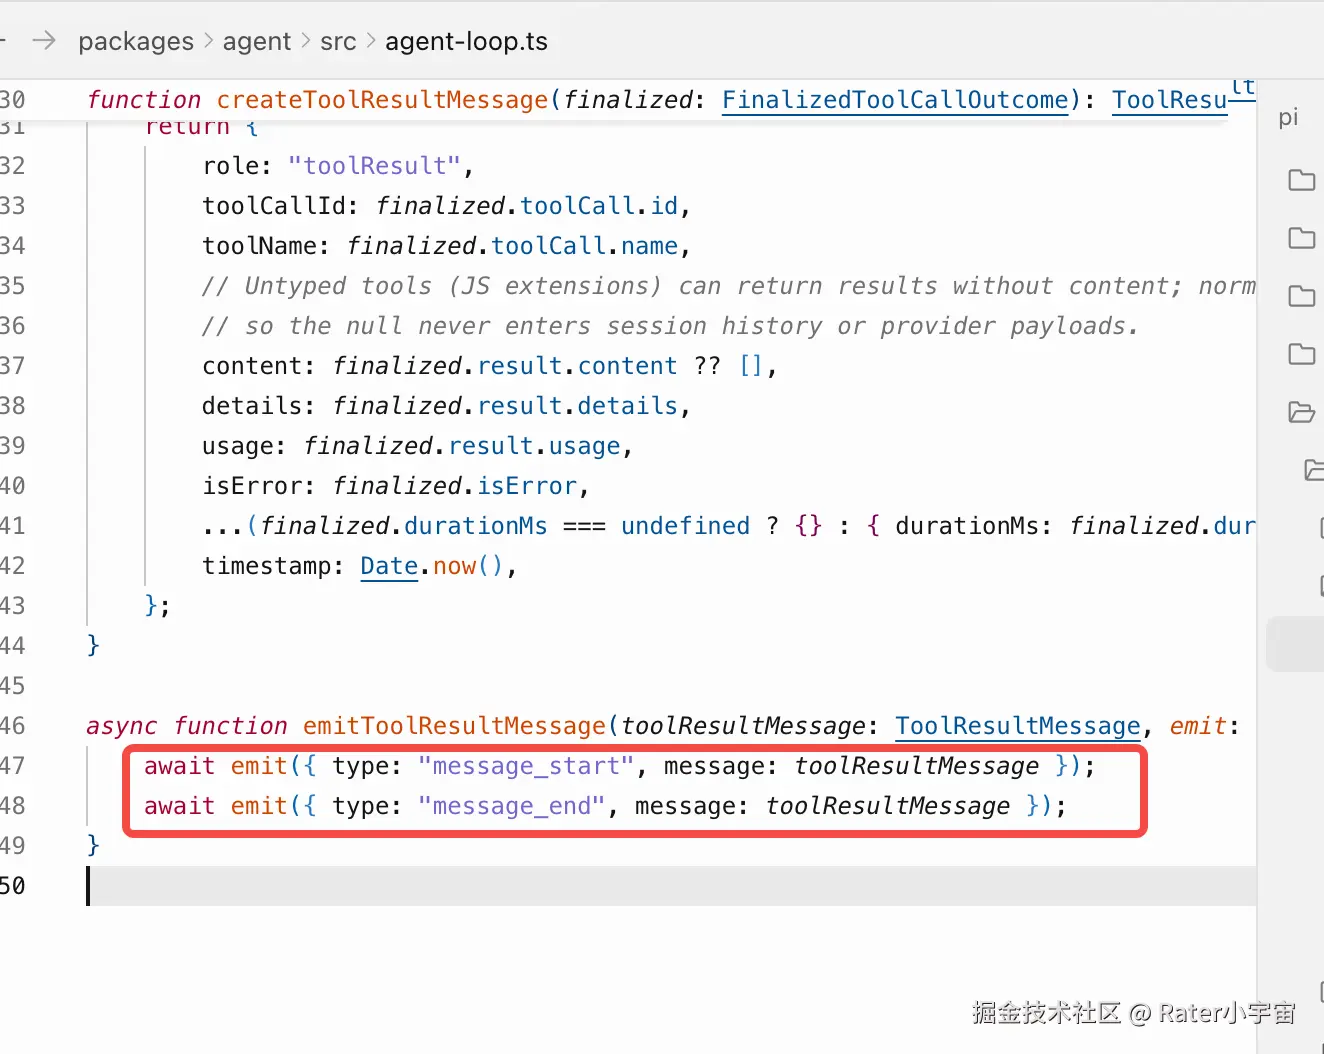
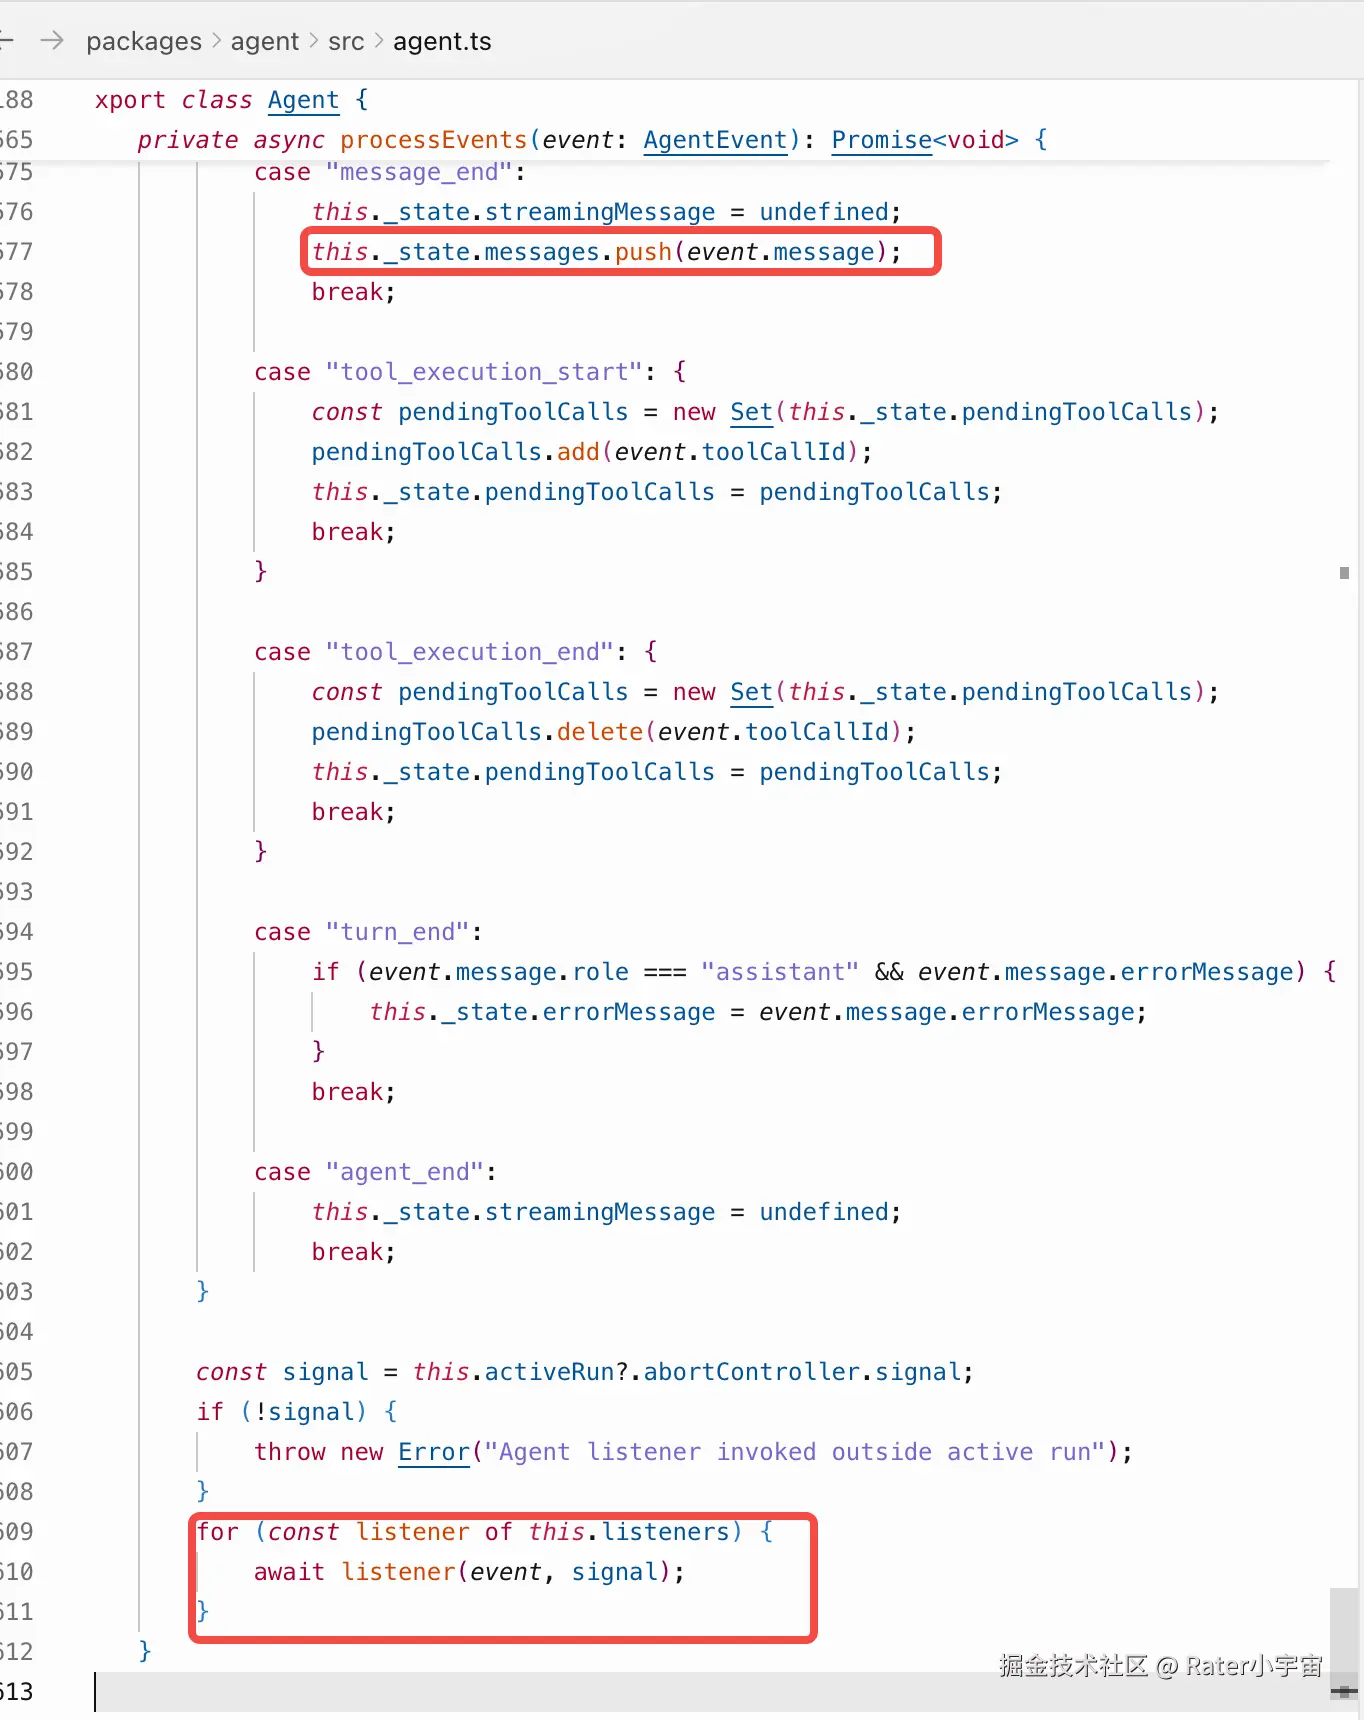
Agent.runPromptMessages() 调用 Agent Loop 时,把 processEvents() 作为事件接收器:
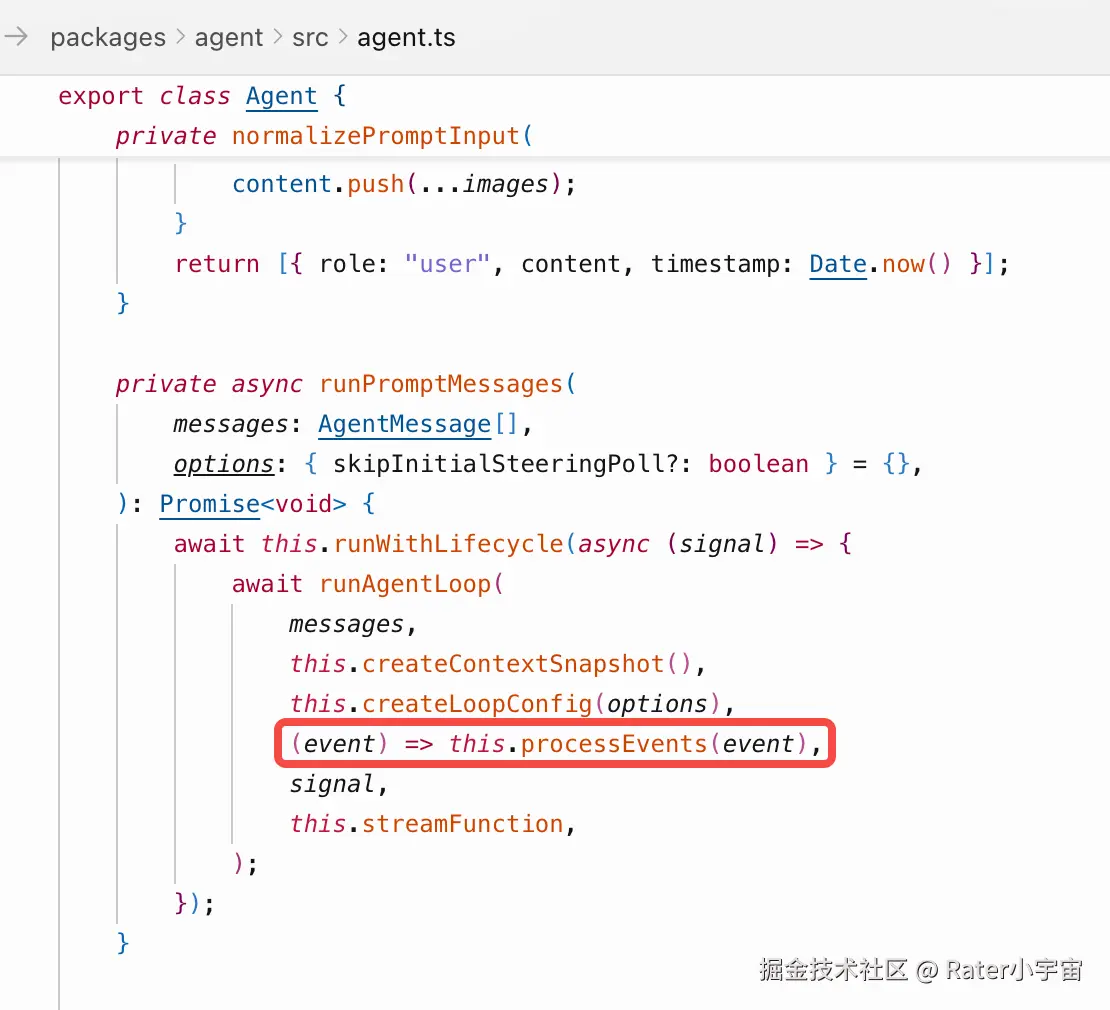
所以,processEvents()会收到message_end事件并处理,
收到message_end 后,Agent 先更新自己的运行时状态agent.state.messages
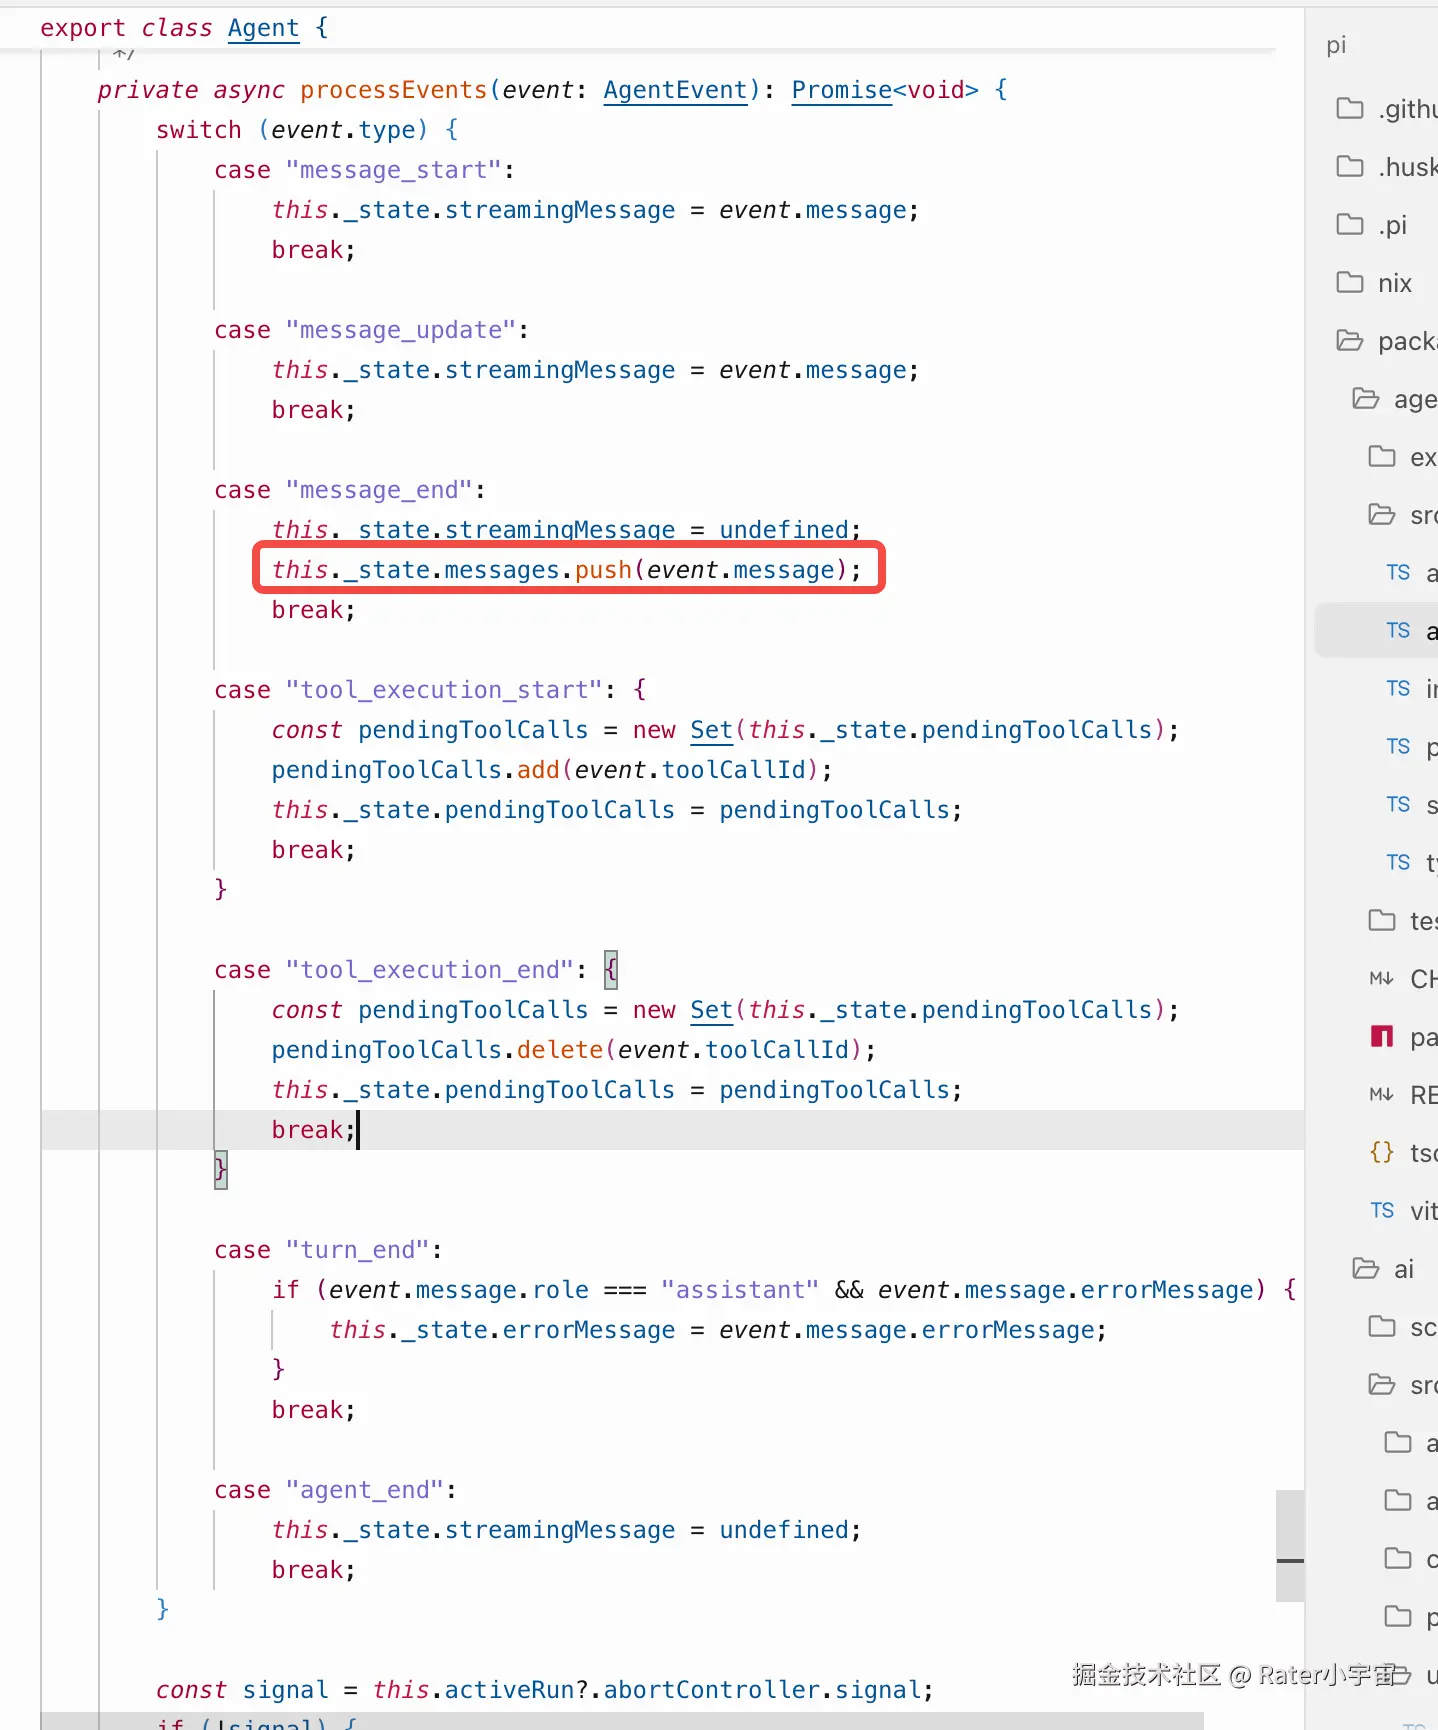
此时agent.state.messages已经包含这条消息,但它还不一定写入了 JSONL。
processEvents() 更新状态后,会按顺序调用所有订阅者:
然后会执行到AgentSession中的_handleAgentEvent方法
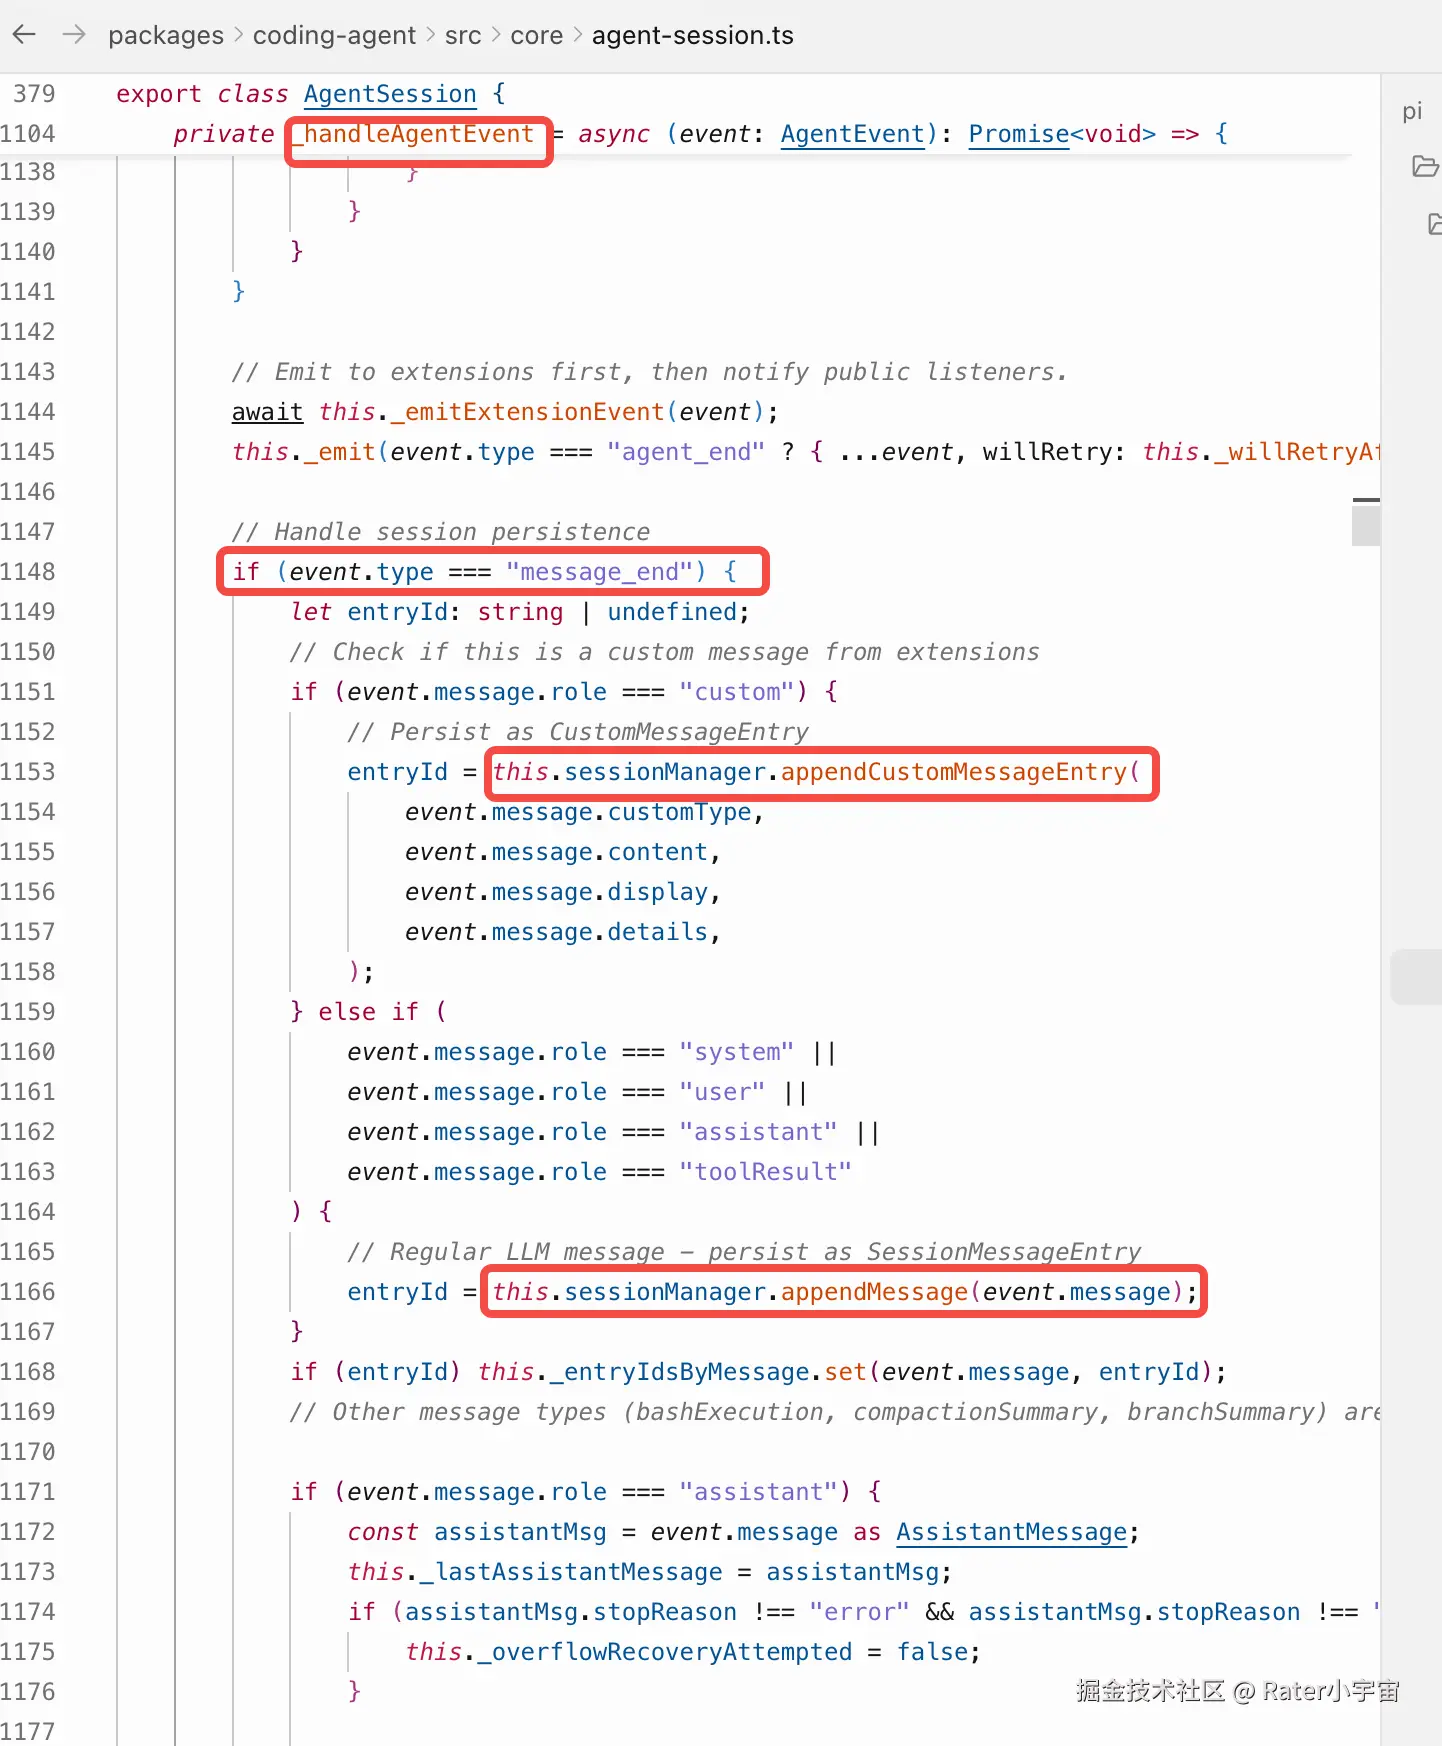
继续往后看,
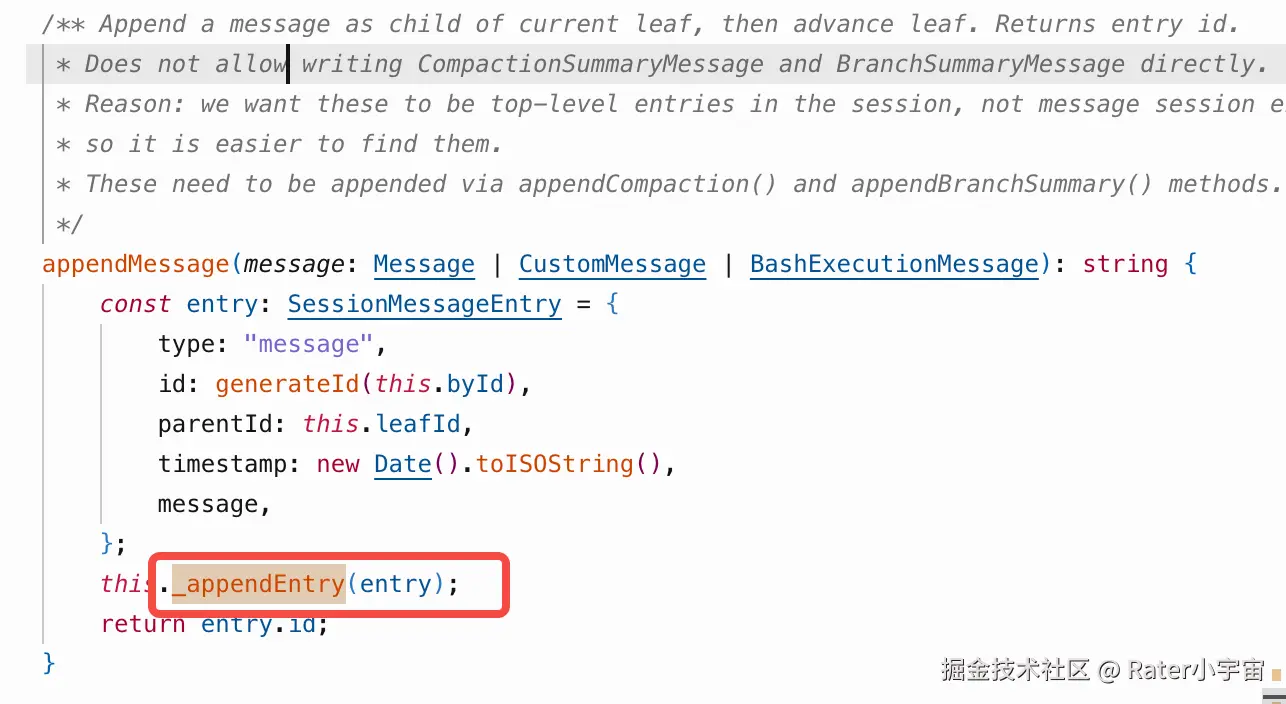
最主要是这个_appendEntry方法,
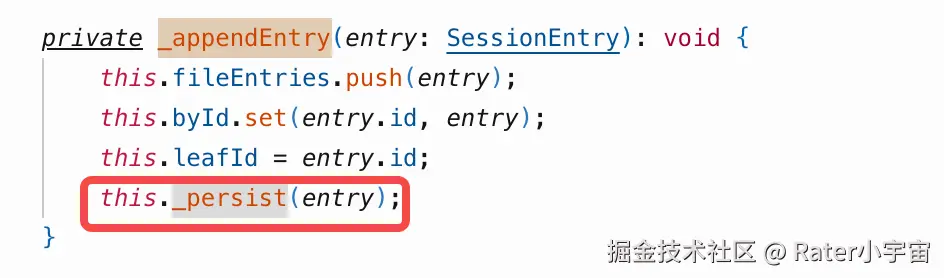
这里面最主要的是_persist方法
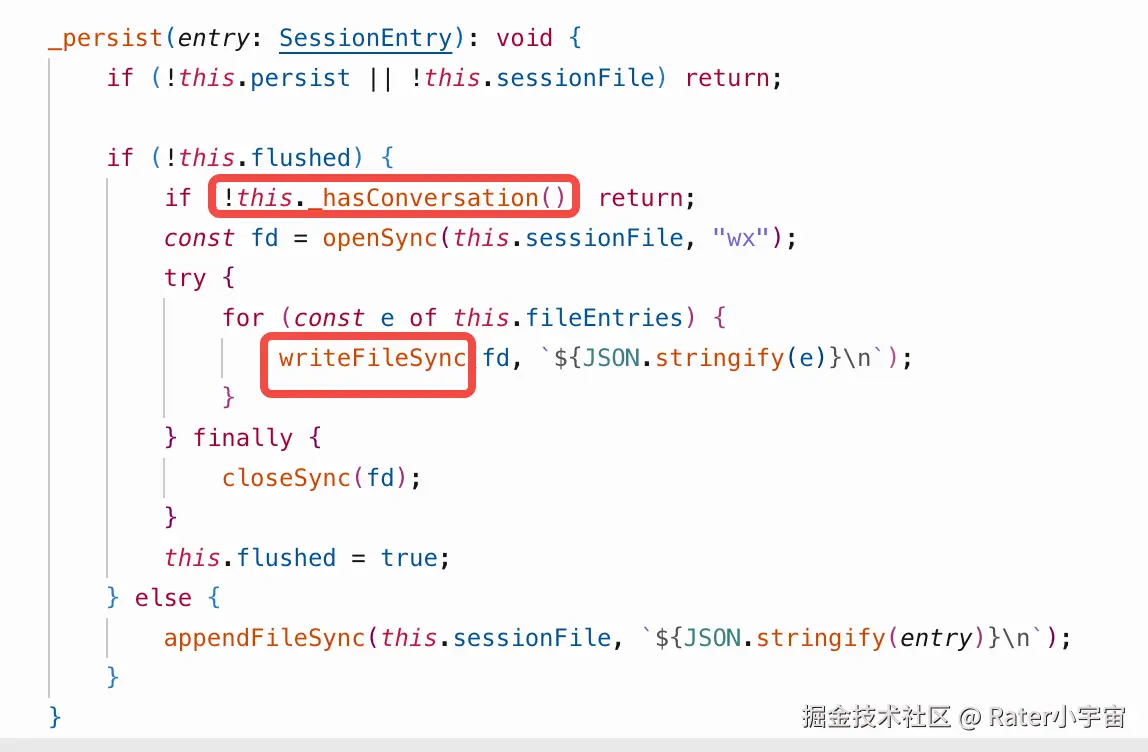
这里面有个细节,就是_hasConversation为true,也就是有UserMessage或者AssistantMessage的时候,才能写入文件
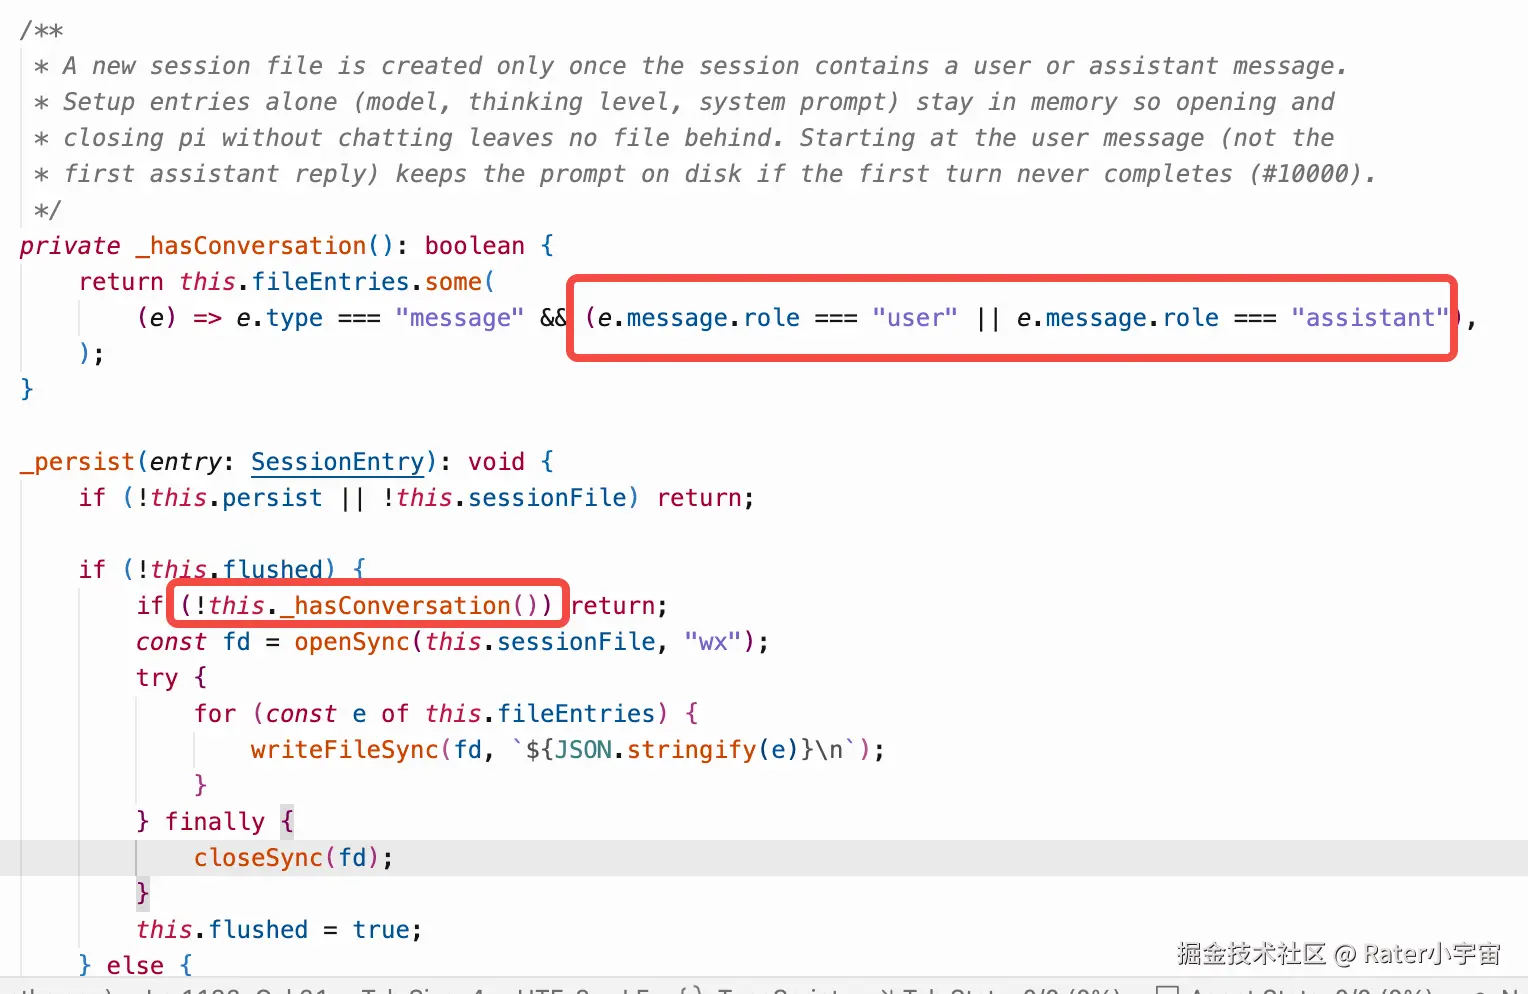
这就算持久化完成了。
完整的调用链如下
scss
Agent Loop 创建最终 Message
→ emit(message_end)

Agent.processEvents()
→ agent.state.messages.push(message)
→ 调用订阅者

AgentSession._handleAgentEvent()

SessionManager.appendMessage()
→ 创建 SessionMessageEntry

SessionManager._appendEntry()

SessionManager._persist()
Session增加使用append-only模式
例如想隐藏一条旧消息,Pi 不会直接修改 JSONL 中的旧记录,而是追加:
yaml
ContextEditEntry {
  targetId: "旧消息ID",
  replacement: null
}
想改变 Session 名称,也会追加新的 session_info。
这样不仅不破坏历史,而且易于审计和恢复。
Session Tree 和分支机制是如何实现的?
Tree 如何形成
每次追加 Entry 时:
ini
新 Entry.parentId = 当前 leafId
当前 leafId = 新 Entry.id
如何获得当前分支
主要是这个方法
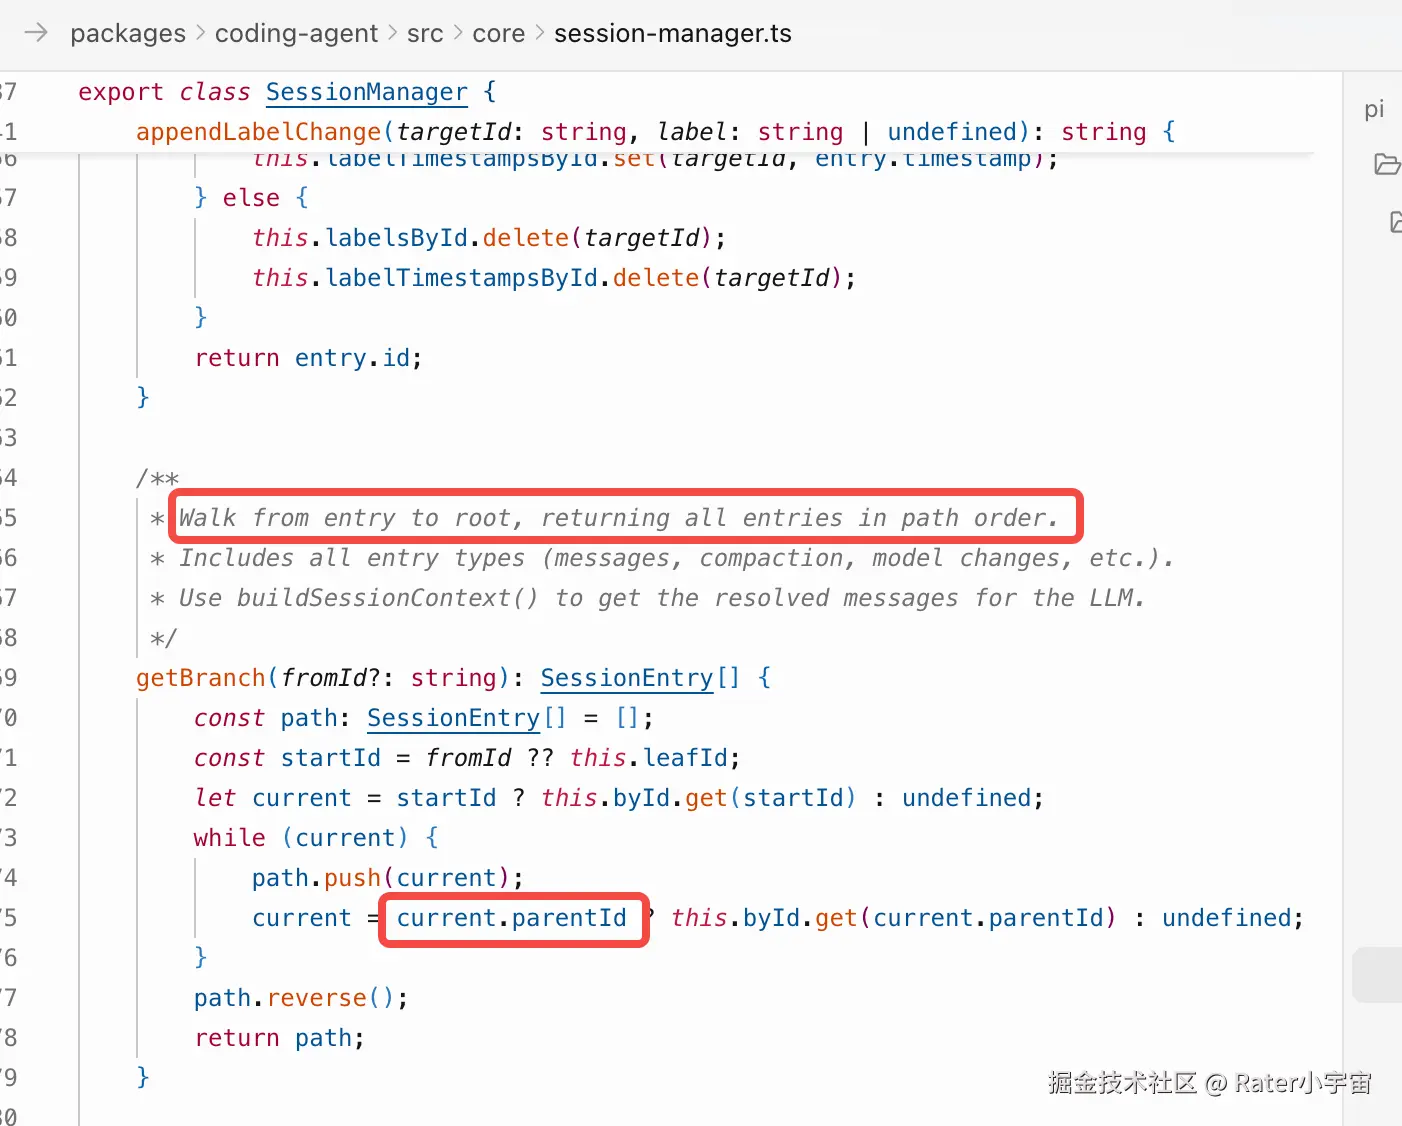
例如完整的事件为:
css
A → B → C → D → E从 E 回溯:
css
E → D → C → B → A最后反转:
css
A → B → C → D → E这就是当前有效分支。
如何创建分支
假设原来的树是:
css
A → B → C → D → E用户想回到 C,并从那里继续。
调用:
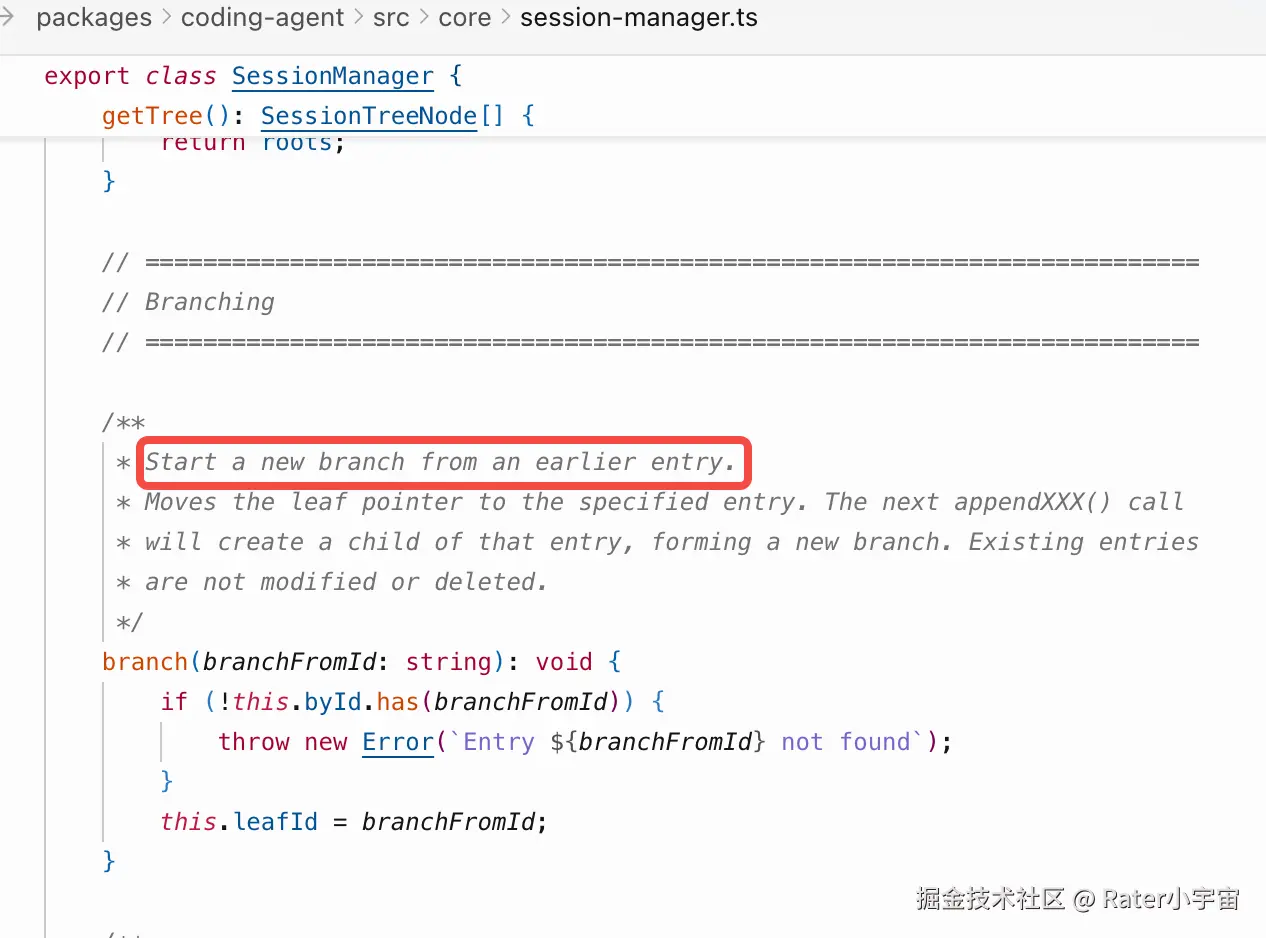
branch("C") 只做一件事:
leafId:E → C它不会删除 D、E,也不会立即写入新 Entry。
下一次追加消息 F:
ini
F.parentId = C
leafId = F
最终形成
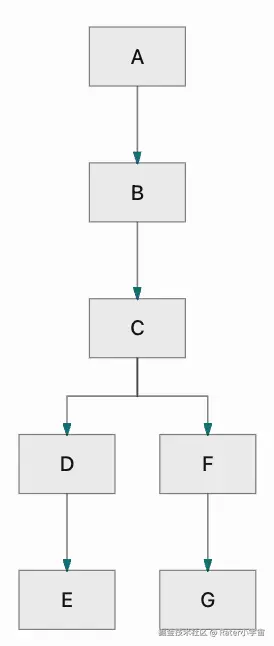
关于branchWithSummary
例如完整的事件为:
css
A → B → C → D → E现在,我们要从C处开始切新分支,
普通 branch() 会直接切换到旧节点C,
D、E 不会进入新 Context。
如果希望模型知道被放弃分支发生过什么,可以使用:
branchWithSummary()
例如:
旧分支 D → E:
尝试修改认证代码,但测试失败
切回 C 后添加:
BranchSummaryEntry:
"之前尝试修改认证代码,但测试失败,已回退。"
树变成:
css
A → B → C → D → E
          \
           S(branch_summary) → F
新 Context 是:
css
A → B → C → BranchSummary → F这样不会保留旧分支的全部细节,但保留了重要结论
getTree() 和 buildSessionContext() 的区别
getTree():
返回完整 Session Tree,包括所有分支
主要用于:
Session Tree UI、分支选择、调试和浏览历史。
buildSessionContext():
只返回当前 leaf 对应的有效分支
主要用于: 恢复 Agent、构建 LLM Context、Compaction、下一次模型请求。
四、Context 构建
每次调用 LLM 时,上下文是如何构建的?
核心就是一句话:
每次 LLM 调用前,Pi 都从当前 Session 分支重新构建 Context;工具调用和结果作为正常消息写回 Session,并参与下一轮推理。
调用链
scss
Session Tree
→ buildSessionProjection()
→ 当前分支的 AgentMessage[]
→ prepareRequest() 替换 AgentContext.messages
→ transformContext()
→ convertToLlm()
→ normalizeContext()
→ LLM
下面我们来依次介绍:
先介绍下:buildSessionProjection()
它主要做了五件事:
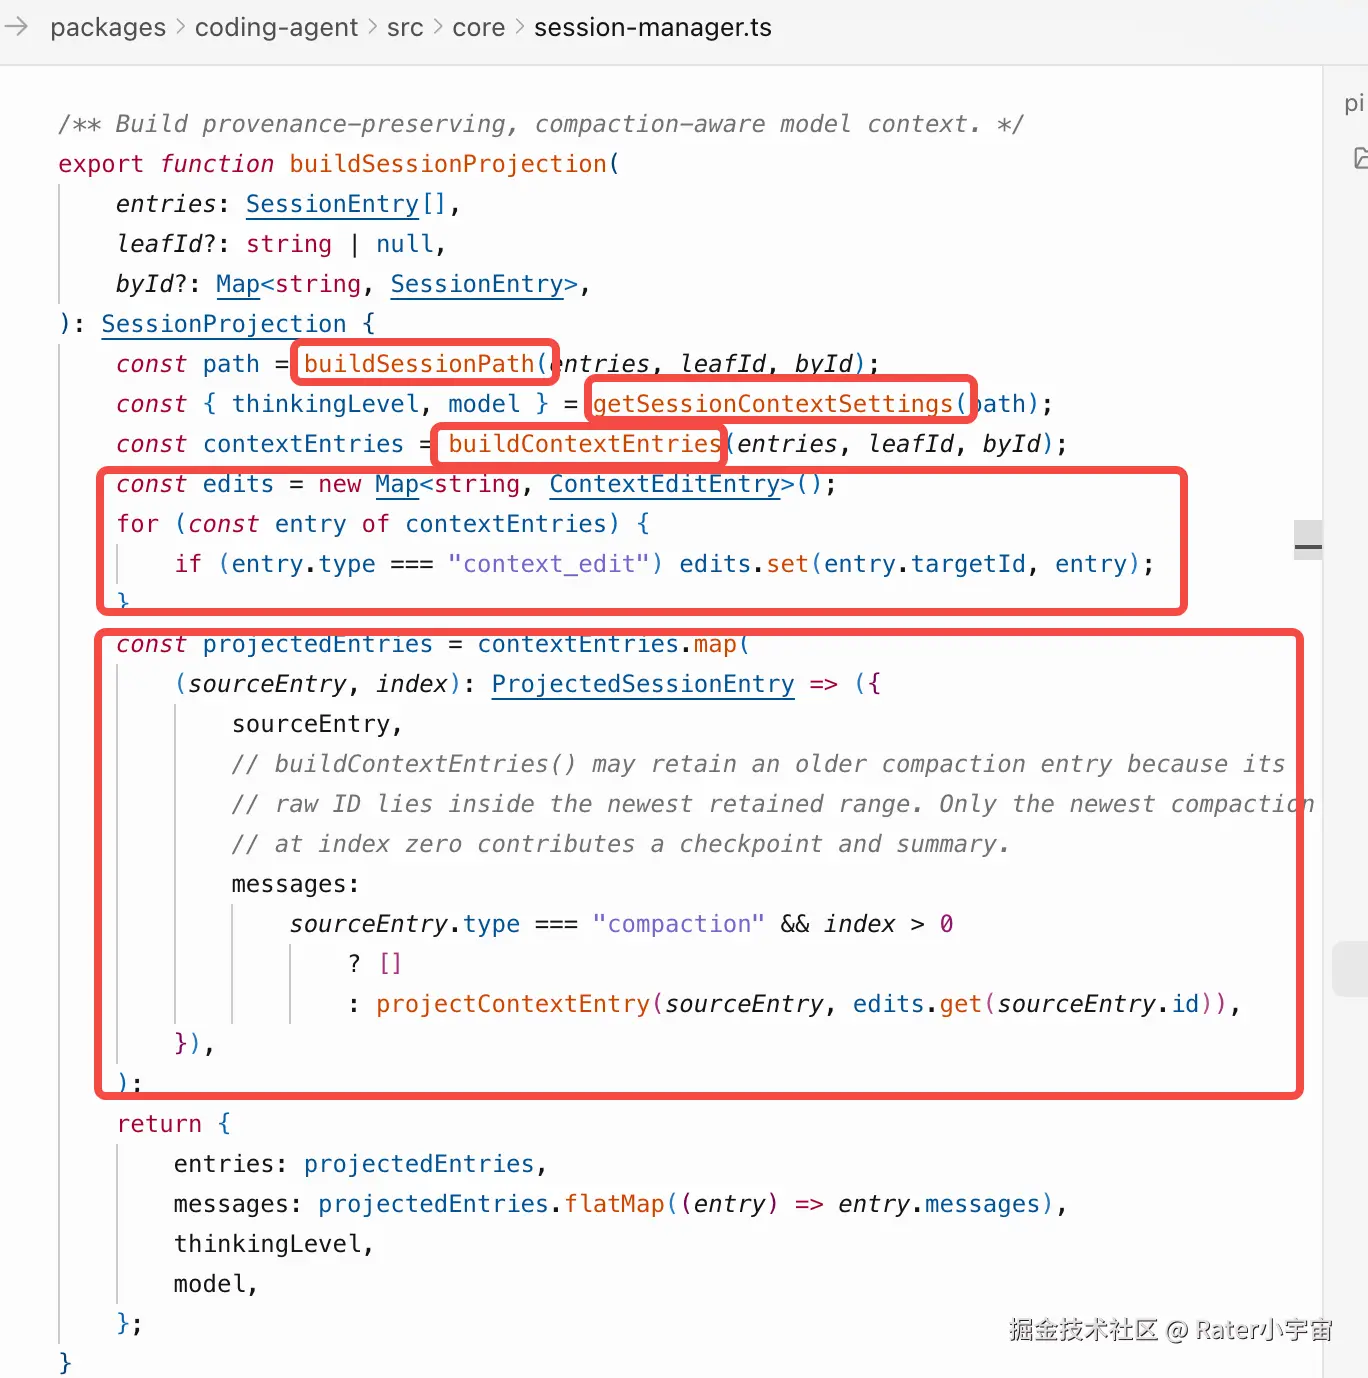
1. 获取当前分支
ini
const path = buildSessionPath(entries, leafId, byId);从当前 leafId 沿 parentId 回溯到根:
css
完整树:A → B → C → D
                ↘ E → F

leafId = F
当前 path = A → B → C → E → F
2. 恢复模型和 Thinking Level
scss
const { thinkingLevel, model } = getSessionContextSettings(path);遍历当前分支中的: model_change、thinking_level_change、AssistantMessage 中记录的模型,得到当前配置。
3. 应用 Compaction
ini
const contextEntries = buildContextEntries(entries, leafId, byId);如果没有 Compaction:
ini
contextEntries = 当前完整分支4. 应用 Context Edit
先收集当前分支上的 context_edit:
typescript
const edits = new Map<string, ContextEditEntry>();然后处理每个 Entry:
ini
replacement = null
→ 该消息从 Context 删除

replacement = { content: "新内容" }
→ 替换消息内容

没有 edit
→ 保持原消息
多个 edit 指向同一消息时,后面的 edit 生效。
这里好像出来的莫名其妙,怎么突然多出来一个edit?
Context Edit 是什么
它的目的是:找出哪些旧消息需要修改
假设 Session 原始记录是:
scss
E1:UserMessage("删除数据库")
E2:AssistantMessage("准备执行")
E3:ContextEdit(targetId=E1, replacement="读取数据库")
Pi 不会修改 E1,因为 Session 是 append-only,而是追加 E3。
buildSessionProjection() 先建立:
ini
edits = {
  E1 → E3
}
处理 E1 时发现存在 Edit,于是投影结果变成:
scss
原始 Session:
UserMessage("删除数据库")

最终 Context:
UserMessage("读取数据库")
原始 JSONL 中的 E1 仍然是"删除数据库",只是模型看到的是替换后的版本。
如果:
ini
ContextEdit(targetId=E1, replacement=null)那么 E1 的投影结果是:
css
[]也就是不进入 Context。
ContextEdit 自身也不会作为消息发送给模型。
5. 转换并合并 Message
每个 SessionEntry 通过:
scss
projectContextEntry()
→ sessionEntryToContextMessages()
转换成零条、一条或多条 AgentMessage:
Entry 为什么还要转换成 Message
因为 SessionEntry 不全是消息。
例如:
ModelChangeEntry
LabelEntry
ThinkingLevelChangeEntry
SessionInfoEntry
这些是 Session 状态,LLM 不应该看到。
prepareRequest怎么执行的
它的作用是:
在每次真正调用 LLM 前,用 SessionManager 计算出的最新消息,替换 Agent Loop 当前持有的消息。
执行的位置:
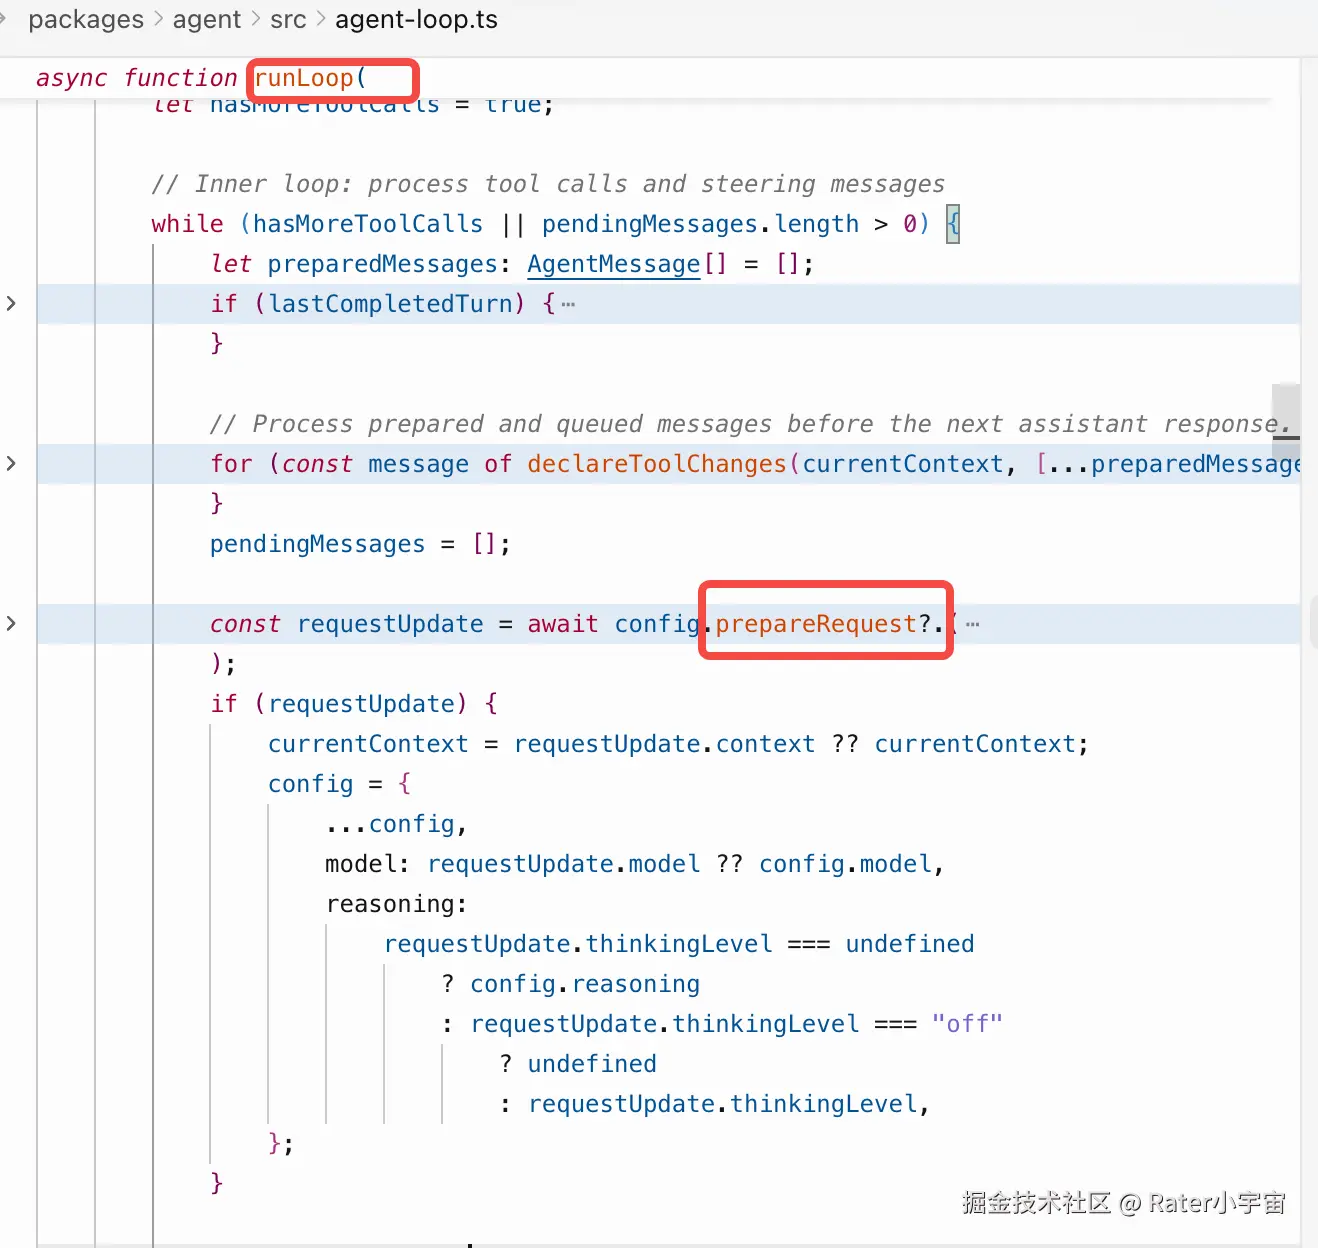
然后会执行到这里:
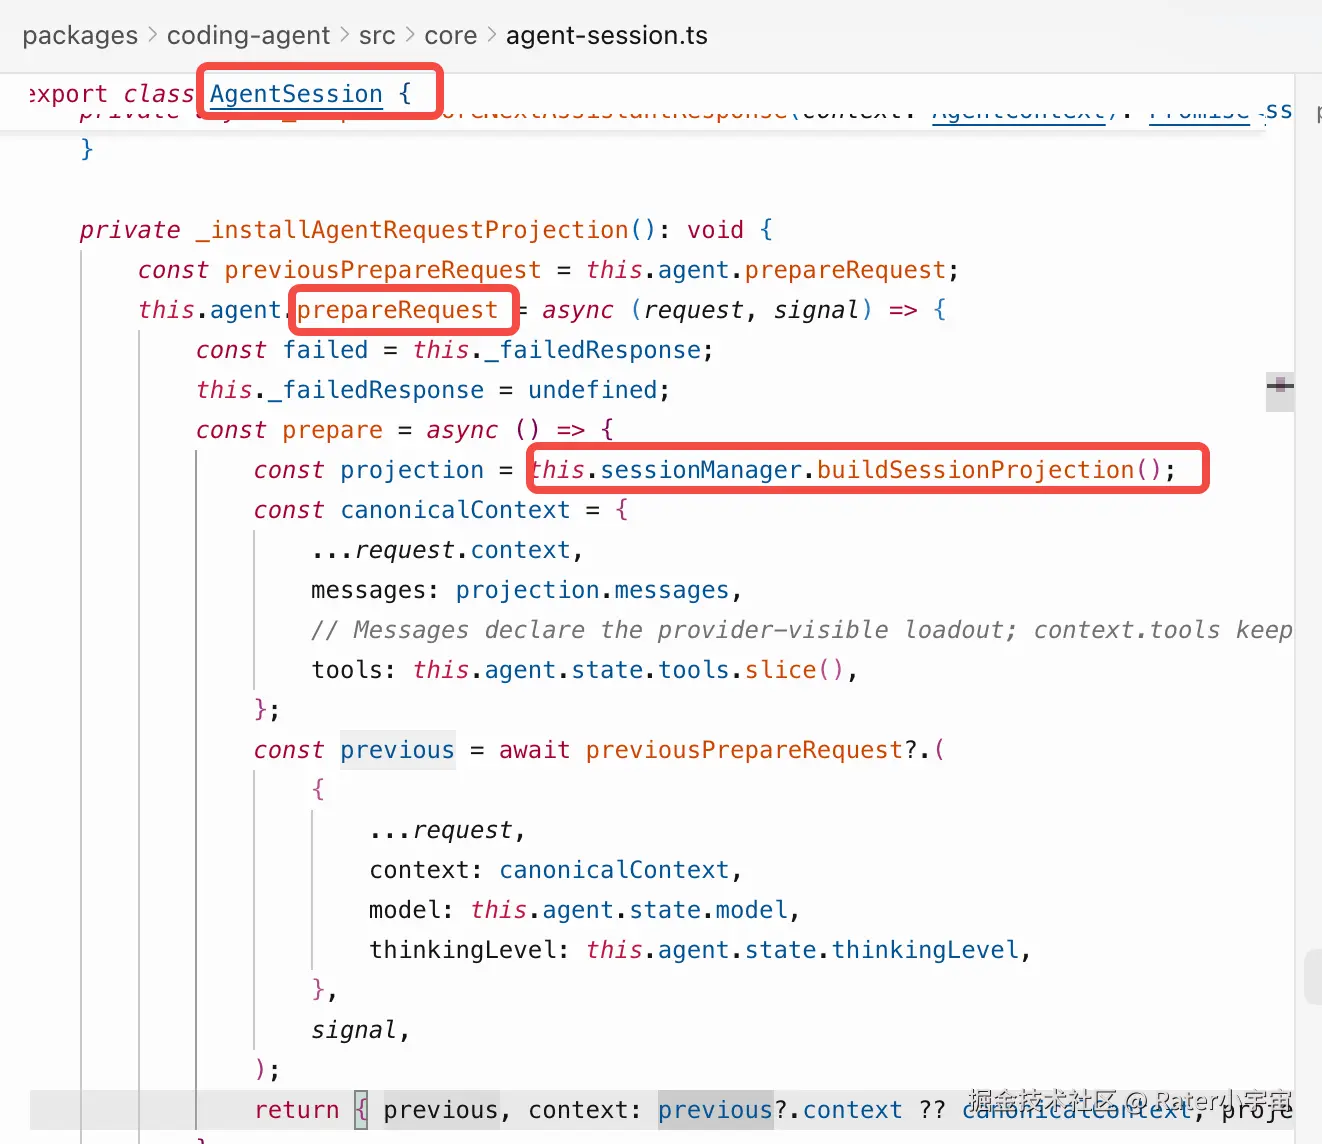
从而重新构建投影。
为什么需要替换
Agent Loop 开始时拿到的是一个快照:
ini
AgentContext.messages = 启动 Agent Loop 时的消息但运行过程中可能发生:
分支或摘要变化、Compaction、Context Edit、新消息已经持久化到 Session 等
所以 LLM 请求前,要以 Session 的最新投影为准。
举个例子
Agent Loop 原来的 Context:
ini
currentContext.messages = [
  UserMessage("旧问题"),
  AssistantMessage("旧回答")
]
此时 Session 中发生了 Compaction:
ini
SessionProjection.messages = [
  CompactionSummaryMessage("之前讨论了认证设计"),
  UserMessage("继续实现")
]
prepareRequest() 后:
ini
currentContext.messages = [
  CompactionSummaryMessage("之前讨论了认证设计"),
  UserMessage("继续实现")
]
接下来 streamAssistantResponse() 使用替换后的 Context 调用 LLM。
完整流程:
scss
Agent Loop 准备请求
→ prepareRequest()
→ buildSessionProjection()
→ 得到最新 messages
→ 替换 currentContext.messages
→ convertToLlm()
→ 调用 LLM
transformContext()
它可以在请求发给LLM前,对Message再做一次修改。
举个例子:
假设 Session 构建出的消息是:
css
[ SystemMessage("你是编程助手"), UserMessage("读取密码文件"), AssistantMessage("好的"), UserMessage("继续")]在发送给 LLM 前,transformContext() 可以临时把消息变成:
css
[ SystemMessage("你是编程助手,禁止读取敏感文件"), UserMessage("继续")]三者的区别:
scss
prepareRequest()
负责:从 Session 取出正确的历史消息

transformContext()
负责:临时决定这一次请求让模型看到什么

convertToLlm()
负责:把 AgentMessage 转成 LLM 支持的 Message
其实就是一层hook。
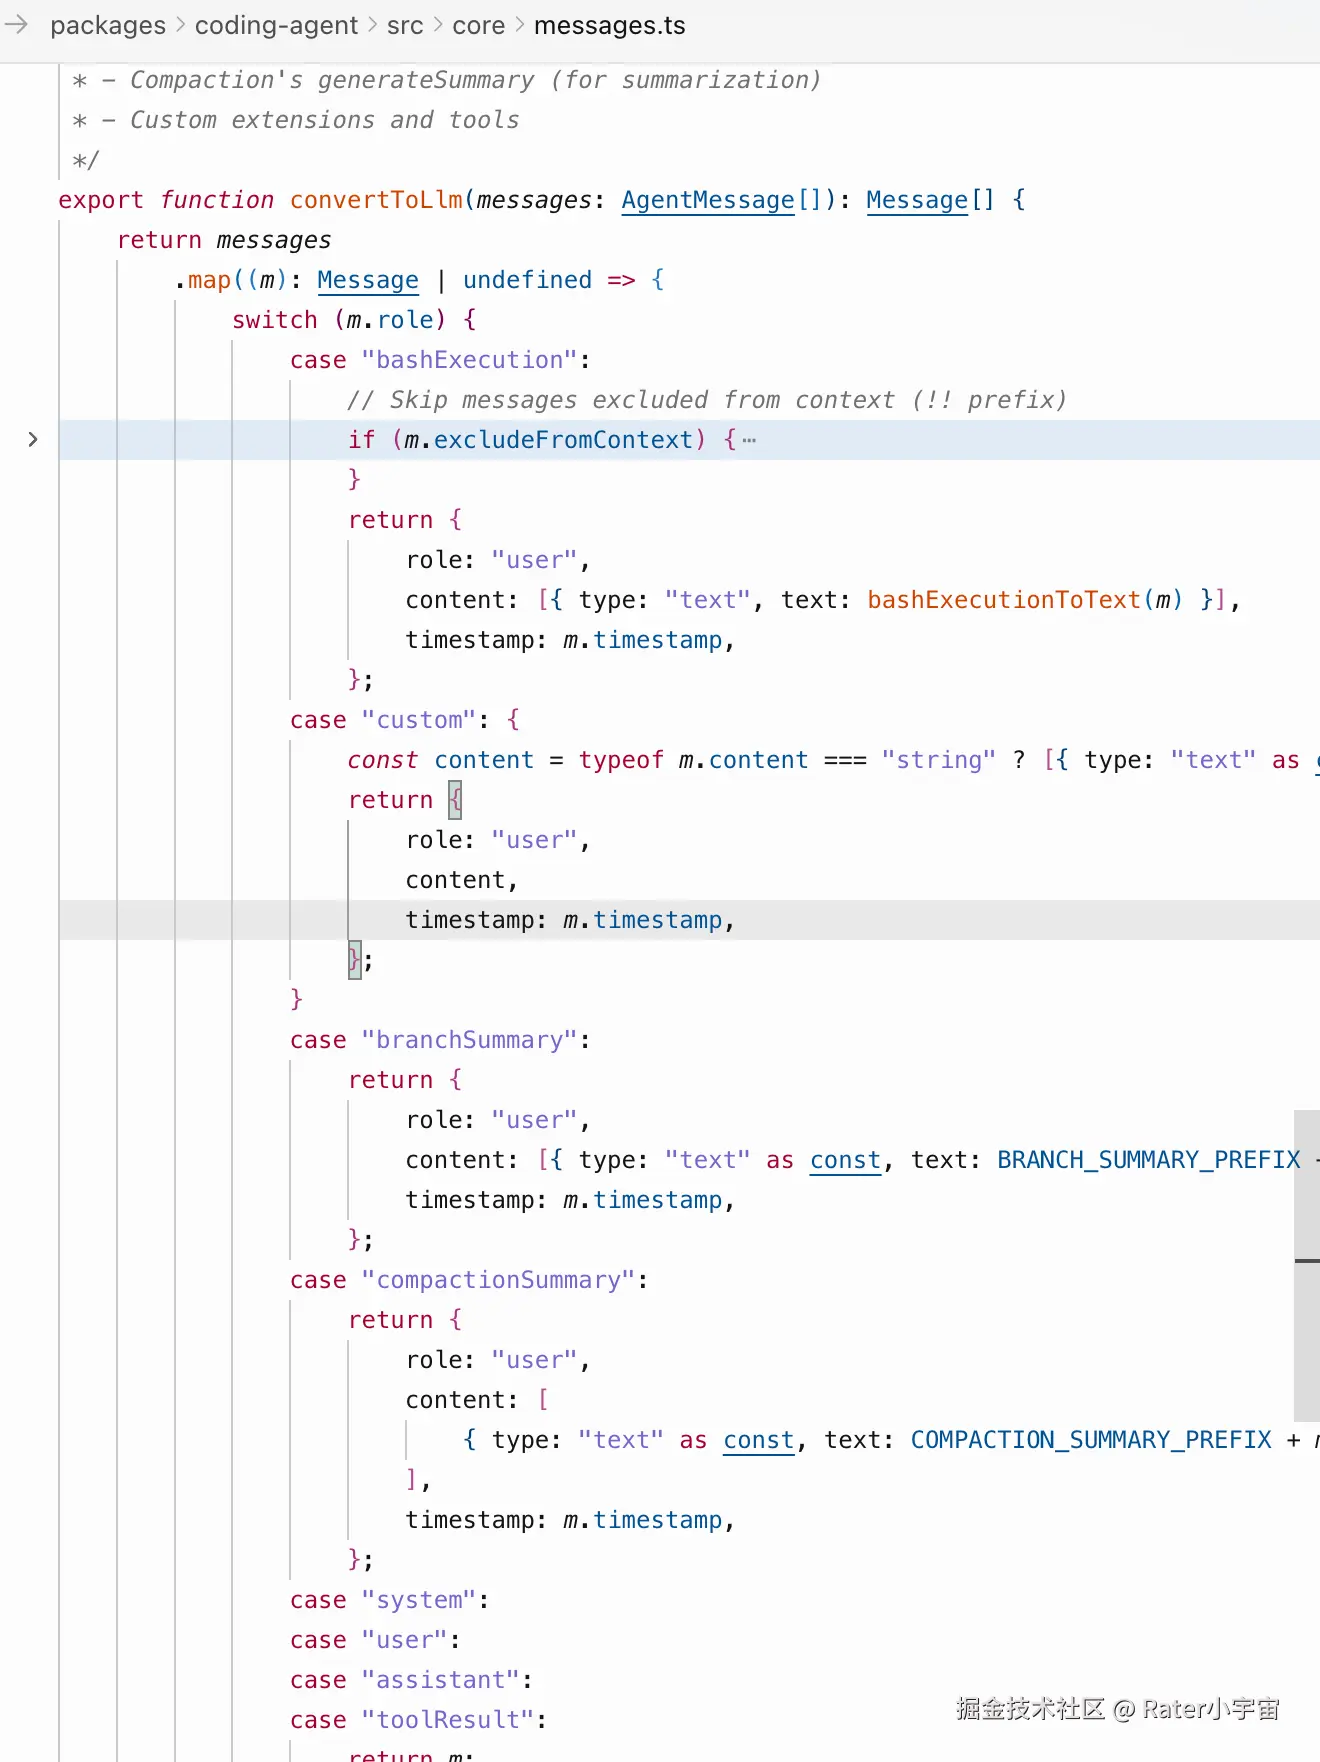
convertToLlm()
它的作用:
把 Pi 内部的 AgentMessage[] 转换成 LLM 能理解的标准 Message[]。
为什么需要转换
Pi 内部有这些扩展消息:
vbnet
bashExecution
custom
branchSummary
compactionSummary
但 LLM 层只认识:
sql
system
user
assistant
toolResult
所以需要转换。
具体转换的逻辑,其实前面已经介绍过了,这里就不再重复
normalizeContext()
convertToLlm() 已经准备好了消息内容:
css
[ { role: "user", content: "你好" }]但 Provider 接收的不是裸消息数组,而是统一的请求对象:
css
{
  messages: [
    { role: "user", content: "你好" }
  ]
}
normalizeContext() 就负责这个包装。
也就是进行请求LLM前的最后一步。
哪些消息会进入 Context Window?
主要经过这几道筛选。
完整判断链:
scss
buildSessionPath()
选择当前分支

→ buildContextEntries()
应用 Compaction

→ buildSessionProjection()
应用 Context Edit、Entry 转 Message

→ transformContext()
扩展临时修改

→ convertToLlm()
过滤或转换特殊消息

→ 最终 Context Window
总之,记住一句话:
Context Window 不是接收完整 Session,而是接收当前分支的有效投影。
五、Compaction(重点)
Compaction,其实就是压缩。
它不会删除 Session 历史,而是追加一条 CompactionEntry,用摘要替代较老消息,同时保留近期消息原文。
为什么需要 Compaction?什么时候触发?
模型有固定的 contextWindow。历史不断增长后,请求可能超过模型限制。
因此,需要Compaction。
触发条件:
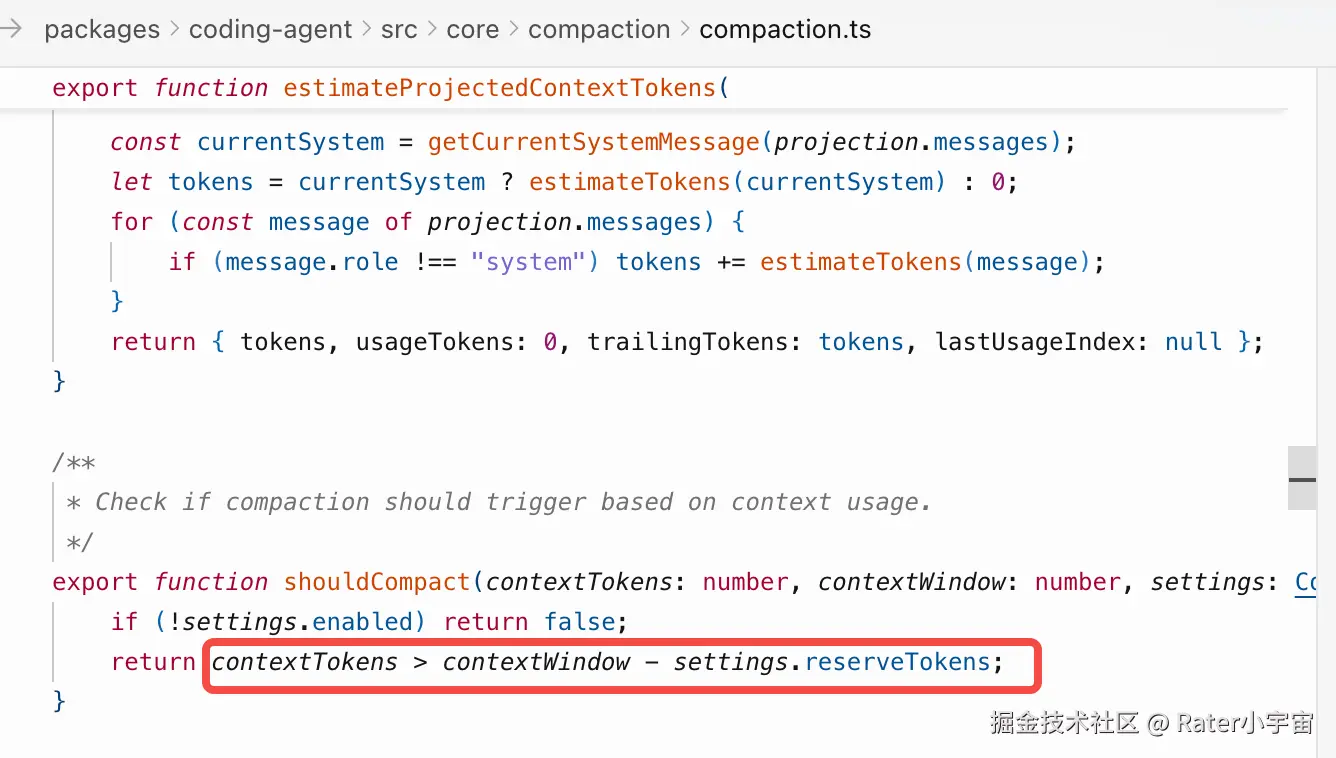
触发的时机:
Compaction 有四个主要触发时机:
1. 用户提交新 Prompt 后、请求 LLM 前
scss
用户调用 prompt()
→ _prepareRun()
→ _checkCompaction()
→ 必要时先摘要
→ 再创建并发送新的 UserMessage
此时用户已经提交输入,但新 UserMessage 还没有加入 Agent Loop。主要用于处理上一次中断后已经过长的 Context。
2. Assistant 响应完成后
scss
AssistantMessage 完成
→ _handlePostAgentRun()
→ _checkCompaction()
→ 必要时立即摘要
这是最常见的自动触发点,因为 AssistantMessage 中有最新 token usage,可以准确判断 Context 是否接近上限。
3. Tool Call 完成、准备下一次 LLM 请求前
scss
Assistant Tool Call
→ ToolResult
→ prepareNextTurn()
→ _compactBeforeNextAssistantResponse()
→ 必要时摘要
→ 下一次 LLM 请求
防止工具结果过大,导致下一轮请求超过 Context Window。
4. 用户手动触发
bash
/compact
→ AgentSession.compact()
不需要等待新的用户消息或模型响应。
总共是这四个时机。
具体实现流程
首先,它还是基于当前分支工作,所以第一步还是buildSessionProjection
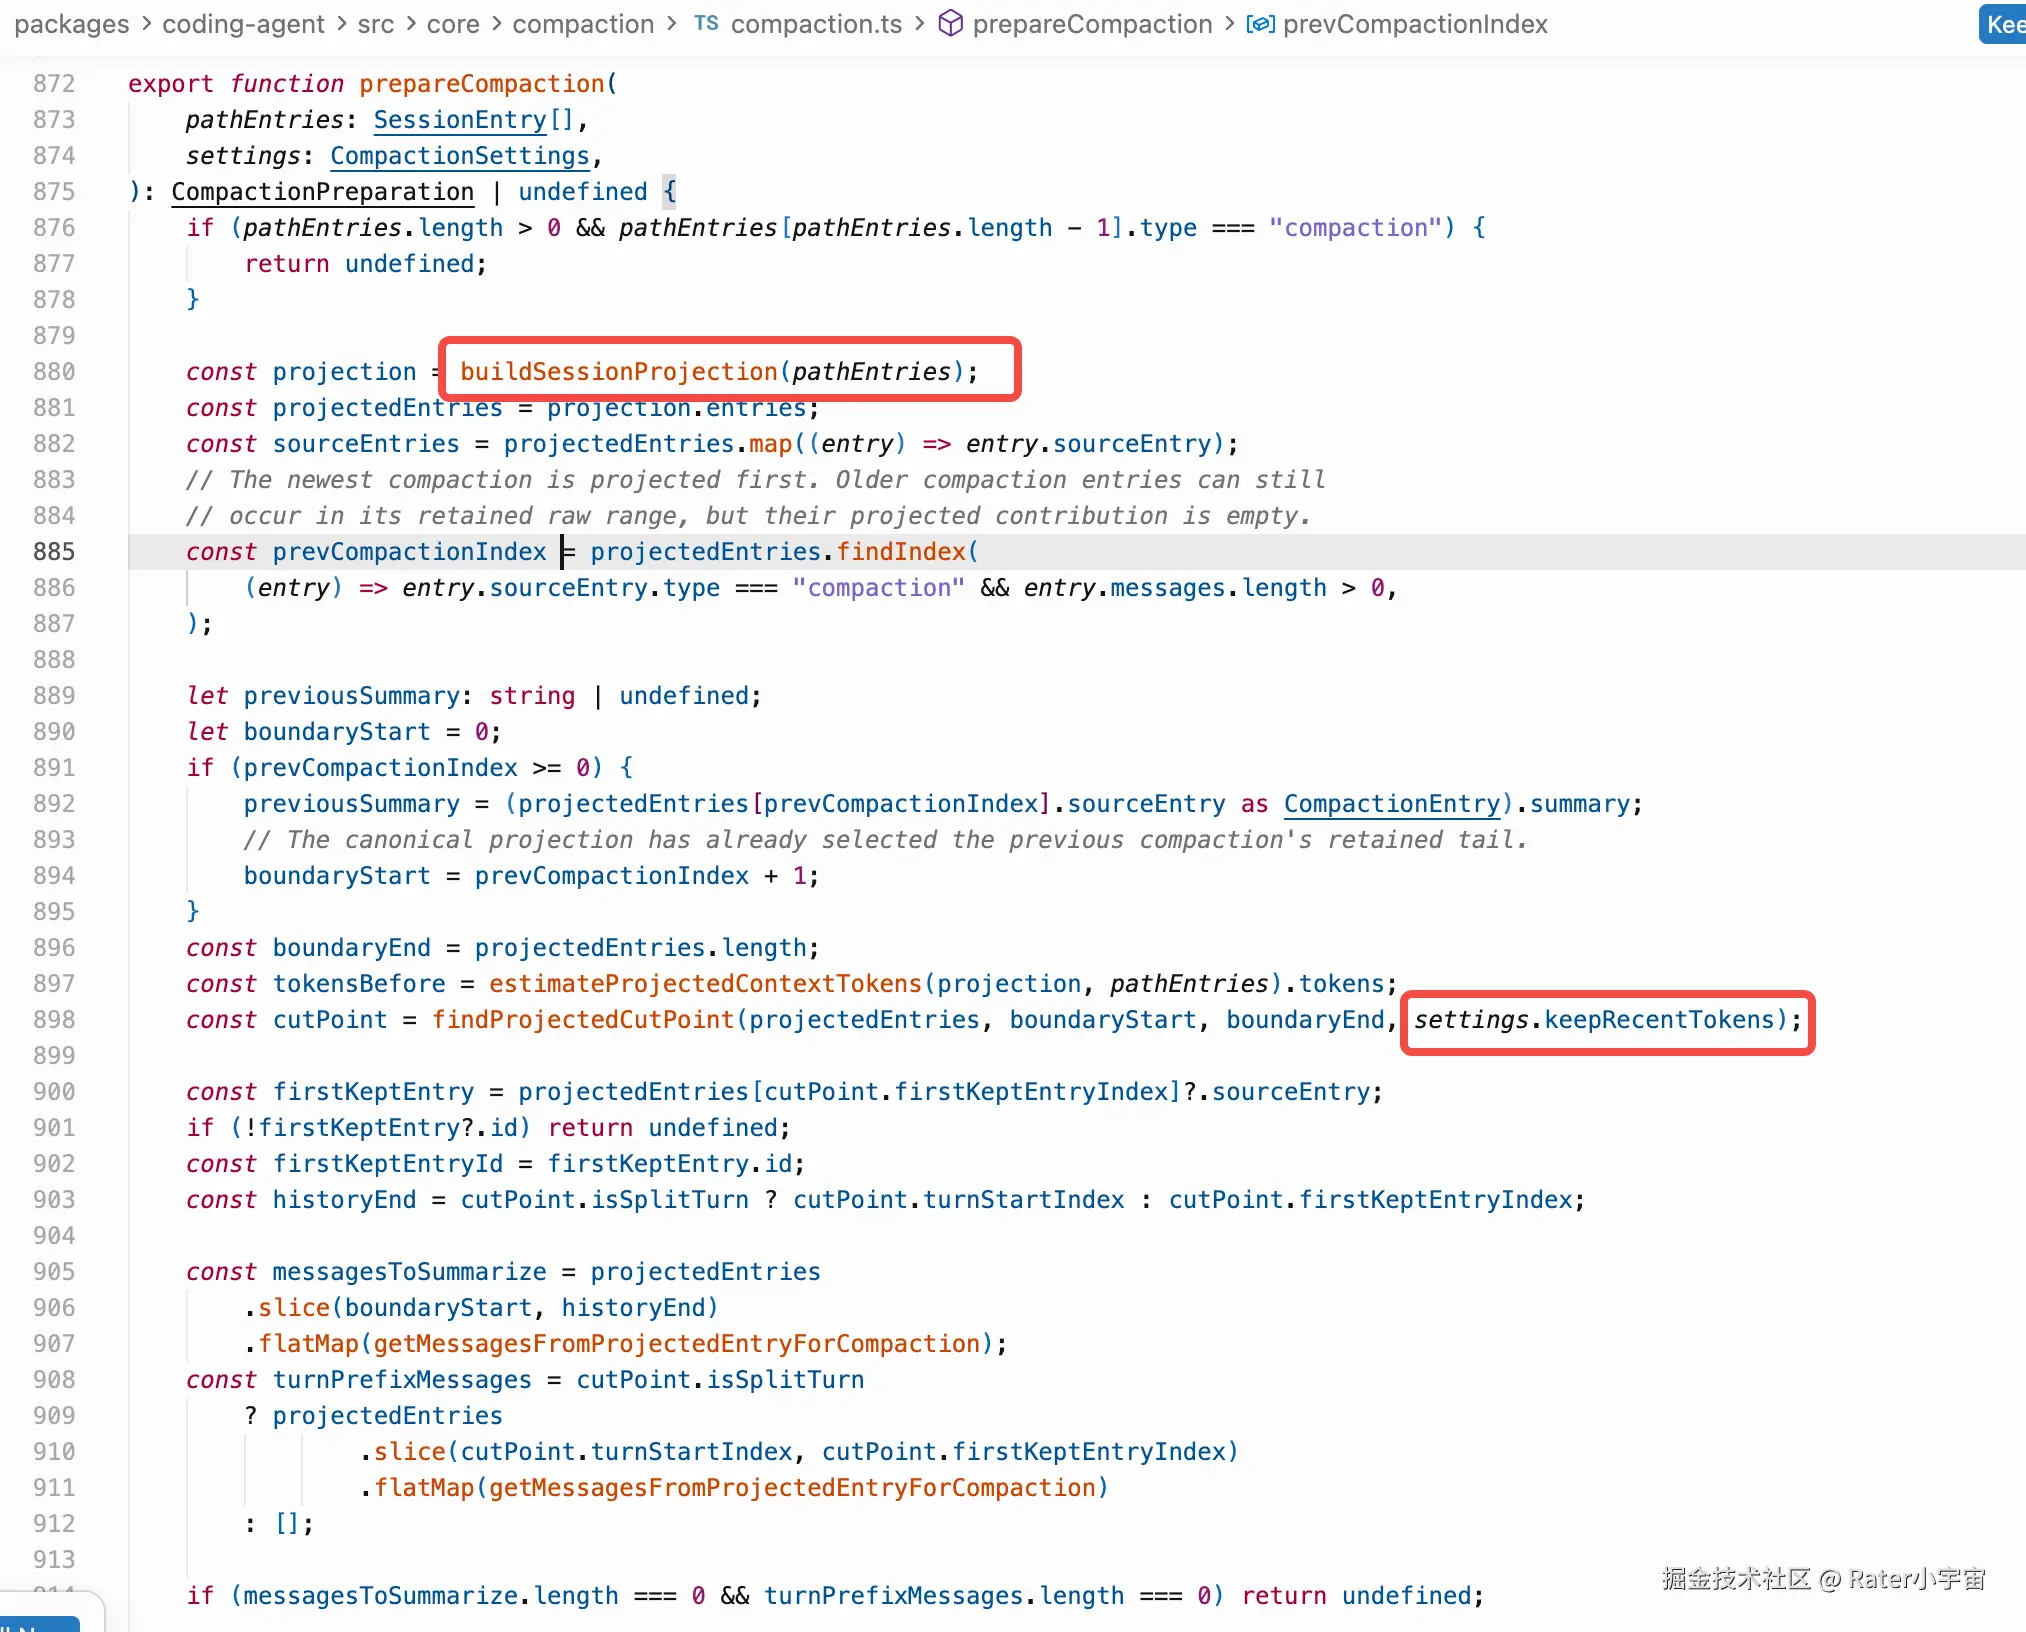
第二步就是从后向前找切分点,
Pi 从最新消息向前累计 token,目标是保留大约:keepRecentTokens
这里有个细节,就是切分点不会选在 ToolResult 上,因为 ToolResult 必须跟在对应 Tool Call 后面。
选到切分点后,切分点前的信息被摘要,切分点后的信息保留。
摘要由compact()实现,主要就是调用了一次LLM。然后由appendCompaction()来生成CompactionEntry,再追加到Session Tree上。
总结一下,就是:
scss
`shouldCompact()` 决定要不要压缩;
`prepareCompaction()` 决定压缩哪些消息;
`compact()` 调用 LLM 生成摘要;
`appendCompaction()` 保存摘要并让后续 Agent Loop 使用。
压缩后的上下文如何参与后续 Agent Loop?
压缩完成后,Agent Loop 不需要理解 Compaction。它只会看到一组新的 AgentMessage[]。
首先,在执行完压缩后,会调用一次_refreshFinalizedContext()
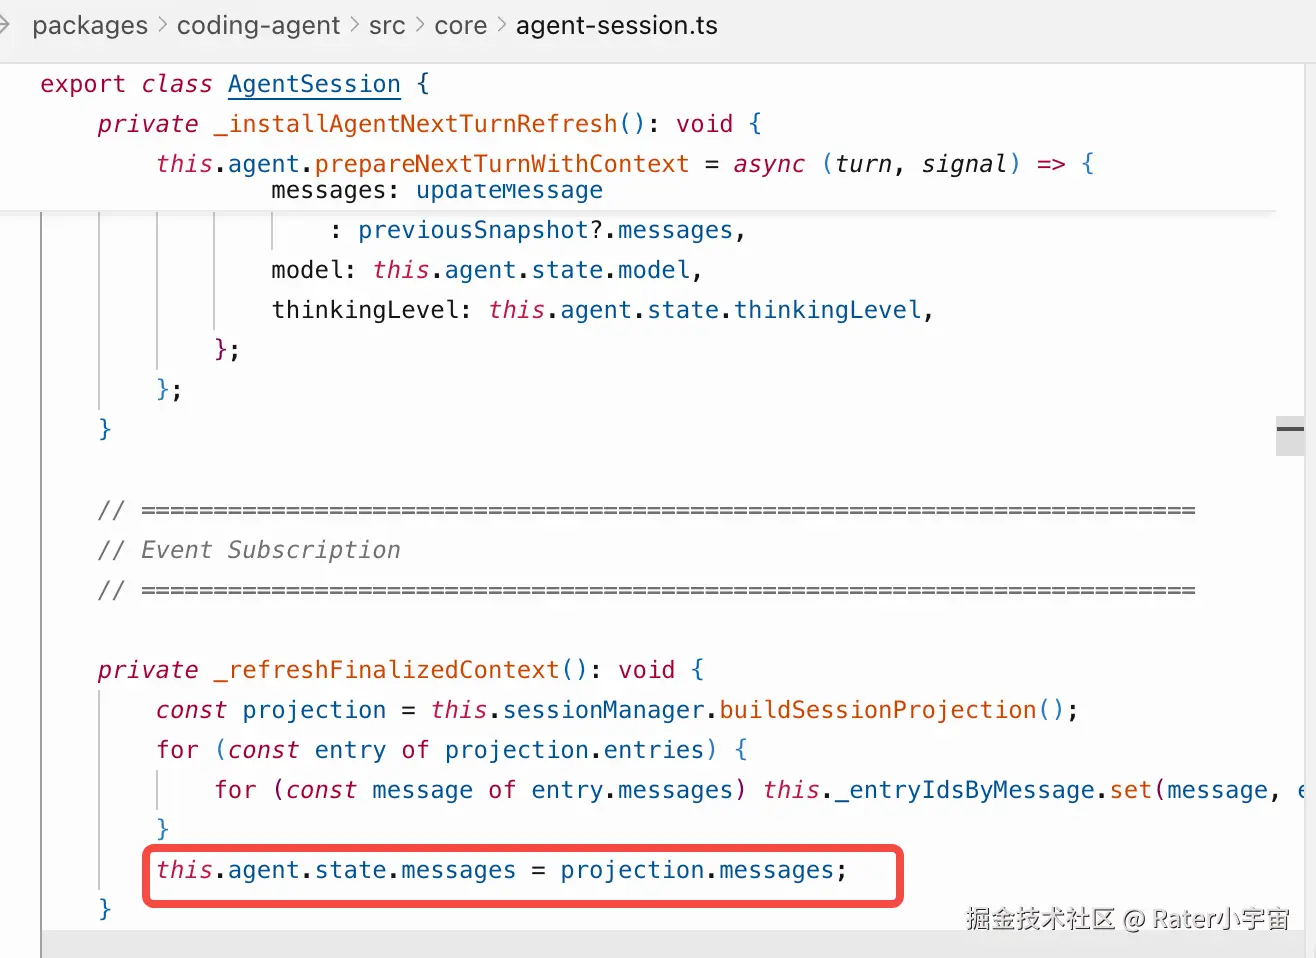
因此: agent.state.messages
会被替换为压缩后的消息。
举个实际例子:
假设压缩前:
ini
agent.state.messages = [
  System,
  User1,
  Assistant1,
  User2,
  Assistant2,
  User3,
  Assistant3
]
在压缩后
arduino
User1 ~ Assistant2 → 摘要:"用户正在实现登录功能,已经完成数据库设计"近期消息 User3、Assistant3 保留。
然后 _refreshFinalizedContext() 替换 Agent 的历史
变成
ini
agent.state.messages = [
  SystemCheckpoint,
  CompactionSummary(
    "用户正在实现登录功能,已经完成数据库设计"
  ),
  User3,
  Assistant3
]
重点是:旧的 User1~Assistant2 不再出现在 agent.state.messages 中。
它们仍保存在 Session 文件里,但不再进入 Agent Loop。
然后用户继续发送消息,
比如用户输入:
继续实现登录接口Agent Loop 得到:
css
[ SystemCheckpoint, CompactionSummary("用户正在实现登录功能,已经完成数据库设计"), User3, Assistant3, UserMessage("继续实现登录接口")]Agent Loop 不知道这里发生过 Compaction。对它来说,CompactionSummaryMessage 只是一条普通历史消息。
然后发送给 LLM,
convertToLlm() 把 CompactionSummary 转成 UserMessage:
css
[  SystemMessage,  UserMessage(    "之前的对话已经压缩,摘要如下:
     用户正在实现登录功能,已经完成数据库设计"  ),  User3,  Assistant3,  UserMessage("继续实现登录接口")]
所以完整过程非常简单:
vbnet
原来:
全部历史消息 → Agent Loop

压缩后:
历史摘要 + 近期原文 → Agent Loop
因此,Compaction 不直接控制 Agent Loop,它只是提前替换了 Agent Loop 使用的 messages。
Agent Loop 后面的模型调用、Tool Calling 流程完全不变。
完整源码调用链
scss
shouldCompact() = true
→ AgentSession._runAutoCompaction()
→ prepareCompaction()
→ AgentSession._runDefaultCompaction()
→ compact()
→ generateSummaryWithUsage()
→ completeSummarization()
→ 调用 LLM
→ appendCompaction()
→ _refreshFinalizedContext()
六、架构总结
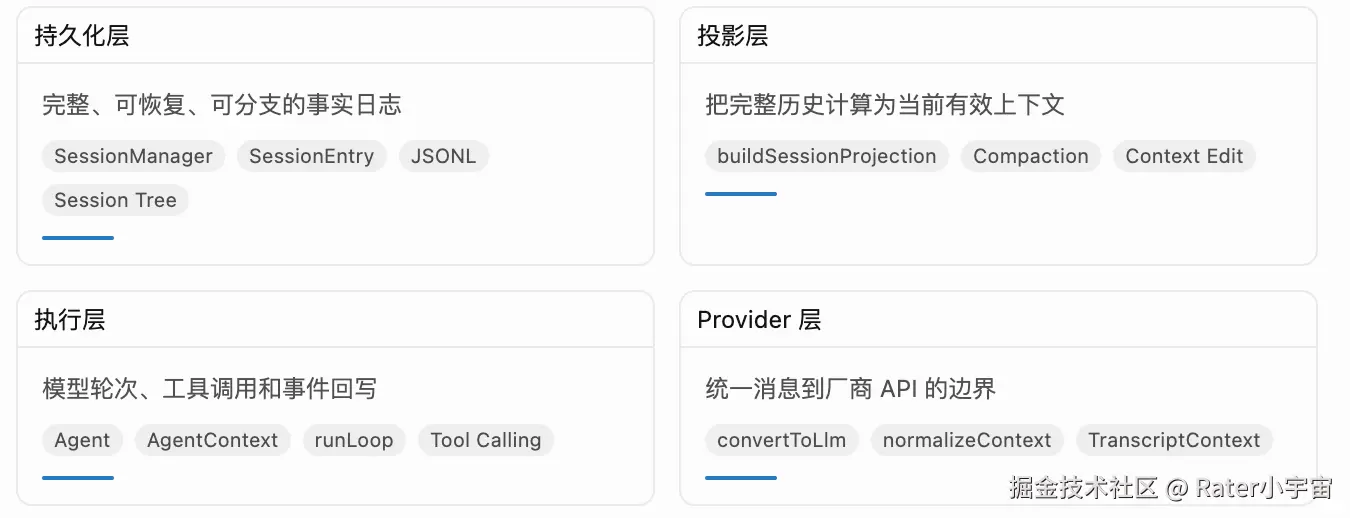
Pi的上下文管理系统,
我觉得总共可以分为四层: 持久化层、投影层、执行层、Provider层。
我用AI画了个图,可以看看
Pi 上下文管理系统的完整运行流程
Pi 启动时会新建或读取 JSONL Session,并根据 parentId 重建当前分支,再通过 buildSessionProjection() 恢复 Agent.state.messages;
用户提交 Prompt 后,AgentSession 启动 Agent Loop,所有最终消息都会在 message_end 时先更新 Agent 内存,再持久化为 SessionEntry;
每次调用 LLM 前,prepareRequest() 都会重新投影 Session,用最新结果替换 AgentContext.messages,随后依次经过 transformContext()、convertToLlm() 和 normalizeContext(),再由 Provider 调用具体模型;
如果模型返回 Tool Call,Agent Loop 执行工具、生成并持久化 ToolResult,然后进入下一轮请求;
如果 Context 接近上限或发生 Overflow,Pi 会调用摘要 LLM,把较老消息压缩为 Compaction Summary,保留 System checkpoint 和近期原文,刷新 Agent.state.messages 后继续运行或等待下一次输入,
这样,就形成了
Session 持久化事实 → Context 投影 → Agent Loop 执行 → 新消息写回 Session
的完整闭环。
核心设计思想
完整历史与模型上下文分离
ini
Session = 完整事实
Context = 本次给模型看的投影
这样才能同时支持完整、可恢复、可分支的事实日志,以及满足有限的 Context Window。
Append-only
这样历史不直接修改,而是通过append的形式,保证历史可审计、可恢复
这套方案有哪些优缺点,值得借鉴的地方是什么?
优点:
可恢复性强
对Context Window Size有较好的保护作用
扩展能力强
缺点:
分层较多、理解成本高
JSONL 会持续增长
摘要本身有成本,且是有损、非确定的
最值得借鉴的地方:
Session 负责保存完整历史,Context 负责决定模型看到什么。
两者解耦,才是 Pi 上下文管理系统最值得借鉴的设计思想。
写在最后
这是我研究 Pi 源码的第三篇文章,前两篇分别介绍了 Agent Loop 和工具调用。
研究到现在,我越来越觉得,
Agent 开发的核心,不只是调用大模型,而是如何围绕大模型构建一套可靠的运行机制。
相比于单纯学习框架、API,我认为理解这些底层设计思想,更有长期价值。
后面也会继续研究 Pi 的其他核心模块,分享自己的理解。