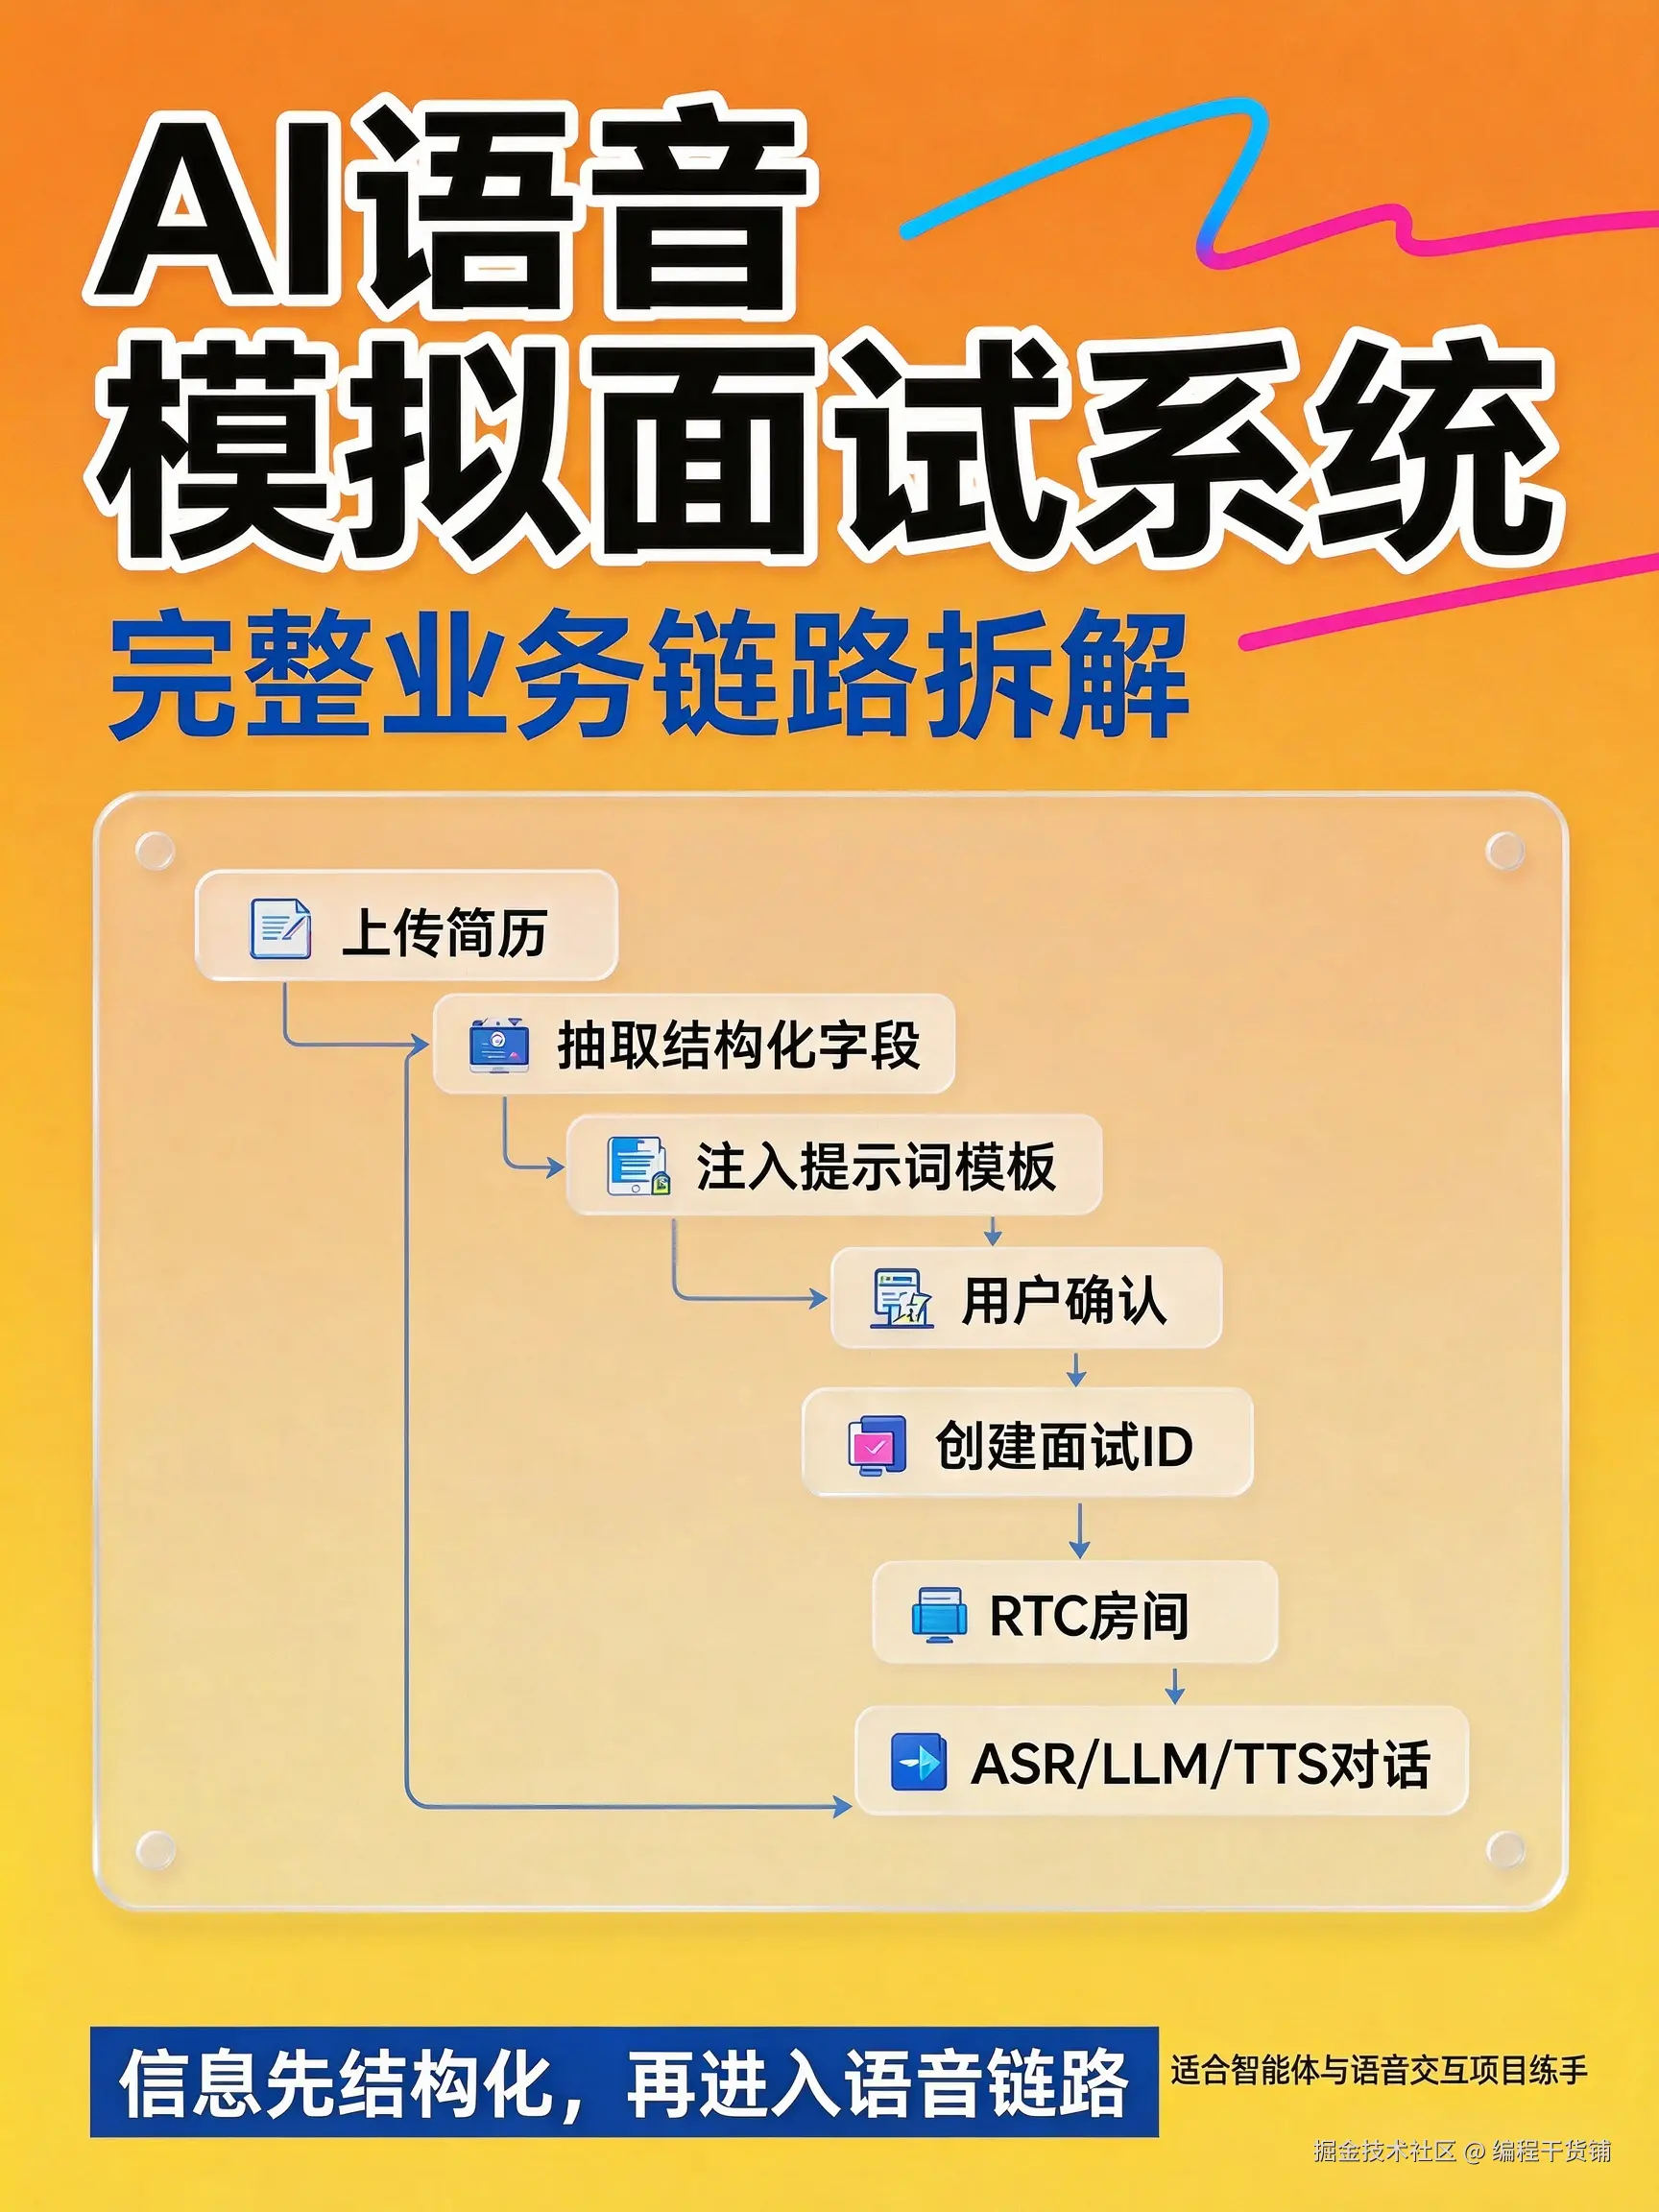
 开发 AI 语音模拟面试,拆开看就是一条固定的业务链路:
简历 → 结构化字段 → 提示词模板 → 用户确认 → RTC 房间 → ASR / LLM / TTS 对话这篇文章就按这条链路从头到尾走一遍:每一步做什么、为什么这么设计、容易在哪里出问题。
如果你正在做 AI 应用,尤其是"语音交互 + 智能体"这类场景,AI 模拟面试是个很适合练手的项目。它体量不大,却几乎把当下最典型的几个技术点全串了一遍:结构化信息抽取、提示词模板注入、RTC 实时语音、ASR / LLM / TTS 三段式链路。
看完之后,你对"一个 AI 语音应用到底该怎么设计",会有一个完整的骨架认知。
一、用户只经历三步,系统要做三件事
动手写代码之前,先把用户体验和数据流对齐:
| 用户看到 / 做的事 | 系统在背后做的事 |
|---|---|
| 上传简历、发起面试 | 帮 AI 面试官"备课" |
| 在弹窗里核对信息、点确认 | 校准上下文,正式创建面试 |
| 戴上耳机,开始对话 | 拉起 RTC 房间,跑通语音链路 |
三步,但每一步的性质完全不同:第一步是信息处理 ,第二步是交互兜底 ,第三步是实时通信。
下面逐个拆。
二、第一步:让面试官智能体先"备课"
用户发起面试请求时,系统要做的第一件事不是开房间,也不是连麦,而是给 AI 面试官准备上下文。
这一步的入口是总控路由:它接收两样东西------用户的面试请求,以及用户选中的那个面试主考官智能体,然后按智能体配置把任务分发出去。
接下来,面试官智能体要做两件事。
① 读取并结构化简历
它去读取用户上传的简历,或者从用户直接输入的内容里,抽取面试所需的背景信息,最终产出一批结构化字段,比如:
-
求职岗位
-
掌握的技能
-
做过的项目
-
薄弱点
这里有个值得停下来想一秒的设计选择:简历本身就是一段文本,为什么不直接扔给 LLM 让它边聊边读?
因为直接读有两个坑。
第一是不稳定。同一份简历,每次读出来的侧重点可能都不一样,问出来的问题也就飘了。
第二是不可控。整份简历是一整块非结构化文本,用户没法逐项核对,系统也没法逐项修改。
而一旦抽成字段,情况就变了:每一项都是独立的、可展示的、可编辑的、可回写的。这为下一步的"用户确认"留好了接口。
顺带一提,"薄弱点"这个字段挺有意思------它通常不是简历里明写的,而是模型基于项目深度、技能广度推断出来的。它恰恰是后面出题最容易出彩、也最容易跑偏的地方,所以更需要人来确认一次。
② 注入提示词模板
拿到结构化字段后,智能体再去数据库里读取这个面试主考官对应的提示词模板,把字段填进模板的占位符里。
填充完成的那一刻,一份面试上下文就生成了。
💡 这里要特别强调一个边界:到这一步为止,系统还没有创建任何真实的语音面试。 没有房间,没有连接,没有 ID。它只是在正式开场前,把 AI 面试官的"资料袋"整理好了。
这个边界看着不起眼,但它决定了整个系统的状态是清晰的:准备态 和进行态是两件事,中间隔着用户的确认动作。
三、第二步:为什么一定要让用户确认一次?
上下文准备好之后,进入第二步:在前端让用户确认面试背景信息。
具体流程是这样的:
-
后端把结构化字段发送给前端
-
前端用一个弹窗面板,把字段渲染成表单控件(输入框、下拉框等)
-
用户既能逐项查看,也能直接就地修改
-
改完点确认
为什么用输入框,而不是直接显示文本?
因为**"可编辑"才是关键**。
如果只是展示一段只读文本,用户看到"AI 理解的项目经历不太对",唯一能做的就是关掉重来。而用输入框,用户顺手改两个字就行,改完继续。
一次轻量编辑,顶得上一整套重来流程。
为什么非要有"确认"这一步?
核心目的只有一个:避免开考之后出题跑偏。
简历抽取一旦有偏差,后面的连锁反应是很难挽回的:AI 面试官可能抓着一个用户根本没做过的项目猛问,或者完全避开用户真正的技术亮点。而这时候语音面试已经开始,用户已经投入了时间和注意力,再纠正的成本就高了。
在开考之前花十秒钟校一次,是性价比极高的一道保险。
用户点下确认之后,发生了什么
-
前端把修改后的背景信息发回后端
-
后端把新信息重新填充进该面试主考官的提示词模板,生成新的上下文
-
创建正式面试,返回一个面试 ID,作为这场面试的唯一标识
到这里,业务逻辑层就准备好了。接下来才是真正"让面试开口说话"的部分。
四、第三步:RTC,语音对话的底座
前面两步都是"准备工作",真正让面试跑起来的,是第三步------火山引擎 RTC 实时语音对话。
这块相对复杂,我们先用一个最小可跑通的视角,理解"语音实时对话"到底是怎么实现的。
1. 音频是怎么流动的
markdown
前端(浏览器 API 采集麦克风音频)
        ↓
    后端(代理层)
        ↓
火山引擎 RTC 云端服务
具体来说:
-
前端调用浏览器 API(
getUserMedia那一套)采集用户的音频数据 -
采集到之后,把音频流发送给后端
-
后端在这里只做一件事:代理
2. 后端为什么要"代理"一下?
后端在这一层对火山引擎 RTC 做了一层封装代理。最直接的好处是密钥安全。
如果把 AppKey / Token 直接写在前端,一旦有人打开 DevTools 翻一下,密钥就泄了。而密钥一旦泄露,别人就能拿着你的额度开房间、跑模型。
加一层后端代理之后,前端只跟自己的后端打交道,真正的凭证留在服务端。这是所有涉及第三方实时通信服务的系统都该有的基本姿势。
除此之外,代理层顺手还能承担几件事:签发临时 Token、创建和管理房间、处理回调事件、做用量与异常统计。一层薄封装,后面省很多事。
3. 一段声音的完整旅程:ASR → LLM → TTS
音频转发到火山平台后,云端会依次跑三个模型:
csharp
用户说话
   ↓
 [ASR] 语音识别
   ↓
  文字
   ↓
 [LLM] 大模型理解与生成
   ↓
AI 回复文本
   ↓
 [TTS] 语音合成
   ↓
  语音
   ↓
前端播放
串起来就是一句话:
声音 →( ASR )→ 文字 →( LLM )→ 回复文本 →( TTS )→ 声音
最终语音回到前端播放出来,用户就听到了 AI 面试官的回答。
理解这条链路有个很实际的好处:当体验出问题时,你能立刻定位到是哪一段。是识别错了(ASR),是答非所问(LLM),还是念得别扭(TTS)?三段拆开看,排查方向一目了然。
4. 别忘了文字:让用户"看得到"
除了语音,链路还会返回文本内容。我们需要把用户和 AI 双方的语音都转成文字,在前端以气泡框的形式实时展示。
这一步不只是锦上添花。在面试这种场景里,用户经常会想回看刚才说了什么、AI 问了什么。纯语音是"听过就没了",加上字幕之后,体验才完整,也才方便用户事后复盘。
听得到 + 看得到,实时语音对话的体验才算闭环。
5. 最容易被忽略、但最关键的细节:随时打断
系统还支持随时打断。
规则很简单:用户说话的优先级更高。
当用户开口时,AI 必须停下来。
别小看这个功能。它直接决定了对话是"像真人"还是"像机器人"。一个不能被打断的语音助手,用户说三句话就会烦------因为你必须等它念完,哪怕你已经知道它要说什么了。
而从工程实现看,"打断"其实不是一个动作,而是三个动作要同时做到:
-
检测:通过 VAD(语音活动检测)判断用户真的开始说话了,而不是环境噪音
-
停播:立刻清空前端正在播放的 TTS 音频缓冲,让声音真的停下来
-
停生成:通知 LLM 中止当前生成,或至少丢弃后续输出,避免它继续"自言自语"并污染上下文
这三件事少做一件,打断就是"假打断":声音停了但模型还在生成,或者模型停了但播放队列里还有两秒音频在往外放。
五、把整条链路串起来看
最后,我们把整个工作流程完整过一遍:
markdown
① 用户发起面试请求
        ↓
② 系统准备面试背景上下文(读简历 → 结构化 → 注入提示词模板)
        ↓
③ 上下文发送给前端,用户确认 / 修改背景信息
        ↓
④ 点击确认 → 创建正式面试(返回面试 ID)
        ↓
⑤ 把用户拉入语音对话房间(由火山 RTC 创建的虚拟环境)
        ↓
⑥ 同时把 AI 机器人也拉入语音房间 → 面试正式开始
注意第 ⑤ 步和第 ⑥ 步:房间里必须有两个"人" ,一个是用户,一个是 AI 机器人。面试本质上是这两个参与者在同一个 RTC 房间里的对话,而不是"前端调一次接口拿一段音频"。
这套架构延续了什么思路
整套系统沿用了同一套架构骨架:
-
总控路由:负责接收请求、分发任务
-
工作流:以编排的形式组织任务步骤
-
智能体:调用提前编排好的工作流
其中最关键的一环,是把简历中的重点信息抽取成结构化数据 ,再把这份数据注入到面试主考官的提示词模板中。
注入之后得到一份新的上下文数据,方便后续随时读取------真正开始语音面试时,直接从这份上下文里取用,不用再回头翻原始简历。
这就是整套设计流程的骨架:信息先被整理成结构,结构再被注入成上下文,上下文最后被语音链路消费。