大家好,我是二哥呀。
真狠啊,DeepSeek 把 App 和网页端用到的应用层能力,全部通过官方 API 的形式开放了。
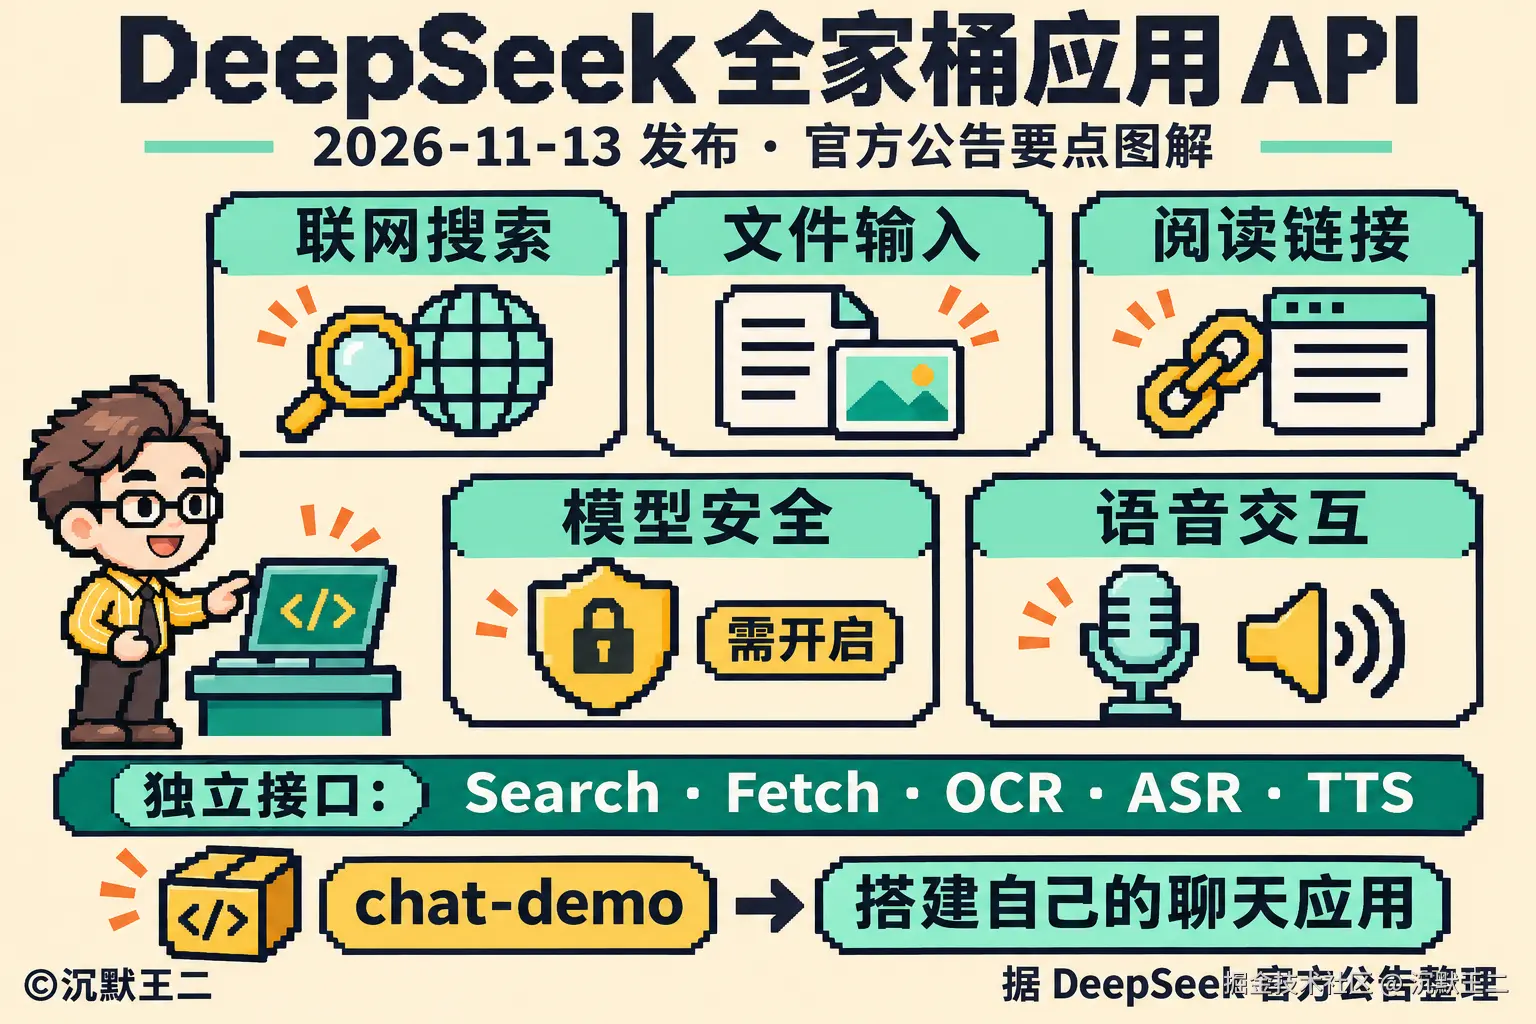
这意味着,联网搜索、深度思考搜索、文件输入、阅读链接、内容安全审核,以及 Search、Fetch、OCR、ASR、TTS 这些能力,我们都可以直接拿来用了。
甚至官方怕我们不会用,直接开源了一个网页版的 DeepSeek,填上 API Key,就能一比一复刻。
这什么开源精神啊!
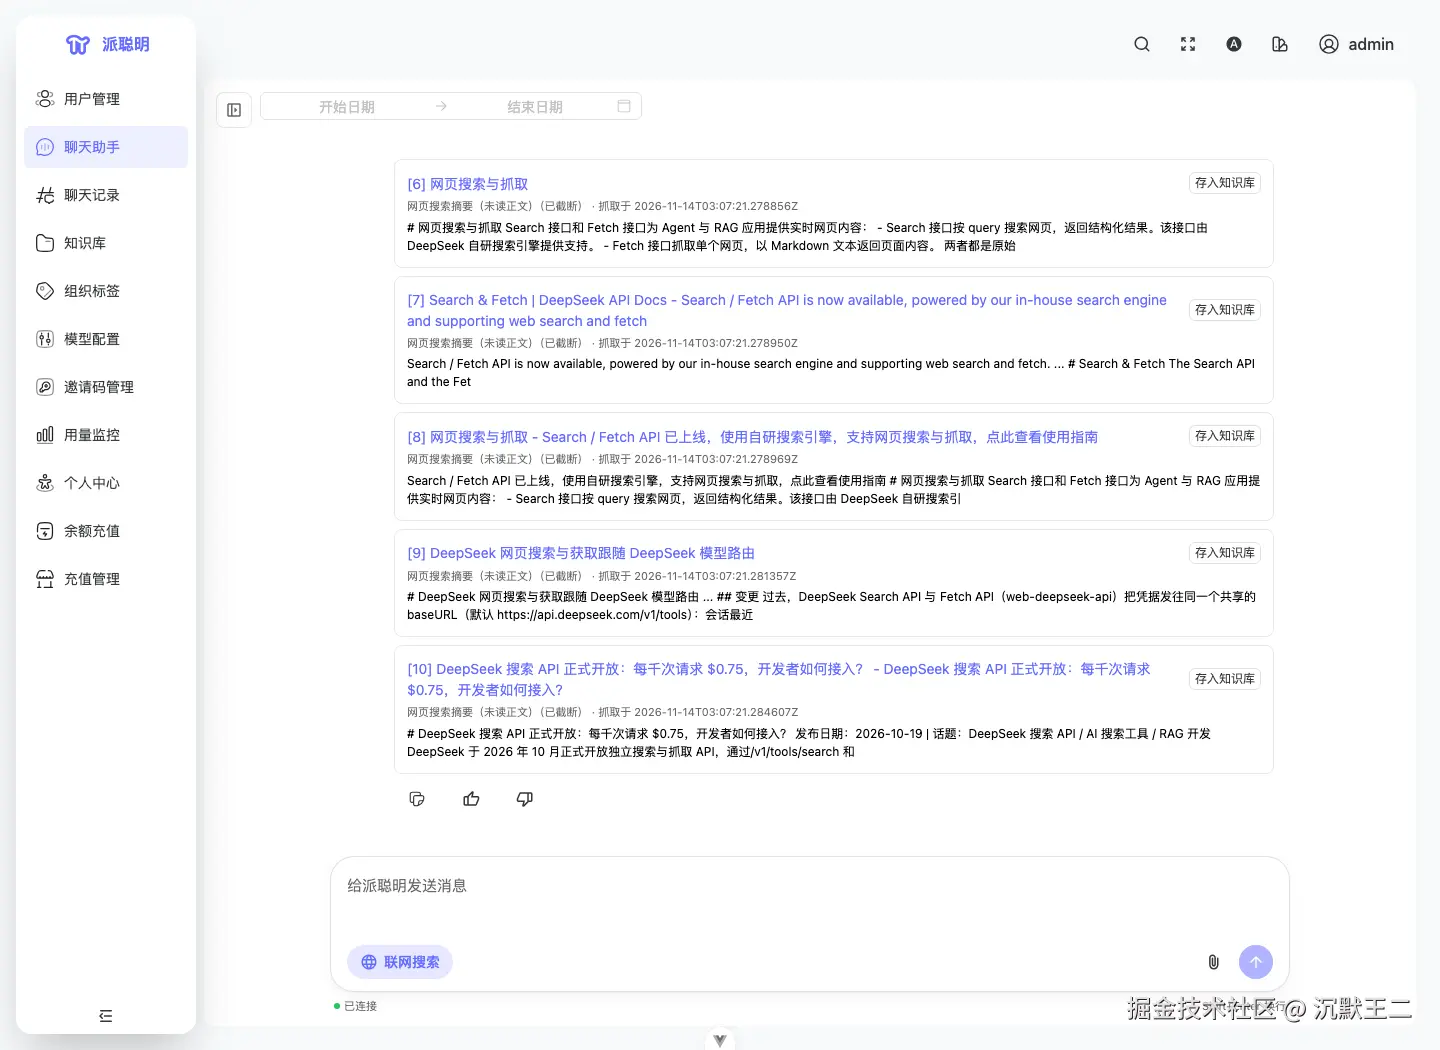
我滴妈呀,梁圣伟大啊。除了 TTS 和 ASR,我已经全部接入派聪明实践了一波。
希望 DeepSeek 以后再出个 Embedding 模型,视频制作方面和文本方面的能力再加强一下,就很无敌了。
01、全家桶 API 包括哪些
来仔细看看全家桶 API 都包括哪些能力吧。
DeepSeek 支持三种协议,即 Anthropic Messages、OpenAI Responses 和 OpenAI Chat Completions。
在这三种协议上,DeepSeek 内置了多项由服务端直接执行的能力,我们只需要在请求里声明一下,剩下的事情全部由 DeepSeek 搞定,我挑最核心的五个给大家一一解释下。
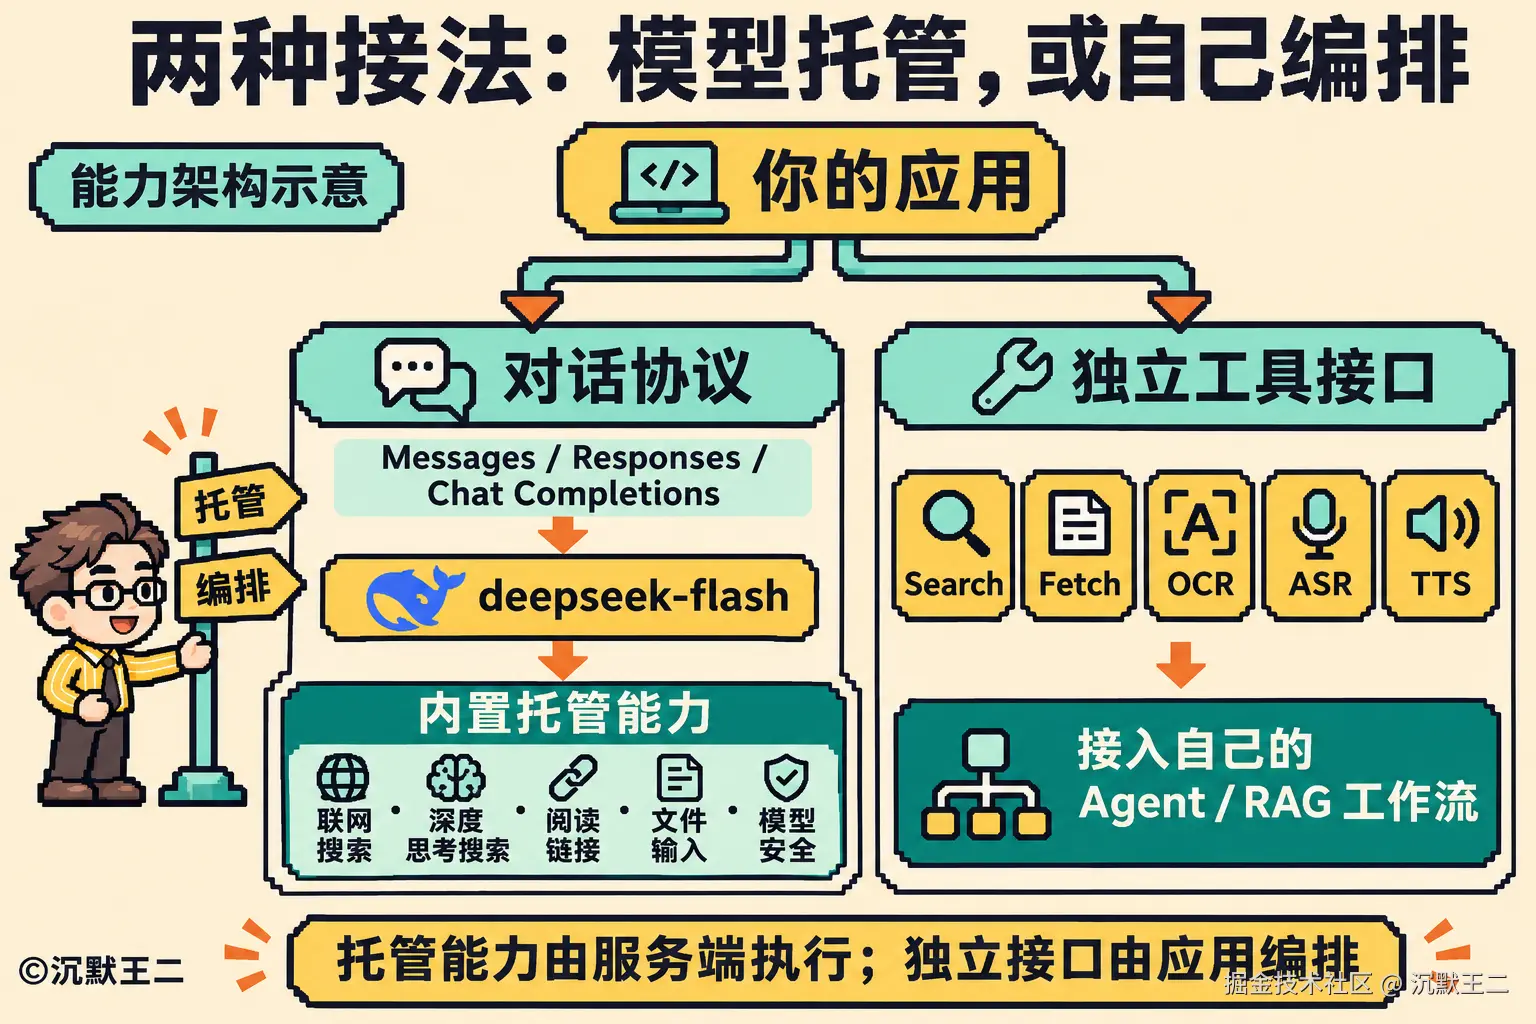
- 联网搜索:声明
deepseek_web_search工具,模型会根据需要自动搜索网页或图片,并在回答里标注来源 - 深度思考搜索:在思考模式下声明同一个工具,模型会在推理过程中自己搜索、打开网页、在网页里查找内容
- 阅读链接:声明
deepseek_read_url工具后,用户在消息里贴的链接,模型会自动打开并读取正文 - 文件输入:先上传 PDF、Word、PPT、Excel、电子书、代码或图片,拿到文件 ID 后放进对话消息,模型就能根据文件内容回答
- 内容安全:服务端会审核模型的输入和完整输出,发现风险时直接拒答
另外,DeepSeek 还把五项底层能力做成了独立的调用接口,可以轻松接入到你的 Agent 项目里。
- 网页搜索
search:返回搜索结果和摘要,每条结果附带相关度和权威度评分,方便筛选 - 网页抓取
fetch:给一个网址,返回 Markdown 格式的网页正文,前两项也是之前已经开放的能力。 - 文字识别
ocr:识别 PDF、Office 文档和图片里的文字,并返回文字所在的位置 - 语音识别
asr:把语音转成文字,支持普通话、粤语、英语、日语等21种语言 - 语音合成
tts:把文字转成语音,内置一男一女两种音色,可以边合成边播放
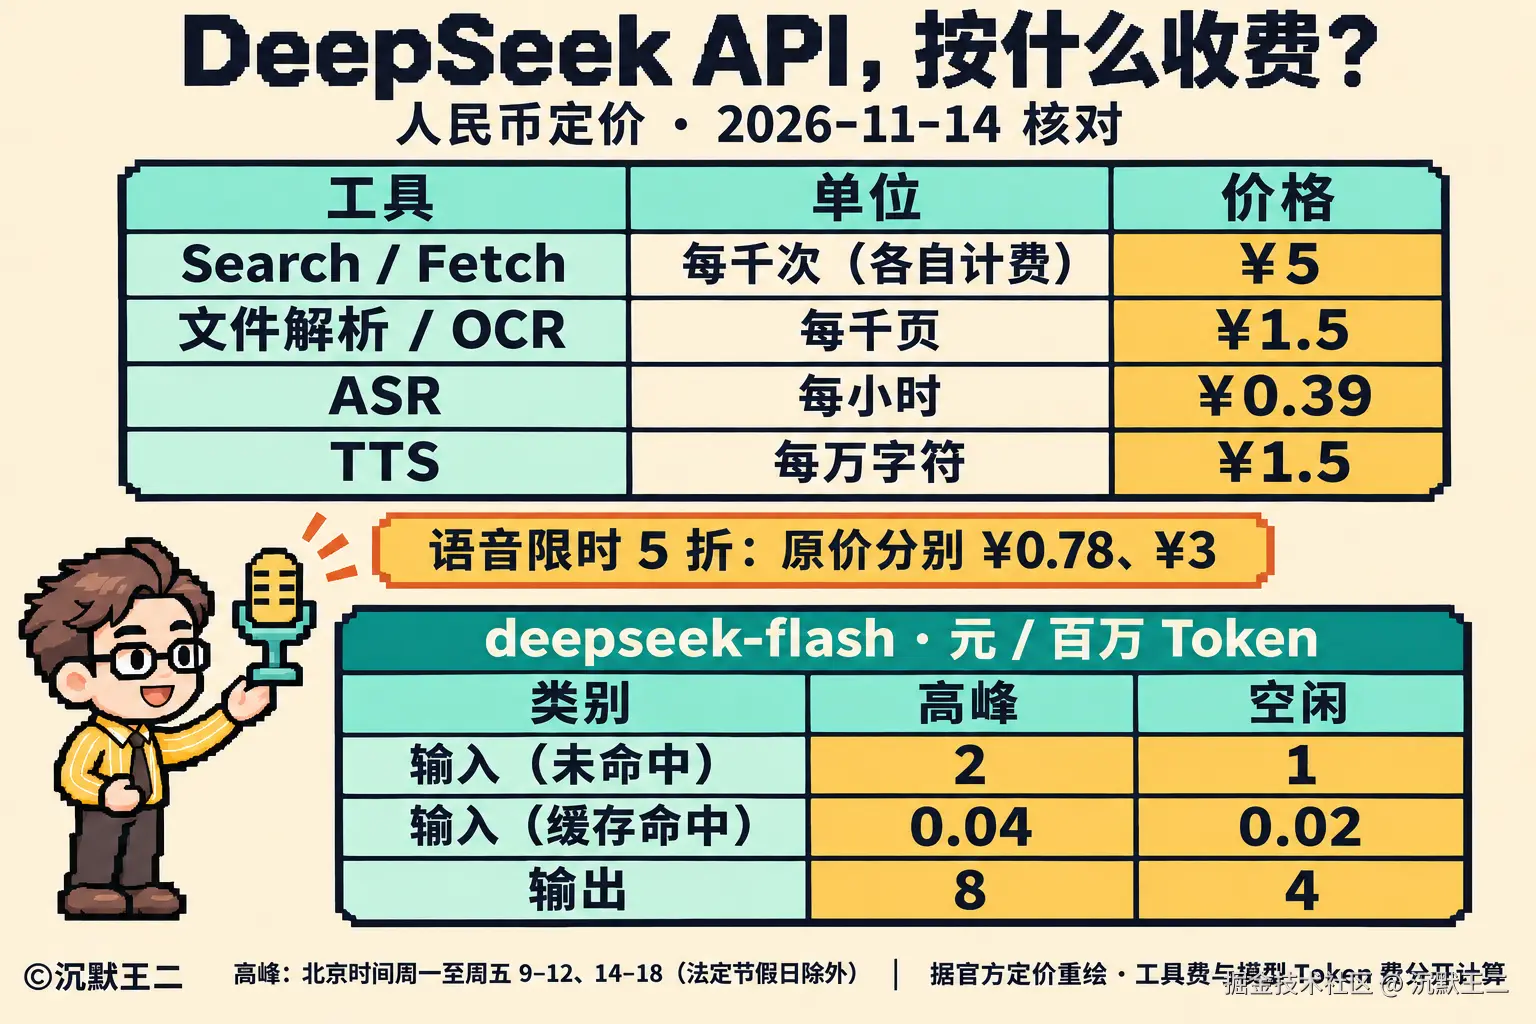
各项工具的计费方式我也帮大家整理好了,定价良心得很。
02、联网搜索
派聪明是一个 RAG 知识库项目,原来只能根据用户上传的文档回答问题。用户问知识库里没有的内容,比如最新的版本发布、新闻、官方文档,模型就答不上来。
接入 search 和 fetch 之后,这个问题就迎刃而解了。方法很简单,把这两个接口封装成两个工具交给模型就可以了。
web_search:先搜索,只看每条结果的摘要read_url:摘要不够用时,再打开网页阅读全文
代码大概是这样的:
java
public JsonNode search(String query) {
    if (query == null || query.isBlank() || query.codePointCount(0, query.length()) > 128)
        throw new IllegalArgumentException("搜索词须为 1 至 128 个字符");
    return execute(client().post().uri("/v1/tools/search").contentType(MediaType.APPLICATION_JSON)
            .bodyValue(Map.of("query", query, "count", 5, "need_content", false)).retrieve().bodyToMono(JsonNode.class), properties.getTimeoutSeconds());
}

public JsonNode fetch(String url) {
    validatePublicUrl(url);
    return execute(client().post().uri("/v1/tools/fetch").contentType(MediaType.APPLICATION_JSON)
            .bodyValue(Map.of("url", url)).retrieve().bodyToMono(JsonNode.class), properties.getTimeoutSeconds());
}
搜索时传 need_content = false,只读取摘要,不读取网页全文;这样做的好处是省 Token。模型先看摘要判断哪篇内容有用,只读取真正需要的网页,不会把一堆无关网页的正文全塞进上下文。
为什么不直接用对话接口内置的 deepseek_web_search?
因为 DeepSeek 规定,内置工具和自己定义的工具不能在同一个请求里混用。派聪明还要调用自己的知识库检索工具,所以只能选独立接口。如果你做的只是一个普通的聊天客户端,用内置工具更省事。
官方开源的 chat-demo 用的就是内置工具,翻看它的对话处理逻辑,能看到它在多轮上下文里的做法。
内置的阅读链接工具在抓取完网页后,返回结果里的正文数据是空的,网页正文被服务端加密后存进了签名字段(signature)。
到了下一轮对话,前端会把上一轮的思考过程和搜索结果全部删掉,只把网页读取记录连同签名原样传回去。
ts
if (
  block.type === 'server_tool_use' &&
  block.kind === 'read_link' &&
  !unsignedReadLinks.has(block.id)
) {
  const { type, id, name, input, kind } = block
  content.push({ type, id, name, input, kind })
} else if (
  block.type === 'web_fetch_tool_result' &&
  block.kind === 'read_link' &&
  !unsignedReadLinks.has(block.tool_use_id)
) {
  content.push(block)
}
服务端收到这个签名后,会在内部解密还原网页内容并拼接回上下文。
来看看派聪明接入联网搜索接口后的实际效果。
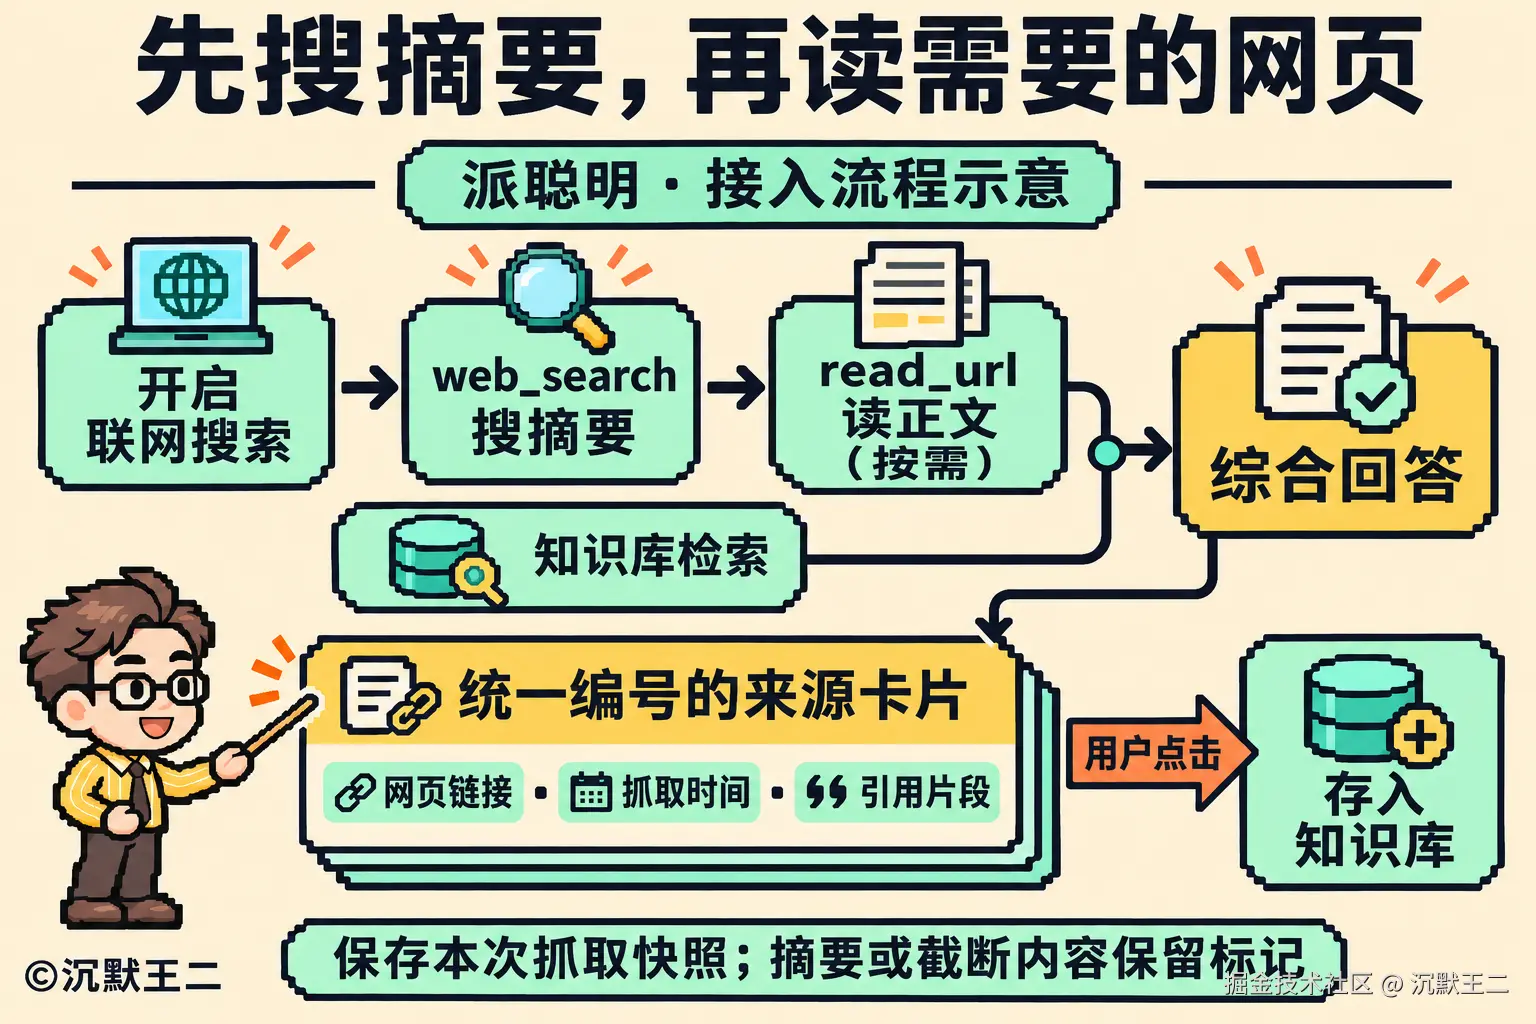
在会话输入框左下角打开「联网搜索」开关,提问后,模型会同时查知识库和外网,回答里的引用会统一编号。外部网页会显示成来源卡片,卡片上有抓取时间和被引用的原文片段,方便核对。
卡片右上角还有一个「存入知识库」按钮。看到有价值的网页,点一下就能存进自己的知识库,下次直接检索。
03、附件问答
用户手里有一份 PDF,想临时问几个问题,并不想把它放进知识库。这种情况用 Files API 就行,效果和在 DeepSeek 网页端"上传附件再提问"完全一样。
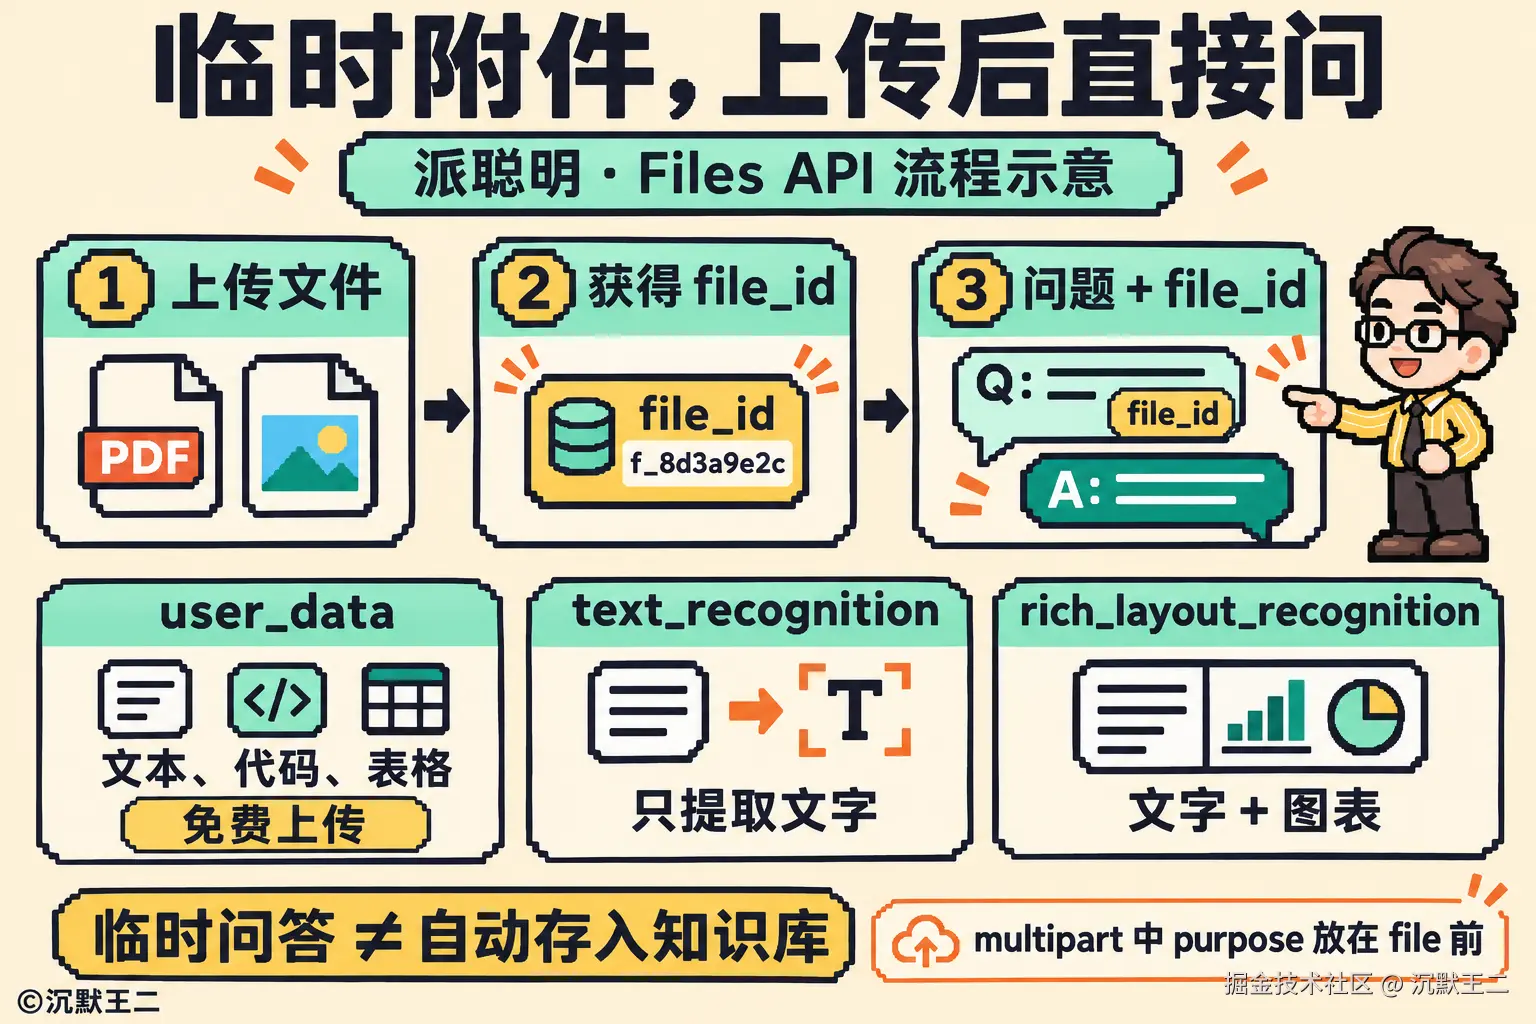
用法分三步:
- 上传文件,用
purpose字段指定解析方式 - 拿到返回的文件 ID
- 提问时,把文件 ID 和问题放在同一条用户消息里发给模型
解析方式有三种,按文件类型选择最合适的。
user_data:适合纯文本、代码、表格和电子书,免费text_recognition:适合 PDF、Word、PPT 和图片,只提取文字,图表会被丢弃rich_layout_recognition:适合带图表的文档,文字和图表会一起交给模型,模型能看懂图
注意,上传时 purpose 字段必须放在 file 字段前面,否则接口会报错。
派聪明在会话输入框右下角加了一个回形针按钮,用来上传临时附件。提问时,把问题和文件 ID 放进同一条用户消息的 content 数组就行:
java
if (!attachments.isEmpty()) {
    List<Map<String, Object>> content = new ArrayList<>();
    content.add(Map.of("type", "text", "text", userMessage + "\n本轮临时附件:" + attachments.stream().map(a -> a.getFileName()).toList()
            + "。回答时注明附件名,未提供的页码不要编造。"));
    attachments.forEach(a -> content.add(Map.of("type", "file", "file_id", a.getRemoteFileId())));
    messages.get(messages.size() - 1).put("content", content);
}
实际接入时有两个工程细节需要处理。
第一,Files API 按文档页数一次性收费,但接口返回的 JSON 里只有文件 ID 和字节数,不返回页数。如果用户传了一份带密码的 PDF 或者几百页的大文件,原样发给上游不仅会报错,超长文档还会浪费大量 Token。所以派聪明在上传前加了一个预处理,用 PDFBox 和无头 LibreOffice 在本地先计算清楚实际的页数、并拦截加密文件,确认合规后再调用 /files 接口。
第二,文件是在上传请求里同步完成解析的,解析完才返回响应。如果用户上传到一半关掉了网页,连接虽然断了,DeepSeek 服务端还是会把这份文件解析完并照常扣费。为此,派聪明在上传时会生成一个唯一的任务文件名,万一中途超时断开,后台恢复任务会调用 GET /files 接口去查这个文件名,查到文件已经生成就把 file_id 认领回来,避免用户重传时浪费 Token。
04、OCR
Files API 解析出来的内容不能下载,没法切块存进知识库。所以入库这一步,要用 OCR。
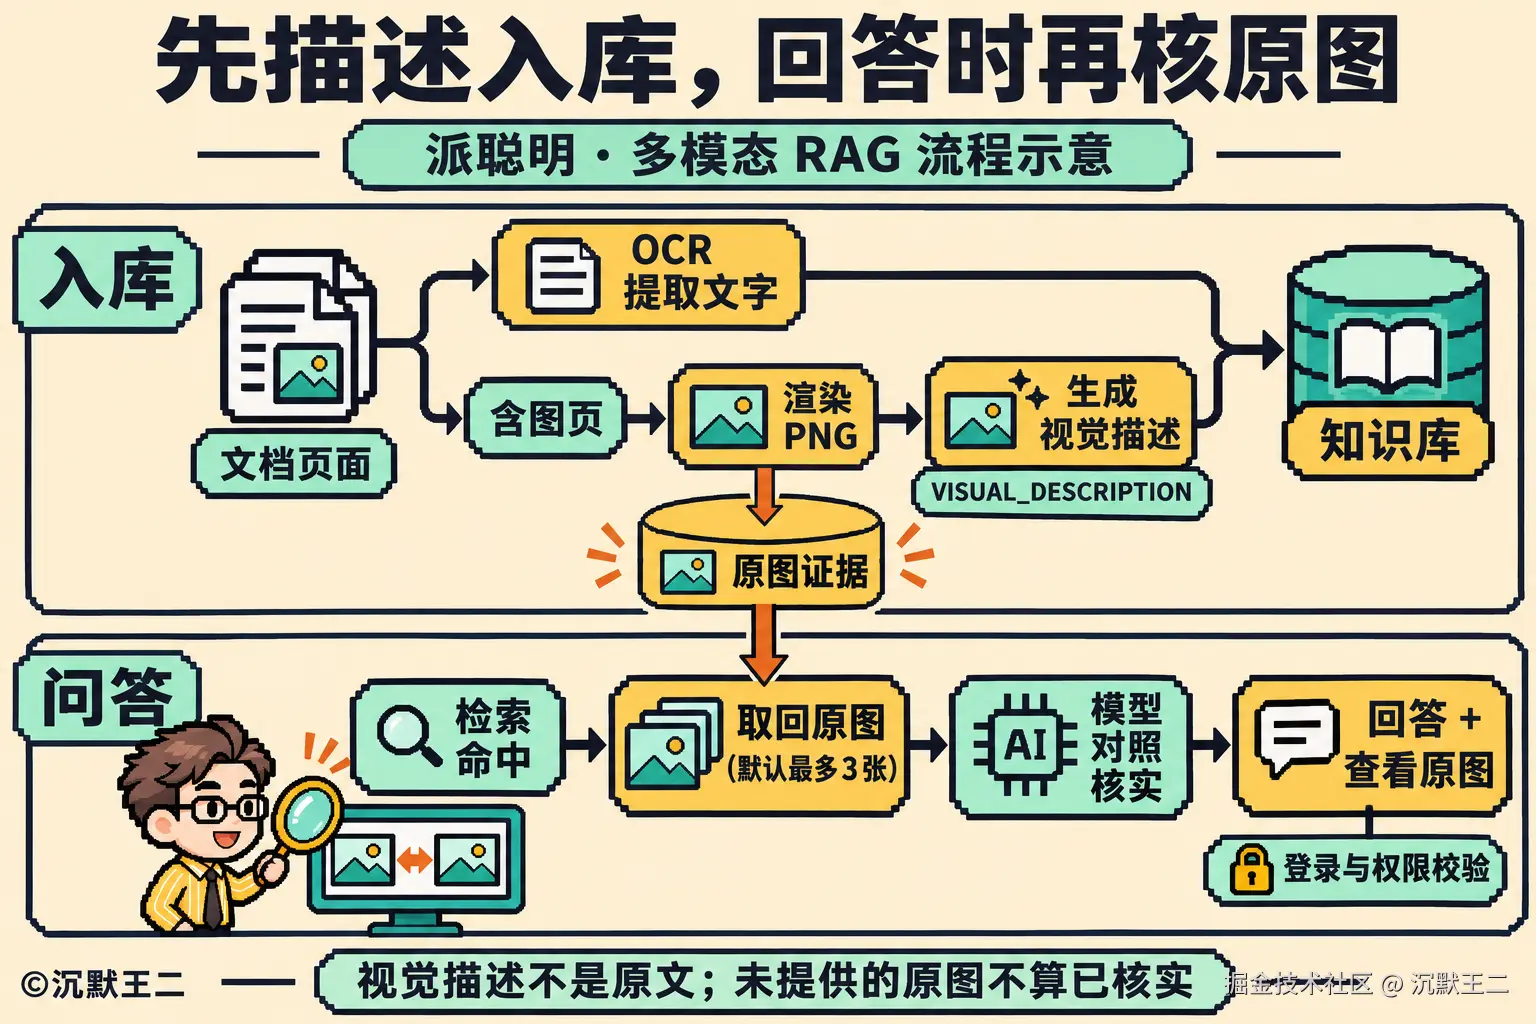
这次,我用 DeepSeek OCR 替换掉了原来的阿里云 OCR。之前我就开了一周阿里的 OCR,消耗了 500 多块钱,真的贼贵,这次我也想观察一下 DeepSeek 效果到底好不好。
扫描版 PDF 上传后,每一页的文字都会被识别出来,再切块存进知识库。
DeepSeek OCR 返回的不只是纯文本,它会在每一段文字外面包上 <ref> 和 <box> 标签,比如 <ref>标题<ref><box>[[52, 40, 948, 96]]<box>。
派聪明会用正则表达式提取出这些标签后,再计算出图片的真实宽高,就能还原出每一行字在页面上的精确位置,保证排版。
java
for (JsonNode page : ocr.recognize(bytes).path("pages")) {
    String raw = page.path("text").asText("");
    var matcher = BLOCK.matcher(raw);
    while (matcher.find()) {
        String text = matcher.group(6).trim();
        if (text.isEmpty()) text = matcher.group(1).trim();
        if (text.isEmpty()) continue;
        List<Double> bbox = List.of(coordinate(matcher.group(2), image.getWidth()),
                coordinate(matcher.group(3), image.getHeight()), coordinate(matcher.group(4), image.getWidth()),
                coordinate(matcher.group(5), image.getHeight()));
        results.add(Map.of("text", text, "bbox", bbox, "confidence", 1.0));
    }
}
不过只有 OCR 还不够。
技术文档和财报里经常会有一些架构图、折线图和流程图,OCR 只能识别出文字,箭头指向哪里、曲线怎么变化,是看不懂的。
如果把每一页都截图喂给视觉模型,成本又太高。派聪明在文档解析时,会先用 PDFBox 扫描每一页的底层绘图指令,只有检测到页面里有嵌入图片或画线时,才把这一页渲染成 PNG,交给 deepseek-flash 生成一段文字描述,和正文一起存进知识库。
模型生成的描述可能会漏掉一些细节,所以派聪明又加了一步,问答时如果检索到了带图的内容,就把原图转成 Base64 一起塞进上下文,让模型对照原图核实之后再回答。
java
byte[] png = visualEvidence.image(userId, result.getUserId(), result.getFileMd5(), result.getChunkId());
blocks.add(Map.of("type", "text", "text", "以下是来源#" + number + "(" + result.getFileName() + ")的原图证据。"
        + "请对照原图核实视觉描述,不能读取的细节明确说明。"));
blocks.add(Map.of("type", "image_url", "image_url", Map.of("url", "data:image/png;base64,"
        + java.util.Base64.getEncoder().encodeToString(png))));
回答下方还有一个「查看原图」按钮,用户点开就能自己核对。
05、语音
语音输入要注意格式。DeepSeek 的语音识别接口只接收 16 位 PCM WAV 或 Ogg Opus 格式的音频,而浏览器自带的 MediaRecorder 录出来的大多是 WebM 格式,原样发过去会报 400 错误。
chat-demo 的录音模块绕开了 MediaRecorder,改用 Web Audio API 按 16000 Hz 采样率采集单声道音频,录完后在前端拼接上 44 字节的 WAV 文件头,再生成符合要求的 WAV 音频。
朗读时用的流式合成,服务端生成第一段音频就开始返回 24000 Hz 的 16 位 PCM 字节流,浏览器收到一段播一段,用户不用等整段语音合成完才能试听。
处理音频流时有一个字节对齐问题。
一个 16 位音频采样点占 2 个字节,而网络传输的分片长度是不固定的,如果某个数据包刚好停留在奇数个字节上,后面的字节会错位,出来的就是刺耳的电流噪音。来看看 DeepSeek 语音朗读模块是怎么处理的。
ts
const bytes = new Uint8Array(rest.length + value.length)
bytes.set(rest)
bytes.set(value, rest.length)
const samples = toFloat32(bytes)
rest = bytes.slice(samples.length * 2)
if (samples.length === 0) {
  continue
}
const buffer = context.createBuffer(1, samples.length, TTS_SAMPLE_RATE)
buffer.copyToChannel(samples, 0)
const source = context.createBufferSource()
source.buffer = buffer
source.connect(context.destination)
nextTime = Math.max(nextTime, context.currentTime + (lastSource ? 0 : START_DELAY))
source.start(nextTime)
nextTime += buffer.duration
lastSource = source
它会把当前数据包末尾多出来的 1 个奇数字节暂存起来,拼到下一个数据包的开头再转成音频样本,然后按播放时间轴一段接一段顺序播放,听起来就跟完整音频一样。
ending
把 DeepSeek 这套全家桶 API 接进派聪明之后,我最大的感受是省心。
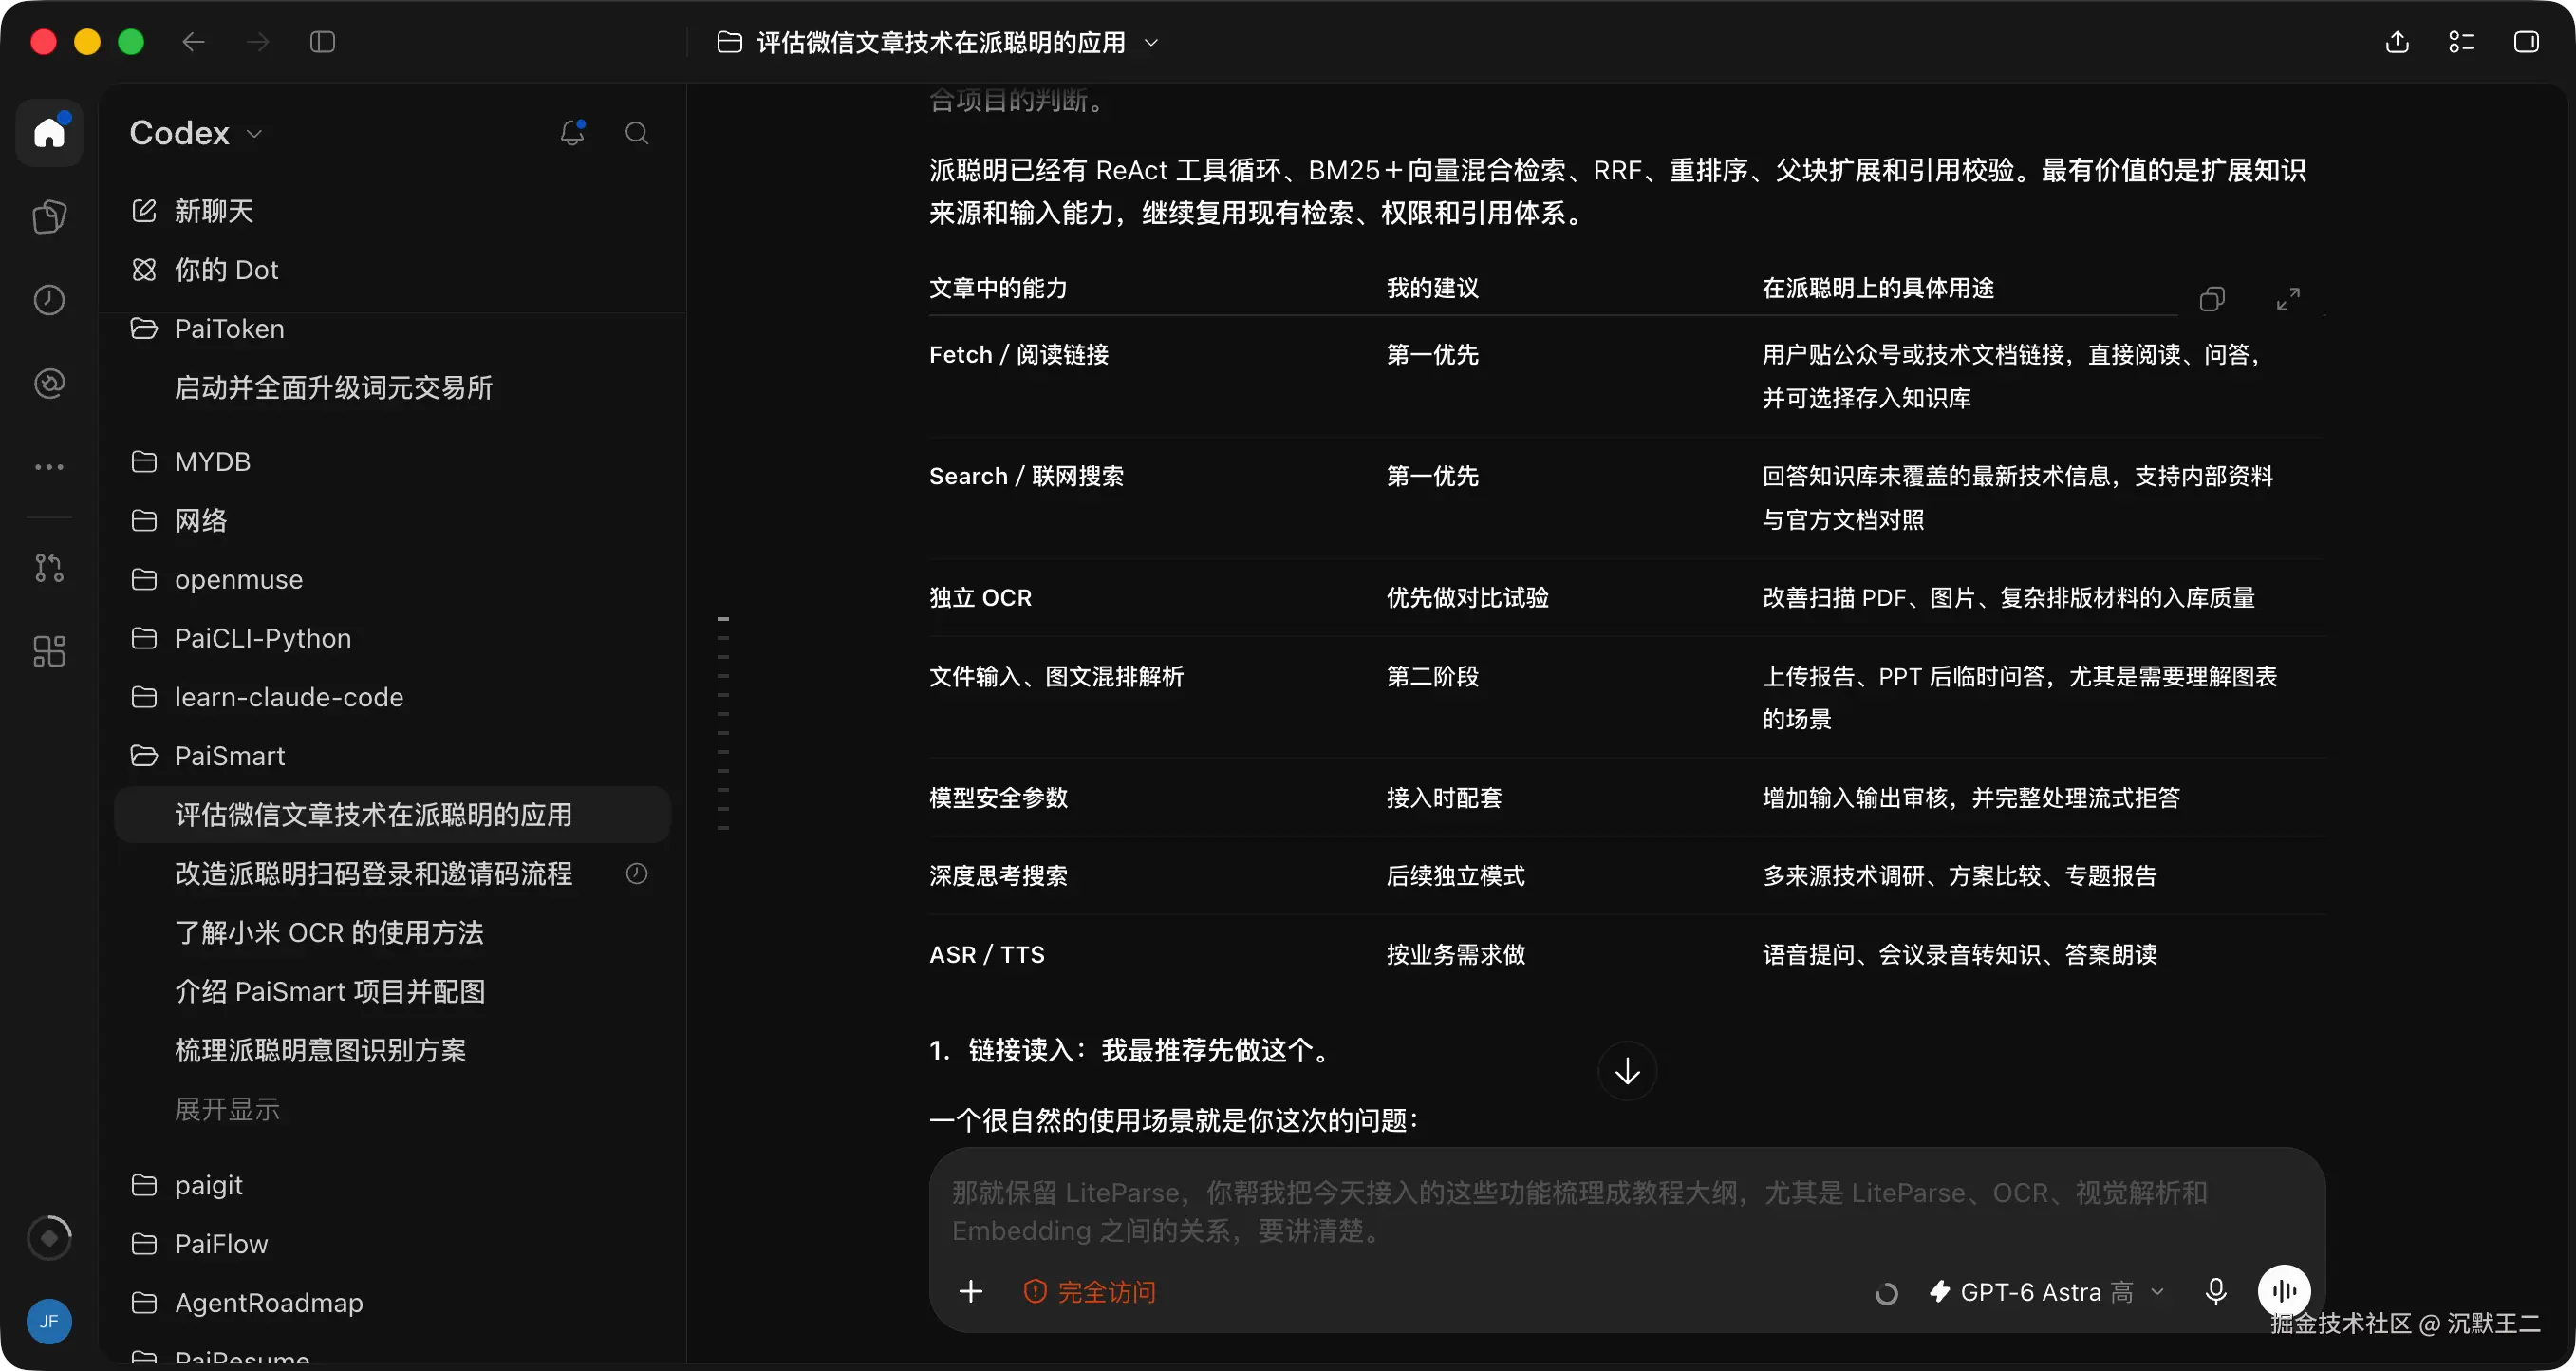
以前的 OCR 接的是阿里云,联网搜索接的是智谱, TTS 用的火山引擎,搞不同的功能,就得去不同的平台开账号、配置权限、引入第三方 SDK,还要保证鉴权和异常重试。
现在好,一个 DeepSeek 就全搞定了。
关键是 DeepSeek 的口碑海内外都有目共睹,确实在开源这一块无敌。
给 DeepSeek 鼓个掌,加个油吧,冲!
我们下期见。