AI 通关了,游戏就算通过测试了吗?
同一款生存小游戏,修改前代理很快阵亡,修改后能坚持更久。开发者看到曲线上升,准备写下"新版更好玩"。如果真正的变化是敌人失去了攻击能力,这条漂亮曲线反而指向一次规则回归。
这是一个用于解释测量的假设案例,本文没有运行该游戏,也没有采集代理或真人数据。它揭示的问题却很具体:我们让AI玩了游戏,最后评价的究竟是游戏、AI的操作能力,还是某群玩家的体验?这三个对象一旦混在一起,一次通关就很容易被包装成"可玩性通过",一次失败又容易被解释成"关卡设计不合理"。
AI可以成为有用的测试员,但每个结论都应停在其证据真正覆盖的范围。接下来用敌人攻击、暂停与通关三个例子说明:怎样把"AI玩过了"改成一条别人能够复查、也能够推翻的评价结论。本文只核对研究资料和公开 协议 ,不提供游戏实测、模型排名或真人偏好的结果。
存活变长,为什么可能是一个坏消息
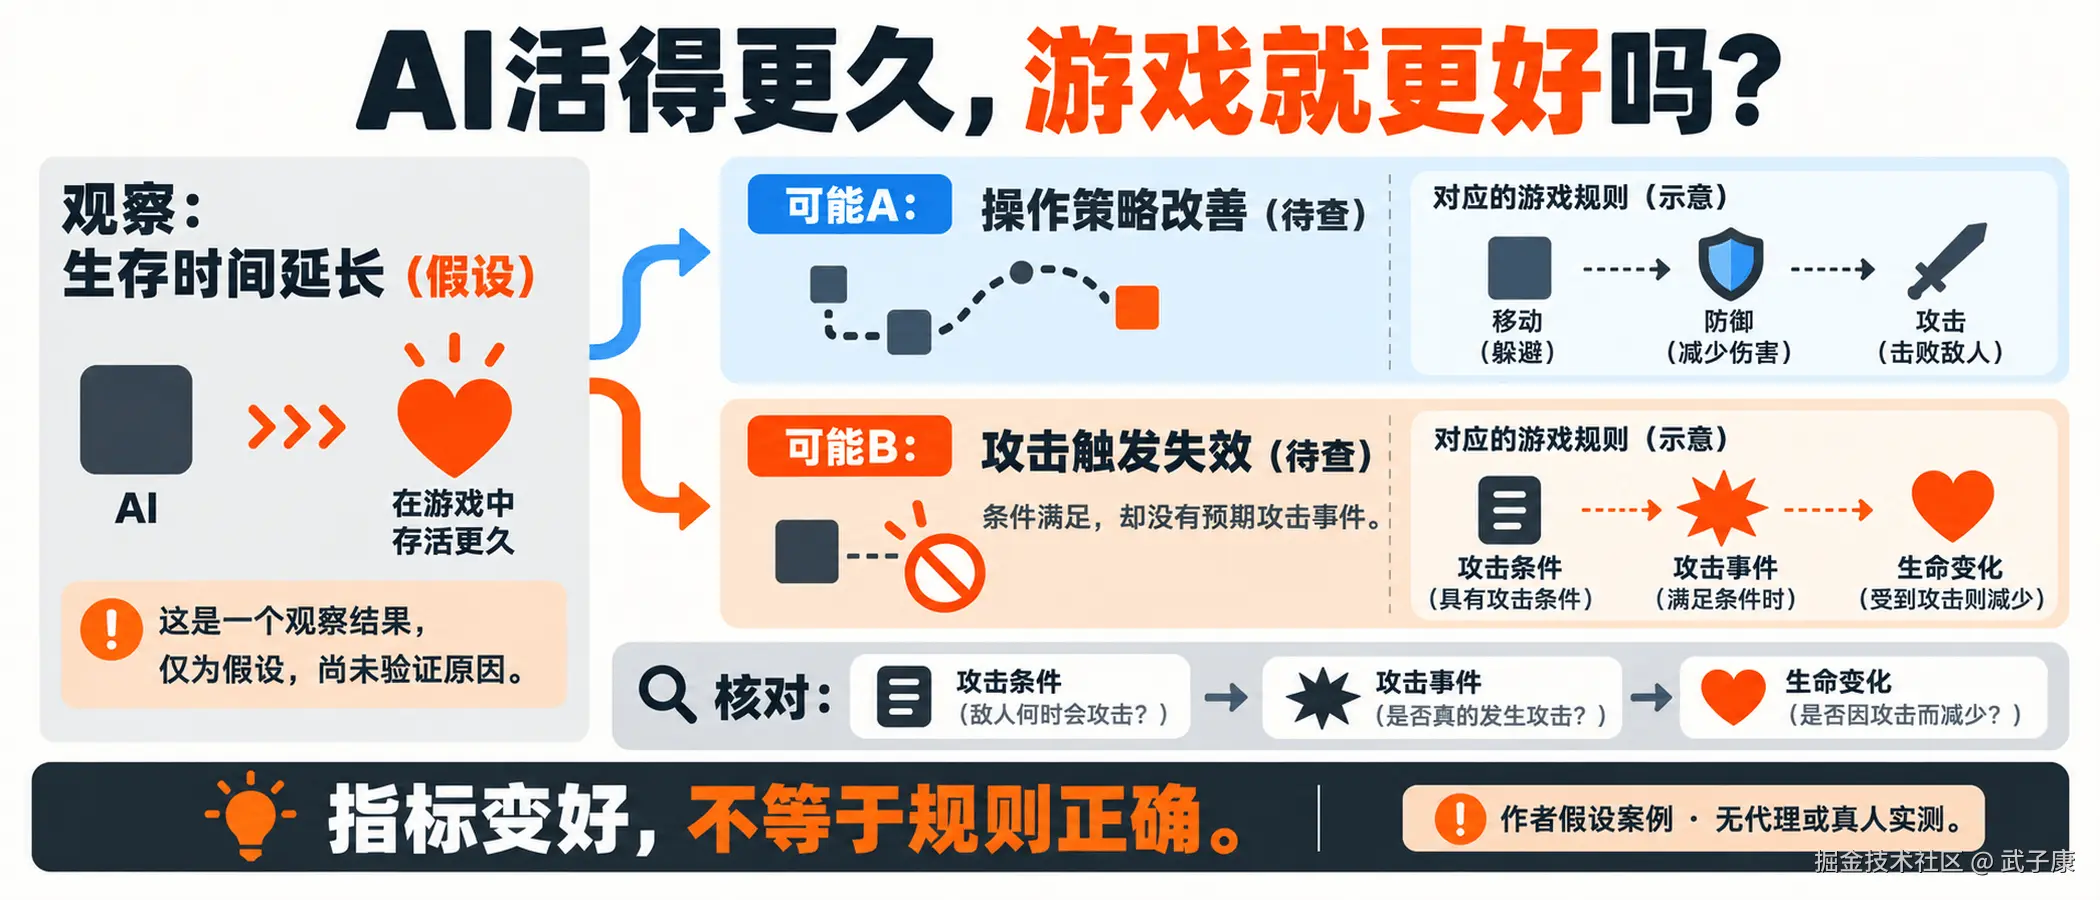
图注:作者假设机制示意,未运行。假设敌人攻击失效,存活时间也会延长;先核攻击预期与事件,再解释指标。假设示意,没有运行游戏、AI或真人测试。
先把开头的观察写准确:在某个版本、某个场景和某套操作条件下,代理的存活时间增加。即使将来确实拿到了这组数据,它仍然没有告诉我们变化发生在哪个环节。敌人变慢、伤害降低、代理更会躲避、计时器异常,都可能让存活时间上升。
其中有些变化可能符合设计,有些可能是故障。若新版明确要降低入门难度,敌人伤害减少可以是预期;若设计要求敌人仍会定期攻击,而修改破坏了攻击触发,延长存活就是异常的结果。判断不能只来自指标的方向,还要来自这次修改原本允许什么行为。
最小的补充证据不是再找一个 模型 给游戏打分,而是检查敌人是否真正进入攻击条件、攻击事件是否发生、命中后生命值是否按当前规则减少。它把"活得久"拆回产生它的原因。敌人尚未进入攻击范围时没有伤害,不能用来证明伤害计算正确;生命条动画出现,也不能单凭画面证明内部扣血和胜负逻辑一致。
这时需要的判据通常被称为 oracle ,也就是决定实际行为是否符合预期的依据。它可以是一条暂停语义、一段资源守恒约束,或由设计者确认的胜负条件,不一定是另一个大模型。若开发者尚未决定暂停是否允许背景动画继续,评测器发现粒子在移动时,应先确认设计含义,而不是直接把它登记成时间系统故障。
把代理接进游戏之前先写这一句预期,常常比增加探索轮数更值钱。例如:"暂停后游戏模拟时间不推进,解除暂停后继续;菜单动画可以播放。"这里区分了模拟时间和界面时间,也给对照动作留下位置。实现是否满足它,仍须未来取得状态记录与操作证据;规则写得清楚不会自动使测试通过。
相反,"存活更久所以体验更好"同时跳过了规则解释和玩家证据两个环节。即使敌人工作正常、难度确实降低,偏好高挑战的玩家和刚接触操作的新玩家也未必作出相同评价。更易存活可以成为进一步研究体验的线索,不能直接替某个人群作结论。
程序响应、规则成立、玩家会玩,证据各有去处
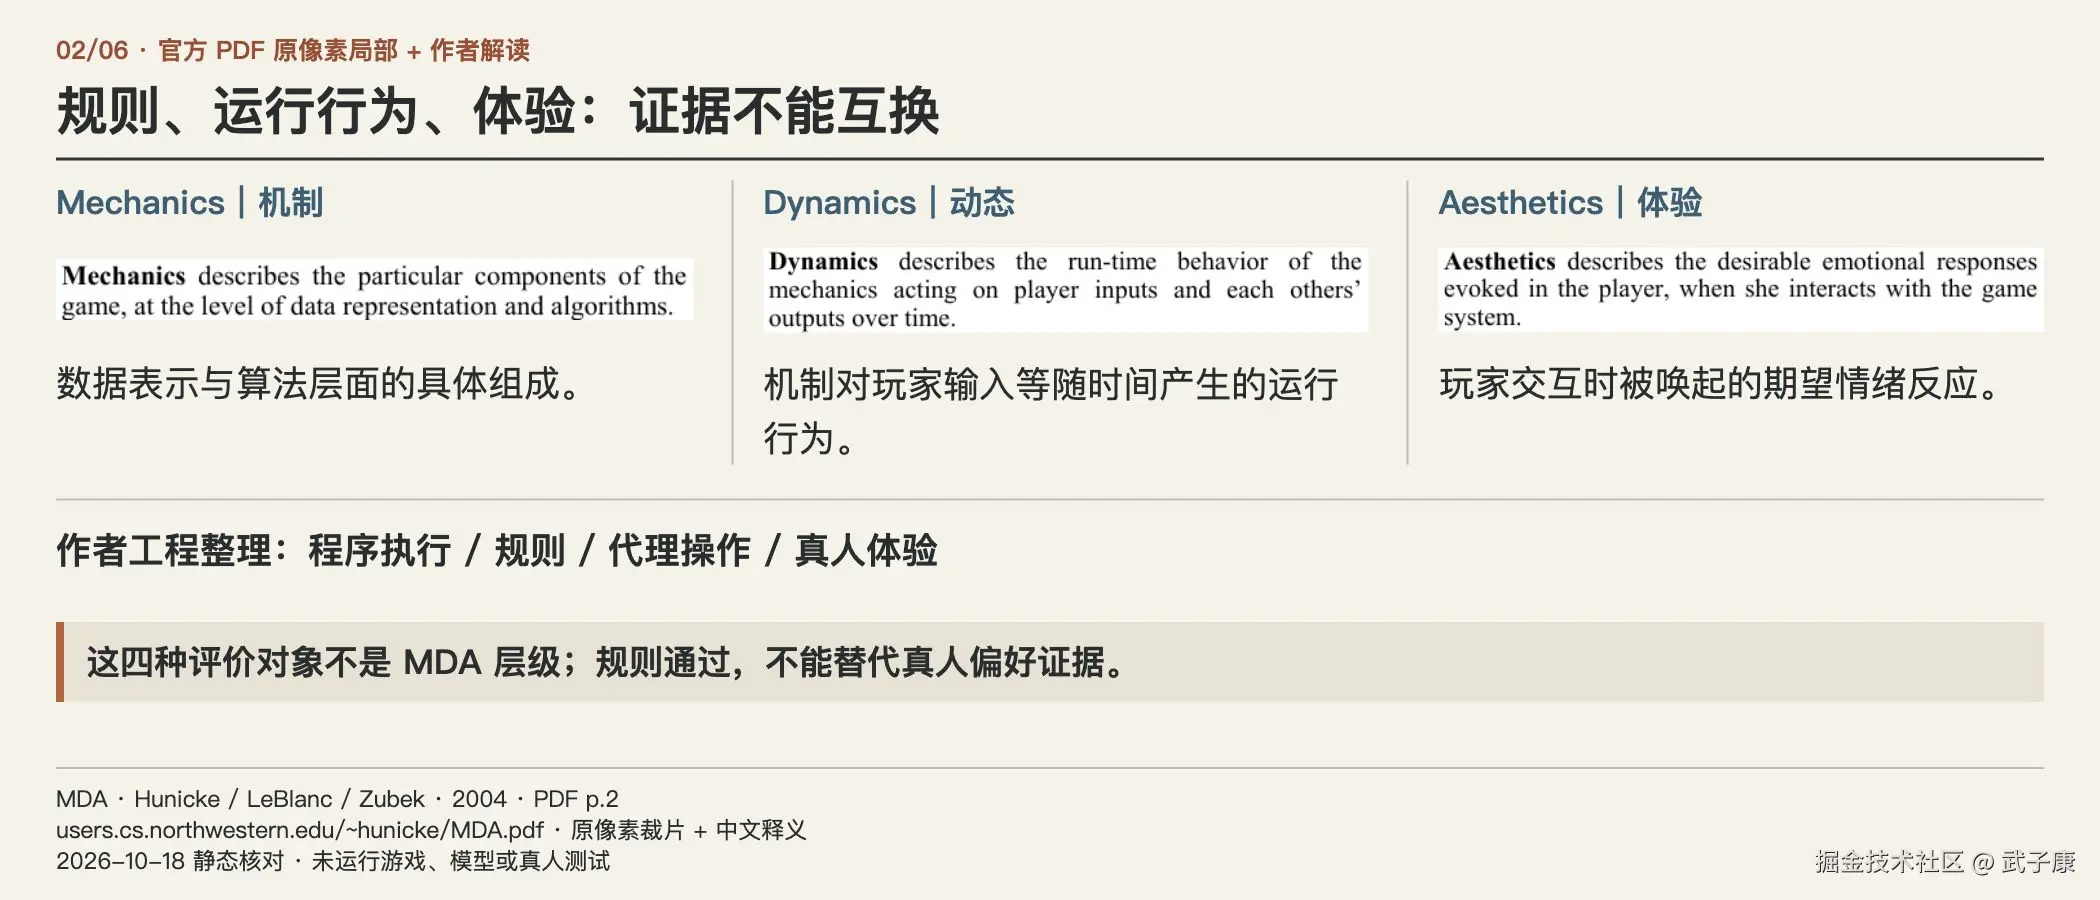
图注:原文证据与作者边界说明。MDA的Mechanics、Dynamics、Aesthetics是三个概念。本文区分程序执行、规则、代理操作和真人体验,是作者工程整理,并非MDA四层标准。规则通过不能直接证明目标玩家喜欢。
对刚生成的小游戏,第一项容易取得的证据是程序加载成功、输入有响应、画面能更新。这说明选定环境下的执行通路可用。它没有覆盖重开、暂停、胜负结算和长时间状态变化;一个能移动角色的页面,仍可能在第二局保留上一局的子弹。
规则检查进一步追问状态变化是否符合设计:攻击应扣多少生命,弹药是否会变成负数,胜利条件与失败条件同时触发时如何处理。同样的按键响应,在规则层可能产生完全不同的后果。这里的评价对象是游戏实现对预期的符合程度,需要明确版本、前置状态、操作与观察结果。
再往前一步,"玩家能理解并完成操作"牵涉的是信息和控制。教程有没有介绍必要动作,按钮提示能否看懂,攻击窗口是否允许在选定输入方式下完成,都不是加载成功可以回答的问题。代理看到了"按空格跳跃",与首次接触游戏的真人是否读到、理解并在正确时机使用它,也不是同一份证据。
最后,"紧张而非烦躁""愿意再玩""战斗令人满足"等体验判断,需要对应人群的体验材料。它可能来自明确招募对象的试玩、访谈与行为记录,并且需要交代任务、时间和情境。本文没有这样的样本,因此不填入任何真人偏好结论。
这几种区分是本文为解释评价范围而作的工程整理,并非一套由MDA论文直接规定的四层验收标准。MDA讨论机制、运行动态与所引发的体验之间的联系:算法规则如何与输入共同形成过程,设计者希望过程带来什么体验。它帮助我们看见层间关系,却没有给出"规则测试通过即可证明好玩"的推导,也不负责替代实际玩家证据。1
以连击为例,伤害和冷却是机制的一部分;玩家与敌人的行为在时间上交织,形成压制、躲避或反击的动态;紧张、掌控感和挫败感则涉及体验。修改冷却确实可能影响后两者,但这条因果链仍需要观察,而不是把冷却单元测试的绿色标志当成体验结论。
因此,报告不必为一个游戏给出一个覆盖全部含义的"通过"。可以明确说:"指定构建在此场景下完成了暂停恢复规则验证;教程理解与真人体验尚未评价。"范围较窄的结论更方便开发者作决定,因为它告诉人们接下来缺的是哪一种证据,而不是留下一张看似完整的总分表。
成功一次和失败一百次,为什么不能对称解释
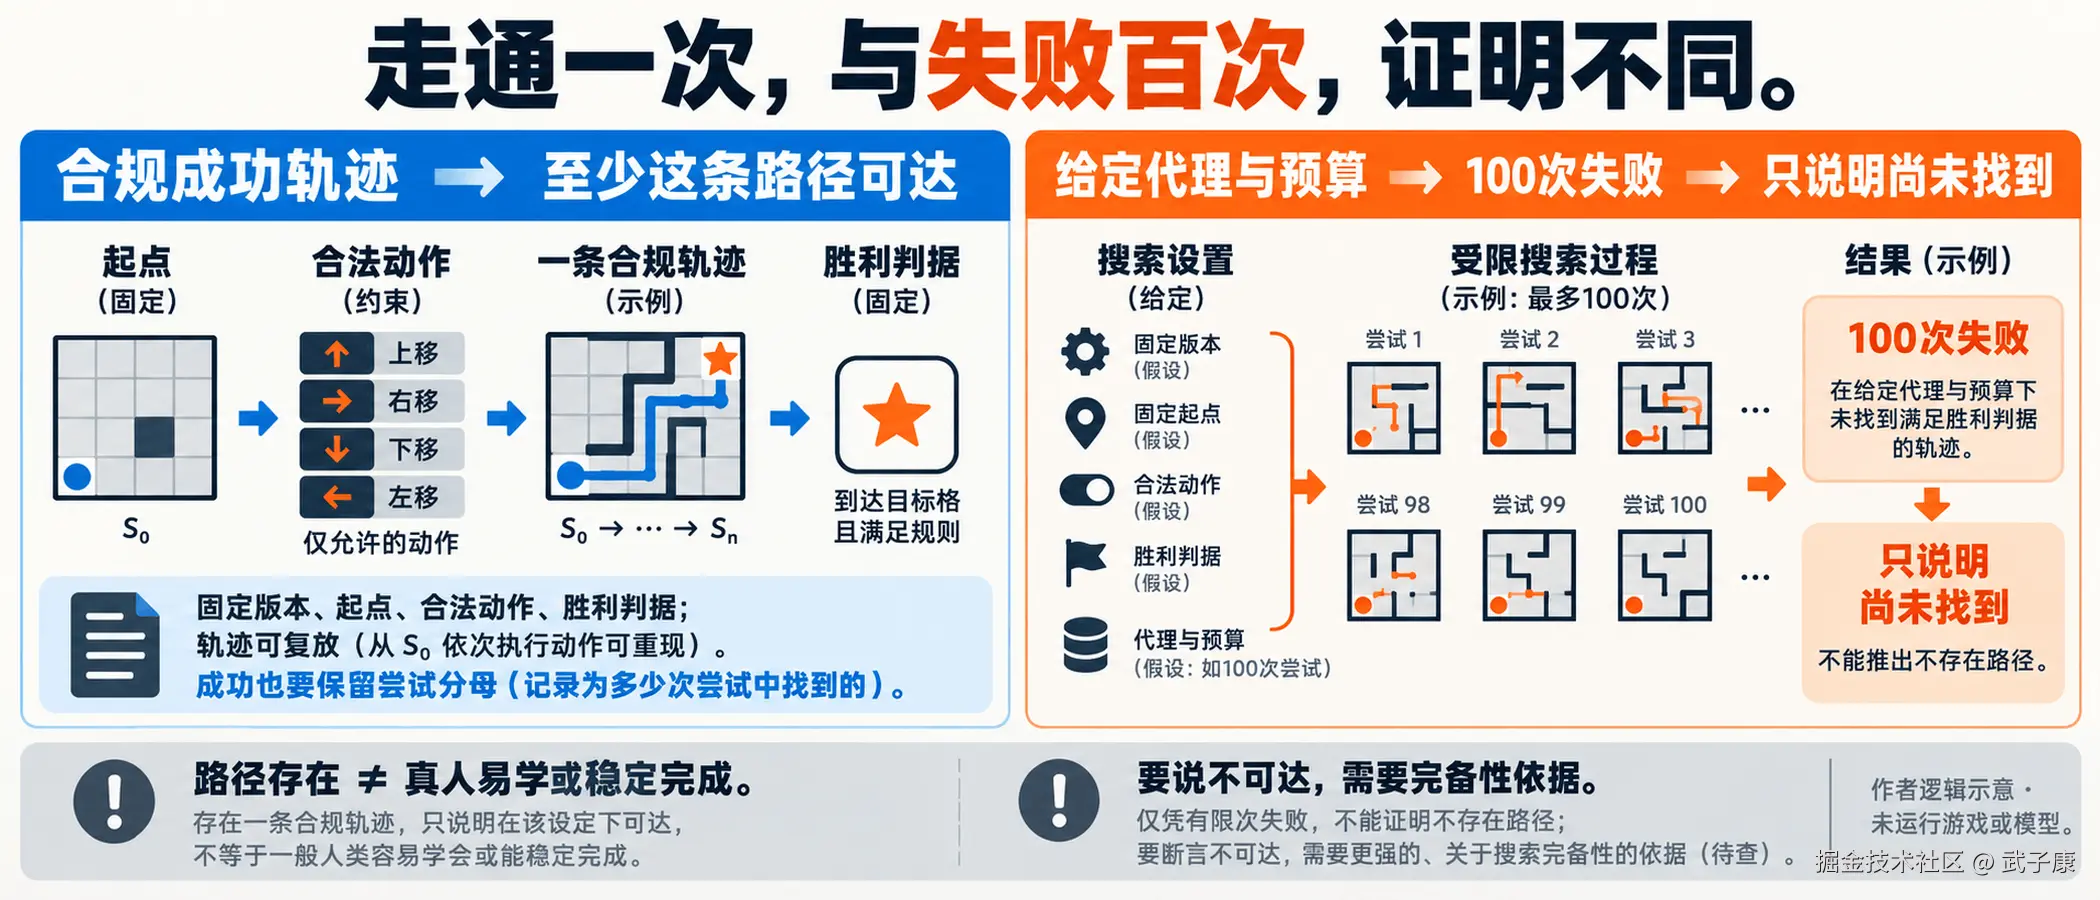
图注:作者假设机制示意,未运行。版本、起点、合法动作及胜利判据成立且轨迹可复放时,一次成功支持至少一条路径存在;百次普通代理失败只说明该代理在这些条件与预算内未找到路径。成功仍需保留尝试分母,不推断人类可玩性。数字是假设。
假设代理从规定起点出发,完全使用允许的动作,留下了可以重放的到达终点轨迹。在版本、初始状态和规则成立的前提下,这是一条存在性的证据:至少有这条路径能完成任务。若它借用了调试传送、隐藏状态或错误的胜利触发,则证明范围要随之收窄,不能继续称为普通玩家通路可达。
可达也不表示路径容易学会、对所有起点成立,或者能在真人的操作精度内稳定完成。一条依赖极窄时机的路径,可能在形式上成立,却与设计目标中的入门体验相距很远。是否属于缺陷,仍取决于目标人群、可接受难度和另外的验证。
代理失败一百次时,逻辑方向不同。我们观察到的是该代理在这些条件和预算内没有找到成功路径,而不是整个状态空间不存在路径。它可能没有看清平台边缘,也可能理解了跳跃却无法准确保持按键,或者还没到关键位置就耗尽了探索预算。
把尝试数扩大也不能自动消除这些限制。如果一百次都使用相同策略、相同误读和相同控制延迟,重复只会更稳定地重现同一种失败。它们未必是对全部可行路径的独立覆盖。只有在状态空间、动作集合和搜索方法足够受限且得到相应完备性证明时,才有机会从穷尽检查推出不可达;普通 视觉 代理的多轮试玩没有这个保证。
这并不意味着失败没有价值。一百次都卡在同一门口,是值得调查的线索。下一步可以回看门的状态、代理实际可见的提示、它发出的动作及游戏回执;在可复查条件下,区分"门未按规则打开"和"代理没有执行已知开门动作"。前者指向实现,后者首先指向所选代理或交互方式。
还可以设计一个很小的对照:固定场景,只改变是否向代理提供已确认的操作说明。如果失败模式改变,说明信息条件参与了结果。它仍然不能直接代表教程对真人有效,因为模型读取外部说明的方式与玩家在游戏中学习的方式不同。对照的作用是缩小解释,不是跨越证据对象。
一次成功也必须保留失败分母。若将来一百次尝试中仅一次完成,最准确的表达是发现了一条成功轨迹,同时在该代理协议下稳定性很低。只展示那一段录像会掩盖运行表现;反过来,只报百分之一又会丢失"路径已经被发现"的信息。两者服务不同判断,应在同一条结论中说明,不能互相抵消。
代理成绩变化时,先检查谁发生了变化
同一游戏版本下,更换模型、观察频率或动作接口,都可能改变成绩。低频截图使代理错过攻击前摇,持续按键被接口转换成单次点击,会让原本能完成的动作失败。若把这些因素统称为"游戏太难",修复工作可能转向错误方向。
反过来,把代理直接接入坐标和目标状态,会降低感知与操作难度。这样的接口有利于定位规则问题,但取得的成功不能原封不动地描述成"像真人一样从画面操作"。评价必须说明代理能够看到什么、怎样施加动作,以及一次决策跨越多少游戏时间。
不同预算也会影响结果。允许更长思考时间、更多 工具调用 或更长探索轨迹,通常改变了代理发现路径和故障的机会。比较两个版本时,如果一个拥有五百步,另一个只有五十步,成绩差不能仅归因于游戏修改。同一预算也未必代表相同墙钟成本或相同有效游戏时间,应先确定要比较哪一种资源。
开头的生存时间问题还存在另一种混杂:假设代理死亡后总会重新开始。这可以是外部调度器的固定策略,不能据此推断它"愿意再挑战"。同样,操作更频繁可能只是输入抖动,探索区域更大可能因为目标提示丢失,游玩更久可能只是忘了结算。指标与体验词之间需要机制证据,不能靠相同的文字联想完成转换。
对工程开发而言,更实用的比较是固定游戏构建、场景和代理条件,检查明确规则的违反是否减少;或者固定评测条件,只修改游戏,再研究哪些观测变化值得继续调查。若同时更换游戏和代理,报告仍可记录现象,但需要承认归因未决,不能给单个改动分配收益。
这些要求不等于先建设一个庞大的测试平台。若眼下只有"暂停恢复后敌人瞬移"的单个故障,保存构建身份、前置状态、操作顺序和可观察异常,就已经能帮助修复。多代理评分、复杂偏好模拟与总分汇总都应服从这个具体问题,而不是变成回答它的先决条件。
两个QA基准,评价的也不是同一种能力
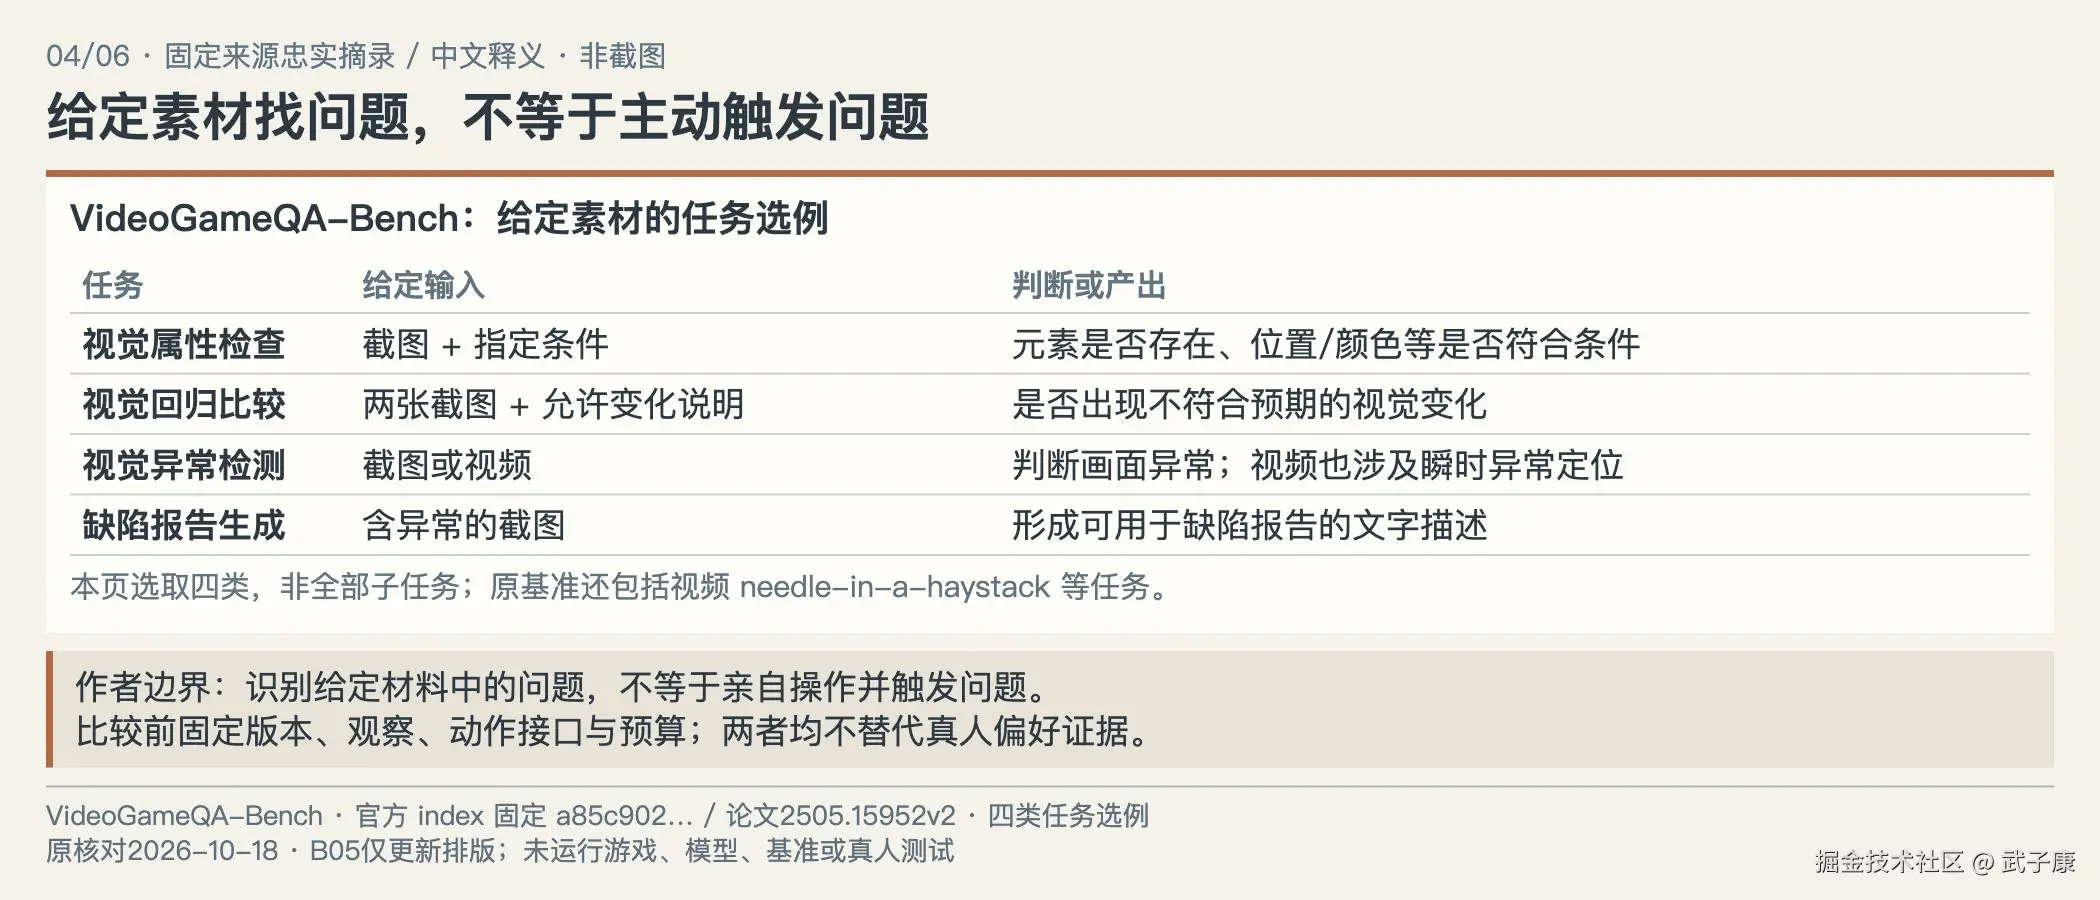
图注:原文证据与作者边界说明。VideoGameQA-Bench给定截图或视频进行视觉属性判断、回归比较、 异常检测 和报告生成;这不等于主动探索,也不是真人偏好测量。比较成绩还须固定游戏版本、观察、动作接口与预算。
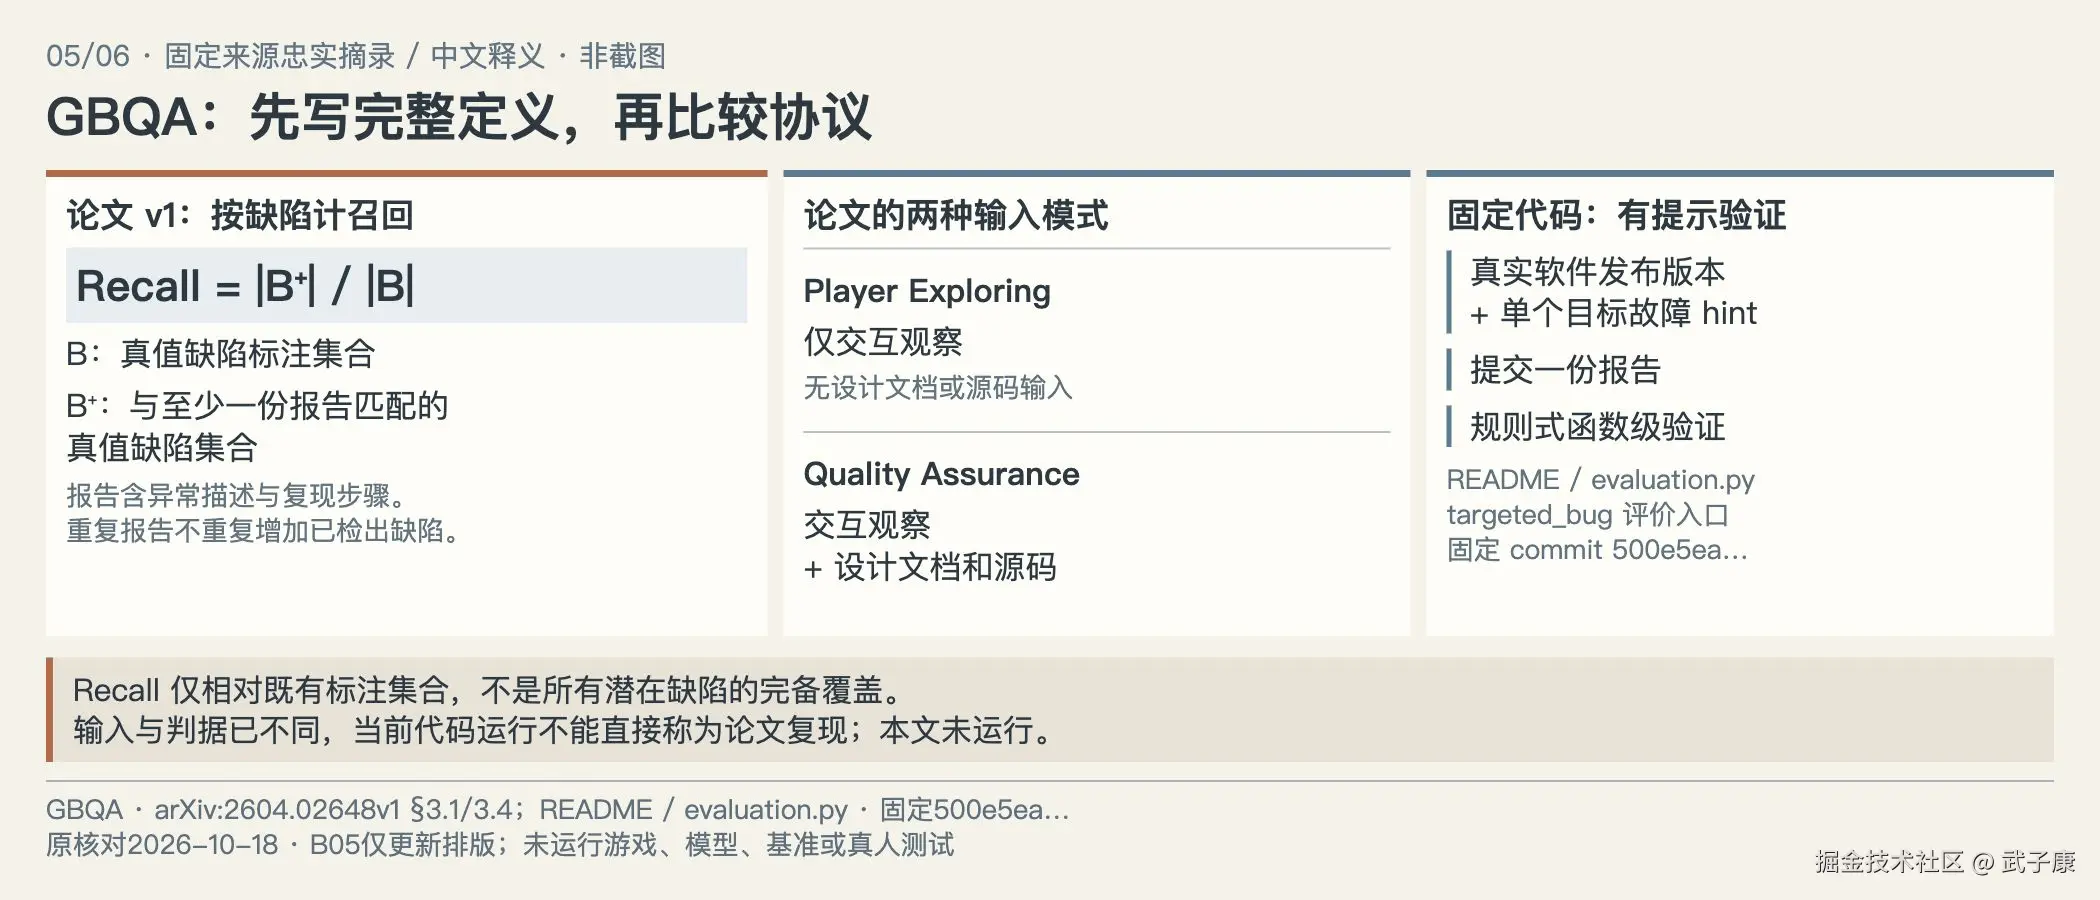
图注:原文证据与作者边界说明。论文v1:交互探索并提交异常与复现步骤,与人工核实缺陷标注匹配,Player Exploring/QA文档输入不同。固定代码500e5ea252ee7afccc275b0e28fbd6de8c8f5dfc:目标故障hint与规则式函数级评价。当前代码运行不能自动称论文复现;本文未运行。
VideoGameQA-Bench的官方任务包括对截图与视频进行视觉属性判断、回归比较、异常检测和 报告生成 。给定素材后识别问题,与亲自探索环境并触发问题,是两种不同能力。一个模型可以正确指出录像中的穿模,仍然不会在主动游玩中走到触发位置;没有发现问题也可能只是输入片段没有覆盖故障。2
GBQA则把主动探索中的缺陷发现作为任务:代理与游戏环境多轮交互,输出异常描述和复现步骤,再与人工核实的缺陷标注匹配。论文还区分仅靠交互观察的模式与提供设计文档、源码的模式。这种输入差异直接影响评价含义,不能把两种模式的成绩并为"普通玩家能力"。3
还要核对版本。本次固定的GBQA代码提交 500e5ea252ee7afccc275b0e28fbd6de8c8f5dfc, README 已描述另一种设置:面向真实软件发布版本,提供一个目标故障提示,以规则式函数级判据评价报告。它与论文v1的开放式多故障发现不是同一实验协议。预先给出线索,已经改变了"自主发现"的难度;不能拿当前代码运行结果直接声称复现论文。4
它们给开发者的启发是先明确任务对象,而不是借一个基准名字给自己的系统背书。视频异常识别、主动发现和复现报告各有用途,均不自动测量目标玩家的满意程度。本文只核对公开定义与代码,没有运行上述基准,没有复现论文成绩,也没有把研究者的结果当成本系统的性能。
如果我们要检查暂停故障,可以先用已知异常的录像判断视觉检测链路,再研究代理能否通过操作主动复现。前者通过而后者失败,值得查探索和控制条件;后者成功又不代表恢复后的节奏让玩家满意。把任务分清,才知道新增证据补上了哪一段,而不是让所有测试共同涂绿一个"可玩性"单元格。
公开基准中的标注也限定了分数口径。与已核实缺陷匹配的召回,回答的是已知标注被找到了多少;它不是对所有潜在缺陷的完备检查,也不能证明未报告的行为全部正常。基准任务定义提供可比较的实验边界,真实项目仍需检查自身游戏类型、接口与故障分布是否相符。
留下一条能够被推翻的结论
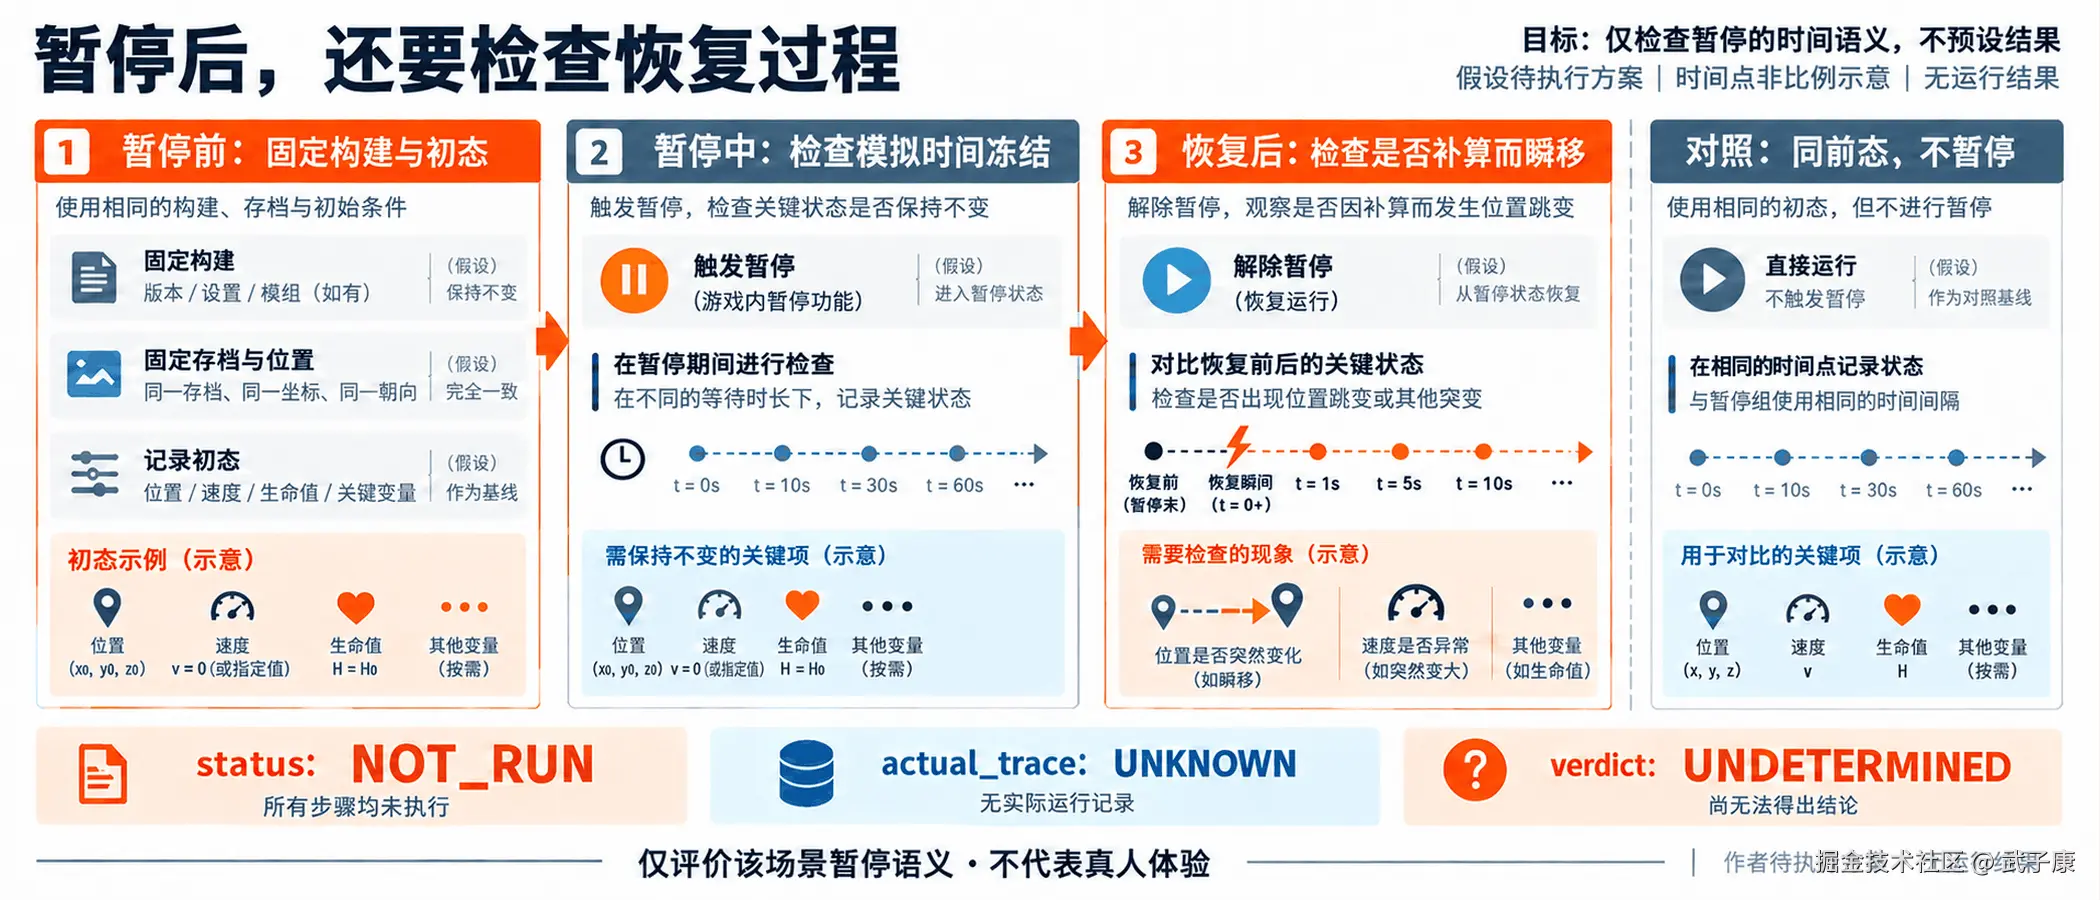
图注:作者假设机制示意,未运行。待执行暂停记录:固定构建、场景、起点与代理条件;预期暂停模拟时间冻结、恢复连续推进,菜单动画允许;与未暂停对照,同时观察模拟时钟和外部行为,复核恢复是否跳变。实际轨迹UNKNOWN,状态NOT_RUN、判定UNDETERMINED;不覆盖其他规则或真人偏好。
本文最终建议的产物只有一条评价结论记录。它不把程序、规则、代理和体验压进同一个分数,而是说明这一次要评价什么,拿到了什么证据,最多允许说到哪里。下面继续使用暂停案例,是待执行的填写示例;所有运行结果保持未知。
yaml
status: NOT_RUN
question: 暂停是否冻结游戏模拟时间并在恢复后连续推进
object: 指定构建中的暂停恢复规则
game_build_scene_and_initial_state: UNKNOWN
expected:
  paused_simulation_time: unchanged
  resumed_simulation_time: advances_without_paused_interval
  menu_animation: allowed
agent_observation_action_and_budget: UNKNOWN
controls: 同一前置状态下未暂停的时间推进
actual_trace_and_replay: UNKNOWN
verdict: UNDETERMINED
allowed_conclusion: 执行并验证后仅讨论该场景的暂停语义
not_covered: 其他规则、关卡整体可达性、真人理解与偏好
真正执行时,先把构建和初始条件固定,再定义模拟时间的观察来源。仅凭两帧画面相同,可能无法排除后台时间继续推进;仅凭内部时间字段不变,也可能漏掉与时间字段脱节的敌人更新。观察应与所声称的暂停规则对应,必要时同时查看状态与外部行为。
恢复后的对照尤其重要:游戏在暂停中积累时间差,恢复时一次性更新敌人位置,可能造成暂停时静止、解除后瞬移。若只检查暂停期间,结论就会漏掉核心故障。这里的示例是在说明未来应寻找的反例,没有提供已经发生的故障日志。
结果填写还应区分三种情况:证据支持预期、证据反驳预期,以及证据不足。截图丢失、场景未进入或代理没有执行暂停,都属于无法完成此项判断,不能默认为规则通过。若观察明确反驳预期,报告应附上能复查的操作与变化,而不是先给"体验糟糕"这类扩大范围的标签。
这条记录也使复测有明确对象。修复后在相同条件下重放原操作,检查原异常是否消失,同时保留构建变化;若换了场景或观察接口,则把变化写进结论。修复一个故障的证据不应被升级成"游戏所有暂停路径都已正确",除非另外取得相应覆盖。
当结论确实涉及真人时,记录的对象也必须改变:明确哪类玩家、进行了什么任务、采用什么提问或行为观察,以及样本与不确定性。不能沿用一份代理操作日志,再在最后加一句"玩家更喜欢"。在尚未开展这类研究时,让体验字段保持未评价,就是准确的项目状态。
AI测试的价值最终落在开发者能采取的动作上:重现一个规则故障、缩小一个可疑变化,或留下一个尚需补证据的问题。一次通关可以证明某条受限路径被走通,一次故障轨迹可以反驳某条预期;"值得继续玩"则需要相应玩家的证据。先把评价对象说清楚,测试结果才不会在交付时变成它从未证明过的承诺。
参考资料
-
Hunicke、LeBlanc、Zubek,MDA: A Formal Approach to Game Design and Game Research(2004),作者托管论文:www.cs.northwestern.edu/~hunicke/MD... 。本文仅用其机制、动态与体验的区别,不将本文工程整理称为论文的验收层级。 ↩︎
-
VideoGameQA-Bench官方项目及公开任务定义:asgaardlab.github.io/videogameqa... ;论文v2:arxiv.org/abs/2505.15... 。正文仅说明任务范围,未引用分数或执行其评测。 ↩︎
-
GBQA论文v1:arxiv.org/html/2604.0... ,第3.1、3.4节;官方代码:github.com/camel-ai/GB... 。正文仅使用任务、输入模式和标注评价定义,未复现模型成绩。 ↩︎
-
GBQA固定代码README:github.com/camel-ai/GB... ;固定奖励实现:github.com/camel-ai/GB... 。当前代码范围与论文v1分别记录,未运行。 ↩︎