【轻量化复现大模型 / KIMI K3】MTP / EAGLE‑3 模块交互式演示
0x00 概述
本文章是MTP (Multi‑Token Prediction) / EAGLE‑3(投机解码草稿)的完整交互式演示,13 个 Tab 覆盖 MTP 偏移对齐、联合损失隐式正则化、特征融合 θ 0 I 初始化、加速比理论与实测、lossless verify 判据、LK 损失、Draft 自回归链路、Cache 回滚正确性、参数量分解。全部 CPU 实时运行,复用 mtp_layer.py、eagle3.py、speculative.py 真实源码算子。
注:
- 项目github.com/RossiLH/Mod... 和系列博客是我的一个尝试,也是我学习的过程。不确定是否满足读者的需求,我自己会反思改进,也希望大家提出宝贵意见。
- 涉及 KIMI K3,DeepSeek V4,PI0.5,PI0.7 等模型。后续可能会跟踪新模型。
- 全 CPU 复刻,不涉及 GPU,也不涉及大规模训练(这是另外一个庞杂深邃的领域)和硬件。
- 模型的组件尽量是原始大模型的缩小版,如果组件没有开源版本,则用近似组件替代。
- 会解释每个组件在解决一个什么问题、这个问题难在哪、为什么只能这么解、解法的原理是什么,以及组件之间如何咬合成一个整体。重点不是记名词,而是理解一条主线。
- 每个主要组件都有可直接运行的 Gradio demo------无需 GPU。另有若干可视化脚本(
plot_*.py),可生成静态图。 - 所有文件行号基于本地源码快照;源码后续变化时,行号可能移动,但函数名和调用关系仍可作为定位入口。
- 为了保证每个文章可以尽量独立成文,所以有些内容会在不同文章中都存在,可能在系列层面上存在冗余,还请大家理解。
0x01 核心数学
MTP 让主模型每个位置同时预测 xt+1 (LM Head) 和 xt+2 (MTP Head),一次训练步得到两份梯度。预训练完成后,MTP 层微调成 EAGLE‑3 草稿模型,配合投机解码推理加速。
1.1 MTP 层前向(§4.1.4)
MTP 层读 backbone 隐藏态 ht 和下一步嵌入 emb(xt+1),预测 xt+2:
ini
h_fused = proj (cat ([ h_norm (h [t]), e_norm (emb (x [t+1])) ], dim=-1) )   # (B, T‑1, C)

h_mtp   = h_fused + block.attn (h_fused) + block.ffn (h_fused)           # 骨架块

output  = norm (h_mtp)                                                  # (B, T‑1, C)

logits  = lm_head (output)                                               # (B, T‑1, V) → 预测 x [t+2]
其中:
h_norm,e_norm: 各自 RMSNorm,先归一化再拼接,避免两个来源的尺度互相干扰proj: 无 bias 线性投影(2C → C),减少参数量、避免偏移block: 复用主干Kimi3Block(KDA 或 MLA 注意力 + MoE FFN)lm_head: 与主模型共享词表头
偏移语义 : MTP logits 第 t 位预测 xt+2(比主模型快一拍),训练时用 labels[:, 2:] 对齐。
1.2 联合损失(Table 1)
ini
loss = lm_loss + λ・mtp_loss

lm_loss  = CE (logits_lm, labels [:, 1:])    # 主模型预测 x [t+1]

mtp_loss = CE (logits_mtp, labels [:, 2:]) # MTP 预测 x [t+2]λ(loss_weight): 默认 0.3 (kimi3‑master)- 隐式正则化: 联合目标让 MTP 梯度回传到骨干,迫使 ht 同时对 xt+1 和 xt+2 有信息量,等价于对骨干表示做隐式正则化
1.3 EAGLE‑3 特征融合(§4.1.4)
推理阶段 MTP 层微调成草稿模型,输入从"骨干隐藏态"改为"低/中/高三层特征融合":
ini
W_E3 初始 = [θ 0 I]    # (C, 3C), 最后一列单位阵,其余零

fuse ([f_low, f_mid, f_high]) = W_E3・cat ([f_low, f_mid, f_high])

= f_high # 初始时- θ 0 I 的直觉: 初始融合输出完全等于高层特征 h_h---正是 MTP 预训练时的输入;模型从"只信高层"逐步学到"吸收低/中层特征"。
- 特征取自 AttnRes 第 1、4、最后块的输出 (
feature_blocks=(0, 3, -1)) - 无 bias: 与 MTP proj 一致,减少参数
1.4 LK 损失 (Eq. 16)
投机解码的加速比正比于逐 token 接受率 sum_x min(p(x), q(x))。K3 直接优化这个量:
perl
L_LK = −log sum_x min (p (x), q (x)) # 温度 1, 无 ground‑truth CE 项- 为什么不用 KL : 减法 KL 是接受率的上界代理,但容量受限的草稿模型不能保证最大化 KL 就最大化接受率;LK 直接优化真正决定加速比的量
p == q时L_LK = θ(完美草稿)L_LK随分布疏离单调增大
1.5 投机解码加速比
lossless 投机采样下,每个目标前向的期望 token 数:
ini
E [tokens/target] = (1 − r^(L+1)) / (1 − r)

r = sum_x min (p (x), q (x))     # 逐 token 接受率

L = 草稿长度 (draft_len)
r = 1(完美草稿):E = L + 1(一次前向产出 L+1 个 token)r = 0(全拒绝):E = 1(退化为普通自回归)- 关键洞察: 加速比同时依赖 r 和 L;r < 0.5 时 L 再长收益也有限
1.6 Lossless Verify 判据
逐位置接受/拒绝,一旦拒绝立即截断:
bash
对每个草稿位置 i:

    采 u ~ U (0, 1)

    若 u <= p_i (c_i) /q_i (c_i)  → 接受 c_i, 继续看 i+1

    否则                         → 拒绝,从 norm (max (p_i − q_i, 0)) 重采 1 个 bonus token

每轮产出 = 接受前缀长度 + 1 (bonus token)- lossless 性质: 接受后输出分布与目标模型精确一致(无质量损失)
- greedy 模式: 确定性路径,草稿 token == 目标 argmax 才接受(测试用)
1.7 Cache 快照‑回滚
投机解码部分接受时,被拒绝的后缀对应的 cache 状态必须丢弃:
ini
每轮开始前: snap = snapshot_caches (caches)      # 深拷贝

逐草稿位置:增量前向打分(cache 被推进)

verify 后:   restore_caches (caches, snap)       # 回滚到快照

重放已接受前缀 + bonus token → cache 停在正确位置- KDA cache: 克隆
state+ 三个卷积窗口 - MLA cache: 克隆
kv_latent+length - 正确性保证: Recompute(全序列重跑)与 CacheRollback(增量+回滚)在固定 seed 下产出逐 token 一致
1.8 KimiDeltaAttention 完整层
ini
q, k, v = ShortConv (W_{q/k/v}・x)

q = L2Norm (SiLU (q)),  k = L2Norm (SiLU (k)),  v = SiLU (v)

g = g_min・sigmoid (exp (A_h)・(W_α^up・W_α^down・x + b_α))   # 有界衰减

β = sigmoid (W_β・x)                                            # 写入强度

(o, S) = kda_recurrent /kda_chunkwise/kda_step               # 核心递推

output = W_o・[sigmoid (W_g・x) ⊙ HeadRMSNorm (o)] # 输出门关键洞察: MTP 预训练是 "一次前向,两份监督"--- 骨干 h t 同时服务 LM Head 和 MTP Head,等价于对骨干做隐式正则化。EAGLE‑3 推理是
"一次前向,L+1 份产出"--- 草稿模型用 L 步起草,目标模型一次 verify,接受前缀 + bonus token 一起写入。
0x02 设计思路
2.1. 零重复代码原则
Gradio demo 不重复实现任何可视化逻辑,全部从已有脚本导入:
| Tab | 函数来源 | 覆盖模块 |
|---|---|---|
| 1. 架构总览 | _mtp_demo_figs.fig_architecture_overview(内联示意图) |
MTP + EAGLE-3 全链路 |
| 2. 偏移对齐 | plot_mtp.fig_mtp_offset(复用) |
mtp_layer.py |
| 3. E1 联合损失 | plot_mtp.fig_e1_joint_loss(复用) |
mtp_layer.py + model.py |
| 4. E2 融合初值 | plot_mtp.fig_e2_init_curve(复用) |
eagle3.py / FeatureFusion |
| 5. E3 加速比理论 | plot_mtp.fig_e3_speedup(复用) |
eagle3.py / speedup_from_acceptance |
| 6. E5 实测加速 | eagle3_demo.run_spec_decode + fig_measured_speedup(复用) |
speculative.py / SpeculativeDecoder |
| 7. Verify 判据 | _mtp_demo_figs.fig_verify_demo(内联,调用 verify_tokens) |
speculative.py / verify_tokens |
| 8. LK 损失 | _mtp_demo_figs.fig_lk_loss_demo(内联,调用 lk_loss) |
eagle3.py / lk_loss |
| 9. Draft 链路 | _mtp_demo_figs.fig_draft_pipeline_demo(内联,调用 Eagle3Draft) |
eagle3.py / Eagle3Draft |
| 10. Cache 回滚 | _mtp_demo_figs.fig_cache_rollback_demo(内联,调用 snapshot/restore) |
speculative.py / kda.py / mla.py |
| 11. 结构与参数 | _mtp_demo_figs.fig_mtp_structure_and_params(内联) |
mtp_layer.py / MTPLayer |
| 12. loss_weight 扫描 | _mtp_demo_figs.fig_loss_weight_sweep(内联,复用 discussion 函数) |
discussion.py + mtp_layer.py |
| 13. 加速比热力图 | _mtp_demo_figs.fig_acceptance_heatmap(内联) |
eagle3.py / speedup_from_acceptance |
2.2 各 Tab 说明
1. 架构总览
MTP 预训练 + EAGLE-3 投机解码的整体架构示意:Backbone → ht → LM Head (xt+1),同时 ht + emb(xt+1) → MTP Layer → LM Head (xt+2);推理阶段 MTP 微调为 EAGLE-3 Draft,配合 FeatureFusion 0 0 I + 投机解码做加速。
2. 偏移对齐
可视化 MTP 的 token 流:x₁ x₂ x₃ x₄ x₅ x₆,箭头标注 LM 预测 xt+1、MTP 预测 xt+2。
3. E1 联合损失
可调 loss_weight 和训练步数,实时对比"纯 LM"与"LM + MTP"的 lm_loss 收敛曲线。核心结论:联合目标对骨干表示做隐式正则化。
4. E2 融合初值
对比 EAGLE-3 特征融合三种初始化:0 0 I(官方)、随机、全零。0 0 I 起步 loss 为 0,从不扰动 MTP 预训练起点。
5. E3 加速比理论
可调接受率范围、高亮 r 和 L,画出 4 条理论曲线(L=1/2/4/7)。公式:Etokens/target = (1 - r^(L+1)) / (1 - r)。
6. E5 实测加速
在 CPU 小模型上跑真实 SpeculativeDecoder,输出:
- Recompute vs Rollback 两路径是否逐 token 一致(回滚正确性证明)
- greedy / lossless 两条路径的实测接受率与 tokens/forward
- 实测点叠在理论曲线上
运行较慢(真实模型前向)。
7. Verify 判据
交互式演示 verify_tokens 纯函数:调词表大小、草稿长度、目标/草稿分布偏向、判据模式(greedy / lossless)、随机种子。上图显示各位置的 p(c) vs q(c),下图显示逐位置接受比(绿色接受、红色拒绝)+ bonus token 来源。
8. LK 损失
展示 LK 损失 = -log(sum min(p,q)) 随分布疏离的单调关系。左图:疏离步数 vs LK loss;右图:接受率 vs LK loss。核心:LK loss 直接优化接受率,而非 KL 代理。
9. Draft 链路
EAGLE-3 Draft 自回归起草的完整链路:特征融合 → MTP 层 → LM Head → 采样 → 嵌入 → 下一步。上图:每步 top-k 概率热力图;下图:分布熵随步数变化(反映自回归漂移)。
10. Cache 回滚
验证 KDA / MLA 两种 cache 的 snapshot → 污染 → restore 流程。输出数值对比表格,证明回滚后与快照完全一致(max|diff| < 1e-6)。这是投机解码 cache rollback 后端正确性的基础。
11. 结构与参数
MTP 层结构图(h_norm / e_norm → proj → block → norm)+ 参数量分解(fusion+3norm vs block)。对比 mla / kda 两种注意力类型的 MTP 层参数量。
12. loss_weight 扫描
扫描 MTP loss_weight(λ)从 0 到 2.0,画出最终 lm_loss 和 total_loss 曲线。展示 λ 对联合训练的影响:过小则 MTP 正则弱,过大则总损失噪声增加。
13. 加速比热力图
接受率 r × 草稿长度 L 的二维热力图,白色等高线标记 1.5/2.0/3.0/5.0/8.0 tokens/forward。直观展示加速比的联合分布。
2.3 运行方式
python experiments\models\llm\kimi_k3\mtp\gradio_mtp_demo.py启动后访问 http://localhost:7860,13 个 Tab 水平排列,点击切换。
Tab 1: 架构总览
目的
展示 MTP 预训练 + EAGLE‑3 投机解码的全链路架构:训练阶段一次前向同时监督 xt+1 和 xt+2,推理阶段 MTP 微调成草稿模型配合投机解码加速。
UI 组件与参数影响
无参数,点击按钮直接运行。
输出图解读
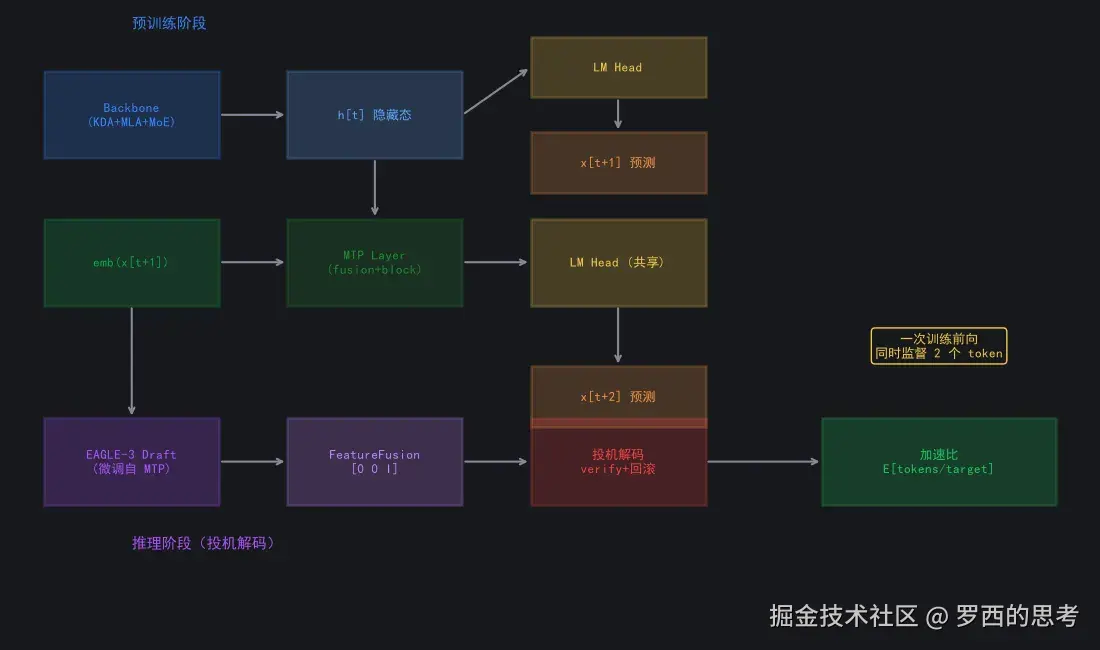
tab-1
单图(架构示意图):
上排(预训练阶段) :
- 蓝色框:Backbone (KDA+MLA+MoE) → ht 隐藏态
- 黄色框:LM Head → xt+1 预测
- 绿色框:MTP Layer (fusion+block) → LM Head(共享)→ xt+2 预测
- 绿色框:emb(xt+1) 作为 MTP 的额外输入
- 黄色标注框:"一次训练前向同时监督 2 个 token"
下排(推理阶段) :
- 紫色框:EAGLE‑3 Draft(微调自 MTP)
- 浅紫色框:FeatureFusion 0 0 I
- 红色框:投机解码 verify+回滚
- 绿色框:加速比 Etokens/target
你该看什么: 预训练阶段 MTP 与 LM 共享骨干和 lm_head;推理阶段草稿模型从 MTP 微调而来,特征融合是唯一新增参数
为什么重要
这是理解 MTP/EAGLE‑3 全链路的入口图。训练和推理共享 MTP 层权重,但输入来源不同(训练时用骨干隐藏态,推理时用特征融合输出)。
Tab 2: 偏移对齐
目的
可视化 MTP 的 token 流偏移语义:主模型预测 xt+1, MTP 额外预测 xt+2(§4.1.4)。
UI 组件与参数影响
无参数,点击按钮直接运行。
输出图解读
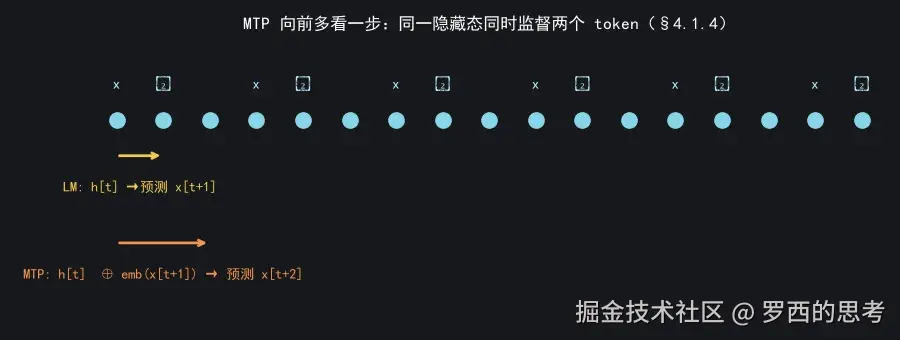
tab-2
单图(偏移示意图):
- 展示 token 序列 x₁ x₂ x₃ x₄ x₅ x₆
- 箭头标注:LM 预测 xt+1(偏移 1),MTP 预测 xt+2(偏移 2)
- 你该看什么:MTP 比 LM 快一拍---看到 emb(xt+1) 就能预测 xt+2
为什么重要
偏移对齐是 MTP 训练正确性的基础:mtp_loss 必须用 labels[:, 2:] 对齐(而非 labels[:, 1:]),否则 MTP 学到的是重复 LM 的任务而非额外预测。
Tab 3: 联合损失
目的
对比 "纯 LM"与"LM + MTP"联合训练的 lm_loss 收敛曲线,验证联合目标对骨干表示做隐式正则化(§4.1.4,Table 1)。
UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| MTP loss_weight | 0.1‑2.0 | 0.5 | MTP 损失权重 λ。增大 → MTP 正则化更强,但总损失噪声增加 |
| 训练步数 | 10‑80 | 40 | 训练步数。增大 → 收敛更充分,差异更明显 |
输出图解读
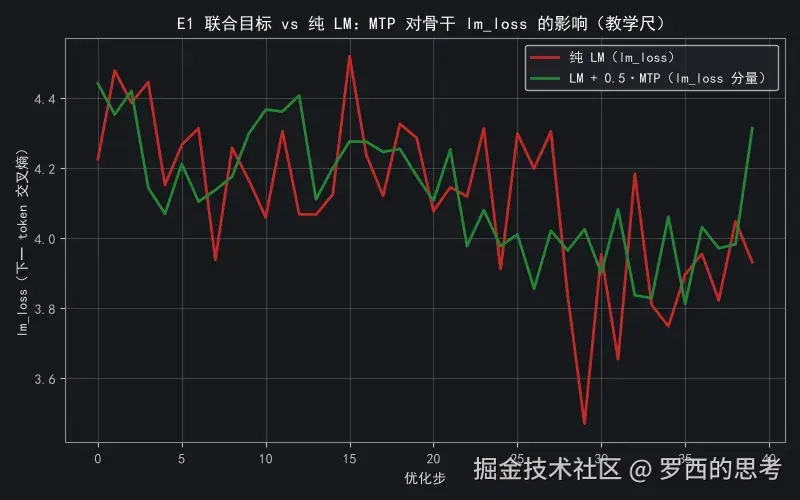
tab-3
单图(训练曲线):
- 两条折线:纯 LM(无 MTP) vs
LM + MTP的 lm_loss 收敛轨迹 - 你该看什么:联合训练的 lm_loss 最终更低---MTP 梯度回传对骨干做隐式正则化
调节建议
- 想看正则化效果更明显 → 增大训练步数到 60+
- 想看 λ 过大的副作用 → 增大 loss_weight 到 1.5+
为什么重要
MTP 的训练动机不是"让 MTP 头预测更准",而是"通过多目标联合训练改善骨干表示"。此 Tab 量化展示联合训练对 lm_loss 的改善。
Tab 4: 融合初值
目的
对比 EAGLE‑3 特征融合三种初始化:θ θ I(官方)、随机、全零。验证 θ θ I 初始不扰动 MTP 预训练起点(§4.1.4)。
UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| 特征维度 | 16‑128 | 32 | 融合投影的维度 C。增大 → 参数更多,收敛更慢 |
| 优化步数 | 20‑200 | 60 | 训练步数。增大 → 三条曲线差异更明显 |
输出图解读
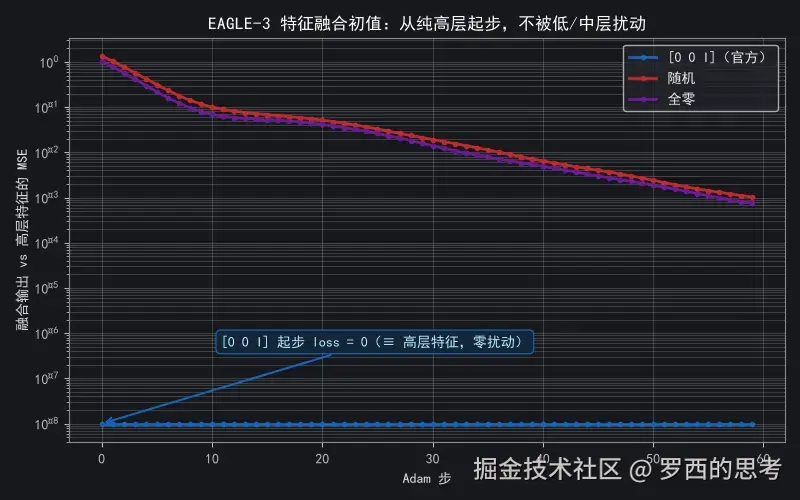
tab-4
单图(融合误差曲线,semilogy):
- 三条折线:θ θ I(蓝色,起步 loss ≈ 0 → 显示为 eps=1e‑8)、随机(红色,起步 loss 高)、全零(紫色,起步 loss 最高)
- 蓝色箭头标注:"θ θ I 起步 loss = θ (≡高层特征,零扰动) "
- 你该看什么:θ θ I 初始融合输出 ≡ 高层特征,起步误差为 θ,从不扰动 MTP 预训练起点;随机/全零起步有初始噪声,收敛更慢
为什么重要
EAGLE‑3 从 MTP 预训练权重微调而来。如果融合初值引入大幅扰动(随机/全零),微调起步就偏离 MTP 预训练的最优点,需要更多步才能恢复。θ θ I 保证平滑过渡。
Tab 5: 加速比理论
目的
画出投机解码加速比的理论曲线 Etokens/target = (1 − r^(L+1)) / (1 − r),展示接受率 r 和草稿长度 L 对加速比的联合影响。
UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| 接受率范围左 | 0.01‑0.5 | 0.1 | X 轴左端。减小 → 看到更低的接受率区间 |
| 接受率范围右 | 0.5‑0.99 | 0.98 | X 轴右端。增大 → 看到接近 1 的接受率 |
| 高亮接受率 r | 0.1‑0.99 | 0.8 | 十字线竖线位置。增大 → 高亮更高接受率 |
| 高亮草稿长度 L | 1‑10 | 7 | 对应理论曲线。增大 → 高亮更长草稿 |
输出图解读
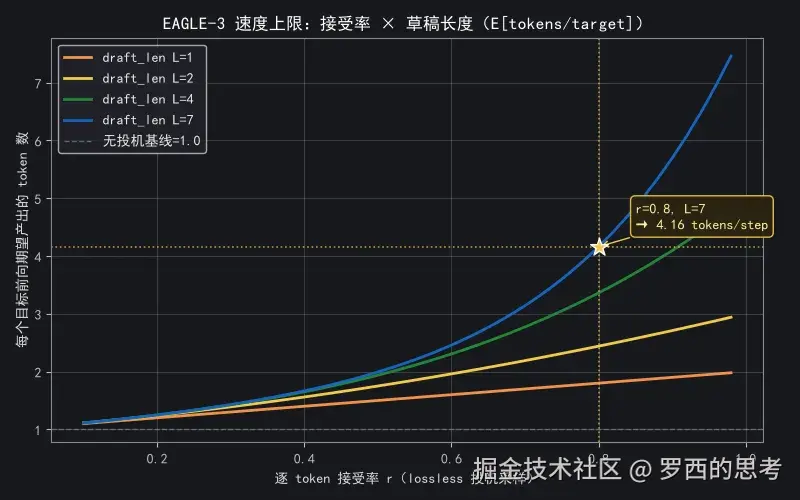
tab-5
单图(理论曲线):
- 4 条折线:L=1,2,4,7 的加速比随接受率 r 变化
- 黄色十字虚线:竖线 = 高亮接受率 r,横线 = 对应 tokens/step 值
- 黄色星号:十字线交点,带白边框
- 标注框 :
r=X, L=Y → Z tokens/step
你该看什么:r < 0.5 时所有曲线接近 1(几乎无加速);r > 0.8 时 L=7 可达 5x+ 加速
调节建议
- 想看低接受率区间 → 减小接受率范围左到 0.01
- 想看高加速比 → 增大高亮接受率 r 到 0.95+
为什么重要
这是投机解码的核心公式,直接决定工程上选择多大的草稿长度 L 以及需要多高的接受率 r 才有收益。
Tab 6: 实测加速
目的
在 CPU 小模型上跑真实 SpeculativeDecoder,验证 Recompute 与 CacheRollback 两条路径逐 token 一致,并将实测接受率叠在理论曲线上。
UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| 随机种子 | 0‑9999 | 1234 | 随机种子,影响草稿/目标分布 |
| prompt 长度 | 4‑16 | 8 | 输入 prompt 的 token 数 |
| max_new_tokens | 8‑48 | 24 | 最大生成 token 数。增大 → 统计更稳定但更慢 |
| draft_len | 1‑7 | 3 | 草稿长度 L。增大 → 每轮可能产出更多 token |
输出图解读
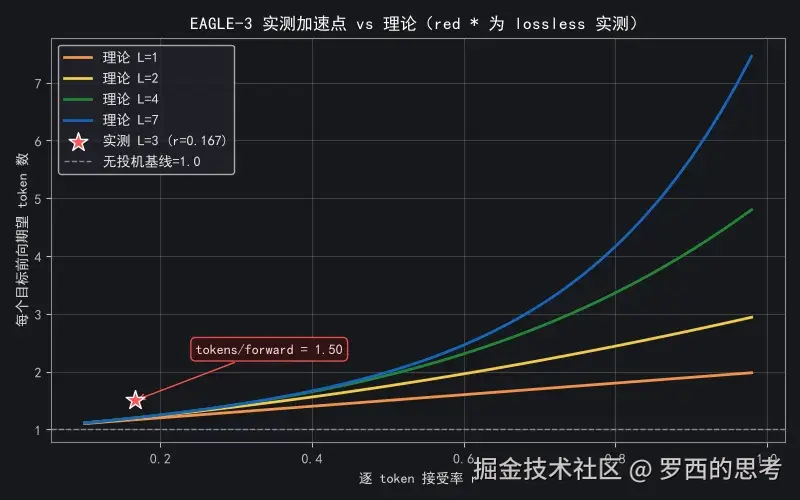
tab-6
单图(实测点 vs 理论曲线):
- 理论曲线(4 条彩色折线,legend 标注 "理论 L=X")
- 红色星号(白边框) :实测点,legend 标注 "实测 L=X (r=X.XXX) "
- 红色箭头标注框 :
tokens/forward = X.XX - 你该看什么:实测 tokens/forward 是否落在对应 L 的理论曲线上
为什么重要
理论公式假设接受率 r 恒定,实测验证真实场景下接受率是否稳定、加速比是否与理论吻合。Recompute vs Rollback 一致性是 cache 回滚实现正确性的数值证明。
Tab 7: Verify 判据
目的
交互式演示 verify_tokens 纯函数:逐位置接受/拒绝判据、bonus token 重采(§4.1.4)。
UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| 词表大小 V | 4‑64 | 16 | 词表大小。增大 → 分布更稀疏,接受率更低 |
| 草稿长度 L | 1‑10 | 5 | 草稿位置数。增大 → 更多位置可能被拒 |
| 目标偏向 token 0 强度 | 0.0‑10.0 | 3.0 | 目标偏向 token 0 的 logits 偏移。增大 → 目标更确定 |
| 草稿偏向 token V‑1 强度 | 0.0‑10.0 | 0.5(原3.0) | 草稿分布偏向 token V‑1 的 logits 偏移。增大 → 草稿与目标越不一致 |
| 判据模式 | greedy / lossless | lossless | greedy: 确定性匹配;lossless: 随机接受 |
| 随机种子 | 0‑999 | 42 | 随机种子(lossless 模式下可复现) |
输出图解读
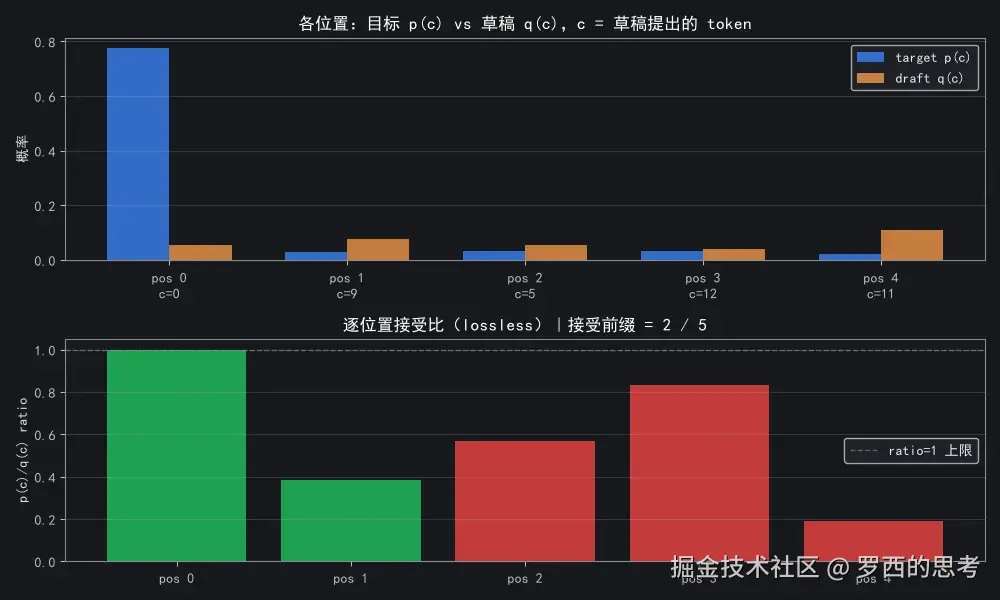
tab-7
2×1 布局:
上图:各位置目标 p(c) vs 草稿 q(c),c = 草稿提出的 token
- 蓝色柱 :目标分布 p 在草稿提出 token c 上的概率(不是任意 token,而是 draft 实际提出的那个)
- 橙色柱 :草稿分布 q 在同一 token c 上的概率
- X 轴 :每个位置下方标注
c=19、c=15等,告诉你 draft 在该位置提出了哪个 token
你该看什么:
- 蓝橙差距越大(橙 >> 蓝) ,ratio = p(c)/q(c) 越小 → 越可能被拒绝
- 蓝橙接近(蓝 ≈ 橙),ratio 接近 1 → 容易被接受
- 蓝色越高于橙色(蓝 >> 橙) ,ratio 大于 1 → 容易被接受
- pos 0-2 橙色远高于蓝色 → ratio ≈ 0.03-0.07 → 必拒
- pos 3-4 蓝橙几乎相等 → ratio ≈ 0.92, 0.56 → 容易接受
下图:逐位置接受比 p(c)/q(c)
- 绿色柱:被接受位置(在前缀内)
- 红色柱:被拒绝位置(第一个拒绝及之后)
- 灰色虚线:ratio=1 上限
你该看什么 :ratio 越接近 1 越容易被接受;第一个红色柱就是拒绝截断点。注意:ratio 高不一定接受 ------因为判据是 u ~ Uniform(0,1) ≤ ratio,ratio=0.92 仍有 8% 概率被拒绝。
调节建议
- 想看全接受 → 设目标偏向=0,草稿偏向=0(两分布接近)
- 想看全拒绝 → 增大草稿偏向到 10(草稿与目标完全不一致)
- 想看 greedy 确定性 → 切换模式为 greedy
为什么重要
verify_tokens 是投机解码的核心判据---它决定每轮接受多少草稿 token、重采哪个 bonus token。lossless 性质保证接受后输出分布与目标模型精确一致。
Tab 8: LK 损失
目的
展示 LK 损失 = −log(sum min(p,q)) 随分布疏离的单调关系,验证 LK 直接优化接受率而非 KL 代理(Eq. 16)。
UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| 词表大小 | 8‑128 | 32 | 词表大小。增大 → 分布更稀疏,LK 损失范围更大 |
| 疏离步数 | 10‑200 | 50 | draft 从 target 渐变到均匀的步数。增大 → 曲线更平滑 |
| 最终疏离程度 | 0.5‑2.0 | 1.0 | 最终插值系数。增大 → draft 更远离 target |
输出图解读
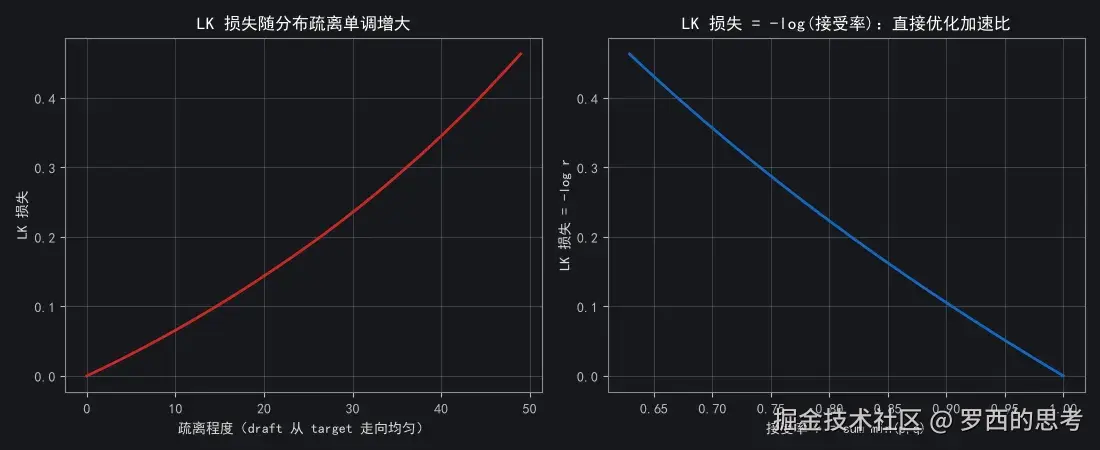
tab-8
1×2 布局:
左图:LK 损失随分布疏离单调增大
- 红色折线:X 轴 = 疏离程度(draft 从 target 走向均匀),Y 轴 = LK 损失
- 你该看什么:LK 损失随疏离单调增大---越不像目标,损失越高
右图:接受率 vs LK 损失
- 蓝色折线:X 轴 = 接受率 r = sum min(p,q),Y 轴 = LK 损失
- 标题:LK 损失 = −log(接受率)
- 你该看什么:LK 损失是接受率的负对数---最小化 LK 等价于最大化接受率
为什么重要
传统做法用 KL 散度训练草稿模型,KL 是接受率的上界代理,容量受限时不保证最大化接受率。LK 直接优化真正决定加速比的量,是 K3 选择 LK 而非 KL 的根本原因。
Tab 9: Draft 链路
目的
展示 EAGLE‑3 Draft 自回归起草的完整链路:特征融合 → MTP 层 → LM Head → 采样 → 嵌入 → 下一步,观察分布随步数的漂移。
UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| 随机种子 | 0‑999 | 42 | 随机种子 |
| draft 步数 | 1‑12 | 5 | 草稿自回归步数。增大 → 漂移更明显 |
| MTP 注意力类型 | mla / kda | mla | 骨架块用 MLA 还是 KDA 注意力 |
| 采样温度 | 0.0‑2.0 | 1.0 | 0=greedy(argmax),1=标准采样,>1 更随机,<1 更确定 |
输出图解读
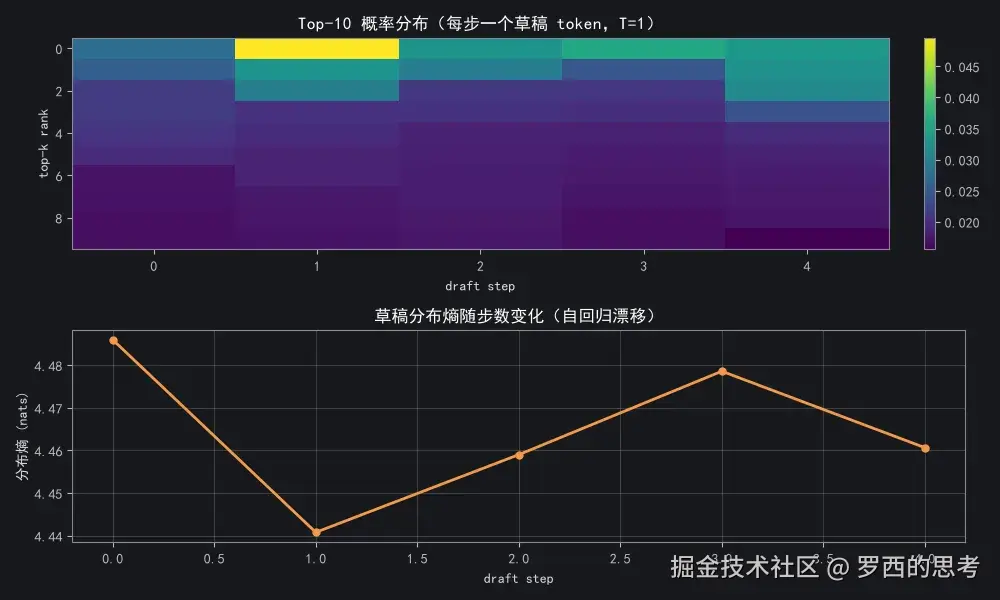
tab-9
2×1 布局:
上图:Top‑k 概率热力图
- viridis 色图,每列 = 一个 draft step,每行 = top‑k rank
- 你该看什么:首步分布集中(top‑1 概率高),后续步分布逐渐变平(自回归漂移)
下图:分布熵随步数变化
- 橙色折线:X 轴 = draft step,Y 轴 = 分布熵(nats)
- 你该看什么:熵随步数增大---草稿每步吃自己前一步的输出,误差累积导致分布变平
调节建议
- 想看退化(全相同 token)→ 设 temperature=0
- 想看多样分布演化 → 设 temperature=1.0(默认)
- 想看更随机 → 设 temperature=1.5+
为什么重要
草稿自回归的漂移是投机解码的核心瓶颈---步数越多,草稿分布越偏离目标分布,接受率越低。此 Tab 可视化漂移过程,帮助理解为什么 L=7 是 K3 的选择(更长收益递减)。temperature 参数帮助理解采样策略对分布多样性的影响。
Tab 10: Cache 回滚
目的
验证 KDA / MLA 两种 cache 的 snapshot → 污染 → restore 流程,证明回滚后与快照完全一致(max|diff| < 1e‑6)。
UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| 随机种子 | 0‑999 | 0 | 随机种子 |
| Cache 类型 | KDA / MLA | KDA | 选择验证哪种 cache 的回滚 |
输出图解读
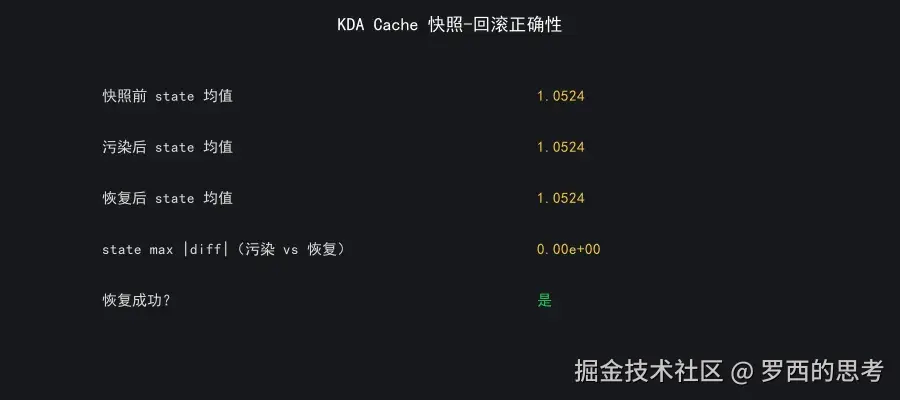
tab-10
单图(数值对比表):
- 文字表格展示:快照前数值、污染后数值、恢复后数值、max|diff|
- 绿色标注"是":恢复成功
- 你该看什么:恢复后数值与快照完全一致,max|diff| < 1e‑6
为什么重要
投机解码部分接受时,被拒绝的后缀对应的 cache 状态必须丢弃。如果回滚不正确,后续生成会读到被污染的 cache,导致输出偏离目标模型。此 Tab 是 cache rollback 实现正确性的基础验证。
Tab 11: 结构与参数
目的
展示 MTP 层结构(h_norm / e_norm → proj → block → norm)和参数量分解,对比 mla / kda 两种注意力类型。
UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| MTP 注意力类型 | mla / kda | mla | 骨架块用 MLA 还是 KDA 注意力 |
输出图解读
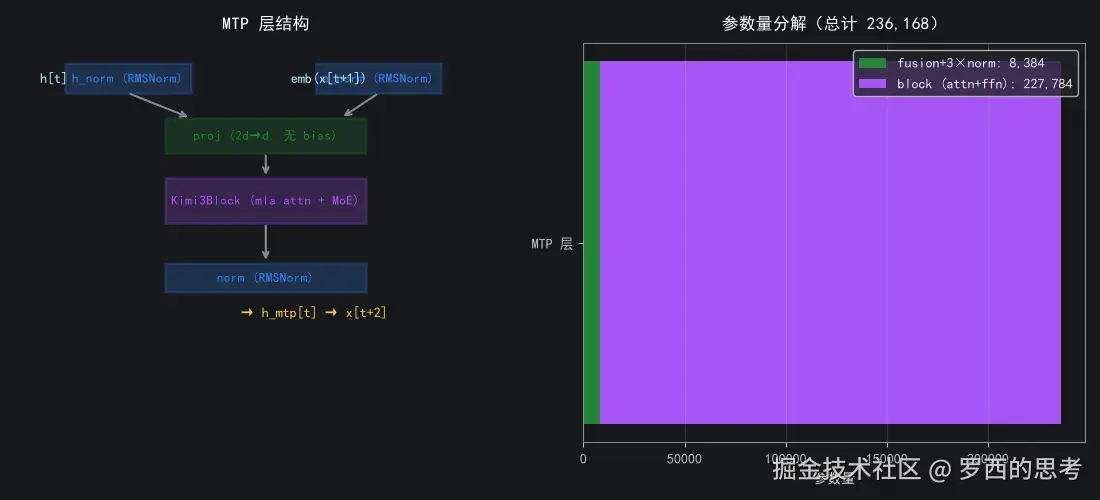
tab-11
1×2 布局:
左图:MTP 层结构示意
- 蓝色框:h_norm(RMSNorm)、e_norm(RMSNorm)、norm(RMSNorm)
- 绿色框:proj(2d→d,无 bias)
- 紫色框:Kimi3Block(mla/kda attn + MoE)
- 箭头:ht + emb(xt+1) → fusion → block → norm → h_mtp → xt+2
右图:参数量分解
- 绿色条:fusion + 3×norm 参数量(= 2d² + 3d)
- 紫色条:block(attn+ffn)参数量
- 标题显示总参数量
- 你该看什么:proj 占大头(2d²),block 参数取决于注意力类型
为什么重要
MTP 层的参数效率直接影响训练和推理开销。proj 无 bias 是 K3 的设计选择---减少参数量、避免偏移。mtp_param_count 公式(2d²+3d)是 proj + 3 个 RMSNorm 的精确下界。
Tab 12: loss_weight 扫描
目的
扫描 MTP loss_weight(λ)从 0 到 2.0,展示 λ 对联合训练的影响:过小则 MTP 正则弱,过大则总损失噪声增加。
UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| 训练步数 | 10‑100 | 30 | 每个权重值的训练步数。增大 → 收敛更充分但运行更慢 |
输出图解读
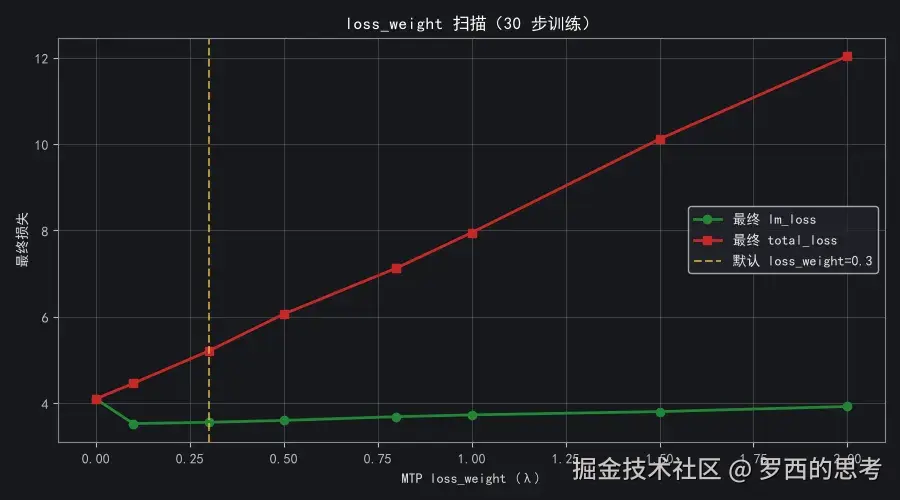
tab-12
单图(loss_weight 扫描):
- 绿色圆点线:最终 lm_loss 随 λ 变化
- 红色方块线:最终 total_loss 随 λ 变化
- 黄色虚线:默认 loss_weight=0.3
- 你该看什么:lm_loss 在 λ≈0.1‑0.5 左右最低(MTP 正则化效果最佳);λ 过大时 total_loss 上升(MTP 损失噪声主导)
为什么重要
λ 的选择是 MTP 训练的关键超参---太小则 MTP 正则化不足,太大则 MTP 损失噪声干扰骨干训练。K3 选择 0.3 是在正则化效果和训练稳定性之间的平衡。
Tab 13: 加速比热力图
目的
接受率 r × 草稿长度 L 的二维热力图,直观展示加速比的联合分布。
UI 组件与参数影响
无参数,点击按钮直接运行。
输出图解读
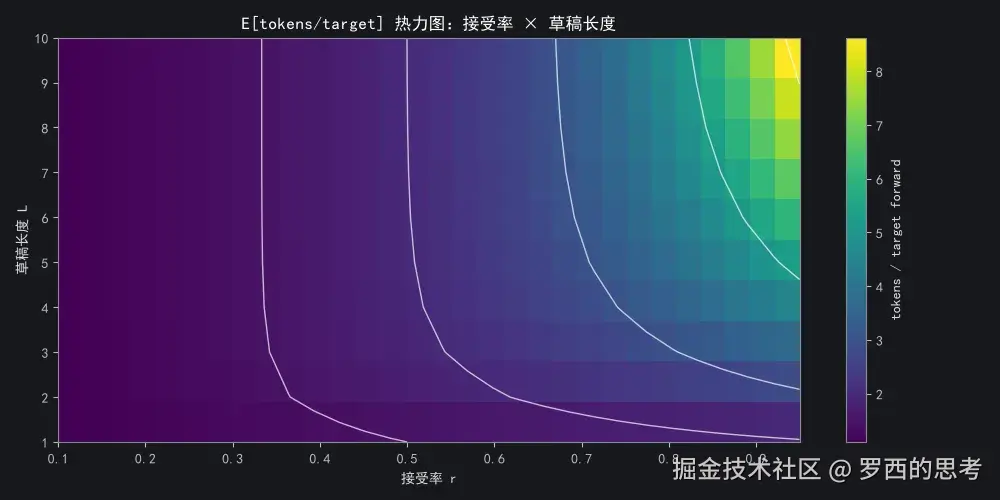
tab-13
单图(热力图):
- viridis 色图:X 轴 = 接受率 r(0.1‑0.95),Y 轴 = 草稿长度 L(1‑10)
- 颜色值 = Etokens/target = (1 − r^(L+1)) / (1 − r)
- 白色等高线:标记 1.5 / 2.0 / 3.0 / 5.0 / 8.0 tokens/forward
- 你该看什么:左下角(低 r、短 L)接近 1(无加速);右上角(高 r、长 L)可达 8x+ 加速;r < 0.5 时 L 再长收益也有限
为什么重要
此热力图是 Tab 5 理论曲线的二维视图,帮助工程决策:给定实测接受率 r,选择多大的 L 能达到目标加速比。等高线直接回答"需要 r≥多少、L≥多少才能达到 3x 加速"。
0x03 验证策略总览
| Tab | 测试函数 | 验证点 | 通过标准 |
|---|---|---|---|
| 2 偏移对齐 | test_mtp_loss_is_next_next_token |
MTP logits 第 t 位对应 labels:, t+2 | loss 组合正确 |
| 3 E1 联合损失 | test_mtp_loss_composition_weight |
loss = lm + w·mtp | allclose(atol=1e‑4) |
| 4 E2 融合初值 | test_eagle3_fusion_init_is_identity_on_high |
θ θ I 初始融合 ≡ 高层特征 | torch.allclose |
| 5 E3 加速比 | test_eagle3_speedup_formula |
r=1→L+1, r=0→1, 通用公式 | abs < 1e‑9 |
| 7 Verify 判据 | test_verify_all_accept_when_same_dist |
p==q 时全接受 | n_accepted == L |
| 7 Verify 判据 | test_verify_rejects_and_truncates |
草稿错时被截断 | n_accepted == 0 |
| 7 Verify 判据 | test_verify_bonus_from_residual |
bonus 从残差重采 | bonus == target argmax |
| 8 LK 损失 | test_eagle3_lk_loss_and_acceptance |
p=>q→loss=0, 非负 | allclose(atol=1e‑5) |
| 9 Draft 链路 | test_eagle3_draft_autoregressive |
draft 自回归形状正确 | shape == (B, n_steps, V) |
| 10 Cache 回滚 | test_cache_snapshot_restore_kda |
KDA snapshot›restore 一致 | torch.equal |
| 10 Cache 回滚 | test_cache_snapshot_restore_mla |
MLA snapshot›restore 一致 | kv_latent equal, length equal |
| 11 结构与参数 | test_mtp_layer_structure |
h_norm/e_norm/proj(block)/norm 结构完整 | isinstance 检查 |
| 11 结构与参数 | test_param_count_is_exact |
mtp_param_count == 2d²+3d |
公式吻合 |
| 6 E5 实测 | test_recompute_and_rollback_agree |
两条路径逐 token 一致 | torch.equal |
TransFormer-封面
0xFF 参考
本文使用 markdown.com.cn 排版