一、为什么我们需要"视觉底座"?
在大模型技术快速发展的今天,各行各业都在探索智能化升级的落地------从传统业务的自动化改造,到AI Agent的逐步引入。货拉拉也不例外,越来越多的业务环节正在用更智能的方式提升效率。但不管是传统业务自动化,还是Agent跑通业务流程,都面临同一个难题:业务输入的不是纯文本。
司机入驻时上传的驾驶证、行驶证,费用审核时的发票、高速小票、合同文件------这些图片里的文字信息,系统能不能准确识别、提取出来?换句话说,视觉OCR感知能力,就是这些业务的"眼睛 ",是整个智能体系的底座。
二、沿着货运链路,看视觉感知全景
依托自研视觉算法,上传一张图,关键信息秒级提取。在货拉拉,这项技术已深入司机准入、车贴、金融、地图、安全、风控、费用治理、服务治理等8大业务场景------从标准证件、财务票据到街景图片,各类图片都能稳稳识别。视觉感知能力,就像一双"隐形的慧眼",贯穿在从司机注册到订单完成的整条货运链路里。
2.1 司机注册:准入第一关
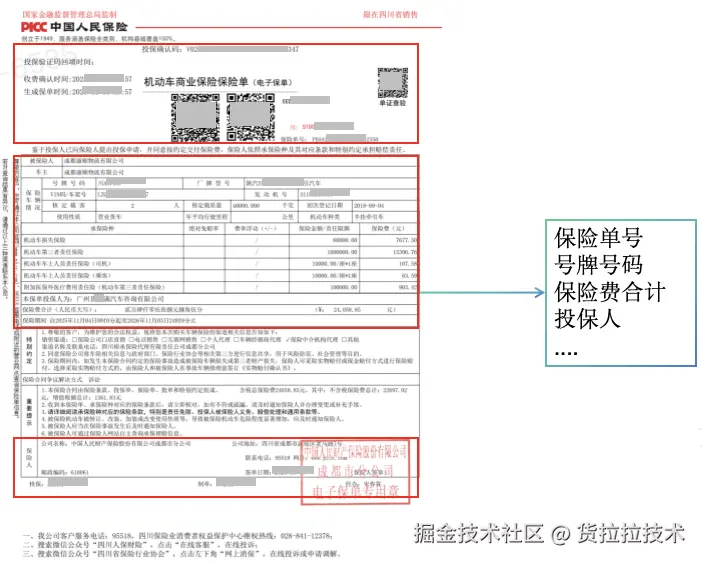
司机注册是业务的第一道关口,需要对各类证件和车辆资质进行严格审核。传统的人工审核方式耗时耗力,而视觉感知技术的引入,让这一过程变得智能且高效。当司机上传证件时,算法能自动引导拍摄清晰的照片,并精准识别驾驶证、行驶证、保险单等文件中的关键信息。这不仅仅是简化了操作步骤,更重要的是实现了信息的自动化提取与核验。
保险单识别 示例
2.2 车贴核验:多任务视觉检测的落地
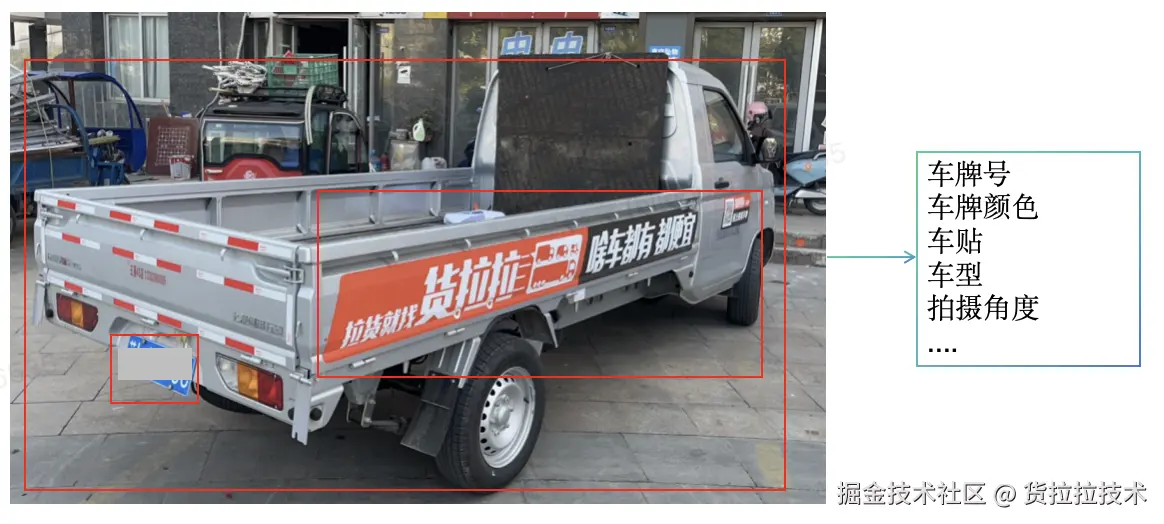
司机上传车贴照片参与激励活动时,OCR技术能够快速识别车辆的车牌号码,并与车辆信息进行绑定,确保了活动数据的真实有效,让每一份激励都落到实处。除了车牌识别,我们还会结合车型识别、车贴检测等多个维度的视觉能力,对上传照片做综合判断。这套多任务检测方案在车贴核验场景中表现稳定,既提升了活动真实性校验的效率,也为市场运营提供了覆盖率数据支撑。
车贴识别示例
2.3 用户下单:降低操作门槛
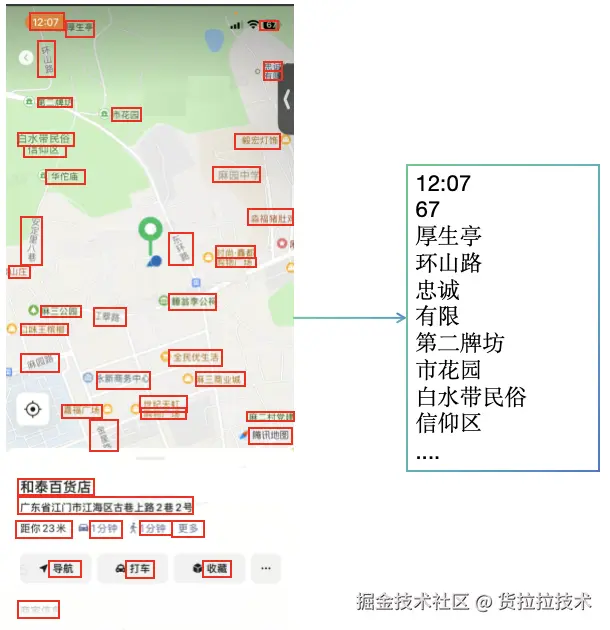
用户下单时,经常需要从微信对话、地图截图等图片中提取地址信息。OCR能力可以自动识别图片中的文字,地址一键填入,大幅降低用户操作门槛。除了地址识别,通用视觉能力还支撑着隐私保护场景------用户上传的街景照片中,系统会自动检测人脸和车牌区域并做模糊处理,避免隐私信息泄露。
通用OCR地址识别示例
2.4 出车与装车:服务起点的安全核验
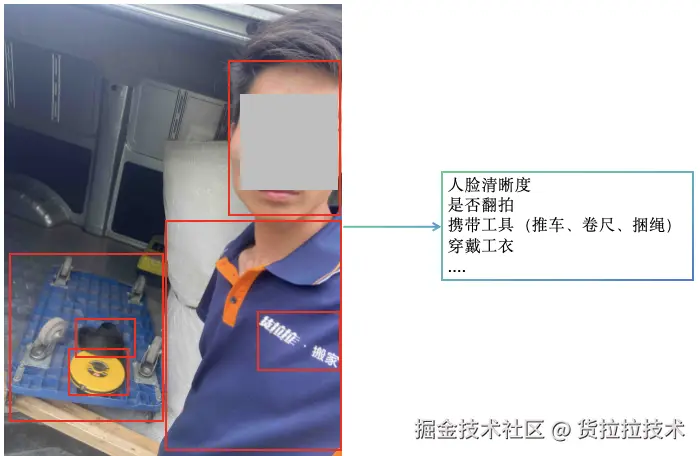
司机每日出车签到时,系统会通过人脸检测与车牌识别完成人车匹配核验,确保出车司机与注册车辆一致。在服务质量管控场景,视觉算法还会对着装规范、工具携带等合规项做自动检查,把质量问题前置到服务开始前。
搬家小哥签到举例
2.5 行程中:货物安全管家
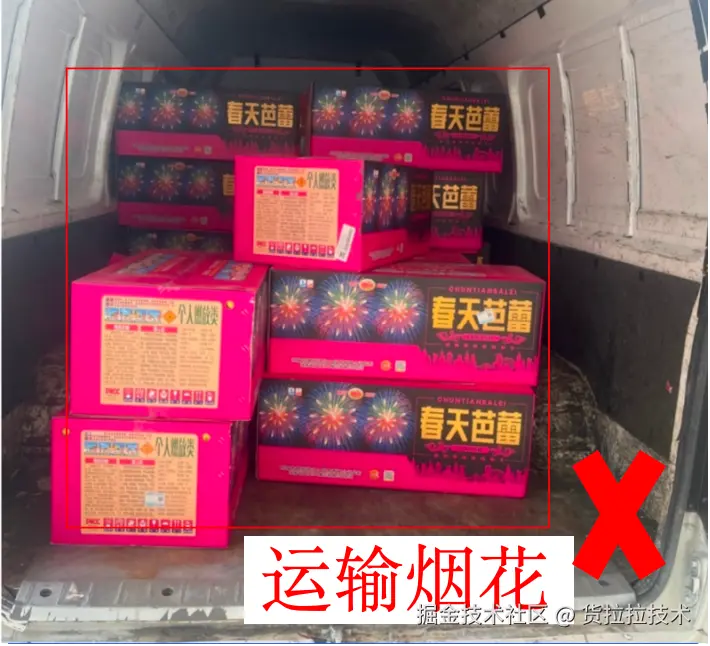
司机装车完成后上传现场照片,视觉算法会自动检查货物安全。核心能力是危险品检测------自动识别装车照片中是否存在烟花爆竹、易燃易爆品等违禁货物,及时预警。这套能力随着业务场景扩展不断迭代优化,覆盖的车型和场景越来越全。
危险品识别示例
2.6 完单:费用审核与交易闭环
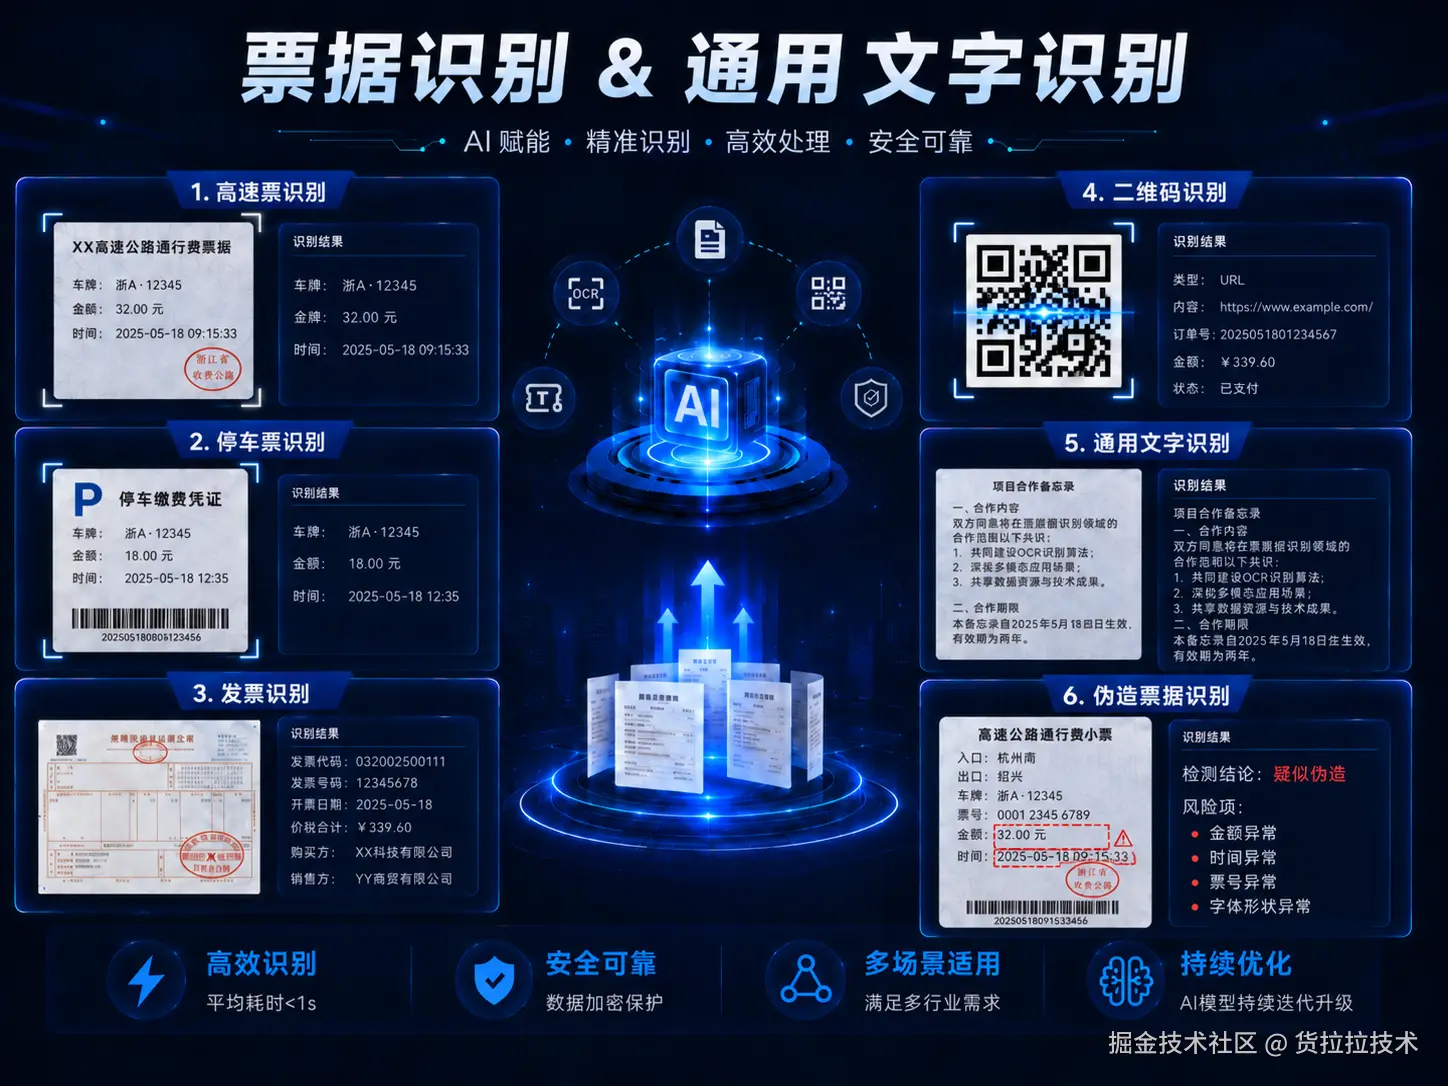
订单完成后,会涉及高速费、停车费等附加费用的自动核验。票据OCR可以快速提取金额等关键信息,与司机填报内容自动比对,同时还能识别票据篡改、造假等异常情况。在法务场景,视觉能力还支撑合同用印比对------把纸质扫描件和电子定稿自动比对,确保条款没有被改动。
票据识别能力总览
图示信息仅做说明,非实际订单中票据信息
三、视觉底座的技术演进
前面我们看到,货拉拉的视觉感知能力已经渗透到业务的方方面面。这套体系不是一天建成的------从最早的传统CV流水线,到现在大模型与传统模型混合调度,我们一直在探索"什么场景用什么技术最合适"。
3.1 传统CV流水线:成熟稳定的基本盘
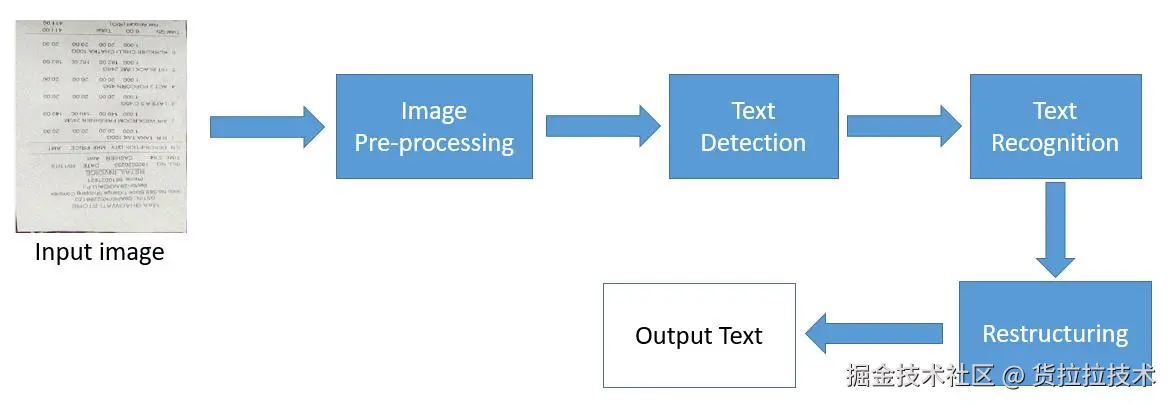
最开始做OCR的思路很朴素:按 业务 场景定制方案------每个场景都有自己独立的文字检测、识别流程,为这个场景的需求量身打磨。在实际的业务落地中,我们发现传统CV方案和多模态大模型各有擅长的领域;
传统OCR流水线架构
传统 CV 方案的优势很明显:
- 延迟低:毫秒级响应,适合高频实时场景
- 效果稳定:在结构化、版式固定的场景,准确率非常高
车牌识别、人脸打码这类高频、结构化、延迟敏感的场景,传统CV方案依然是性价比最高的选择。
而对于以下场景,多模态大模型则展现出了独特的优势:
- 版式碎片化的文档:比如保险单,不同保险公司、不同时期的版式千差万别,每加一种版式,都需要额外的适配和维护工作
3.2 多模态大模型:打开新场景的钥匙
多模态大模型(MLLM)的快速发展,正好为我们解决这类问题提供了新的思路。我们在保险单识别、合同比对等审核等场景中做了尝试。
典型多模态大语言模型(MLLM)架构
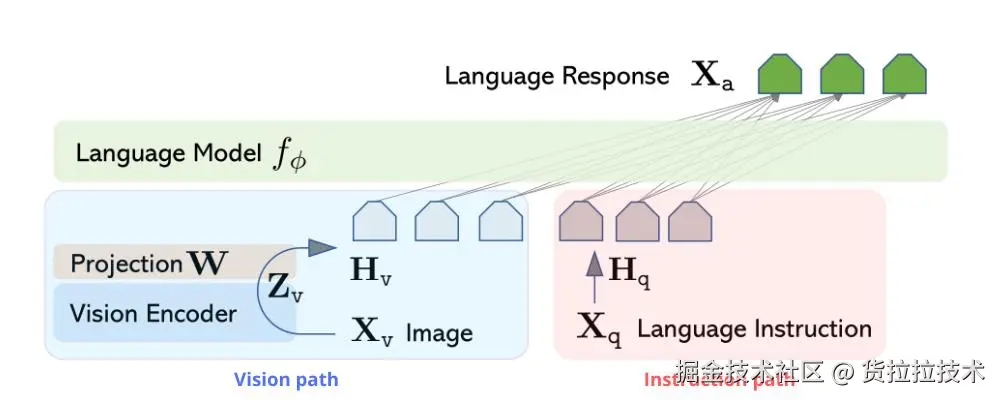
从架构上看,典型的MLLM由三部分组成:
- 视觉编码器:通常基于CLIP等预训练模型,把输入图片转换成视觉特征向量
- 投影层:把视觉特征对齐到语言模型的嵌入空间,让大模型能"看懂"图片
- 大语言模型:接收对齐后的视觉token和文本指令,像处理文字一样处理图片信息,生成回答
和传统OCR"检测→识别→后处理"的流水线不同,MLLM是端到端的------模型直接从图片输入到输出结构化结果,中间不需要人工设计的后处理规则。
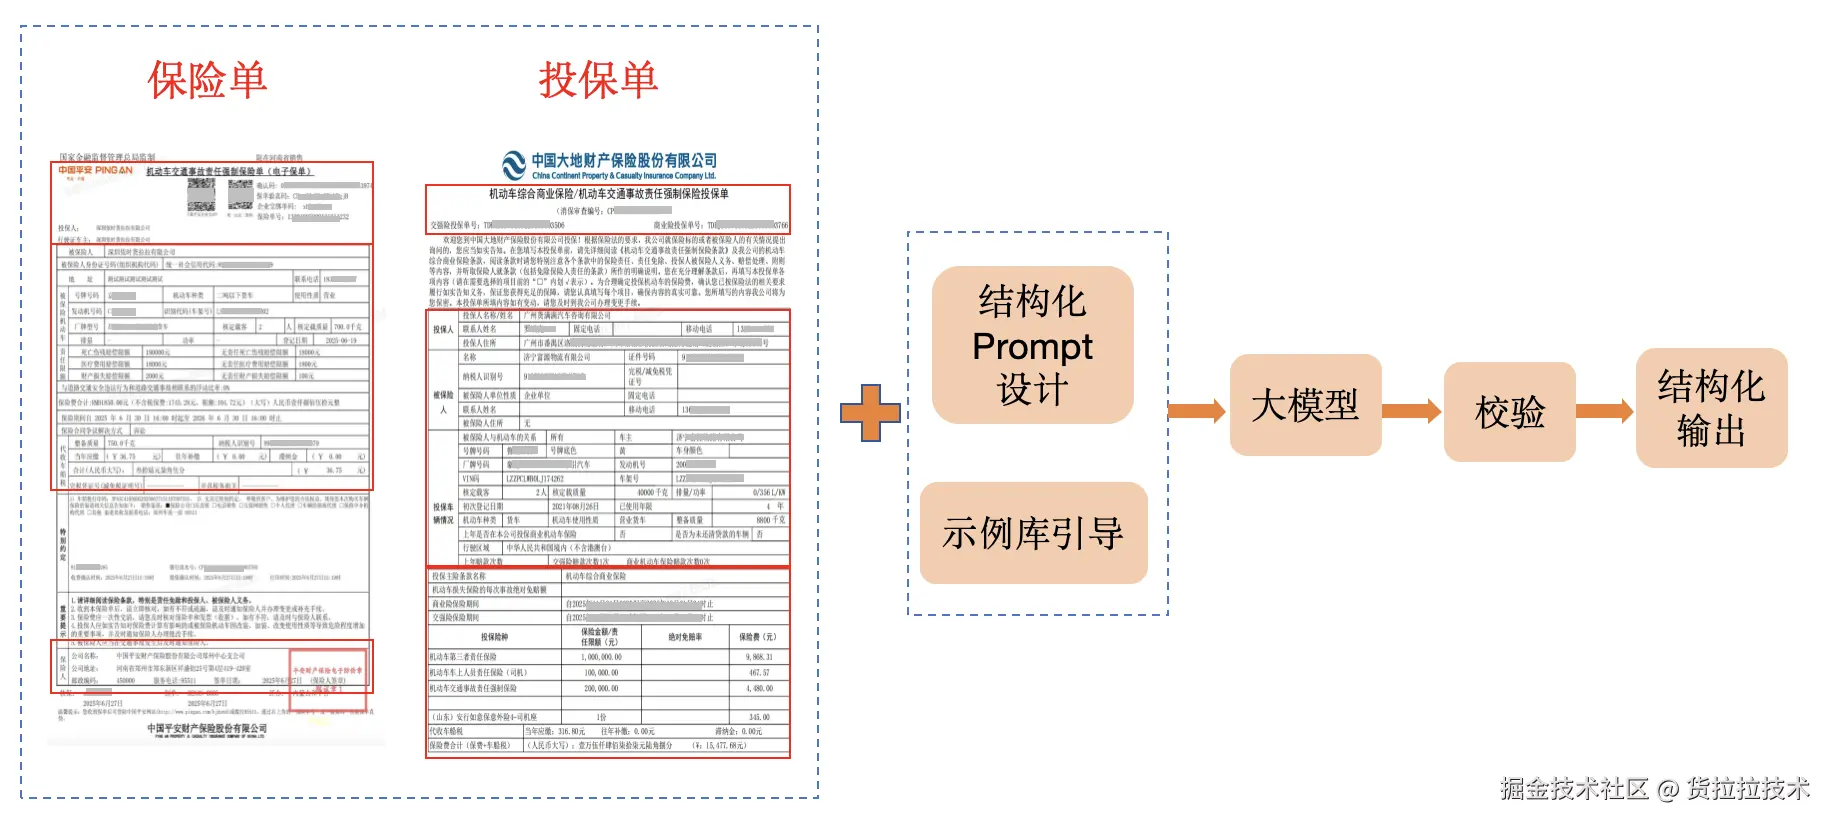
落地场景:保险单&投保单关键字段识别
传统OCR方案要应对不同保险公司、不同版式的保单,需要持续投入适配和维护工作。引入多模态大模型后,新接入一种版式不再需要大量的适配工作。
不过,通用大模型直接用在生产场景,还需要做一些工程化的优化,比如结构化Prompt设计、示例库引导、输出后校验等,确保输出稳定可靠。
流程图
3.3 混合架构:分层调度的视觉服务体系
基于这些实践,我们逐渐搭出了一套分层的视觉服务体系。从下往上看,是算法能力支撑业务的完整链路。
架构图
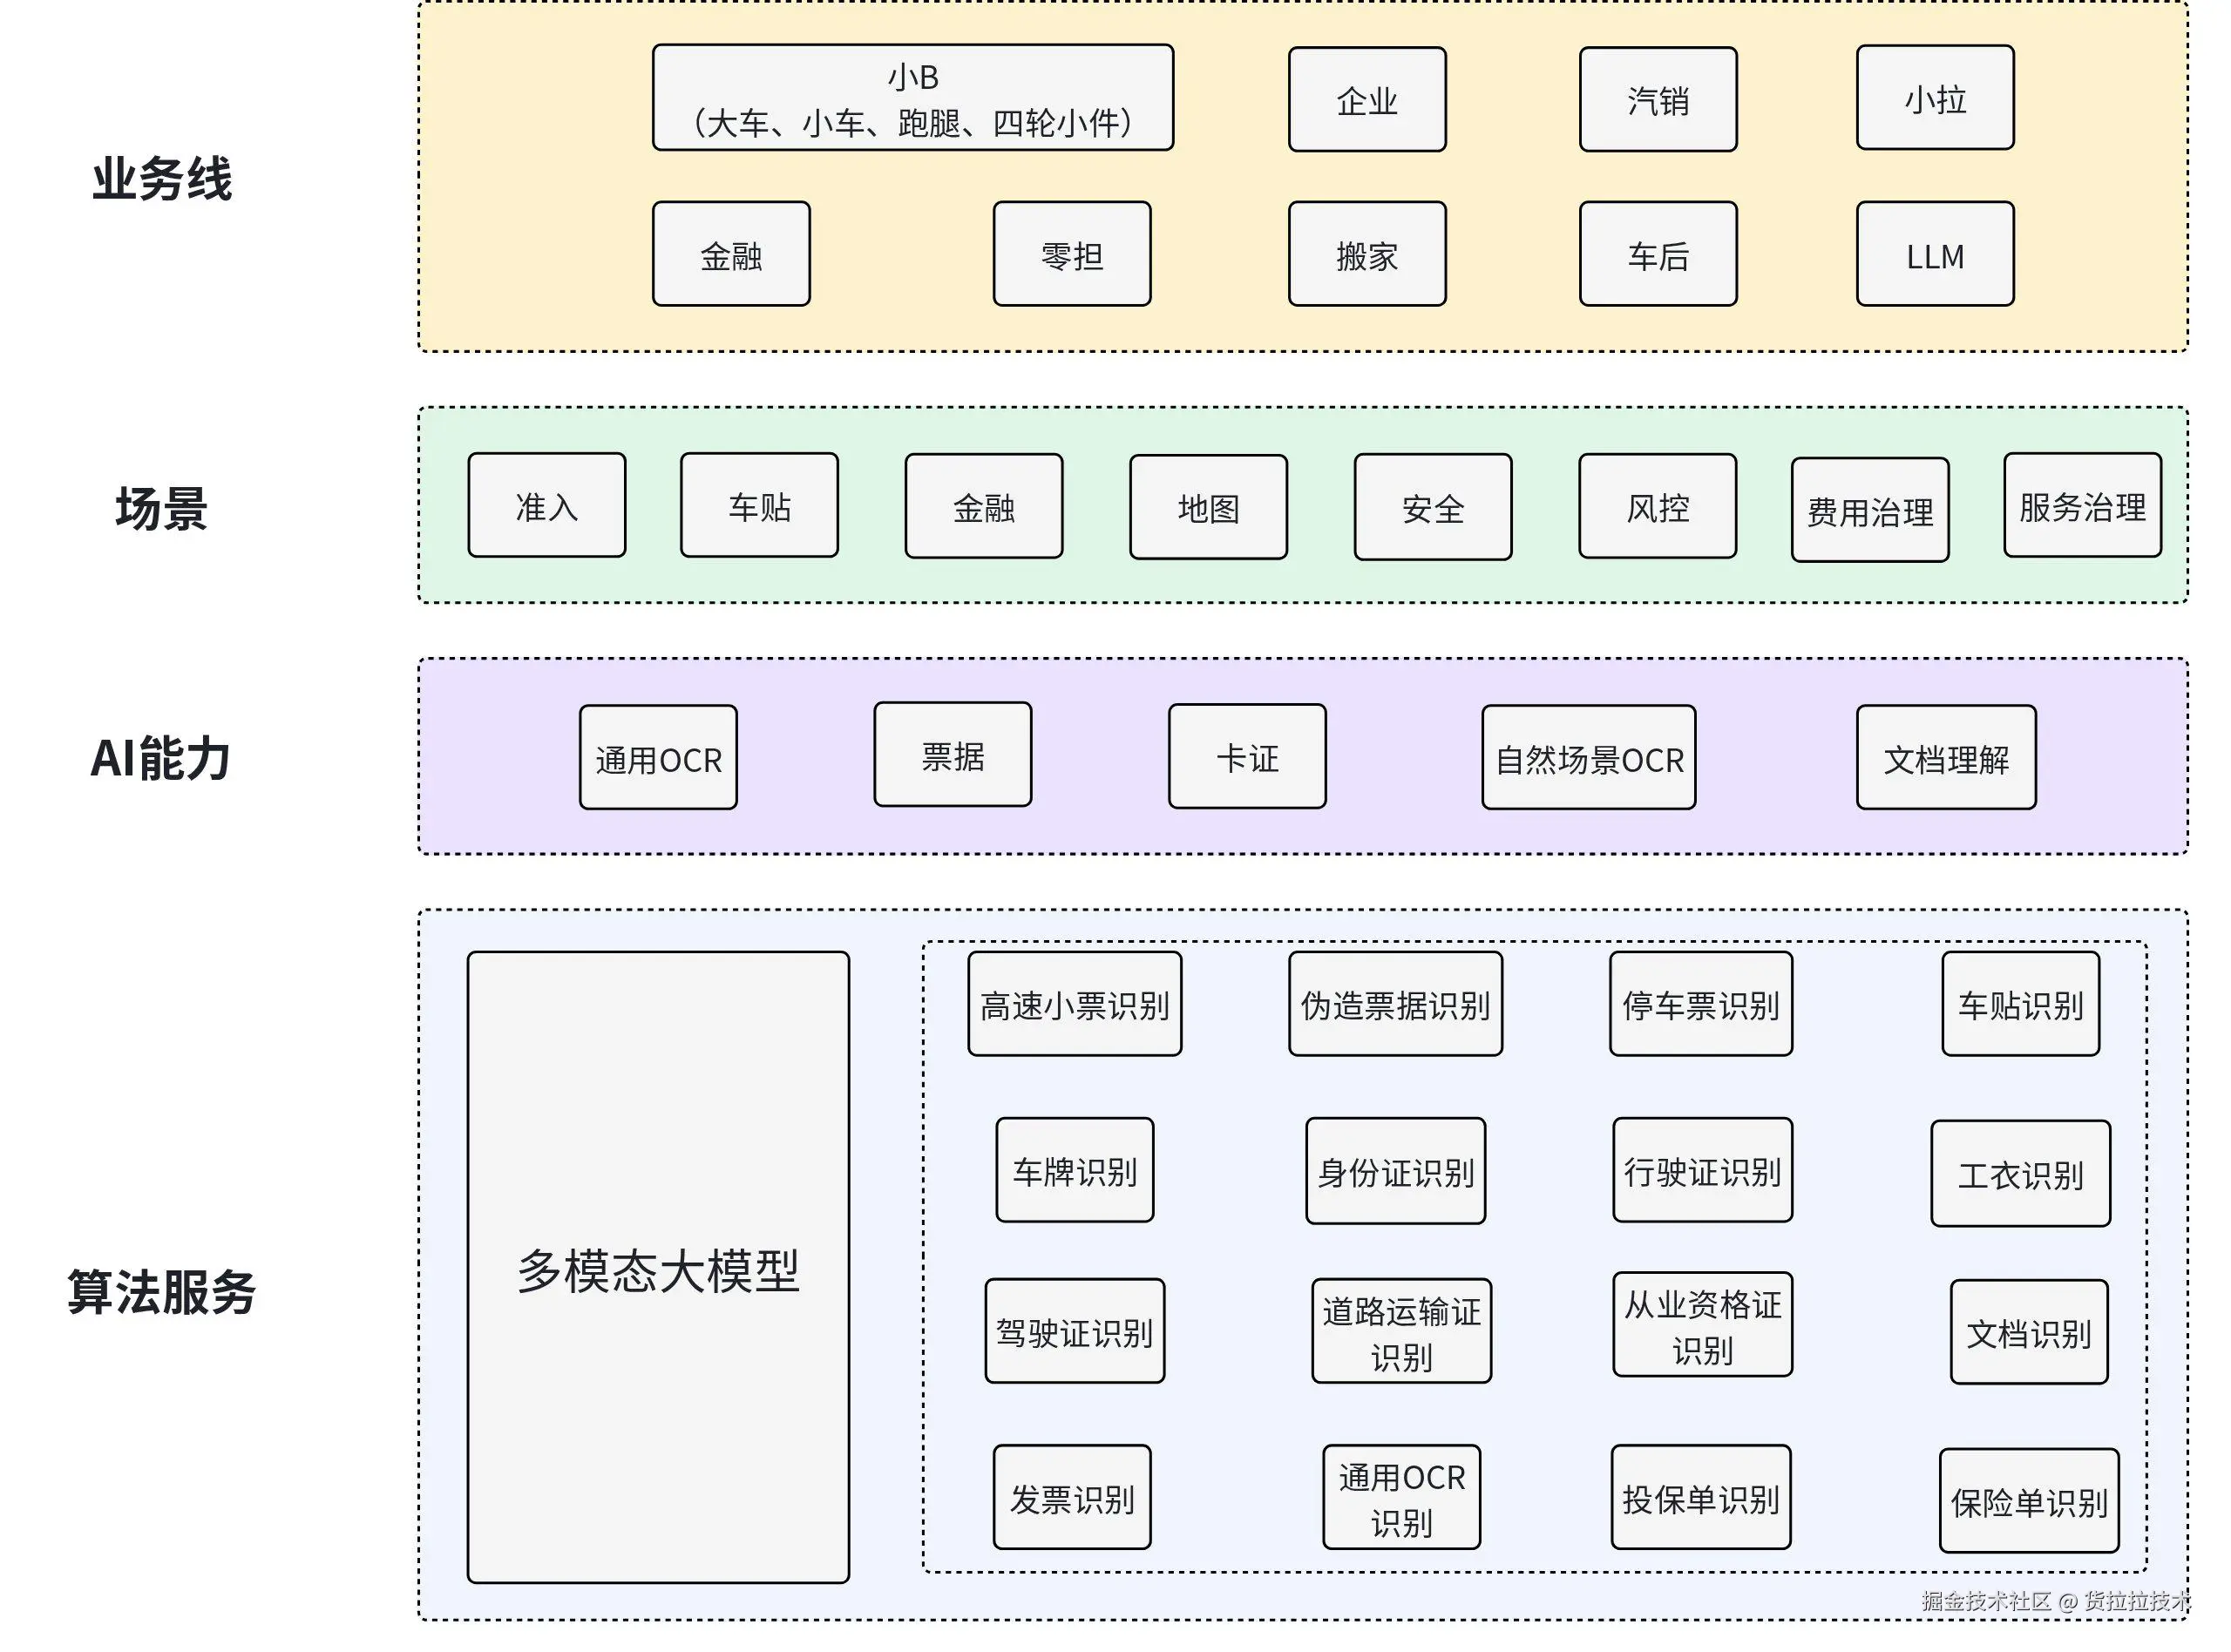
最底层是算法服务层 ------视觉能力的底座。左边是多模态大模型,作为通用能力支撑各类复杂文档和开放场景的理解;右边是各种专门化的传统视觉算法,针对高速票、停车票、车牌、各类证件、车贴等具体场景做了深度优化。
往上是AI能力层,把底层算法封装成业务可直接调用的原子能力大类:通用OCR、票据识别、卡证识别、自然场景识别、文档理解。
再往上是场景层,把这些原子能力组合起来,支撑具体的业务场景:司机准入、车贴核验、金融审核、地图地址识别、行程安全、风控反欺诈、费用治理、服务质量治理。
最上面是业务线,最终服务于小B(大车、小车、跑腿、四轮小件)、企业、汽销、小拉、金融、零担、搬家、车后等各个业务条线。
这套体系的特点是:大模型和传统专门化模型各展所长。通用、复杂的场景用大模型,接入快、泛化好;高频、要求极致性能和成本的场景用专门化小模型,快、稳。不是谁替代谁,而是在一个统一的视觉底座上互相补充,一起支撑上层的丰富业务场景。
四、从"看见"到"看懂"------视觉感知的业务闭环
前面讲的都是视觉感知"能做什么",但它真正的价值,不只是把图片里的文字"读"出来,而是要成为业务系统自动化决策的关键输入------从"看见"图片,到"看懂"业务。不管是传统业务的自动化流程,还是未来Agent在更多场景的落地,这个视觉底座都是不可或缺的基础能力。
举个完整的例子:司机准入环节,上传材料。
照片进来之后,视觉感知层做了几件事:
- 质量检测------照片清不清楚?有没有拍全?
- 多维度识别------OCR识别和理解材料上的文字(姓名等)、印章文字、二维码内容;
- 结构化理解------把识别出来的信息整理成统一的字段,交给规则引擎做校验:姓名对不对?公章属地是否匹配?二维码是否正常?
这些结构化信息传上去之后,系统就能自动判断这些材料是否有问题,要不要重新上传或者转人工复核。
视觉感知不是终点,是自动化决策的起点。未来,我们还会把视觉数据回流起来------AI判错了哪些case?人工审核纠正了什么?这些badcase再反哺回来,优化视觉感知模型,让"眼睛"越来越准。
眼睛越准,系统的决策就越靠谱。这就是视觉感知和业务决策之间的正向循环。
写在最后
从最早的OCR文字识别,到现在多模态大模型与传统模型混合调度的视觉服务体系,货拉拉的视觉感知能力一直在进化。传统模型守着基本盘------高频、结构化的场景,快、稳;大模型开着新边界------复杂、多变的场景。从传统CV到多模态大模型,视觉能力在持续进阶。