装软件这件事我基本闭眼能装,脑子里有模板。
但 AI 这套工具,坑是新的。
卡在这一步的人,开口通常是这么一句:
"柯柯,Ollama 我装好了,但模型拉不动。"
这句话里其实藏了两种完全不同的病,修法也完全不一样。先对号入座,别急着折腾。
第一步:分清你是哪一种"拉不动"
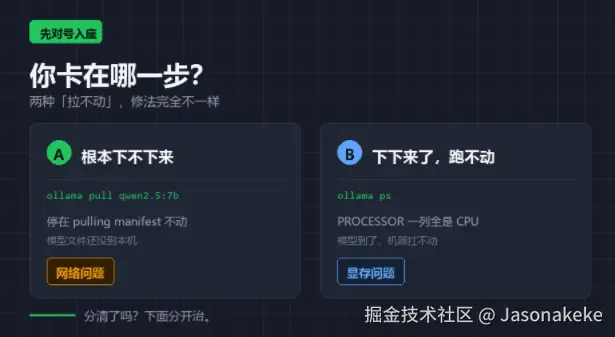
A 型:根本下不下来
ollama pull qwen2.5:7b屏幕上停在 pulling manifest 不动,或者进度条走得像蜗牛,最后甩一句 Error: max retries exceeded。
这是网络问题,模型文件还没到你电脑上。
B 型:下下来了,但跑不动
ollama list 里能看到模型,可一 run 就崩,或者回一句话要等半分钟、风扇狂转。
这是显存问题,模型在,但你的电脑扛不动。
分清楚了吗?下面分开治。
A 型:卡在 pulling manifest
Ollama 的模型默认从 registry.ollama.ai 拉,这个地址在国内直连经常不稳。不是你网络坏了,是这条路本来就不顺。
修法一:换国内模型站(最直接)
ModelScope(modelscope.cn,阿里的模型站)上有大量 GGUF 格式的模型,国内下载快得多。
拿到 .gguf 文件之后,用 Ollama 导入,全程不经过官方 registry:
- 新建一个没有后缀 的文本文件,名字就叫
Modelfile - 里面写一行:
bash
FROM ./qwen2.5-7b-instruct-q4_k_m.gguf- 在同一个目录下打开命令行,执行:
lua
ollama create qwen-local -f Modelfile- 然后就能跑了:
arduino
ollama run qwen-localqwen-local 这个名字你可以随便起。这样模型就进了你本地的库,以后不用再下载。
修法二:先拿小模型把链路试通
别一上来就拉 7B、14B。先来个 1.5B 的,不到 1 GB,一会儿就下完。
ollama pull qwen2.5:1.5b能拉通,说明网络和 Ollama 本身没问题,再去下大的。卡住的原因常常是文件太大加上网速太慢,不是环境坏了。
B 型:模型在,但跑不动
先别猜,两条命令就能看出来。
看它到底跑在哪
ollama ps盯 PROCESSOR 那一列:
| 显示 | 含义 | 状态 |
|---|---|---|
| 100% GPU | 全在显卡上 | 正常,这就是你要的 |
| 大部分 GPU + 一点 CPU | 显存塞不下,溢出到内存 | 速度会掉一半以上 |
| 100% CPU | 完全没吃到显卡 | 慢,但如果能忍,也能用 |
看它到底多快
arduino
ollama run qwen2.5:7b --verbose回答完会打出一段统计,找 eval rate 那一行,单位是 token/s。
参考值(看机器,不是绝对) :40 以上很流畅,15 左右能正常聊,10 以下基本没法用,个位数就是幻灯片。
你的显存到底够不够
4bit 量化下,大致是这么个账(估算值,以 ollama ps 实测为准):
| 模型规模 | 大概需要显存 | 常见型号 |
|---|---|---|
| 1B--3B | 1--2.5 GB | qwen2.5:1.5b、llama3.2:3b |
| 7B--8B | 5--6 GB | qwen2.5:7b、llama3.1:8b |
| 14B | 9--10 GB | qwen2.5:14b |
| 32B | 19--21 GB | qwen2.5:32b |
| 70B | 40 GB 以上 | 家用基本别想 |
注意,这只是模型本身的重量。 对话越长,上下文还要再吃 1--2 GB。所以 8G 显存跑 7B 是紧的,16G 跑 14B 才舒服。看到"8G 显卡能跑 7B"的说法,别全信,跑是能跑,但稍微聊长一点就溢出去了。
三种救法
- 换小的(最有效) 。14B 卡就换 7B,7B 卡就换 3B。3B 的模型回答质量已经能应付大部分日常问答了,别迷信大。
- 别开长上下文。默认 2048 够用,硬拉到 32K,显存直接爆。
- 接受 CPU 跑。7B 在普通 8 核 CPU 上大概 5--8 token/s,慢,但适合不赶时间的活,比如批量处理文档、夜里挂着跑。
顺手三个更常见的坑
这三个不属于"拉不动",但同样常见:
1. 'ollama' 不是内部或外部命令 装完没重开终端。关掉所有命令行窗口重开,或者直接重启电脑。
2. connection refused 服务没起来。看右下角托盘有没有 Ollama 图标,没有就手动启动一次。
3. 端口被占用
netstat -ano | findstr 1143411434 是 Ollama 的默认端口,被别的程序占了就起不来。
最后:怎么算真的通了
arduino
ollama run qwen2.5:1.5b出现 >>> 提示符,输入"你好",它回你一段通顺的话 ------ 这就成了。
别急着下 70B。 先用小模型把整条链路走通一遍,知道每一步长什么样,再去试大的。这跟你装 Python 先跑个 print("hello") 是一个道理。
第一步就想跑最大的模型,卡住之后很容易得出「我这台不行」的结论。
其实只是顺序错了。
Ollama 请从 ollama.com 下载,模型优先用官方源或 modelscope.cn,别用来路不明的整合包。