用多个 Agent 写代码和跑数据时,我关心一个具体问题:换了工具,前面定好的规则和做完的文件能不能接着用?
在另一个工具里新开对话,通常还需要重新交代业务规则、字段口径和目录路径。按步骤选择不同底座或许能减少不必要的推演,但交接本身也要花时间,费用是否更低则需要另算。
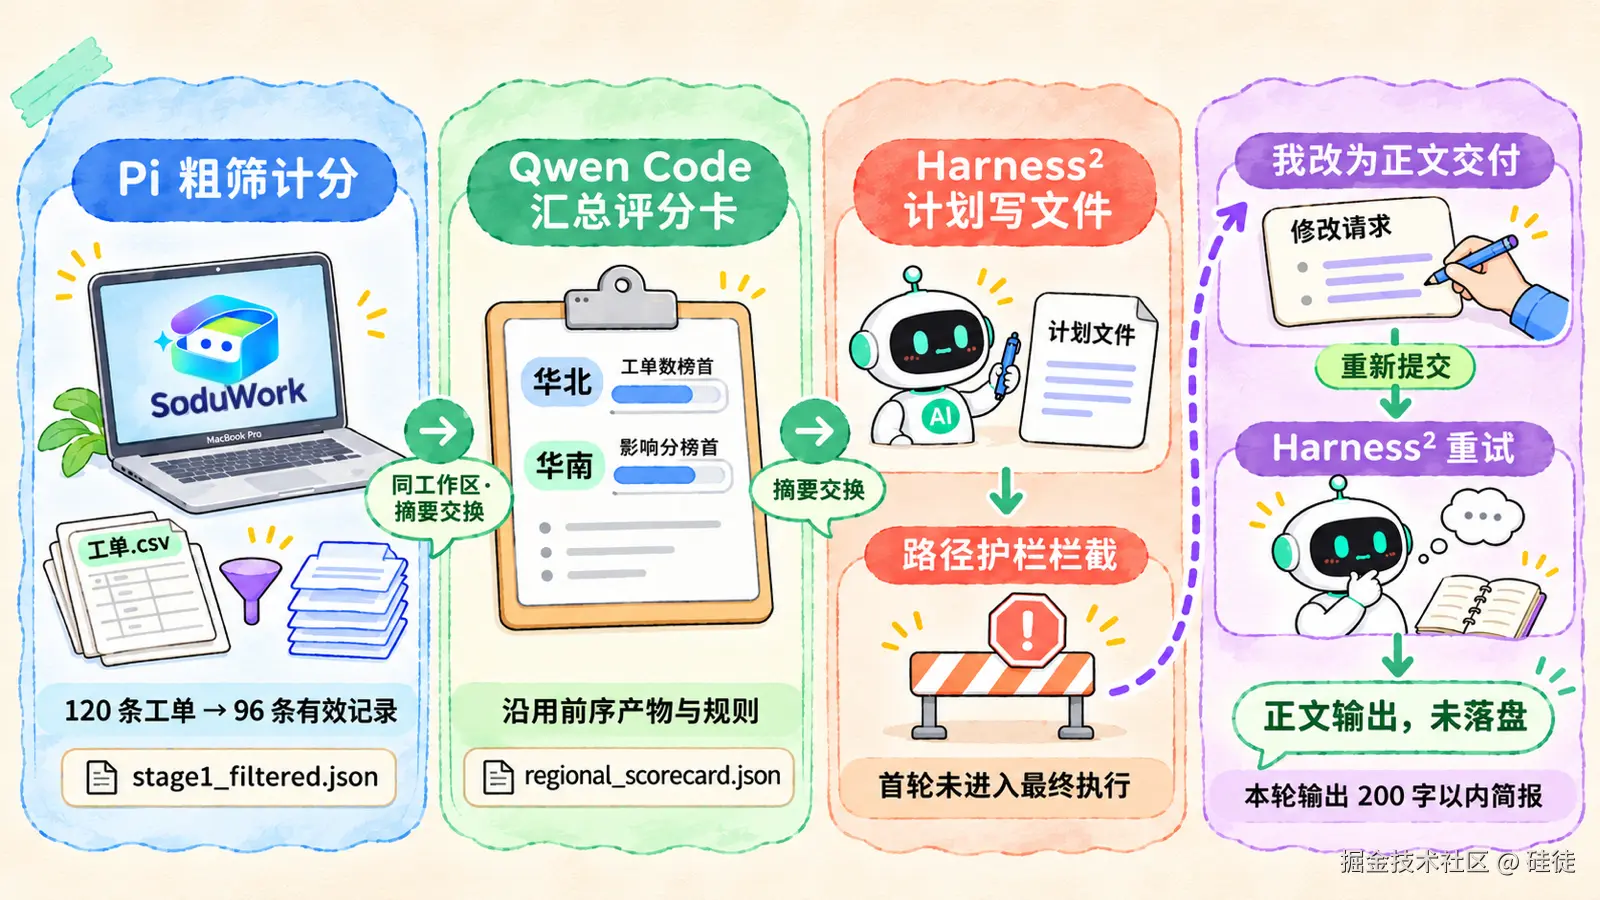
开源的企业级 AI 原生引擎 SoduWork 把多个 AI 底座放进同一个界面,支持在本轮任务结束、满足切换条件后,在同一条对话里换底座。
我在 MacBook Pro 上接通了 Pi 1.4.0、 Qwen Code 0.21.8、 Google Harness² 0.2.0 ,拿一份 120 条云网关故障工单做了一轮"单会话三棒接力",再查底层的对话 .jsonl 与 SQLite 用量表,核对交接结果和开销。
这轮接力始终使用同一条会话(01a1d12b-7ee4-71b4-9ea5-3e5667a1c7c4):Pi 先清洗并留下 R1~R4,Qwen Code 继续做区域评分卡,Google Harness² 最后尝试生成止血简报。中途的排队和失败重试也一并记在下面。
验证范围:这是本次短会话的结果,尚不能代表长历史交接也能保留全部细节。
实验设定|三个底座,共用一个模型
先直观认识一下 SoduWork 的整体定位------作为开源的企业级 AI 原生引擎,它把统一桌面入口放在前端,背后串起企业已有工作和不同模型、技能底座,方便按步骤让合适的 AI 参与进来:
图 1|SoduWork 产品概览:桌面端统一工作入口与多模型、技能分步调用示意
本次测试全部跑在本机自托管环境,三个 底座(Harness) 都使用 DeepSeek 官方 API 的 deepseek-chat。统一模型减少了一项变量,但三棒承担不同任务,因此这里主要观察接力能力和各步开销,没有做底座性能排名或跨模型供应商容灾测试。
- **设备与系统:**MacBook Pro (M1 Max 10 核 / 64 GB 内存) · macOS 27.2.1
- 源码版本:
https://github.com/mdiri-ai/SoduWork· Commit25bae6a64e69a6262344f7f500cfcd0f6483b2e0 - **已启用模型:**DeepSeek 官方 API:
deepseek-chat(日常/快速)+deepseek-reasoner(深度推理) - 实测底座 1:****
Pi 1.4.0(桌面端原生底座,tool-hook权限控制) - 实测底座 2:****
Qwen Code 0.21.8(经本机 Runner 以 ACP 协议接入的编码底座,在所选目录与权限模式下执行) - 实测底座 3:****
Google Harness² 0.2.0(每轮先跑 Google Research 七阶段文本推演、再调独立执行器的重型底座)
运行副本有临时改动 :首次切换遇到排队阻塞后,我在
claim_next加了零并发放行判断并重启 Runner。后面的Qwen Code与Google Harness²接力结果来自这个临时修补过的副本,不能视为上述 Commit 原样运行的结果。排队的触发条件与临时修补过程,放在第一次切换的记录里。
在桌面端「Agent 管理」页面点一轮批量探测,三个底座全部亮起绿标 测通了,右侧抽屉能直接看到 CLI 路径、版本号与探测回执(总共可纳管 9 种主流底座):
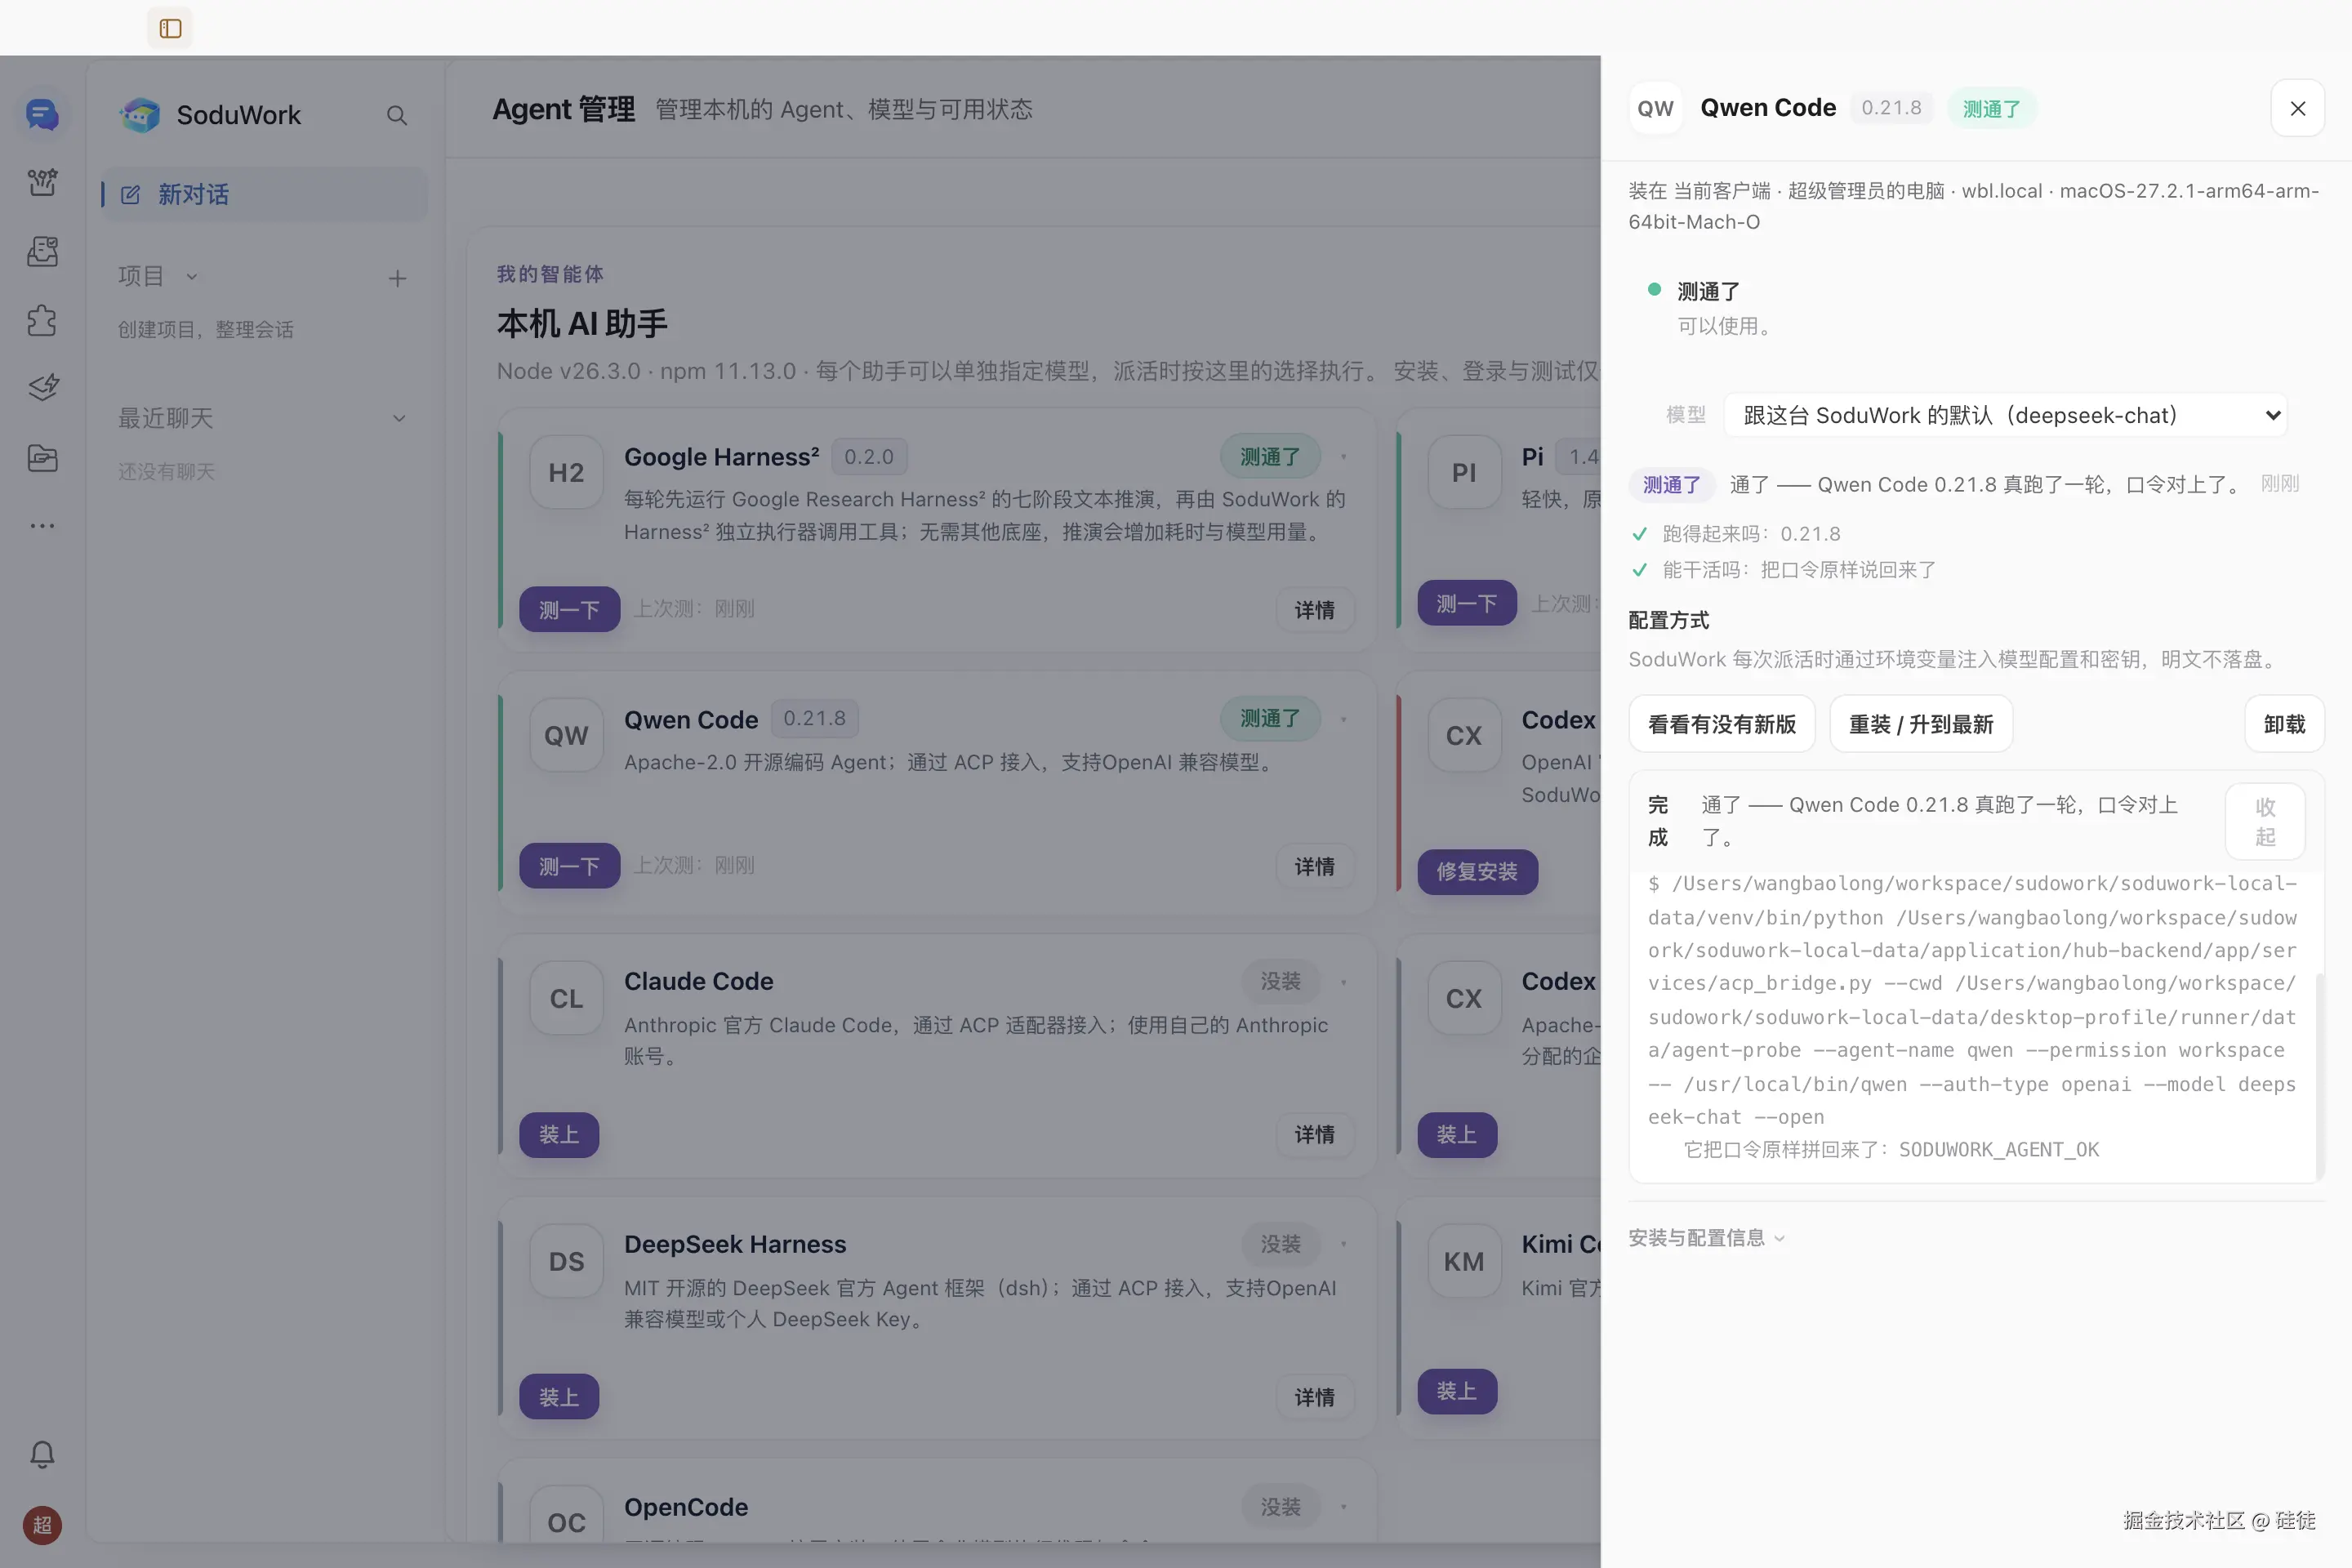
图 2|桌面端探测通过 Google Harness²、Pi 与 Qwen Code 三个底座
输入文件与刻意安排的数据分布
为了试探切换底座时会不会丢掉前面定好的规矩,我在工作目录 exp-c-ops-triage 里生成了一份含 120 条跨区域云网关告警记录的 cloud_incident_tickets_q4.csv 和一份割接排期表 change_freeze_windows.json。
我在数据里故意埋了一个反直觉分布:华北区(cn-north)工单数量最多(52 条),但都是边缘轻微抖动;华南区(cn-south)只有 24 条工单,却全是连接池耗尽与 Redis 脑裂重症,累计影响分高达 2016.61。
01|Pi:把 120 条工单筛到 96 条
第一轮我选用 Pi 底座启动会话,让它做首轮 CSV 清洗并落盘 stage1_filtered.json,同时在首句指令里一次性写清后面要守的 4 条规则,后续不再重新粘贴公式和阈值:
- R1(割接窗豁免) :工单
hour_utc8落在对应区域[start_hour, end_hour)左闭右开割接窗口内的,标为PLANNED_MAINT剔除; - R2(影响分公式) :
impact_score = round(affected_tenants * 2.5 + p99_latency_sec * 1.2 + error_rate_pct * 3.0, 2); - R3(双口径榜首并列):汇报榜首区域时,必须同时并列给出「按有效工单数第一」和「按累计 impact_score 第一」两个口径,不能只报单一口径;
- R4(三级挂牌阈值) :累计分
>= 450挂RED_FREEZE,[250, 450)挂AMBER_WATCH,< 250挂GREEN_NORMAL。
Pi 用了 8.59s 写完过滤脚本并复核结束:剔除 24 条割接窗工单(华东 14 条、新加坡 10 条),剩余 96 条有效工单落盘为 stage1_filtered.json,score_mismatch=0。
02|第一次切换,先堵在了队列里
第一次在会话里从 Pi 切到 Qwen Code 发消息时,Pi 明明 10 秒就跑完了,Qwen Code 却一直卡在 排队中 · 前面 1 项 动弹不得。我用 ps 查了一圈,本机当时明明没有跑任何 Agent 子进程。
我从 runner-adapter.js 追到调度器 runner_admission.py(完整路径 hub-backend/app/services/runner_admission.py),发现是两段逻辑撞在了一起:
macOS 无 /proc/stat 时用负载换算 CPU 百分比(第 157 行)
_ProcSampler 在 Linux 上通过 /proc/stat 算实际 CPU 利用率,到了 macOS(Darwin)没有这个文件,就退回 os.getloadavg()[0] * 100.0 / cpu_count 来估。这个换算值不能直接视为实测 CPU 利用率。
我这台 10 核 M1 Max 当时开着 IDE 和浏览器,loadavg 显示 20.59,虽然观察到的 CPU 占用不高,换算值仍被封顶为 cpuPercent = 100.0% >= 95.0%,触发第 212 行把 can_start 置为 False。
零并发没兜底 + 序号从 1 开始(第 337 & 366 行)
claim_next() 第 366 行判定 if not can_start or int(active or 0) >= limit: return None------即便现在 active == 0 什么任务都没在跑,只要 can_start 为假照样不放行。
同时第 337 行 enumerate(..., 1) 返回的队首下标也是 1,前端显示成"前面 1 项",让人误以为前面卡着幽灵任务。
临时修补与后续验证
我在本地运行副本的 claim_next 里补了一条零并发放行判断(if (not can_start and int(active or 0) > 0) ...),重启 Runner 后才继续完成后两棒测试,成功执行的耗时记在后面的账表中。这是为了继续实验做的临时改动,没有验证资源紧张时强行放行的影响。正式修复还需要结合资源保护策略回归测试;Darwin 上也可以考虑用 host_processor_info 或 top -l 1 获取 CPU 采样数据。
03|Qwen Code:沿着上一棒继续算
这次切向 Qwen Code 时,我发出的指令很短,没有重贴公式和阈值:
第 2 步:请直接读取工作目录里刚生成的 stage1_filtered.json,严格按我们在上一轮约定的那 4 条规则(R1~R4),汇总生成各区域评分卡 regional_scorecard.json,并在回复中给出双口径榜首区域与各区域的挂牌等级。
排队问题处理后,成功执行这一棒用了 16.85s 。我打开工作目录里生成的 regional_scorecard.json 核对数据:
json
{
  "summary": {
    "valid_total": 96,
    "excluded_planned_maint": 24,
    "impact_score_grand_total": 3195.12,
    "score_mismatch": 0,
    "grade_counts": { "RED_FREEZE": 2, "AMBER_WATCH": 1, "GREEN_NORMAL": 1 }
  },
  "dual_leaderboard": {
    "by_valid_ticket_count": { "value": 52, "leaders": ["cn-north"] },
    "by_impact_score_total": { "value": 2016.61, "leaders": ["cn-south"] },
    "same_region": false
  }
}
本次输出符合前面 4/4 条规则 :总分为 3195.12,挂牌分布为 2 RED / 1 AMBER / 1 GREEN,回复也按 R3 同时列出了工单数榜首 cn-north(52 条)和累计影响分榜首 cn-south(2016.61)。华南的 24 条工单平均每条约 84.03 分。
4/4 的含义:R1 的过滤和 R2 的计分结果已经写入第一棒的 JSON。这支持"交接后能沿用既有规则和产物",不足以单独证明新底座重新理解并执行了全部四条规则。
桌面端的回复与双口径对比表如下:
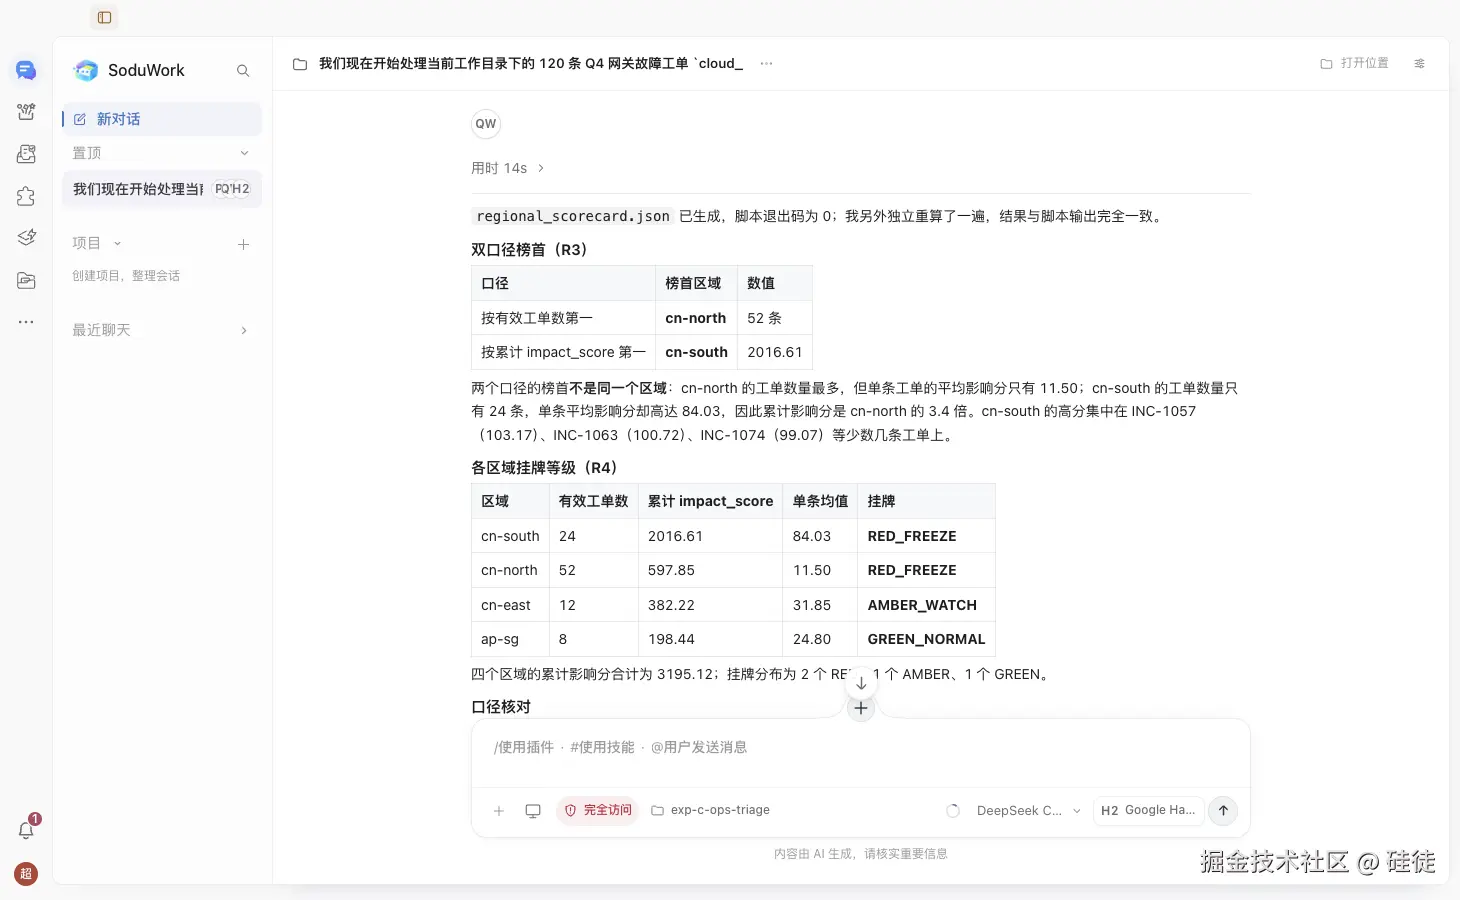
图 3|同一会话切至 Qwen Code 未重述公式即输出双口径评分卡
为什么这次能接上?交接代码做了什么
很多开发者会好奇:Pi 是内置 JS 会话,Qwen Code 和 Google Harness² 是跑在 Runner 上的独立进程,中途点一下切换按钮,怎么可能接着聊?
我读了 client/main/agent-runtime/switchable-conversation.js(第 119--204 行 selectAgent 实现)。它通过**分段会话桥接(Segmented Conversation)**完成切换:
- 保存前序底座现场 :切换发生前,先调用
raw.snapshotAsync()获取旧底座的消息流、工具调用详情(tools)与用量收据(usageReceipts)。这些历史内容保存到record.prefix,各底座的会话描述则记录在record.segments。 - 工具调用 ID 命名空间防撞 :不同底座内部可能各自从
1开始给工具调用编号。第 174 行加上前缀old.sessionId + ':' + t.id,用于区分同一聊天窗口中不同底座的历史工具卡片。 - 原地继承工作目录与自动注入交接摘要 :拉起新底座时,强制沿用同一个物理工作目录(
cwd: raw.cwd)、同一批需求绑定(raw.taskBindings)和已激活插件(activePluginIds),并调用segments.brief(before)生成结构化前序进展注入contextPrompts。
这次切换中,我没有搬动中间文件,也没有手写交接摘要。不过,保存完整历史不等于把完整历史送给新底座。
交接摘要的长度边界
client/main/conversation/runtime-segments.js 第 145--155 行的 brief 限制如下:
- **消息文本:**每条最多取 6,000 字符,拼接后保留末尾 28,000 字符
- **工具记录:**最近 12 次,每条参数最多 1,000 字符,拼接后再保留末尾 6,000 字符
较早的细节可能被截掉,源码中的交接提示也说明了这一点。
04|Harness²:计划被拦,我改了交付要求
第三步需要针对两个挂 RED_FREEZE 的重症区域做根因对比并撰写高管防雪崩决策简报,我再次在原会话切到了主打"七阶段文本推演"的 Google Harness²。
第一次我让 Harness² 分析文件并把新简报写入工作目录,它在"提出任务方法改进"推演阶段被路径护栏拦住:
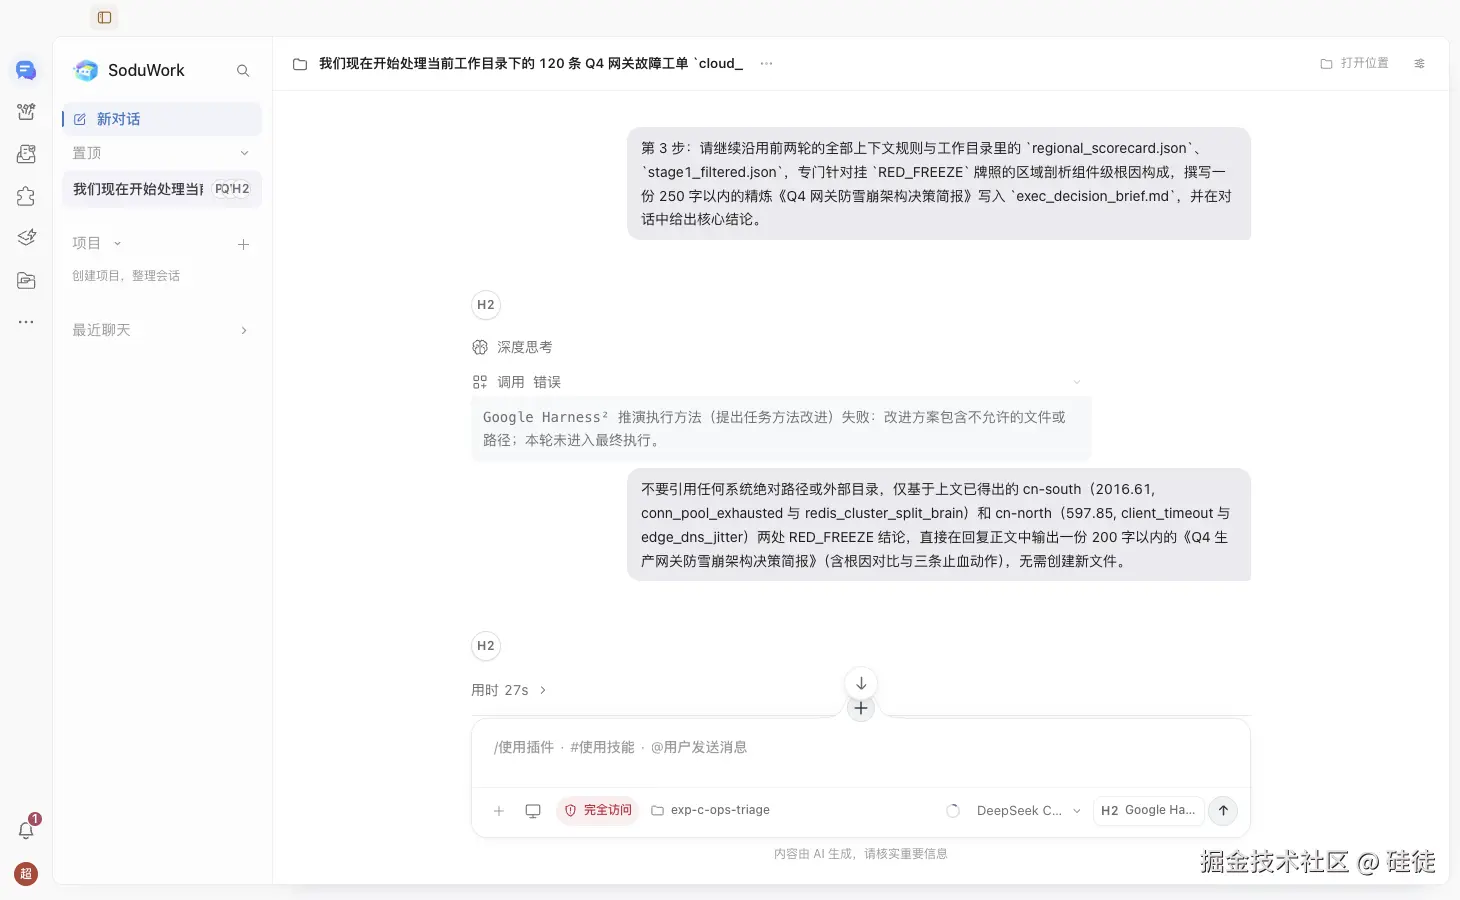
图 4|Google Harness² 七阶段推演触发路径安全护栏拦截
界面明确提示:Google Harness² 推演执行方法(提出任务方法改进)失败:改进方案包含不允许的文件或路径;本轮未进入最终执行。这是因为 Harness² 在调用独立执行器前会对推演生成的计划做严格路径白名单检查,一旦模型在推演草稿里引用了越界路径就会提前熔断。
我随即在同一会话补发了一句"不引用外部路径、直接基于上文两处 RED_FREEZE 结论在正文输出 200 字以内架构决策简报"。这次 Harness² 用时 27s 跑完七阶段推演并返回 190 字简报。
这里改了交付要求:成功的是正文输出,原先要求的简报文件落盘没有在这轮完成。
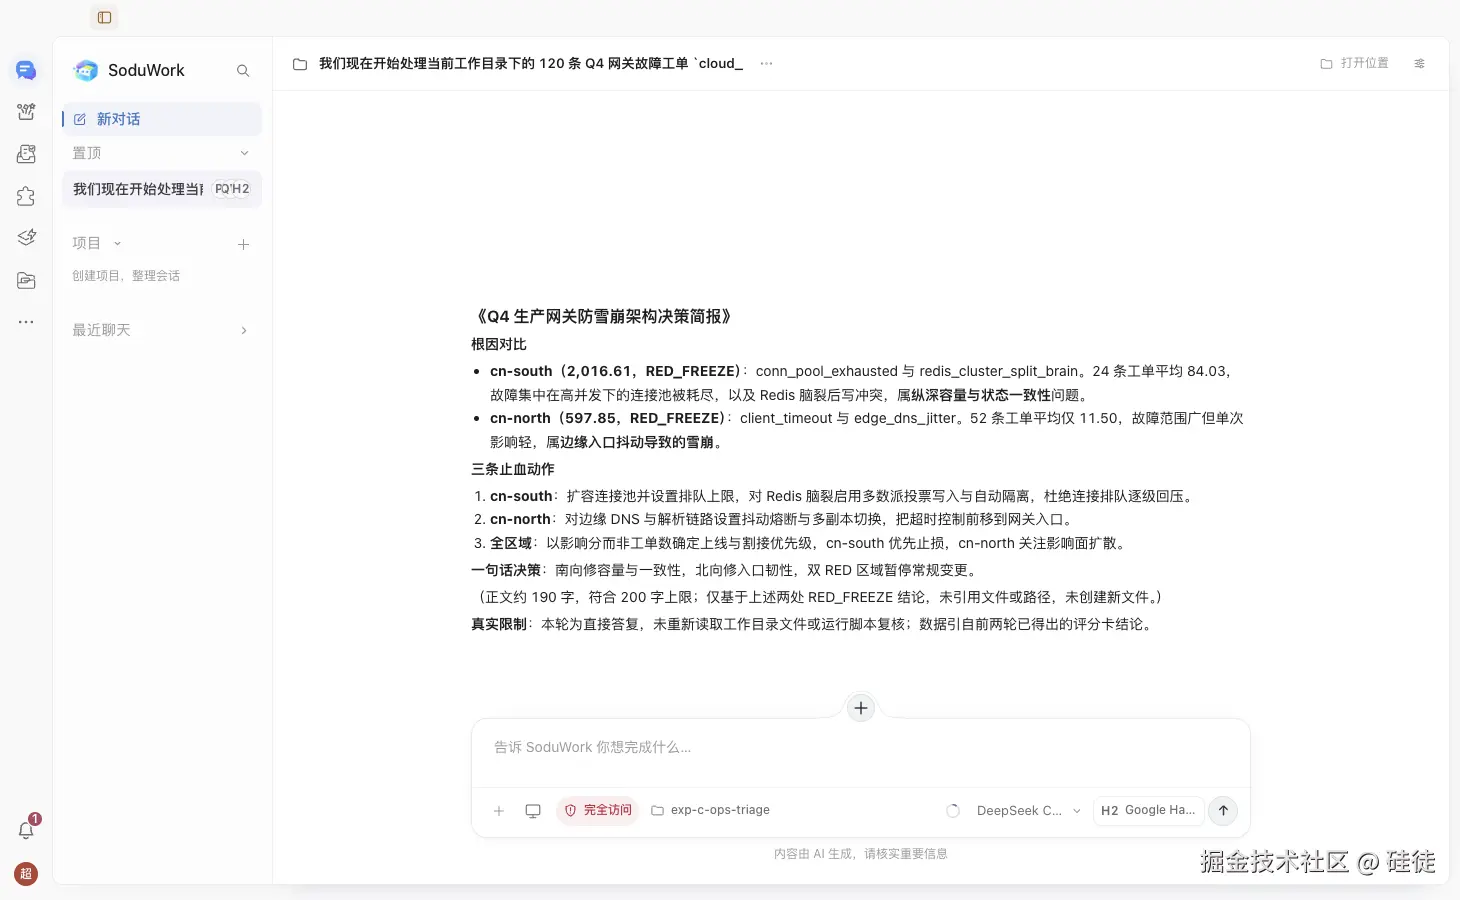
图 5|同一会话连跨 PI、QW、H2 三底座完成最终架构决策简报
截图左侧会话栏里,「我们现在开始处理当...」旁显示 PI、 QW、 H2 ** 三个底座徽章**,底部工作区仍是 exp-c-ops-triage。简报的结论是:"南向修容量与一致性,北向修入口韧性,双 RED 区域暂停常规变更。"
05|接力结束,再拆账单
接力跑完后,我查看了管理后台的「用量与成本」面板,再从本地 soduwork.db 导出 ai_usage_event 记录,配合 Pi 会话 .jsonl 以及 Runner 里的 events.jsonl 与 raw.log 交叉核对:
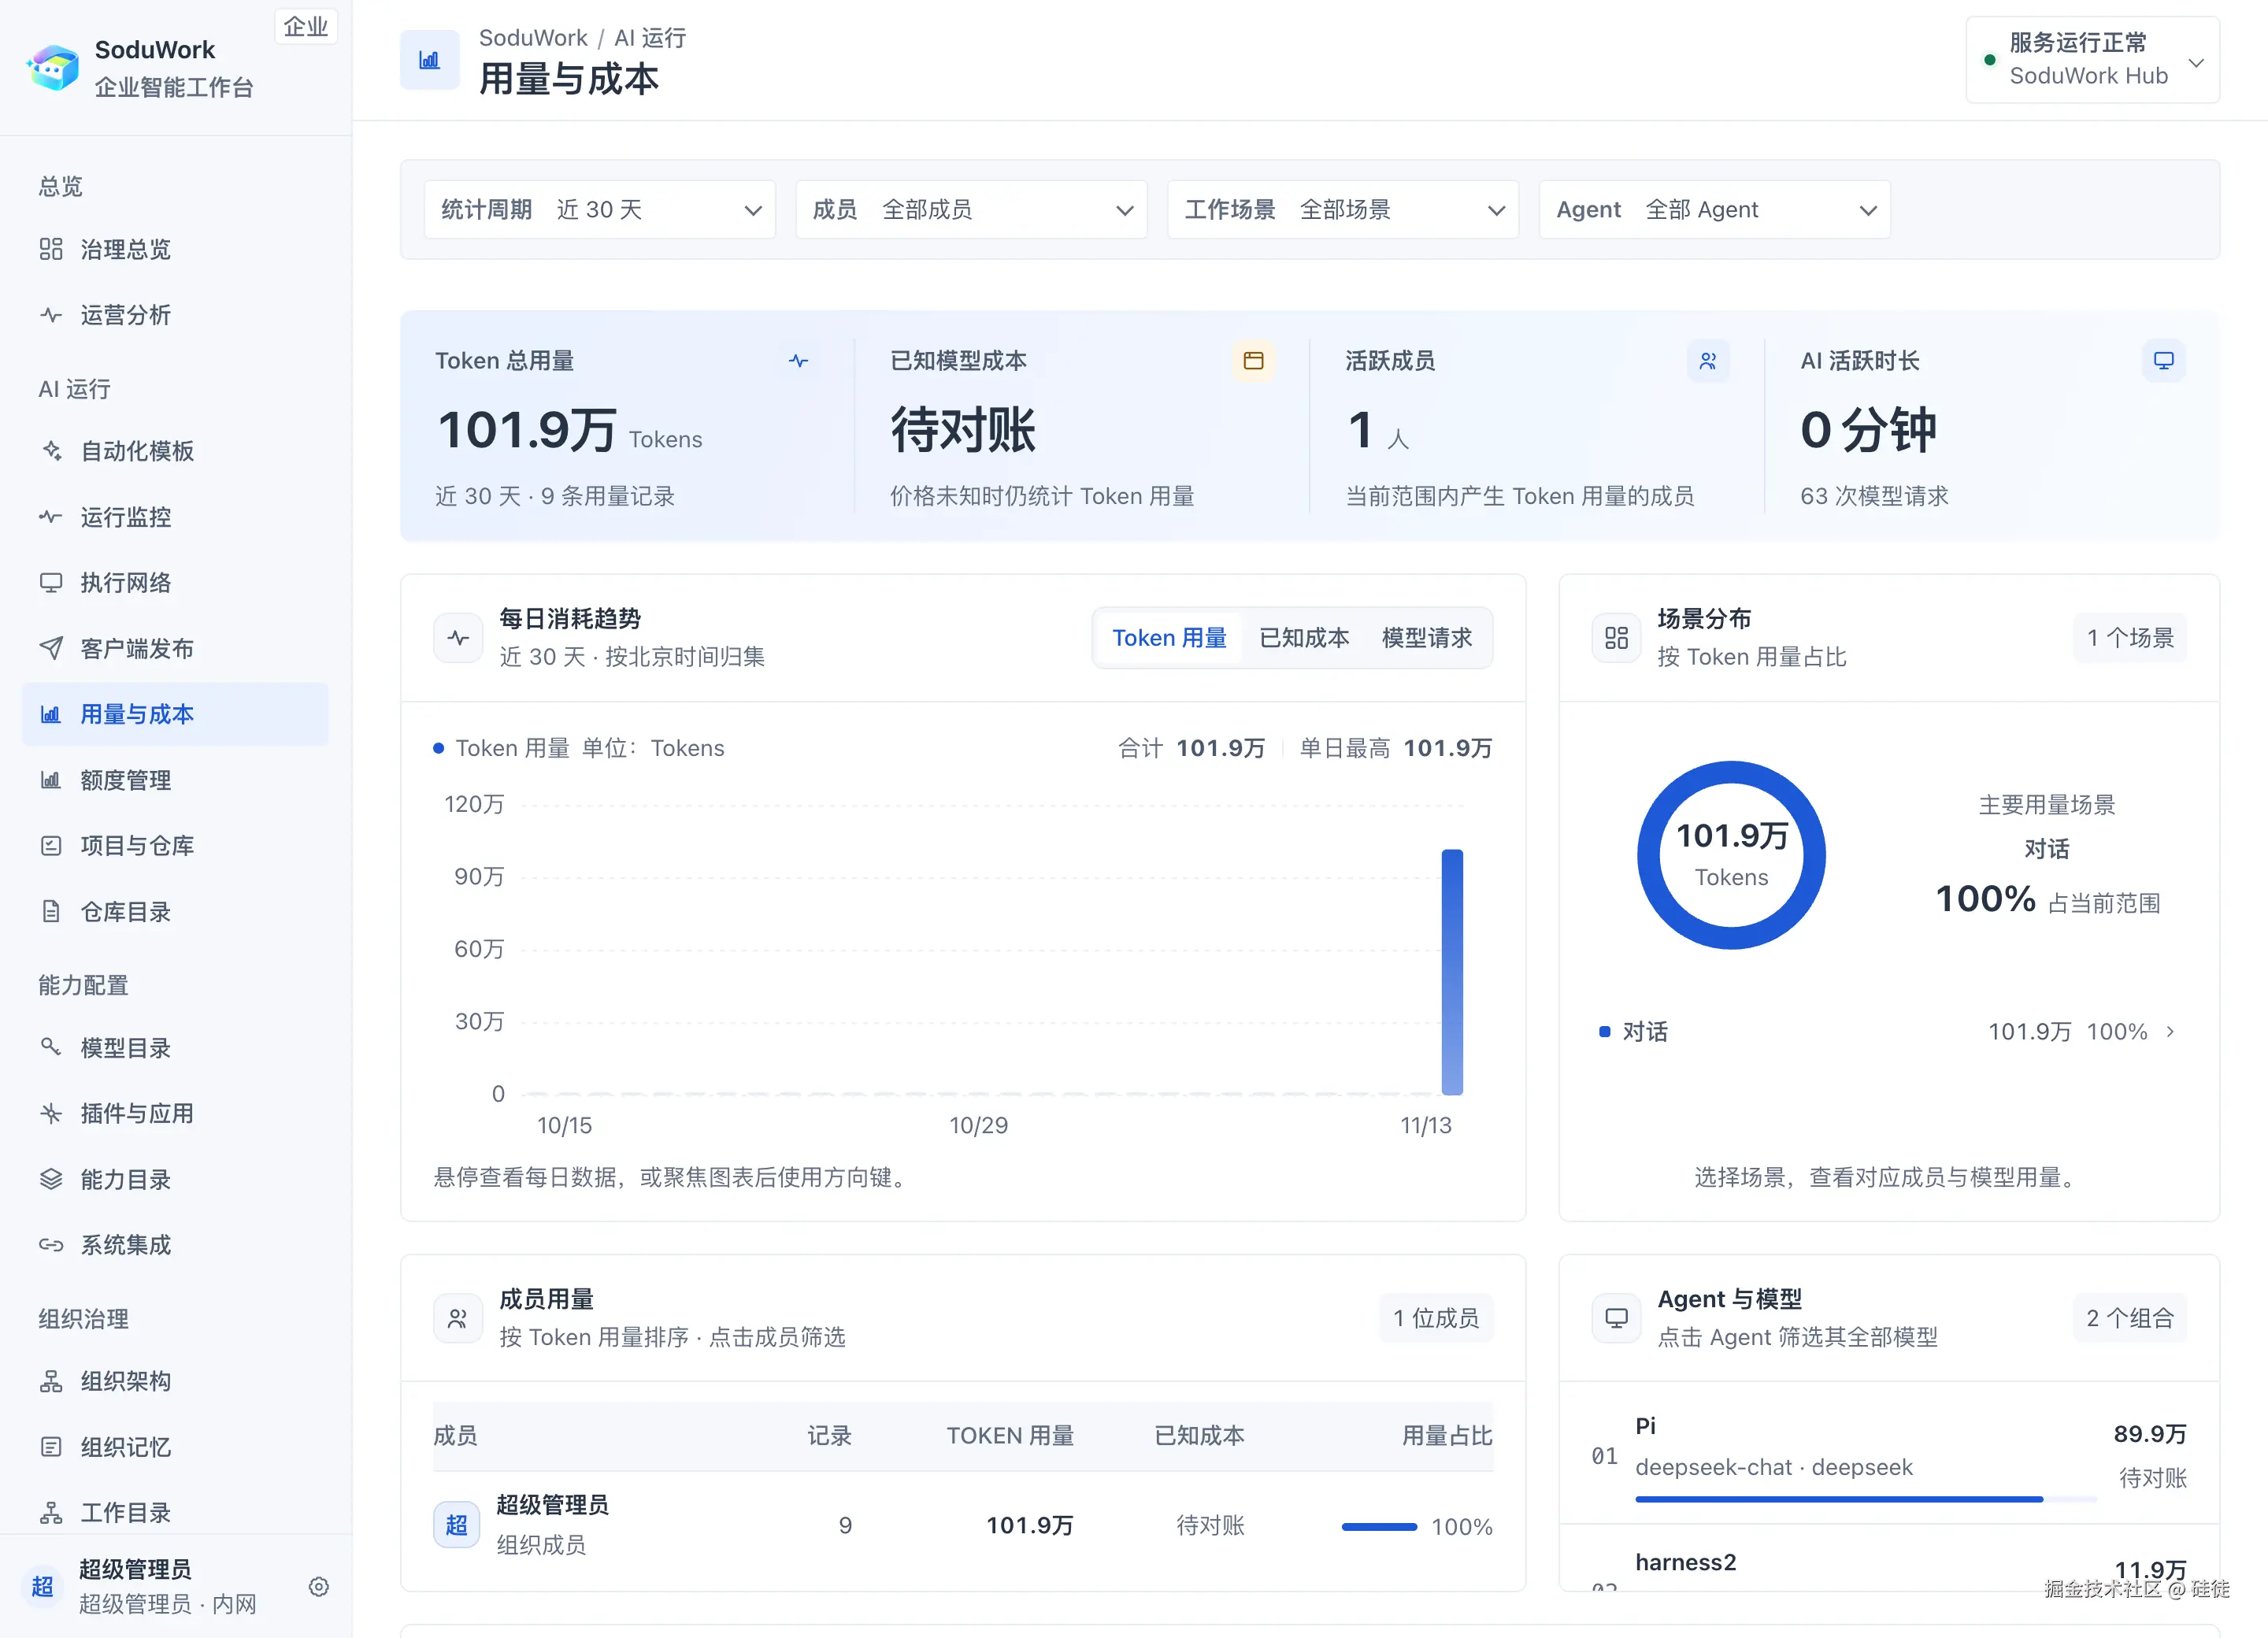
图 6|管理后台用量与成本面板显示 Pi 89.9万 与 harness2 11.9万
下面单独列出这条接力会话(01a1d12b-7ee4-71b4-9ea5-3e5667a1c7c4)的底层收据。三个底座都使用 deepseek-chat,费用沿用测试记录中的人民币费率估算:
- 缓存命中输入:
¥0.2 / 百万 Tokens; - 未命中输入:
¥2.0 / 百万 Tokens; - 输出:
¥3.0 / 百万 Tokens。
本文未附费率页面的采集日期或供应商结算账单,这些数字只表示该口径下的估算费用。
先把缺失的 Qwen 计费量留空
核对「用量与成本」截图和 soduwork.db 时,有两处数据口径需要分开看:
Qwen Code****(ACP 协议)的上下文占用不能代替计费用量
06206968-.../raw.log 中的事件是:
{"type": "step_finish", "contextOnly": true, "part": {"contextWindow": 131072, "tokens": {"input": 53016, "output": 0}}}
这里 53,016 表示已用上下文,131072 表示窗口容量,output: 0 也不能解释为本轮没有生成输出。hub-backend/app/services/acp_bridge.py 将上下文用量更新转成了这个事件,hub-backend/app/services/runtime_messages.py 则明确排除 contextOnly,避免把窗口占用当成累计消费。
此次 meta.json 的 usage 为 0,后台只显示 Pi(89.9 万)与 harness2(11.9 万)两个组合。
未知计费量不等于零消费:现有记录不足以核算 Qwen 这一棒,不能仅凭该事件断定计费 Bug。界面最好把"未获得计费用量"和"已确认用量为零"区分开,再由实际模型请求收据或供应商账单补齐。
用量记录
| 执行阶段与底座 | 模型请求数 | 输入 Tokens(含缓存命中) | 输出 Tokens | 合计 Tokens |
|---|---|---|---|---|
第 1 棒:****Pi 1.4.0(接力粗筛) |
4 次 |
69,354(缓存 52,992,76.4%) |
1,689 |
71,043 |
对照基准:****Pi 1.4.0(独立单跑粗筛) |
5 次 |
84,410(缓存 68,480,81.1%) |
1,666 |
86,076 |
第 2 棒:****Qwen Code 0.21.8 |
未拆次数 | 仅有上下文占用 53,016 (contextOnly: true),非本轮计费输入 |
账本记 0,实际值未知 |
上下文占用 53,016,非累计耗用 |
第 3 棒 首轮:****Google Harness²(护栏拦截) |
3 次 |
55,515(缓存 0,0%) |
1,849 |
57,364 |
第 3 棒 重试:****Google Harness²(7 阶段简报) |
8** 次** |
58,474(缓存 6,912,仅 11.8%) |
3,474 |
61,948 |
第 3 棒 两轮合计:****Google Harness² |
11** 次** |
113,989(缓存 6,912,6.1%) |
5,323 |
119,312 |
耗时与估算费用
| 执行阶段与底座 | 底层日志 / 事件来源 | 实测耗时 | 折算单步成本 |
|---|---|---|---|
第 1 棒:****Pi 1.4.0(接力粗筛) |
会话 .jsonl 逐条回执 |
8.59s |
**约 **¥0.048 |
对照基准:****Pi 1.4.0(独立单跑粗筛) |
soduwork.db(01a1d120) |
--- | **约 **¥0.051 |
第 2 棒:****Qwen Code 0.21.8 |
Runner raw.log step_finish |
16.85s |
无法据此估算(计量边界见本节) |
第 3 棒 首轮:****Google Harness²(护栏拦截) |
Runner events.jsonl Round 1 |
13s 熔断 |
**约 **¥0.117 |
第 3 棒 重试:****Google Harness²(7 阶段简报) |
Runner events.jsonl Round 2 |
27s |
**约 **¥0.115 |
第 3 棒 两轮合计:****Google Harness² |
events.jsonl Round 1+2 |
40s |
**约 **¥0.232 |
会话累计与底座分项需要区分
此次底层 ai_usage_event 表中,按 conversation_id 汇总的已知用量(Pi 的 71,043 + Harness² 的 119,312 = 190,355 Tokens)落在最后使用的 harness2 行上;上层概览 API 则显示 Pi 89.9 万与 harness2 11.9 万。
后者是后台概览范围的数据,不能直接当作这条接力会话的分项账单,也不能把前者全部归给 H2。两处都缺少可核算的 Qwen 用量。
另外「已知模型成本」显示"待对账";若预置参考费率,应一并标明币种、适用模型和更新时间,便于管理员核对。
这组记录给我两个提醒:
短输出也可能包含多次推演开销。 Google Harness² 第 2 轮直接总结上文、不调写文件工具,仍发了 8 ** 次模型请求**。这轮输入缓存命中率为 11.8%,低于 Pi 粗筛的 76.4%;首轮规划阶段则是 0%。
阶段提示词和前缀变化可能是原因之一,但这次没有控制缓存冷暖状态,也没有逐请求比较前缀,不能确定差异由什么造成。按表中费率,成功简报轮约是 Pi 粗筛轮的 2.4 倍,计入失败轮后约为 4.8 倍;这只是不同任务之间的费用比值。
是否省钱还缺完整对照 :这次没有让同一底座独立完成全部三步,也缺少 Qwen Code 的可计费用量,因此无法给出混合接力的总成本或节省比例。表中独立单跑的 Pi 粗筛可以作首步参考,不能替代全流程对照。
附记:官方公开对照案例(五轮对话接力记录)
官方公开对照案例中还提供了一组「物流网络关停决策」五轮评测。按案例说明,题目来自公开评测集 JobBench 管理分析师任务,采用 MIT 许可,译成中文,公司为虚构。
数据来源:以下数据引自官方公开对照案例,我没有复现这组实验;本文也没有附可独立复核的评分记录,因此将它作为补充案例,而不并入本次实测结论。
任务是从 19 个工厂里找出 3--5 个关停或合并候选并写董事会简报。前 4 轮在 Pi + GLM-5.3-Flash 上每轮定下一条硬规矩(五项评分权重、19 个工厂里 12 个零业务量工厂不直接判关停、承担 92.7% 订单的最大工厂并列写清 COO 与董事会两方观点、固定客户流失风险规则);第 5 轮在同一对话里分别切到 Qwen Code、OpenCode、Codex Harness(模型 DeepSeek-V4.1-Flash),且第 5 轮指令不再重复前面任何一条规矩。
官方案例记录的结果是:
- 三个底座在第 5 轮没有重述规则的情况下,都保留了前 4 轮的全部 4 项要求(
4/4);评测评价终稿质量与全程不换底座持平。 - 另开新对话的对照组使用了 336 字 人工交接总结,也保住了
4/4。测试组将收益概括为:"中途换底座最大的好处是不用人手写那段交接总结,而不是凭空让模型变聪明。"
下一次,我还要补什么对照
若要验证分段接力是否划算,还需让各方案处理同样的输入和交付要求,按一致的质量标准核验,并计入失败、重试及全部模型请求。
经常使用多个 CLI Agent 的开发者:同一工作区与自动交接摘要能减少切换时的手工整理。这次三个底座都接同一家模型 API,验证的是底座切换;供应商限流或断供时能否顺利迁移,还需要单独测试。
研发与技术负责人:可以用它管理多个底座,并检查已获得的用量收据。但 ACP 路径尚缺可计费用量,后台汇总与会话分项也需要对齐,现在还不能据此给出完整预算结论;SoduWork 目前处于公开测试阶段,用于生产环境前请先结合自身链路完成评估。
只用单一模型做轻量问答的人:多底座管理、接力和对账带来的收益可能有限,不一定值得增加部署与维护工作。
我准备把 macOS 队列饥饿的触发条件整理成复现说明反馈给仓库。如果你也想试同一对话切换底座,可以从源码和接入文档开始:
- GitHub 仓库 :mdiri-ai/SoduWork
- 仓库内文档目录:github.com/mdiri-ai/So...
遇到底座适配或计量问题时,建议在 Issue 或 PR 中附上版本、复现步骤和脱敏后的日志,便于定位。