今天,Google 开发者博客公布了一篇新文章,标题讲的是如何加快超大型 Git 仓库的开发速度。点进去一看,好家伙,案例就是 AOSP。
官方给出的成绩很夸张:源码准备从约 36 分钟缩短到 8 秒以内 ,一次完整构建从约 80 分钟缩短到 2 分多钟 。这些数字,编过 AOSP 的同学应该深有体会,天下苦 AOSP 编译太慢久矣!
为了解决这两个问题,他们做了 ABFS(Another Build File Service) ,并且开源了。
AOSP 这棵树有多大
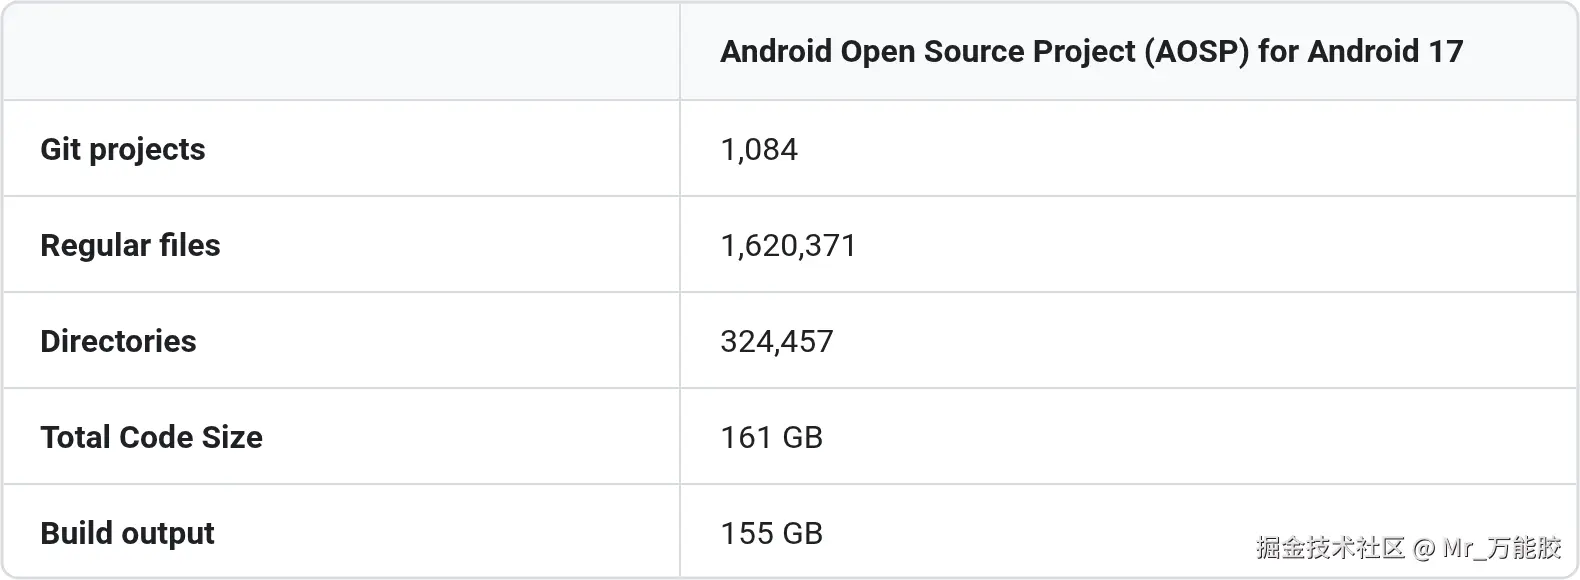
图源:Google Developers Blog。这里统计的是原生 AOSP;加上厂商代码、BSP 和自家应用,工程还会继续膨胀。
平时开发可能只改一个模块,换个分支、开个新工作目录,却仍要为整棵源码树付出准备成本。Google 统计的一个 Cuttlefish 构建图里,有 192,249 个 Ninja 构建动作 。即使修改 system/libbase 这样的基础库,约 97% 的构建图仍与 CI 已构建过的内容相同。
也就是说,我们的机器吭哧吭哧编了一个多小时,团队里可能早有另一台机器做过其中大部分工作。这部分时间能不能省下来?ABFS 的答案是:让开发机和 CI 共用同一套内容与构建缓存。
源码目录出来了,文件内容可以晚点再取
ABFS 客户端的核心是一个叫 CASFS 的虚拟文件系统。挂载工作目录时,它先取得目录结构和文件元信息。你可以看到文件名、大小,也能正常进入目录;文件内容则在工具真正读取时,才从缓存或远端取回来。
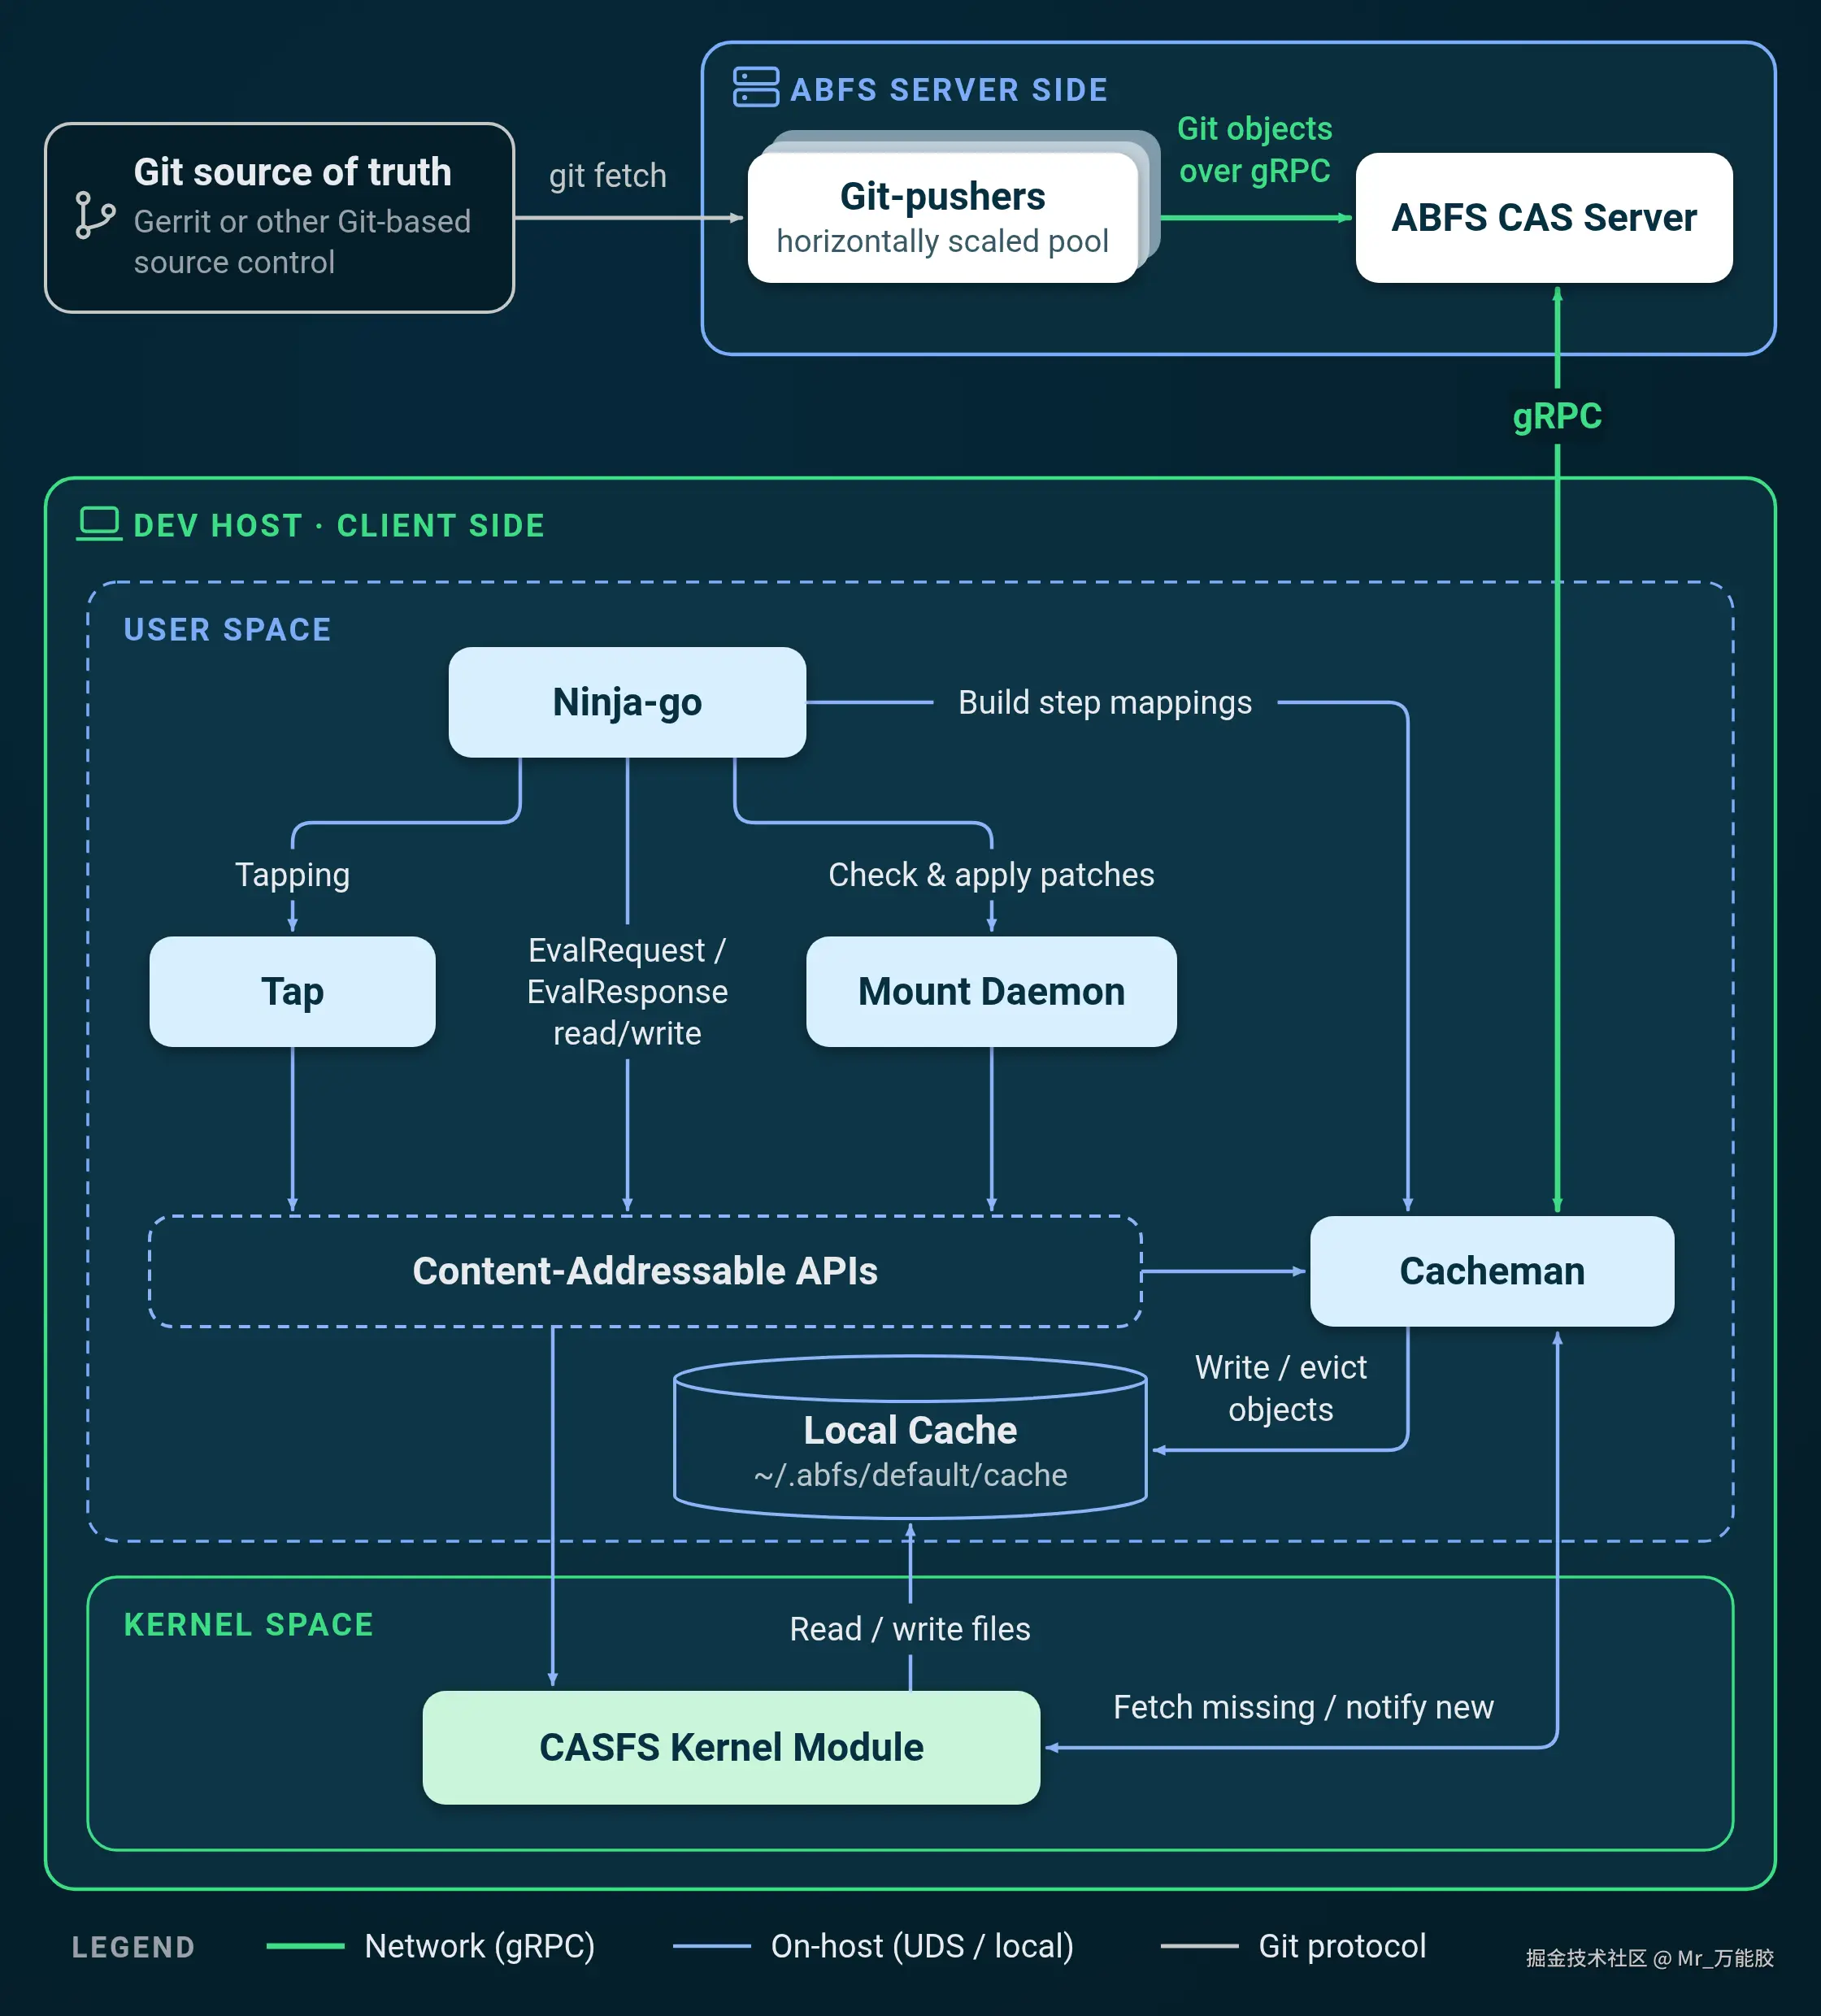
图源:Google Developers Blog。下边是开发机上的文件系统和缓存组件,上边的服务保存 Git 内容与构建结果。
看这张图时,主要抓住 CASFS → Cacheman → 远端服务 这条线。CASFS 负责呈现文件;需要内容时,Cacheman 先查本地缓存,没找到再向服务端获取。
它使用 Git 的内容哈希来标识文件。同一份内容即使出现在多个分支、多个工作目录里,也有机会复用本地缓存。git 和 repo 仍然可以在挂载的目录里使用。架构文档把这部分讲得比较清楚。
官方测试中,传统方式准备源码花了 36 分 19 秒 ;ABFS 在本地缓存为空时,挂载目录用了 7.4 秒。注意这里的"挂载"不是我们传统意义上的"代码整个下载完挂到本地"的意思。此时整份源码其实并没有下载完,后面读到尚未缓存的文件,仍然会发生网络请求,Google 现在把这个过程叫"挂载"。
编译结果能复用,怎么保证不会拿到旧的?
AOSP 的构建流程大致是 Android.bp → Soong → Ninja。Ninja 主要依据时间戳判断文件要不要重建。ABFS 使用的 Ninja-go 会查询内容哈希,再到共享缓存中寻找已完成的构建结果。Ninja-go 项目。
到这里可能有人会问:缓存是快了,可 AOSP 工程这么大,构建规则里的依赖万一没写全呢?
这个担心很有道理。Google 在架构文档里举了个例子:某个编译命令通过参数读取 schemas/v1.json,但这个 JSON 没被声明为构建输入。开发者只改 JSON,不改 Java 源码,传统增量构建就可能跳过这一步,留下过期的产物。相信被迫执行过 m clean 的同学,对这类问题不会陌生。
ABFS 为此做了两次检查。先根据命令、环境变量和已声明输入的哈希 找缓存结果;找到之后,还要核对这个构建动作上一次实际读取过的文件 。CASFS 能记录文件读取、写入和删除,所以那个漏写在构建规则里的 schemas/v1.json 也会出现在读取记录中。
如果 JSON 的内容变了,旧结果就会被拒绝,编译动作重新执行。没有变,才复用结果。这里处理的就是大型工程里常见的「规则写得不够完整」的问题。构建结果要是错的,省下来的几十分钟,迟早会在排查问题时还回去。
两分钟全编,我也想要。
Google 和 ABFS 项目 README 给出了完整对照。测试在同一云网络中的 GCE n2d-standard-64 虚拟机上进行,配置为 64 vCPU、256 GB 内存 ;数据取 3 次运行的平均值,构建目标使用 Cuttlefish,执行 m droid。
| 场景 | 平均耗时 |
|---|---|
| 传统方式同步源码 | 36 分 19 秒 |
| ABFS 挂载,空本地缓存 | 7.4 秒 |
| 传统方式构建 | 1 小时 20 分 35 秒 |
| ABFS 构建,不使用构建缓存 | 1 小时 39 分 11 秒 |
| ABFS 构建,空本地缓存、完整远端缓存 | 2 分 11 秒 |
| ABFS 构建,完整本地缓存 | 1 分 19 秒 |
比较耐人寻味的,是"ABFS 构建,不使用构建缓存 " 的 1 小时 39 分 11 秒 :关闭构建缓存后,ABFS 比传统构建还慢。CASFS 和实际文件访问记录本身都有开销。那 2 分 11 秒的成绩,靠的是远端已有可复用的构建结果,并且客户端与服务端处于网络条件良好的同一云环境。
所以如果你只是把 ABFS 装到一台电脑上,却没有团队共享缓存、没有 CI 持续填充缓存,就期待第一次全编直接缩短到两分钟,那大概率会失望。
真想上手,要做哪些事?
Google 已经提供了 Android 开发者使用文档。在管理员部署好 ABFS 服务、客户端安装好 ABFS 与 CASFS 后,开发者可以挂载工作目录,再按熟悉的方式编译:
bash
abfs mount --ws dev --branch android-latest-release mnt
cd mnt
source build/envsetup.sh
lunch aosp_cf_x86_64_only_phone-aosp_current-userdebug
m droid
编译时要确认日志显示 SOONG_NINJA=ninjago。如果最终还是传统 Ninja 在干活,自然用不上 ABFS 的共享构建缓存。文档也给出了缓存命中率的日志示例,方便判断这次加速究竟有没有发生。
不过目前它更像一套需要团队建设的基础设施 ,还不是装个插件就能解决问题。客户端依赖 Linux 内核模块;服务端要同步 Git 对象、保存源码和构建产物,并持续维护缓存。官方 README 明确提到网络质量、存储成本、非确定性构建都会影响效果。ABFS README。
需要注意的是,当前这套方案如果真的要上,有一些限制还得评估,比如当前 CAS 服务缺少客户端身份认证和权限控制,也尚无垃圾回收机制。准备接入公司源码的团队,得先解决网络隔离、容量和数据留存问题。这些在公司内部而言,可能得开发、配管、IT多部门一起解决才行。
最后
前些年我写 Cuttlefish 时,关注的是编完系统之后,能不能少折腾一次刷机。这次 ABFS 处理的是更靠前的两段:少等源码,少做重复编译。
至少,从思路上感觉这应该就是行得通的:源码按需取,构建结果跨 CI 和工作目录复用,同时检查那些构建规则里没写清楚的依赖。
对于经常维护多个机型分支、有稳定 CI 和基础设施团队的厂商,这套方案很值得研究。对于个人开发者,先理解它为什么快、在哪些条件下会慢,同样有价值。毕竟看懂瓶颈,才知道下次该优化哪一段,而不是又默默把 -j 往上加。