本文是《从 Copilot 到 WorkBuddy:让 AI 自学习、自验收、跨项目的几个实践》的续篇。上一篇埋了个伏笔:AI 写代码的速度远超人 review 的速度,我们的解法是把「LLM 语义评审」嵌进 CI。这一篇就把这套 AI 代码评审的实现拆开讲------规则怎么管、CI 怎么跑、结果怎么分发、评审质量怎么量化。
先看全貌
整套系统四层,每层职责单一:
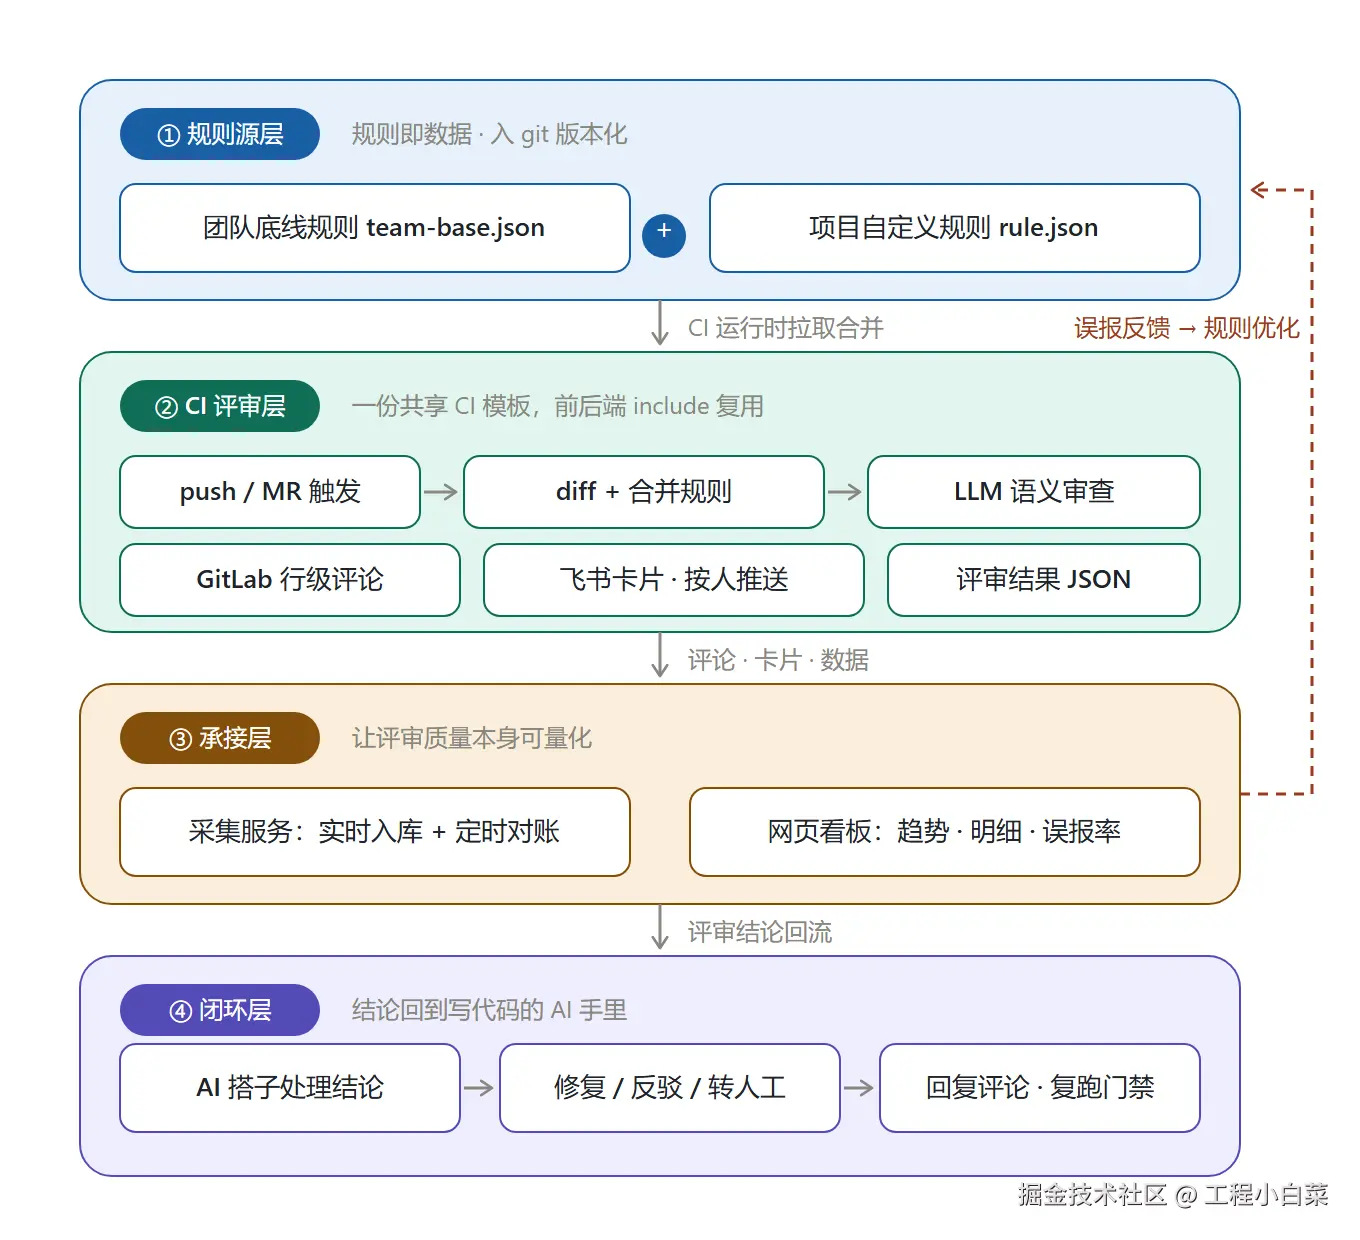
一句话概括分工:CI 负责「审」,飞书负责「喊」,看板负责「算」,AI 搭子负责「改」。
一、选型:引擎不造轮子,模型性价比优先
评审引擎我们直接用了阿里的开源工具 Open Code Review(下称 OCR),理由三条:
- 质量复用:直接继承阿里验证过的高质量规则,避免自己摸索提示词。
- 避开造轮子:省去处理代码上下文、Diff解析等繁琐底层开发。
- 维护零成本:紧跟大模型迭代,无需专人维护。
模型接的是公司内网模型网关,选了个便宜档的模型------代码评审这种任务不需要旗舰模型,性价比优先。实践下来这个判断是对的:评审 finding 的质量瓶颈更多在规则而不是模型智商。
二、规则拆分:团队底线 + 项目自定义
OCR 的评审规则是结构化 JSON,跟代码一样进 git 管理:
json
{
  "meta": { "version": "1.2.0" },
  "rules": [
    {
      "path": "src/request/**",
      "level": "background",
      "rule": "【豁免说明】src/request 是统一接口层,其中 import axios 是正常用法,不适用下条请求集中红线。",
      "merge_system_rule": true
    },
    {
      "path": "**/*.{js,ts,tsx}",
      "level": "redline",
      "rule": "【红线】所有后端请求必须集中在 src/request 目录,页面和组件不得直接创建 axios 实例。",
      "merge_system_rule": true
    }
  ]
}
这套 schema 里几个关键设计:
- path 匹配:规则可以精确到目录和文件类型,比如只对组件目录生效的 Props 类型规范
- level 三级 :
background是给 AI 的背景说明(包括豁免------告诉它哪种情况不算违规,这对降误报非常关键),redline是必须修的红线,team_standard是团队规范 - merge_system_rule:控制是否与 OCR 自带的系统规则合并,团队规则是叠加在通用规则之上的,不是替换
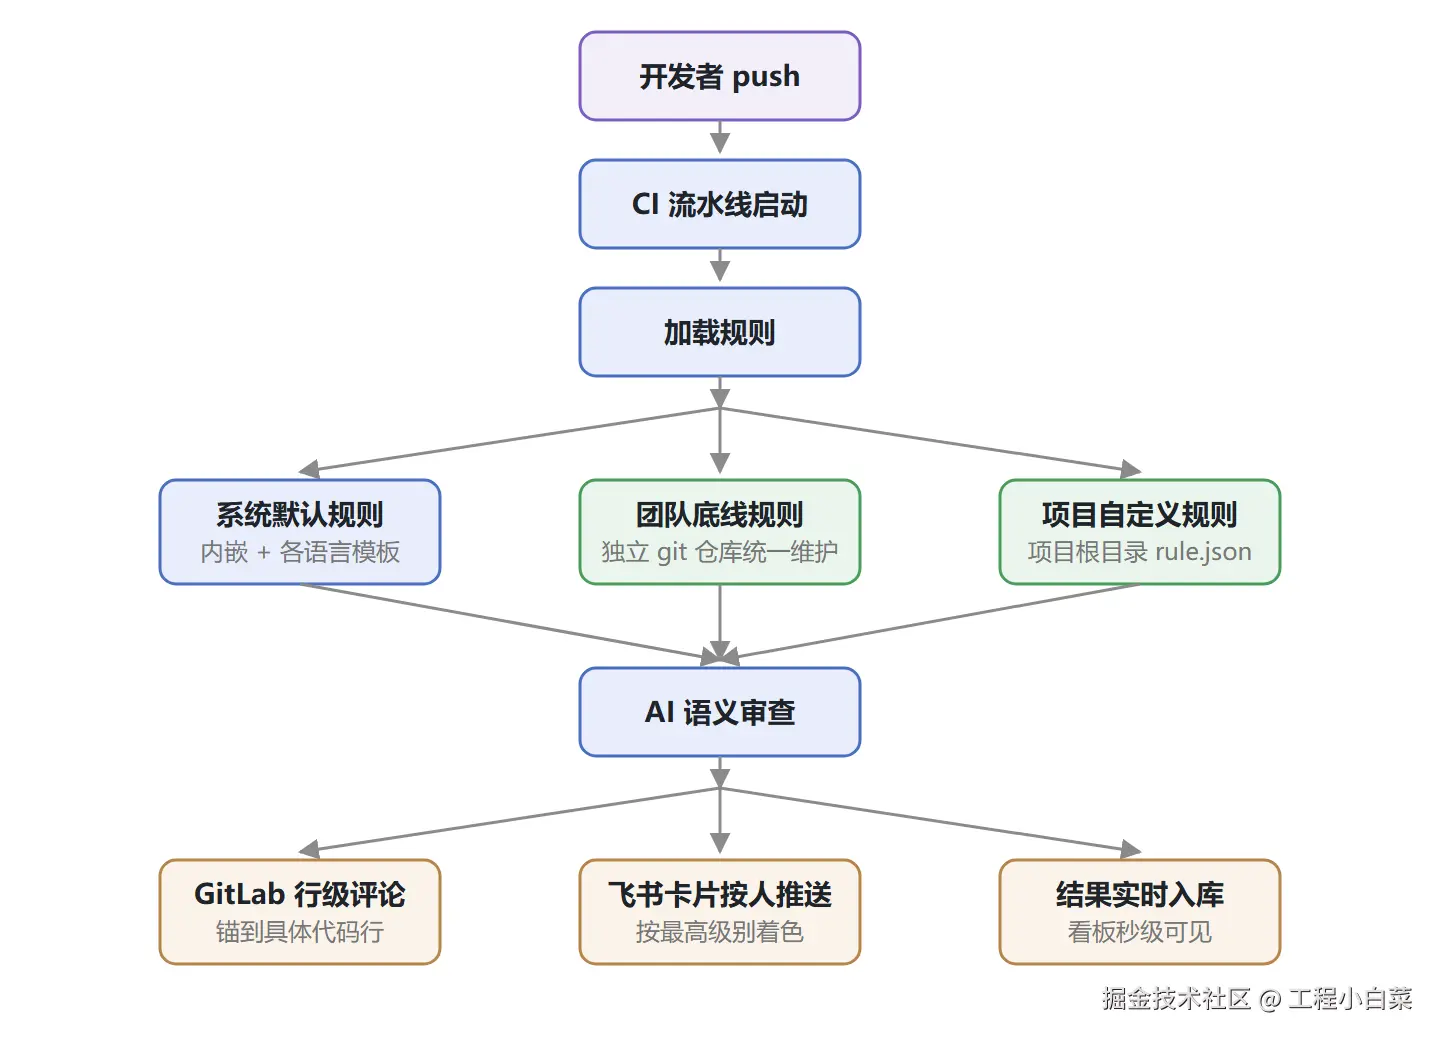
我们做的是把它拆成两层:团队底线规则放独立 git 仓库统一维护,CI 运行时拉取合并,拉取失败降级系统默认;项目自定义规则放各仓库根目录 .opencodereview/rule.json,按项目补自己的红线。写完 push 即生效,而且 CI 端和本地评审门禁共用同一份规则文件。
三、CI 作业:共享模板 + 差异变量化
评审作业收敛成了一份共享 CI 模板,前后端通过 include 引用:job 定义、评审逻辑、severity 口径、评论格式一份维护;前后端差异(扫描排除清单、建议代码块语言、runner、stage)抽成 CI 变量,使用方只覆盖几行壳配置。
yaml
ai_review_job:
  image: node:20
  only:
    - develop
    - release
  variables:
    GIT_DEPTH: "0"          # 全量历史,diff 才有基准
  allow_failure: true       # 评审与 build 并行,失败不阻塞部署
  script:
    - npm install -g <ocr-cli>
    # 1. 配置模型网关(变量在 GitLab group 级 CI Variables,项目零配置)
    # 2. 拉取团队规则 + 合并项目规则
    # 3. ocr review --from <基准> --to $CI_COMMIT_SHA --format json
    # 4. 结果分发:GitLab 评论 + 飞书卡片 + 实时入库看板
diff 基准分三种场景取:MR 模式取 MR diff base;普通 push 取上一次提交;新建分支首个 commit 没有父提交,自动 fetch 目标分支作为基准;实在拿不到再退化为单提交扫描。
allow_failure 保障嵌入无感:评审作业与 build 并行执行,挂了、超时都不影响部署,开发者使用方式与接入前完全一致。
排除清单按技术栈变量化 :前端排除 dist/、*.less,后端排除 target/、*.class,压缩产物和样式文件一律不进 LLM。
四、结果分发:一条结果,三路出口
OCR 输出 JSON 后,一个 Node 脚本做三路分发:
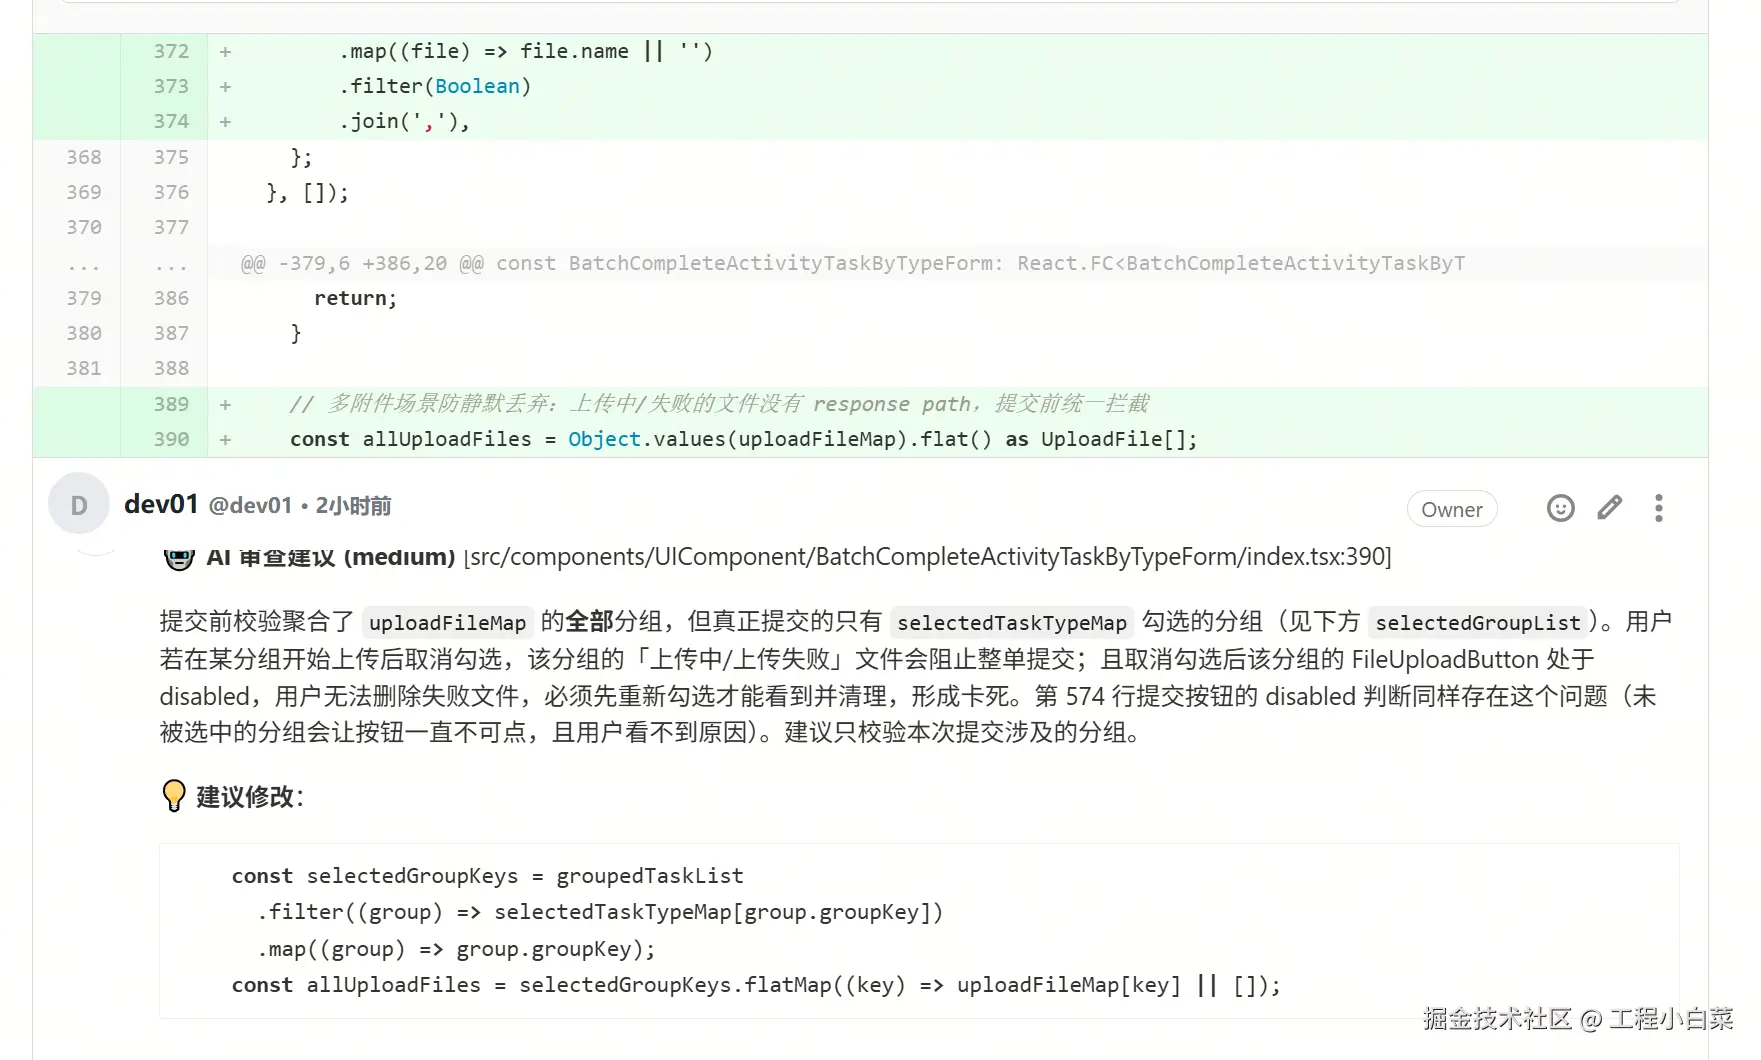
GitLab commit 评论 。每条 finding 独立评论,用官方 API 的 path / line / line_type: "new" 参数锚到具体代码行------打开 commit 页面直接看到是哪一行的问题。评论正文带固定格式(🤖 AI 审查建议 (severity)),评论创建后拿回 noteId------这个 ID 是后面采集层精准定位的钥匙。
飞书消息卡片。评论完成后私聊推送给被审人,每张卡片自己讲清楚三件事:
- 有多严重:卡片标题按本次问题的最高级别着色------高→红、中→黄、低→蓝,扫一眼就知道要不要立刻处理
- 在哪看:每条问题带严重度圆点,点击文件行号直接跳到 GitLab 对应评论;底部「审查统计看板」按钮按分支跳对应环境的看板,「查看全部评论」回到 commit 页
- 谁的责任:卡片带项目/分支双栏和触发信息;多人混合的扫描范围按作者拆分,每人只收到自己改动文件相关的评论
对卡片的回复(「误报 / 已修复」)会自动归类进看板统计。
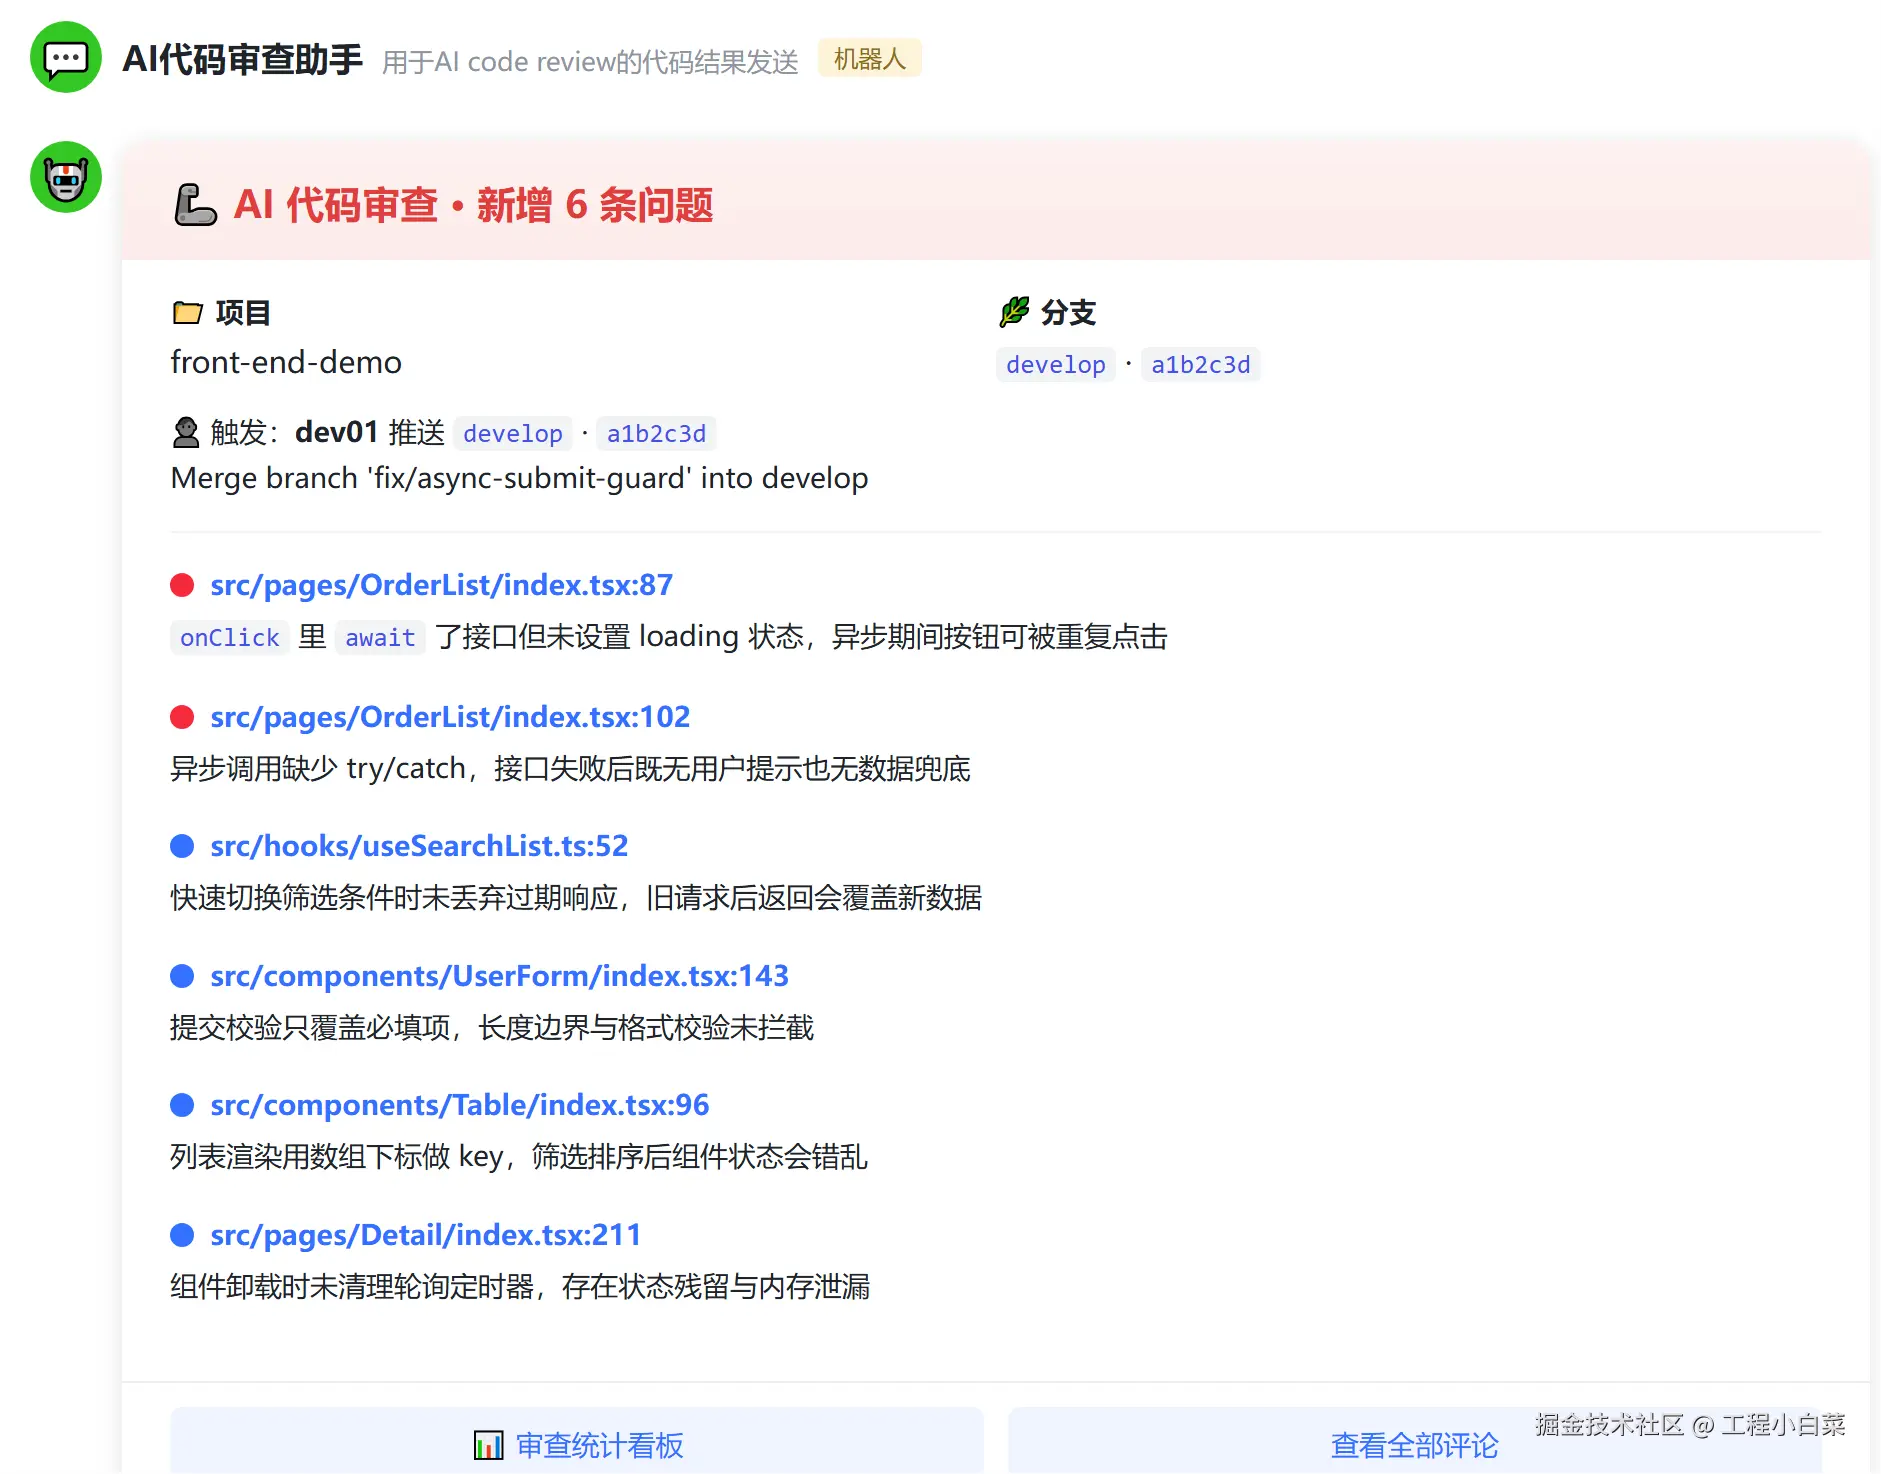
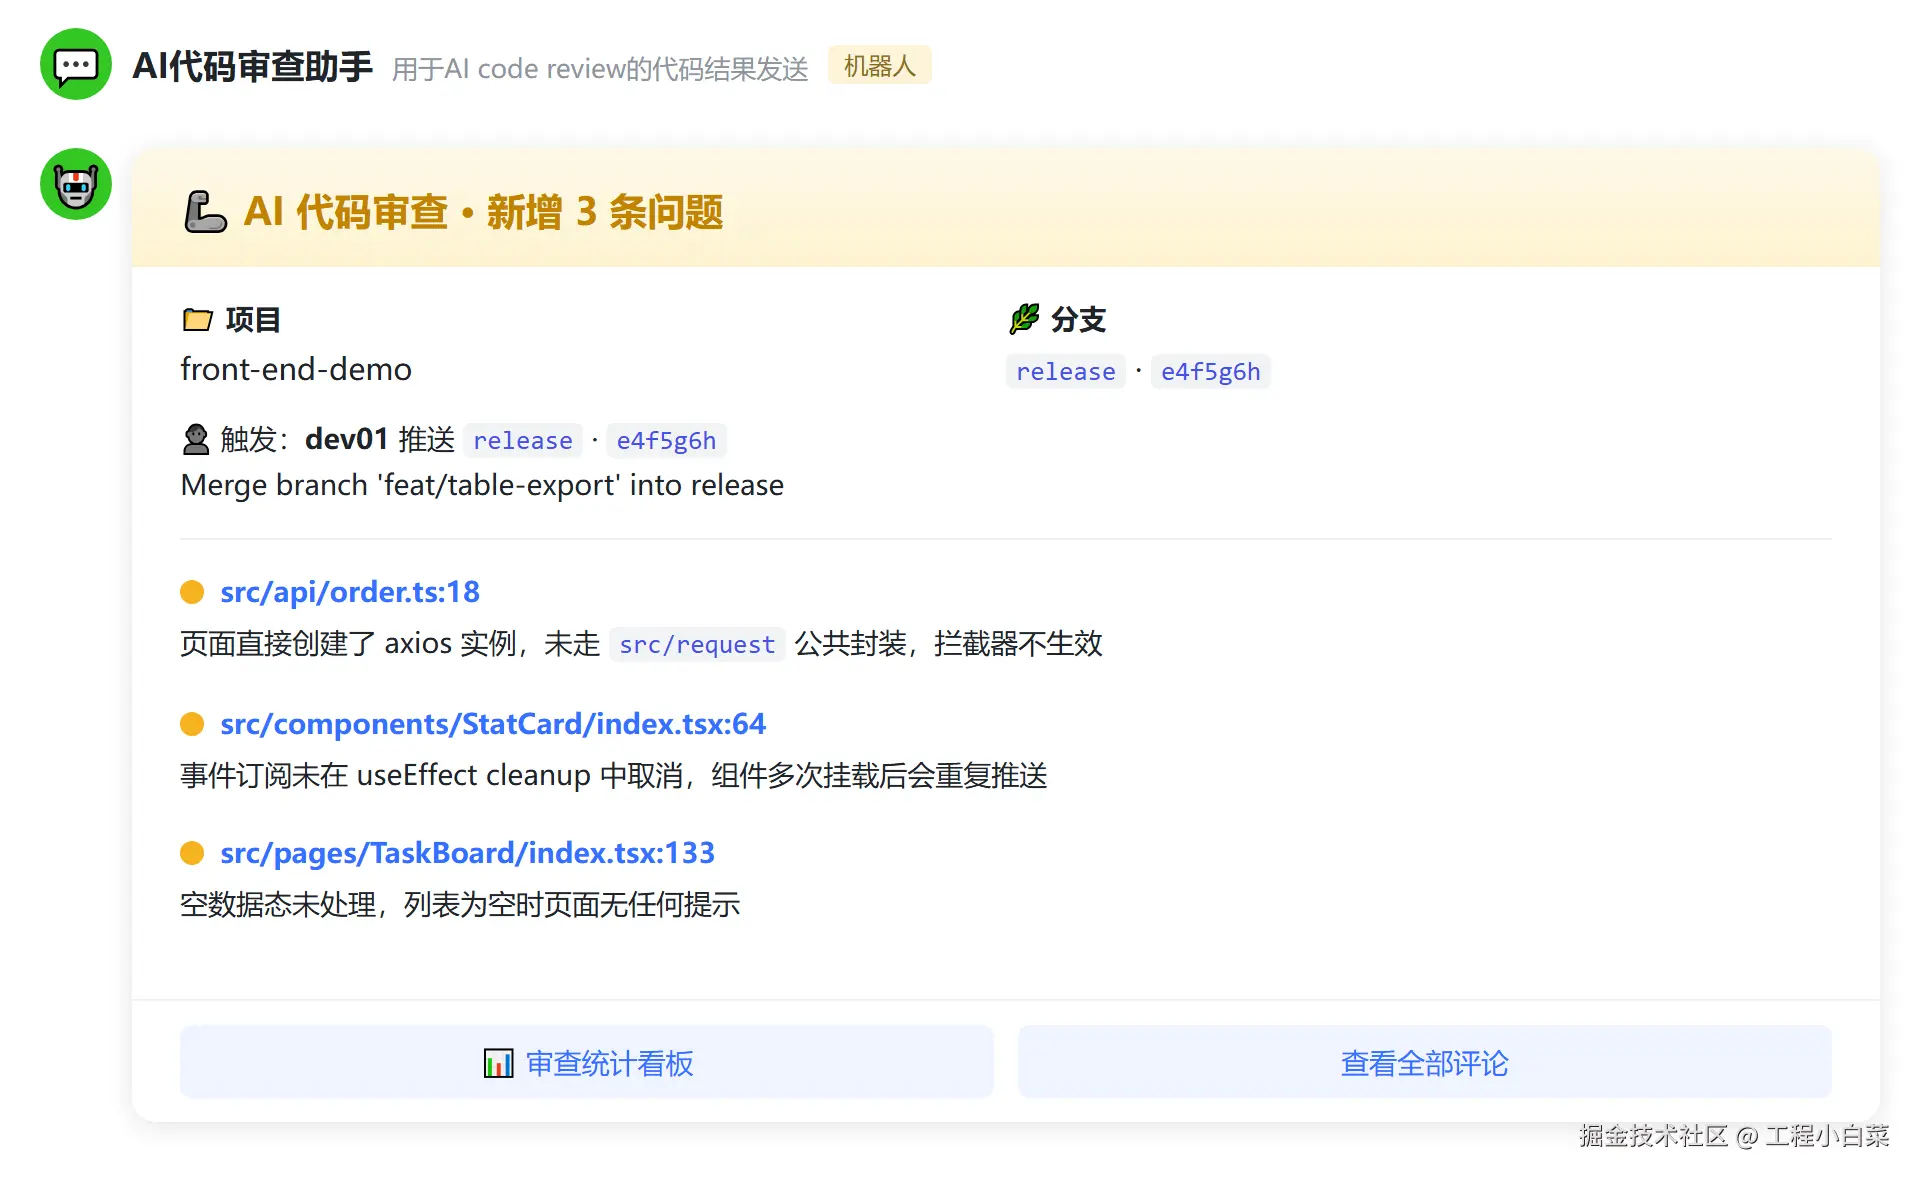
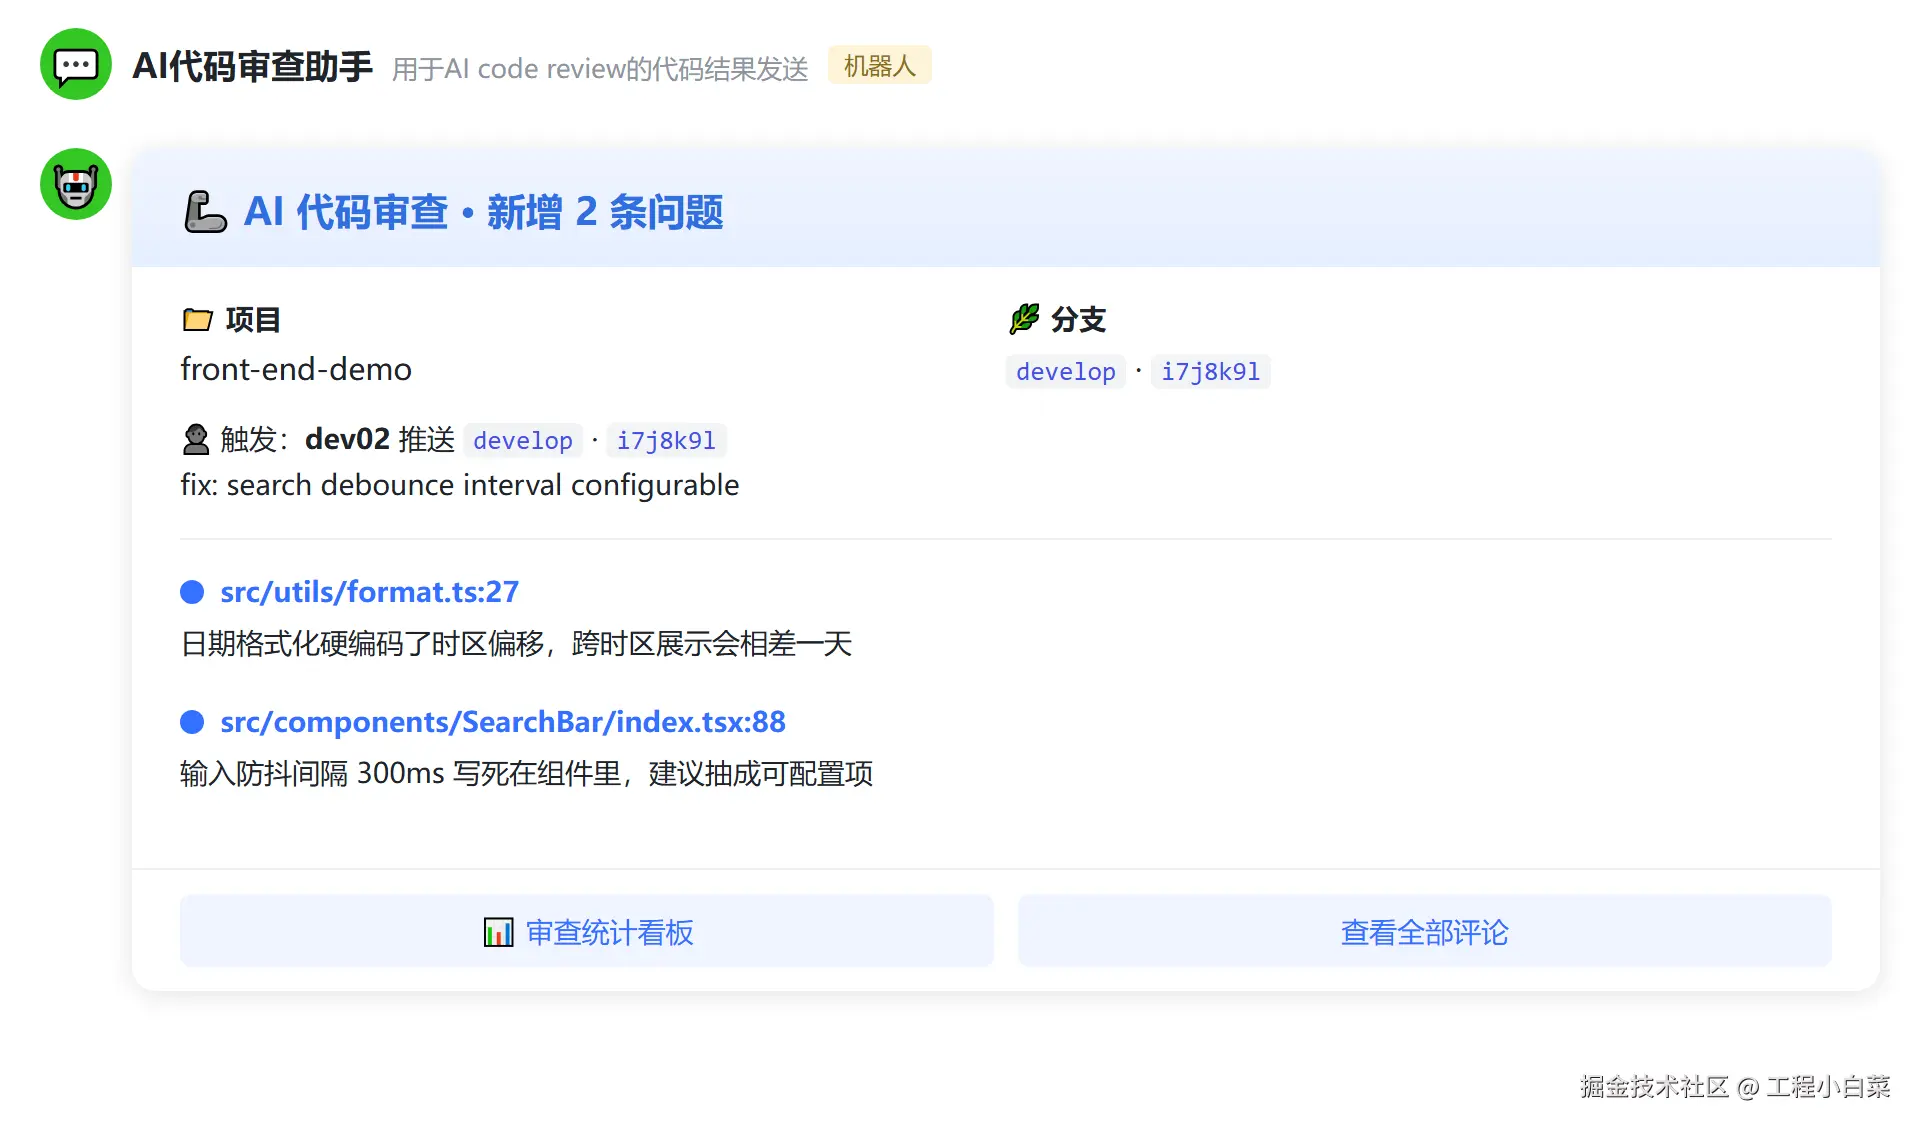
实时入库。同一份结果带 token 推送到采集服务的入库接口,severity 统一口径后落库------评审记录秒级可见,不等离线采集。
五、承接层:让评审质量本身可量化
分发出去只是开始。评论散落在几百个 commit 上,没人看得过来,我们需要回答的问题是:这套 AI 评审到底准不准?大家认不认?
于是有了采集服务和看板:
- AI 评论识别按正文格式,不按账号。CI 用的 token 和人用的账号可能变,但评论正文格式是我们自己定的------按格式识别天然稳定,前后端两套系统的评论也能统一收进来
- 双通道入库:CI 跑完实时推送到采集服务(有评论立刻可见),另有定时任务全量对账(补齐回复、修正状态、兜底实时通道漏掉的)。实时管「快」,对账管「准」
- 回复状态推断 :开发者在 AI 评论下回复「👍 已修复」或「🤡 误报」,采集层用正则推断这条 finding 的最终状态:adopted / falsePositive / pending。误报是 用户 用脚投票标记的,不是我们自己判的
- 看板:趋势图(每天产生多少条评审意见、各严重级别占比)、按项目/按人的明细表、误报率统计
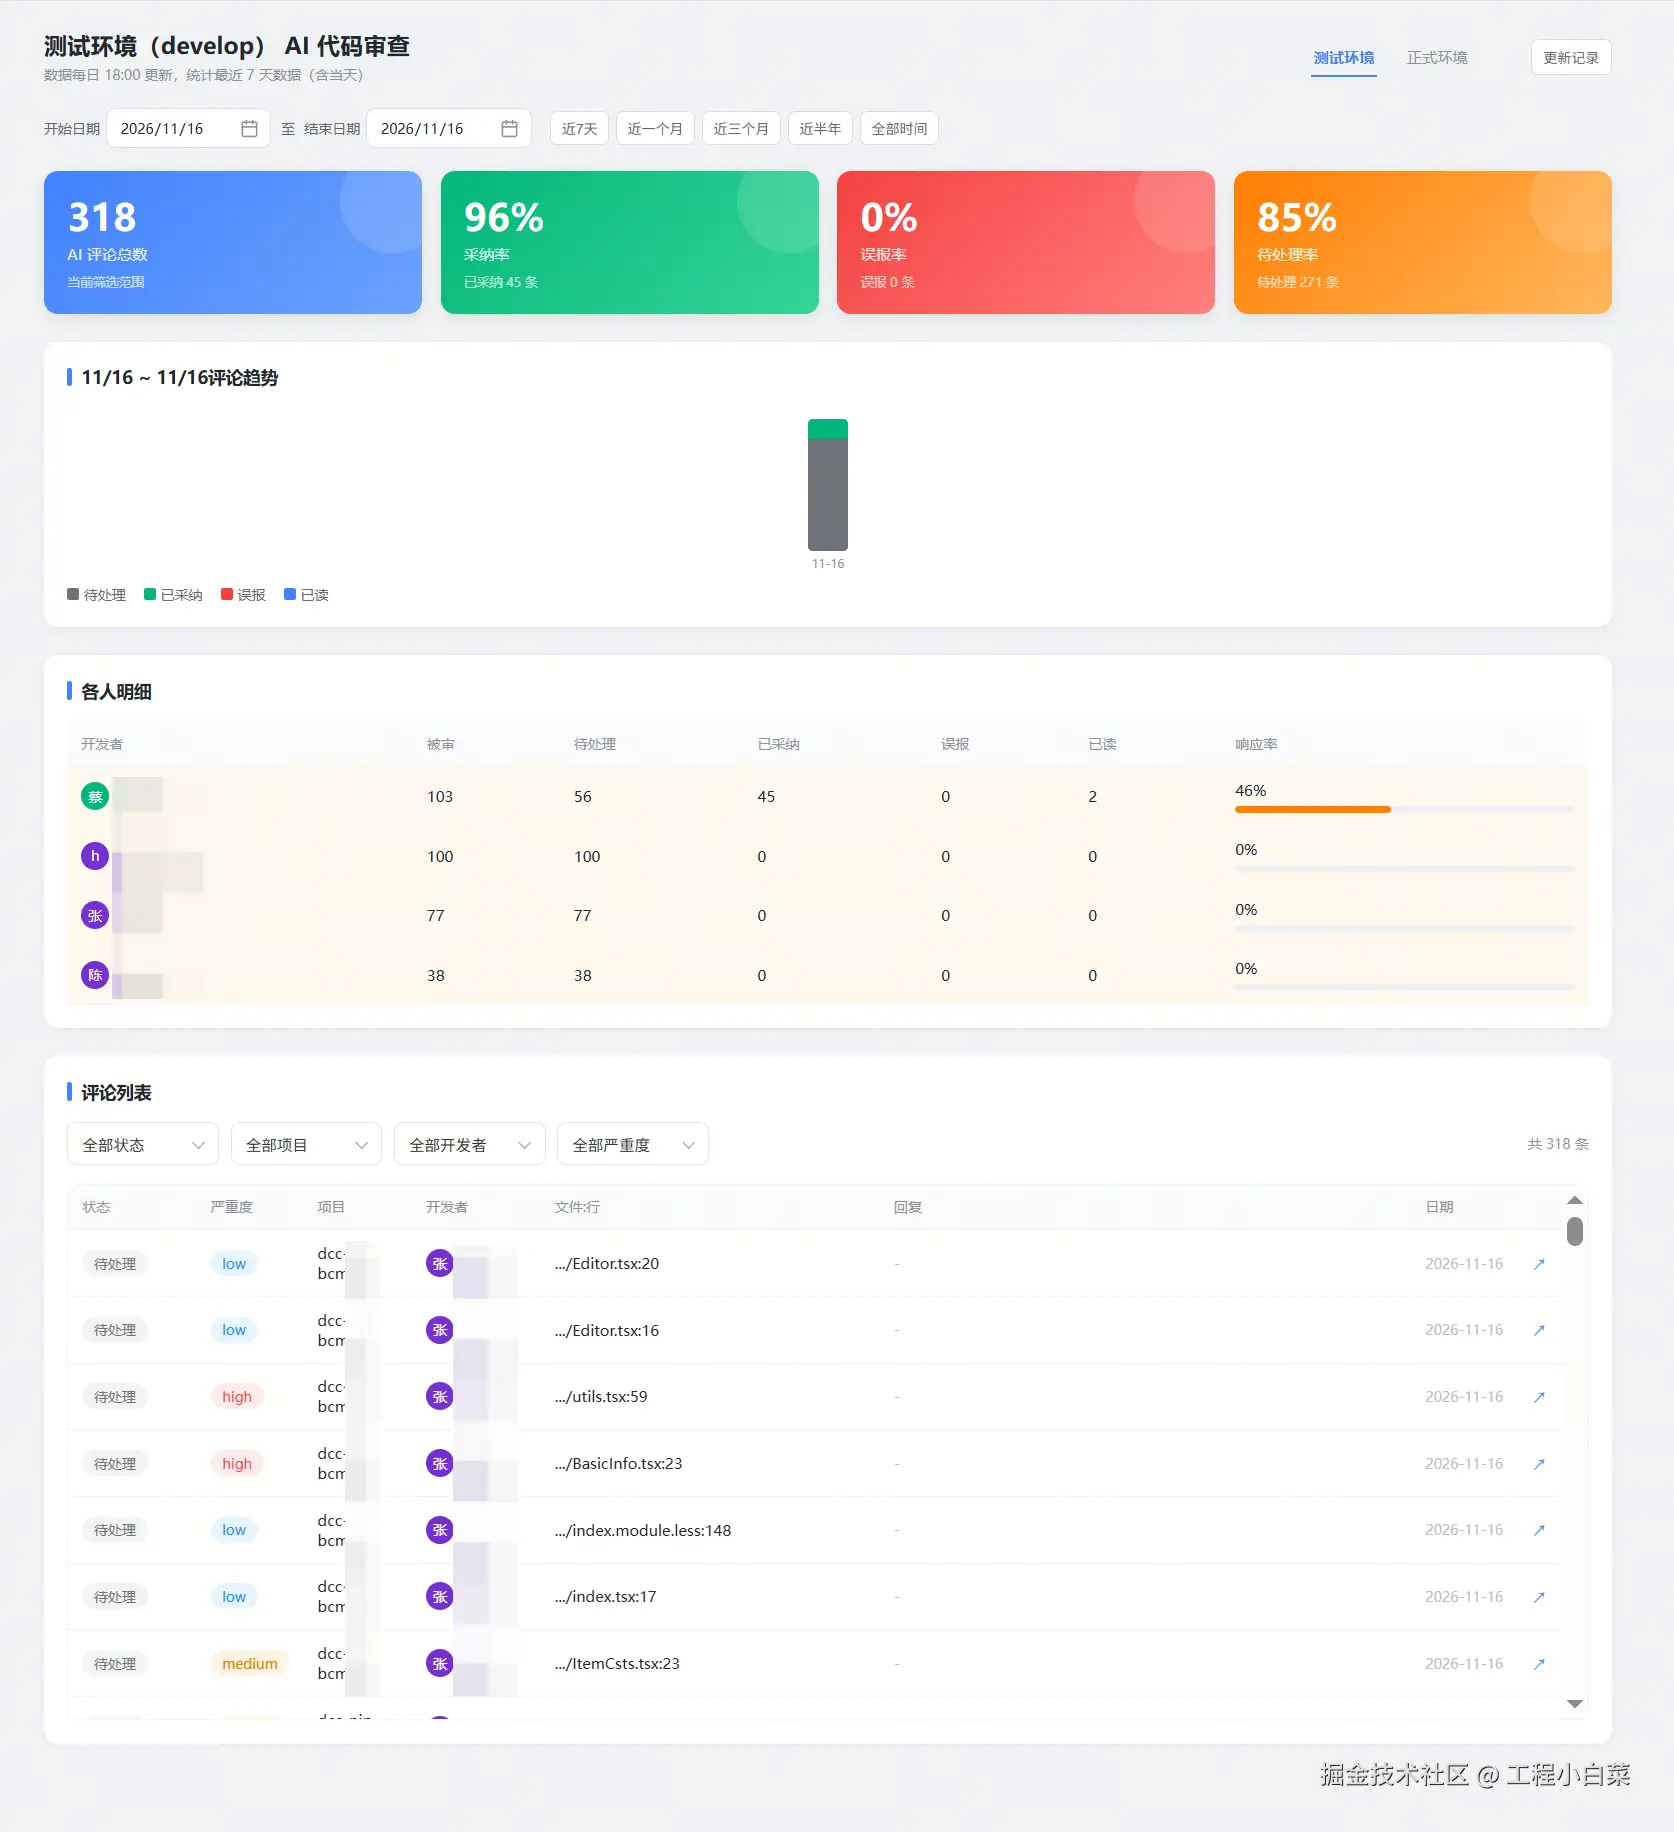
这一层出来之后有个意外收获:误报率成了规则优化的直接输入。某条规则误报持续偏高 → 看板一眼看到 → 改规则 → 下个版本误报率下降,全程有数据。
六、闭环层:评审结论回到写代码的 AI 手里
到这里,「发现」的问题还是要人去改。但我们日常开发是 AI 写码的(上一篇讲过),所以评审结论的消费者还应该有 AI 本身------运动员/裁判分离的「裁判」,判完要把球传回给「运动员」。
红线问题,本地拦截。AI 搭子改完代码主动跑本地评审门禁------一组红线正则,秒级、确定性,命中直接拦截、兜底永远执行,逐条修复复跑直到红线清零。
CI 评论,逐条处理并回复。按固定口径回复在 GitLab 评论下:
- 已修复:说明修复方式,附修复 commit,评论可追溯到代码
- 已失效:问题在后续提交已经实现或已不存在,说明依据
- 误报:给出理由------比如参数结构是后端 OpenAPI 定义、测试环境联调已通过
- 拿不准的转人工,不硬答
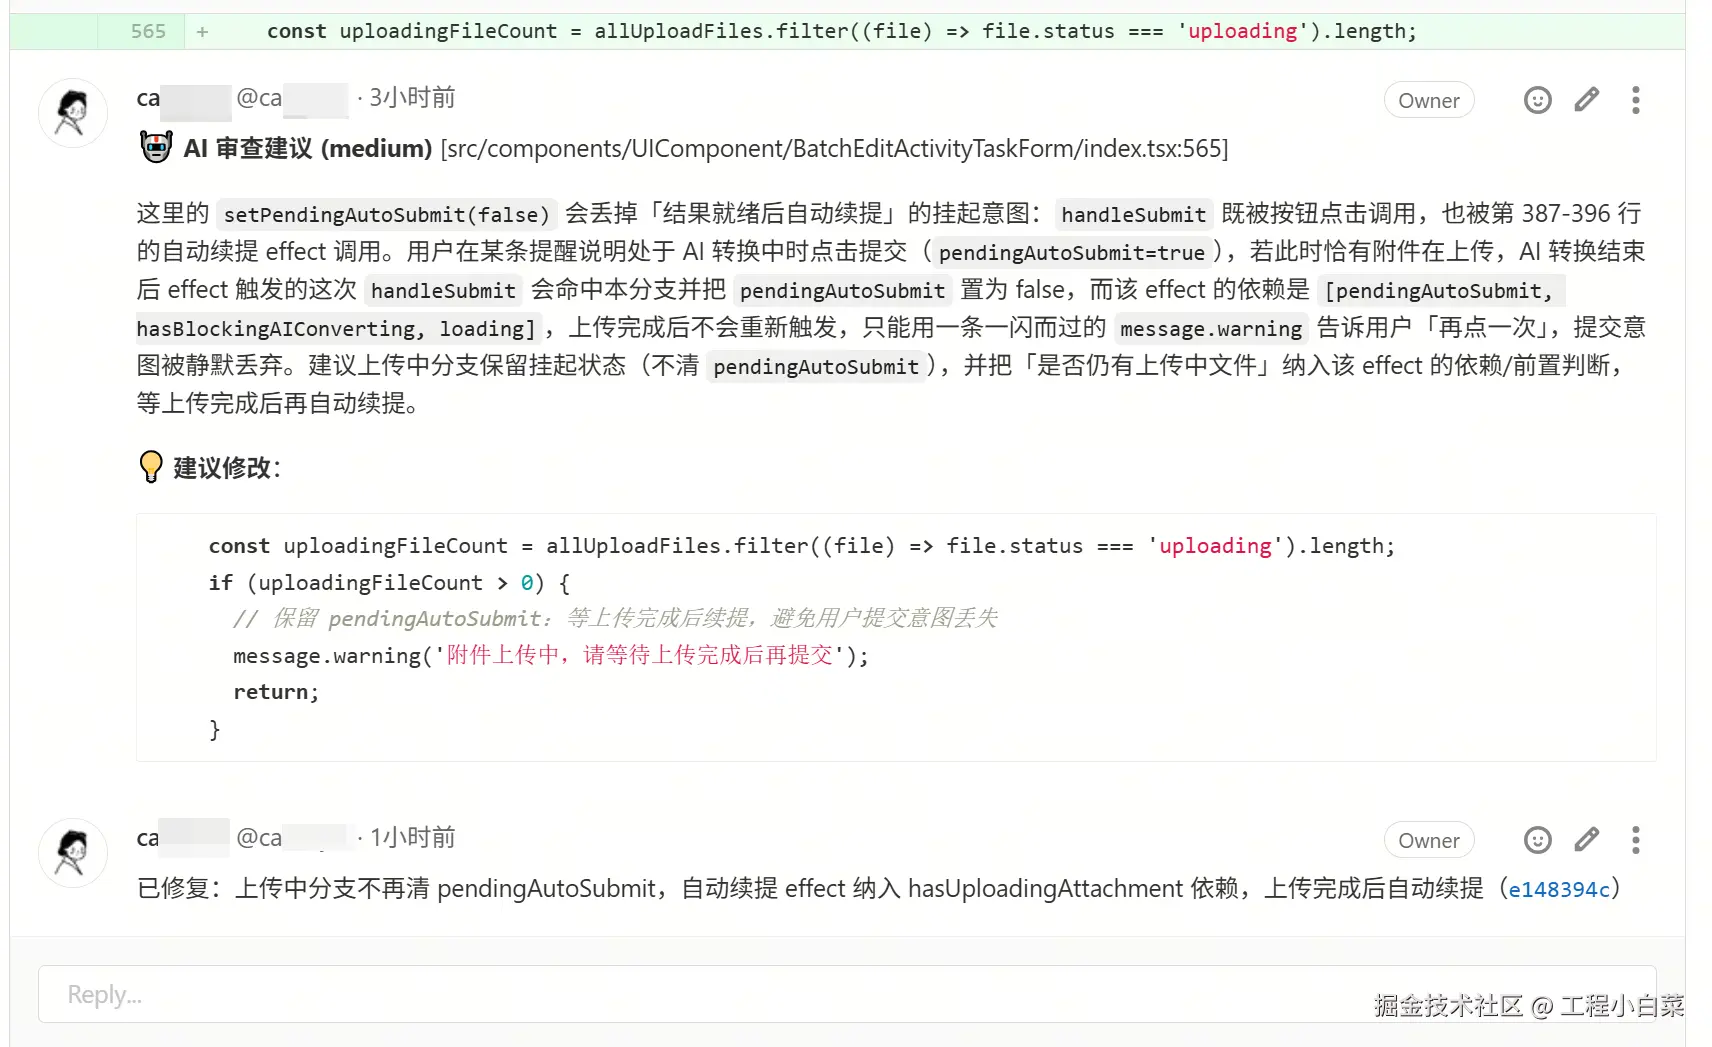
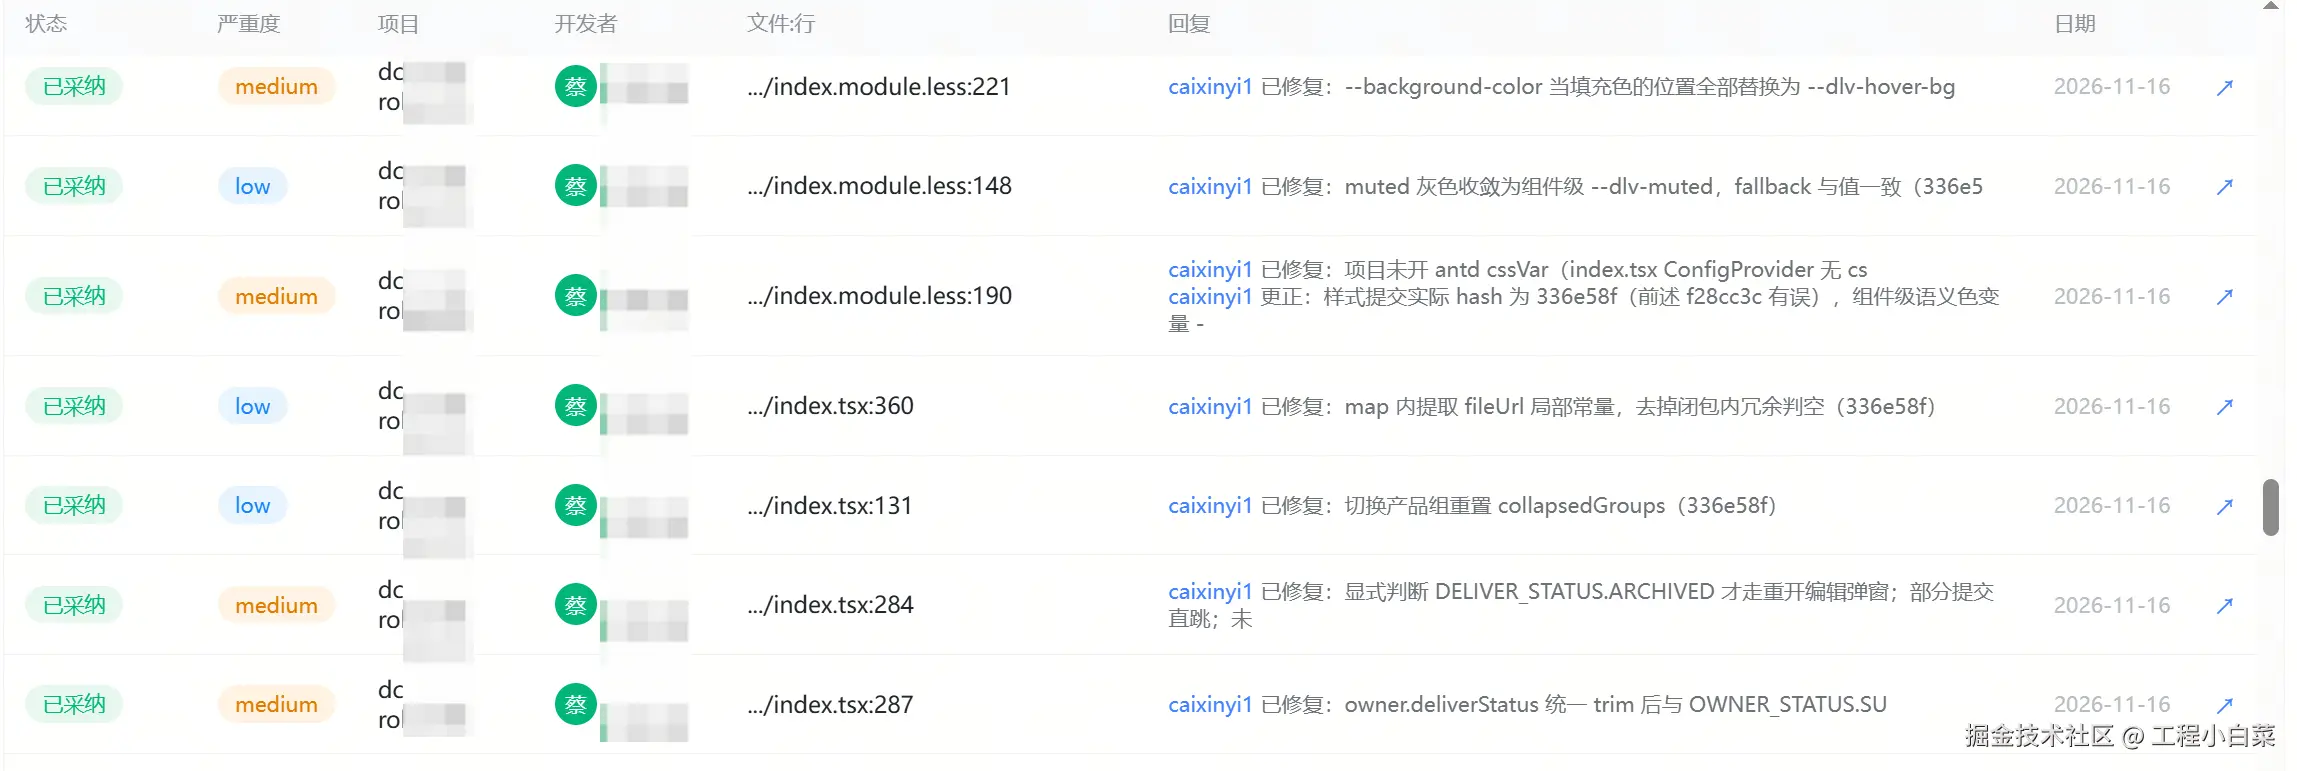
实测一轮真实处理:17 条 CI 评论,14 已修复、2 已失效、1 误报,回复全部由AI生成提交,人只最后确认。
回复自动回流看板。采集层按关键词归类回复、推断状态。AI 审 AI 的代码,AI 回 AI 的评论,人只在关键节点拍板。
写在最后
最后把整条链路串一遍:AI 改完代码,先过本地红线门禁,清零才 push;CI 做语义评审,评论锚到行、卡片推到人、结果实时入库;结论回到搭子手里,按口径逐条回复;回复被采集归类、回流看板,误报率反过来优化规则------下一轮评审从更准的规则开始。
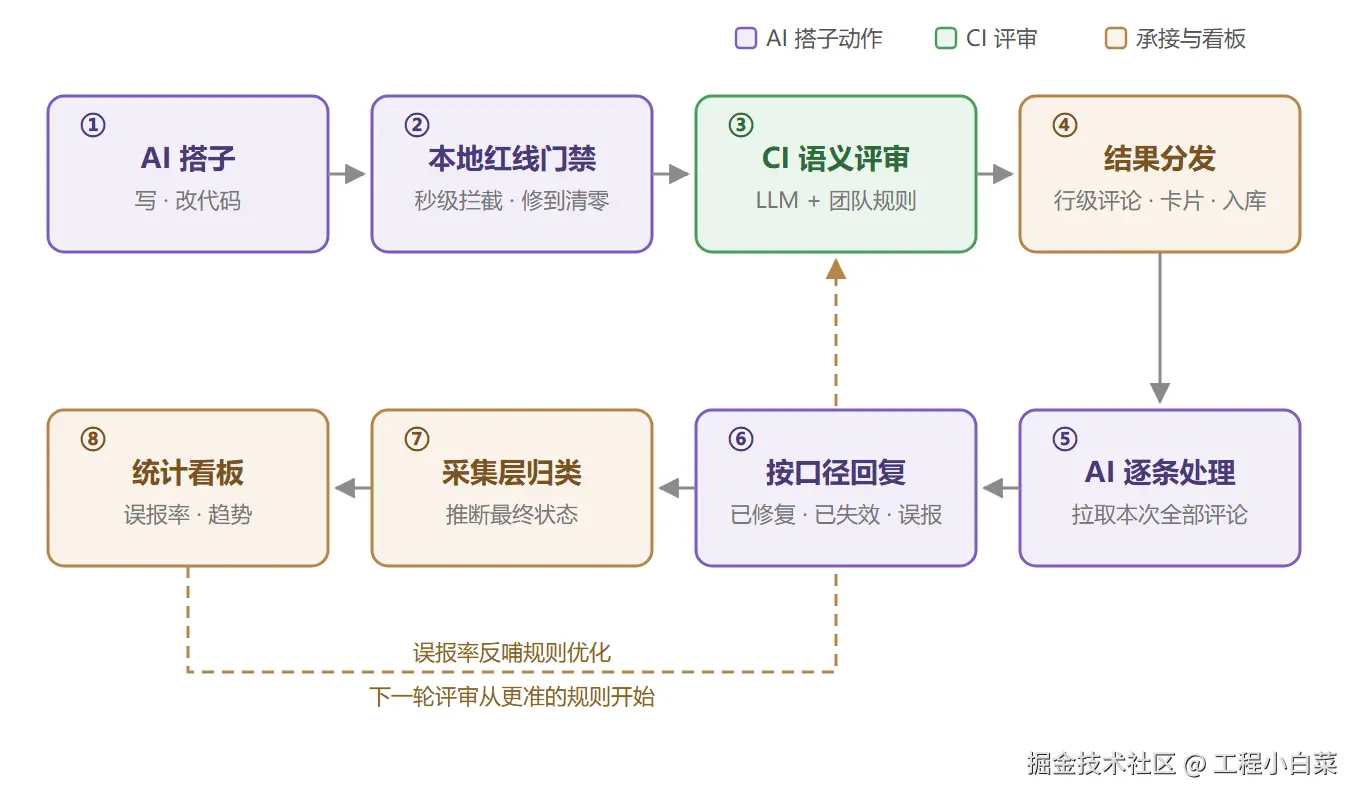
还有一层更实际的收益:当 AI 既写码又回评论,人的角色就从「逐条处理评审意见」退到「看数据、拍关键板」。上一篇的结论是「AI 提效的瓶颈是沉淀、验收和规模化」,这篇补上的是验收这条线的另一半------验收不只是 AI 自查,还要有独立的裁判,而裁判自己也要被度量。
有问题欢迎评论区交流。