Netty 的 ByteBuf 用双索引读写模型、动态扩容与引用计数解决了 JDK ByteBuffer 的核心痛点。而"池化(Pooled)"与"堆外(Direct)"两条正交维度交汇之处,正是 Netty 高性能内存管理的核心命题------既不能让频繁创建销毁的小缓冲区反复穿越 JVM 堆与内核之间,又要让分配与释放尽量贴合线程局部、减少锁竞争。Netty 对此给出的答案是 PooledByteBufAllocator:一个借鉴 jemalloc 思路的分层池化分配器。它自上而下把内存划分为 Allocator、Arena、ChunkList、Chunk、Subpage 五个层次,Allocator 按线程分发到 Arena,Arena 内用六条使用率链表管理 Chunk,Chunk 以 run(连续页段)为粒度分配,Subpage 再用位图切分小块。理解这套多级结构,是掌握 Netty 内存管理乃至排查内存泄漏问题的关键一步。
围绕"Allocator 分层 → SizeClasses 规格 → Chunk run 分配 → Subpage 位图 → ChunkList 迁移"这条主线,以下几个问题将贯穿本文的源码分析:
PooledByteBufAllocator的默认pageSize、maxOrder、chunkSize与nHeapArena/nDirectArena各是多少,它们如何计算,又分别被哪个系统属性覆盖?SizeClasses如何用log2Group/log2Delta/nDelta三个参数生成全部内存规格,size2idxTab又怎样在查找表覆盖范围内以 O(1) 归一化请求大小?- 一次
directBuffer()调用如何经PoolThreadLocalCache拿到线程绑定的 Arena,再被PoolArena.allocate()按 Small / Normal / Huge 三路分发? PoolChunk的 64 位handle位图如何编码 runOffset、size、isUsed、isSubpage、bitmapIdx,runsAvail优先队列与runsAvailMap又是怎样支撑 run 的查找与切分?PoolSubpage的bitmap位图与doNotDestroy标志如何实现小块的高频复用,PoolChunkList的六级链表又如何随使用率迁移PoolChunk并最终释放内存?
本文将沿着池化内存"归一化 → 分层查找 → run 分配 → subpage 切分 → 回收合并"的完整链路,逐一分析五层架构与核心参数、SizeClasses 的规格生成、PoolChunk 的 run-based 分配算法、PoolSubpage 的位图管理,最后解读 PoolChunkList 的使用率迁移与 PoolChunk.free() 的连续 run 合并。
一、池化内存分配的架构总览:五层分层与核心参数
1.1 五层分层架构
PooledByteBufAllocator 的设计思路可以凝练成一句话:把内存按"规格"和"归属"两个维度切碎,让每次分配都落在最合适的层级上。所谓"归属",是指把竞争域缩小到线程,每个线程通过线程缓存绑定到某一个 Arena,分配释放尽量在自己线程内完成;所谓"规格",是指把连续的请求大小离散成有限的 size class,从而让 chunk 与 subpage 各自只处理自己擅长的那一段粒度。这两条线索交汇出的完整层级如下:
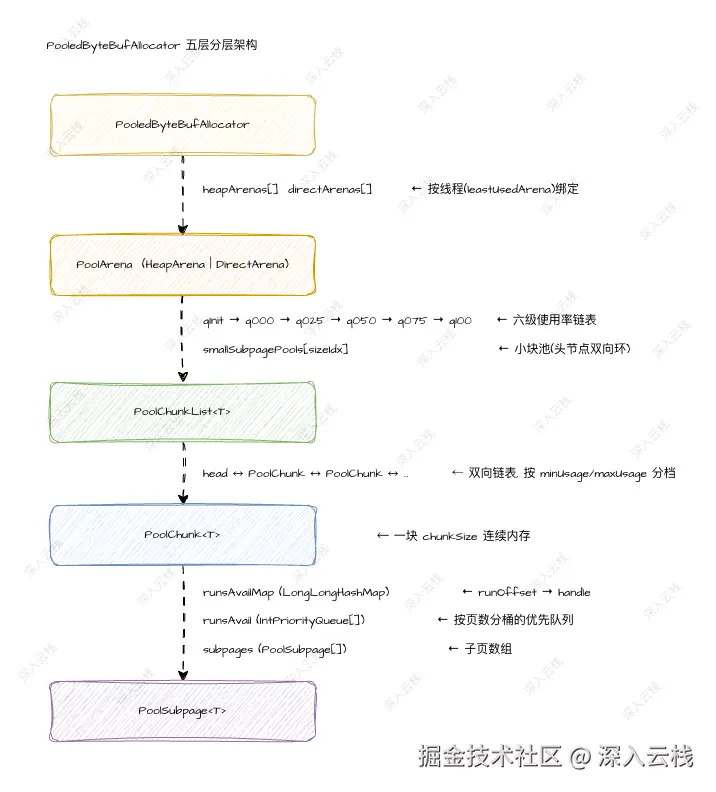
最顶层是 PooledByteBufAllocator,它持有 heapArenas[] 与 directArenas[] 两组 Arena 数组,并维护一个线程级缓存,负责把每个线程路由到"最不拥挤"的那个 Arena。第二层 PoolArena 是同一规格内存的共享竞争域:堆内存归 HeapArena,堆外内存归 DirectArena,主体结构一致,差异主要在内存落地方式与 HeapArena 的 chunk 复用上。第三层 PoolChunkList 把 Arena 里的所有 chunk 按使用率分成六个档位,第四层 PoolChunk 是一块 chunkSize 大小的连续内存、以 run 为分配粒度,第五层 PoolSubpage 则把 run 再切成 elemSize 大小的小块、用位图管理。下面先看这套结构的地基:默认参数。
1.2 默认参数:静态初始化块
PooledByteBufAllocator 的所有默认值都在一个 static 初始化块里解析系统属性(前缀统一是 io.netty.allocator.*)得到,我们截取其中最关键的几段:
java
io.netty.buffer.PooledByteBufAllocator

// 静态初始化块:解析系统属性,确定 pageSize / maxOrder / arena 数量
static {
    int defaultAlignment = SystemPropertyUtil.getInt(
            "io.netty.allocator.directMemoryCacheAlignment", 0);
    int defaultPageSize = SystemPropertyUtil.getInt("io.netty.allocator.pageSize", 8192);
    Throwable pageSizeFallbackCause = null;
    try {
        validateAndCalculatePageShifts(defaultPageSize, defaultAlignment);
    } catch (Throwable t) {
        pageSizeFallbackCause = t;
        defaultPageSize = 8192;
        defaultAlignment = 0;
    }
    DEFAULT_PAGE_SIZE = defaultPageSize;
    DEFAULT_DIRECT_MEMORY_CACHE_ALIGNMENT = defaultAlignment;

    int defaultMaxOrder = SystemPropertyUtil.getInt("io.netty.allocator.maxOrder", 9);
    Throwable maxOrderFallbackCause = null;
    try {
        validateAndCalculateChunkSize(DEFAULT_PAGE_SIZE, defaultMaxOrder);
    } catch (Throwable t) {
        maxOrderFallbackCause = t;
        defaultMaxOrder = 9;
    }
    DEFAULT_MAX_ORDER = defaultMaxOrder;

    // 假设每个 arena 持有 3 个 chunk,使池化内存最多占用总内存的约 50%
    final Runtime runtime = Runtime.getRuntime();

    /*
     * 默认用 2 * availableProcessors 起步,与 NIO/EPOLL 下 EventLoop 数量对齐,
     * 减少分配与释放时需要同步 PoolArena 带来的热点竞争。
     */
    final int defaultMinNumArena = NettyRuntime.availableProcessors() * 2;
    final int defaultChunkSize = DEFAULT_PAGE_SIZE << DEFAULT_MAX_ORDER;
    DEFAULT_NUM_HEAP_ARENA = Math.max(0,
            SystemPropertyUtil.getInt(
                    "io.netty.allocator.numHeapArenas",
                    (int) Math.min(
                            defaultMinNumArena,
                            runtime.maxMemory() / defaultChunkSize / 2 / 3)));
    DEFAULT_NUM_DIRECT_ARENA = Math.max(0,
            SystemPropertyUtil.getInt(
                    "io.netty.allocator.numDirectArenas",
                    (int) Math.min(
                            defaultMinNumArena,
                            PlatformDependent.maxDirectMemory() / defaultChunkSize / 2 / 3)));

    // 线程缓存大小
    DEFAULT_SMALL_CACHE_SIZE = SystemPropertyUtil.getInt("io.netty.allocator.smallCacheSize", 256);
    DEFAULT_NORMAL_CACHE_SIZE = SystemPropertyUtil.getInt("io.netty.allocator.normalCacheSize", 64);
    // ... 其余 cacheTrimInterval、maxCachedBufferCapacity 等略
}
这里有几个必须点明的默认值:
DEFAULT_PAGE_SIZE默认是 8192 字节(8KB) ,io.netty.allocator.pageSize可覆盖。DEFAULT_MAX_ORDER默认是 9 ,io.netty.allocator.maxOrder可覆盖。源码在字段声明处直接写了一句注释// 8192 << 9 = 4 MiB per chunk,也就是说默认chunkSize = 8KB << 9 = 4 MiB。- Arena 数量的默认起点是
NettyRuntime.availableProcessors() * 2(2 倍核数 ),再取min(..., maxMemory / chunkSize / 2 / 3)作为内存维度的上限。堆内存用runtime.maxMemory(),堆外内存用PlatformDependent.maxDirectMemory(),最后各自再被Math.max(0, ...)兜底。 - 线程缓存只有
smallCacheSize与normalCacheSize两个默认值(256 / 64)。tinyCacheSize在当前版本已废弃:构造器里虽然还保留着带tinyCacheSize的重载签名,但内部直接忽略这个参数,转调不含它的新构造器。
1.3 PoolArena 的骨架:六级链表与 subpage 池
PoolArena 的构造器把第二、三层结构都织起来。它先按 sizeClass.nSubpages 建一个 PoolSubpage 头节点数组(每个 small 规格一个头,详见第五章),再构建六级 PoolChunkList:
java
io.netty.buffer.PoolArena

protected PoolArena(PooledByteBufAllocator parent, SizeClasses sizeClass) {
    assert null != sizeClass;
    this.parent = parent;
    this.sizeClass = sizeClass;
    // 每个 small sizeIdx 对应一个 subpage 池头节点
    smallSubpagePools = newSubpagePoolArray(sizeClass.nSubpages);
    for (int i = 0; i < smallSubpagePools.length; i ++) {
        smallSubpagePools[i] = newSubpagePoolHead(i);
    }

    // 六级 chunkList,minUsage / maxUsage 依次递进
    q100 = new PoolChunkList<T>(this, null, 100, Integer.MAX_VALUE, sizeClass.chunkSize);
    q075 = new PoolChunkList<T>(this, q100, 75, 100, sizeClass.chunkSize);
    q050 = new PoolChunkList<T>(this, q100, 50, 100, sizeClass.chunkSize);
    q025 = new PoolChunkList<T>(this, q050, 25, 75, sizeClass.chunkSize);
    q000 = new PoolChunkList<T>(this, q025, 1, 50, sizeClass.chunkSize);
    qInit = new PoolChunkList<T>(this, q000, Integer.MIN_VALUE, 25, sizeClass.chunkSize);

    // 回连上一个(更低使用率)链表,构成双向迁移路径
    q100.prevList(q075);
    q075.prevList(q050);
    q050.prevList(q025);
    q025.prevList(q000);
    q000.prevList(null);
    qInit.prevList(qInit);
    // ... 指标收集略
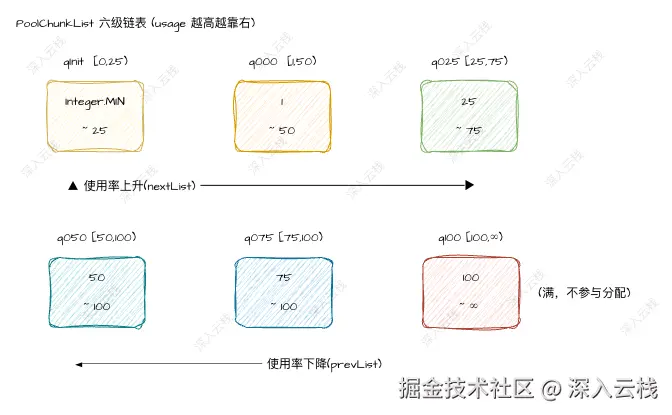
}六级链表的命名里藏着它的分档语义:q050 等名字中的数字就是该档位的 minUsage 阈值,q100 是满的 chunk、qInit 是刚创建的低使用率 chunk 的初始落脚点。它们通过 nextList(指向更高使用率档)与 prevList(指向更低使用率档)串成一条双向迁移路径,chunk 使用率变化时就在这条路径上前后移动,细节留到第六章。注意 q050 的 nextList 直接指向 q100 而跳过 q075,q075 只能在下移时被抵达。
HeapArena 与 DirectArena 的差异主要在底层内存的落地方式上,堆内存 Arena 用 byte[]、堆外内存 Arena 用 ByteBuffer;此外 HeapArena 还额外维护一个 lastDestroyedChunk 复用上一个被销毁的 chunk:
java
io.netty.buffer.PoolArena$HeapArena#newChunk

// 复用上一个被销毁的 chunk,避免反复分配 byte[] 数组
protected PoolChunk<byte[]> newChunk(int pageSize, int maxPageIdx, int pageShifts, int chunkSize) {
    PoolChunk<byte[]> chunk = lastDestroyedChunk.getAndSet(null);
    if (chunk != null) {
        assert chunk.chunkSize == chunkSize &&
                chunk.pageSize == pageSize &&
                chunk.maxPageIdx == maxPageIdx &&
                chunk.pageShifts == pageShifts;
        return chunk; // 参数总是一致,可直接复用这块已分配的数组
    }
    return new PoolChunk<byte[]>(
            this, null, null, newByteArray(chunkSize), pageSize, pageShifts, chunkSize, maxPageIdx);
}
堆外内存 Arena 则直接向 JDK 申请 ByteBuffer:
java
io.netty.buffer.PoolArena$DirectArena#newChunk

protected PoolChunk<ByteBuffer> newChunk(int pageSize, int maxPageIdx, int pageShifts, int chunkSize) {
    if (sizeClass.directMemoryCacheAlignment == 0) {
        // 无对齐要求:直接分配一块堆外连续内存
        CleanableDirectBuffer cleanableDirectBuffer = allocateDirect(chunkSize);
        ByteBuffer memory = cleanableDirectBuffer.buffer();
        return new PoolChunk<ByteBuffer>(this, cleanableDirectBuffer, memory, memory, pageSize, pageShifts,
                chunkSize, maxPageIdx);
    }
    // ... 需要对齐时,额外申请 alignment 空间后做对齐切片
}
至此五层结构的"骨架"已经搭好。理解了 Allocator 如何生产 Arena 与 ChunkList,接下来就看最底层的"规格化":SizeClasses 如何把连续的大小请求变成离散的 size class。
二、SizeClasses:内存规格生成与 O(1) 归一化索引
2.1 用三个参数生成全部规格
池化分配的前提是"规格化":把用户请求的任意字节数,向上归一到某个预定义的 size class。SizeClasses 就是负责这件事的类,它的核心常量只有三个:LOG2_QUANTUM = 4(最小规格 2^4 = 16 字节)、LOG2_SIZE_CLASS_GROUP = 2(每个倍增区间分 4 组)、LOG2_MAX_LOOKUP_SIZE = 12。
规格生成并不枚举具体数字,而是用一个公式 size = (1 << log2Group) + nDelta * (1 << log2Delta) 动态算出整张表。构造器里先"播种"第一组,再逐组往后生成,直到规格大小追上 chunkSize:
java
io.netty.buffer.SizeClasses

SizeClasses(int pageSize, int pageShifts, int chunkSize, int directMemoryCacheAlignment) {
    int group = log2(chunkSize) - LOG2_QUANTUM - LOG2_SIZE_CLASS_GROUP + 1;

    // 每条 size class 用 [index, log2Group, log2Delta, nDelta, ...] 七元组编码
    short[][] sizeClasses = new short[group << LOG2_SIZE_CLASS_GROUP][7];

    int normalMaxSize = -1;
    int nSizes = 0;
    int size = 0;

    int log2Group = LOG2_QUANTUM;
    int log2Delta = LOG2_QUANTUM;
    int ndeltaLimit = 1 << LOG2_SIZE_CLASS_GROUP;

    // 第一组(最小规格组),nDelta 从 0 起步
    for (int nDelta = 0; nDelta < ndeltaLimit; nDelta++, nSizes++) {
        short[] sizeClass = newSizeClass(nSizes, log2Group, log2Delta, nDelta, pageShifts);
        sizeClasses[nSizes] = sizeClass;
        size = sizeOf(sizeClass, directMemoryCacheAlignment);
    }

    log2Group += LOG2_SIZE_CLASS_GROUP;

    // 其余各组,nDelta 从 1 起步,直到 size 追平 chunkSize
    for (; size < chunkSize; log2Group++, log2Delta++) {
        for (int nDelta = 1; nDelta <= ndeltaLimit && size < chunkSize; nDelta++, nSizes++) {
            short[] sizeClass = newSizeClass(nSizes, log2Group, log2Delta, nDelta, pageShifts);
            sizeClasses[nSizes] = sizeClass;
            size = normalMaxSize = sizeOf(sizeClass, directMemoryCacheAlignment);
        }
    }

    // 最大 normal 规格必须正好等于 chunkSize
    assert chunkSize == normalMaxSize;

    int smallMaxSizeIdx = 0;
    int lookupMaxSize = 0;
    int nPSizes = 0;
    int nSubpages = 0;
    for (int idx = 0; idx < nSizes; idx++) {
        short[] sz = sizeClasses[idx];
        if (sz[PAGESIZE_IDX] == yes) {
            nPSizes++;                       // 页大小的整数倍
        }
        if (sz[SUBPAGE_IDX] == yes) {
            nSubpages++;                     // 属于 subpage 切分范围
            smallMaxSizeIdx = idx;           // 记录最后一个 small 规格
        }
        if (sz[LOG2_DELTA_LOOKUP_IDX] != no) {
            lookupMaxSize = sizeOf(sz, directMemoryCacheAlignment);
        }
    }
    this.smallMaxSizeIdx = smallMaxSizeIdx;
    this.lookupMaxSize = lookupMaxSize;
    this.nPSizes = nPSizes;
    this.nSubpages = nSubpages;
    this.nSizes = nSizes;
    // ... pageSize / pageShifts / chunkSize 赋值略

    // 生成三张查找表
    this.sizeIdx2sizeTab = newIdx2SizeTab(sizeClasses, nSizes, directMemoryCacheAlignment);
    this.pageIdx2sizeTab = newPageIdx2sizeTab(sizeClasses, nSizes, nPSizes, directMemoryCacheAlignment);
    this.size2idxTab = newSize2idxTab(lookupMaxSize, sizeClasses);
}理解这段的关键在几个边界索引:smallMaxSizeIdx 标记最后一个"属于 subpage 切分范围"的规格,nSizes 是规格总数------前两者划定了后文三路分发的边界:sizeIdx <= smallMaxSizeIdx 走 Small 路径、sizeIdx < nSizes 走 Normal 路径、再往后就是 Huge。nPSizes 是"页大小整数倍"规格的数量,用于 PoolChunk 的 run 队列数量与队列上界,不参与分发判定。
PoolArena.SizeClass 枚举只有 Small 与 Normal 两个值,Huge 不进规格表,而是作为"超出 chunkSize"的分支单独处理。所以严格说,内存只被分成 Small、Normal、Huge 三类,其中 Huge 不参与池化。
2.2 查找表与 O(1) 归一化
规格生成后,关键是把"请求大小 → sizeIdx"在查找表覆盖范围内做到 O(1)。SizeClasses 为此提供了两张互补的表:sizeIdx2sizeTab(sizeIdx 反查规格大小)与 size2idxTab(大小正查 sizeIdx)。后者下标直接由请求大小右移得到:
java
io.netty.buffer.SizeClasses#size2SizeIdx

@Override
public int size2SizeIdx(int size) {
    if (size == 0) {
        return 0;
    }
    if (size > chunkSize) {
        return nSizes;                       // 越界返回 nSizes,作为 Huge 的哨兵值
    }

    size = alignSizeIfNeeded(size, directMemoryCacheAlignment);

    if (size <= lookupMaxSize) {
        // 命中查找表:下标 = (size - 1) >> LOG2_QUANTUM,间隔为 16 字节
        return size2idxTab[size - 1 >> LOG2_QUANTUM];
    }

    // 超出查找表上限时,退化为对数定位 + 组内线性逼近
    int x = log2((size << 1) - 1);
    int shift = x < LOG2_SIZE_CLASS_GROUP + LOG2_QUANTUM + 1
            ? 0 : x - (LOG2_SIZE_CLASS_GROUP + LOG2_QUANTUM);

    int group = shift << LOG2_SIZE_CLASS_GROUP;

    int log2Delta = x < LOG2_SIZE_CLASS_GROUP + LOG2_QUANTUM + 1
            ? LOG2_QUANTUM : x - LOG2_SIZE_CLASS_GROUP - 1;

    int mod = size - 1 >> log2Delta & (1 << LOG2_SIZE_CLASS_GROUP) - 1;

    return group + mod;
}
size2idxTab 的间隔是 1 << LOG2_QUANTUM(16 字节),所以下标 size - 1 >> LOG2_QUANTUM 恰好把请求大小映射到数组的格子;size - 1 是为了让"刚好等于规格边界"的值也归入正确的档位。只有当请求大小超过 lookupMaxSize(查找表容量上限)时才退回对数计算,由 log2 直接定位出 sizeIdx;normalizeSize 的越界分支同样走对数公式,把大小向上取整到最近的规格边界,并不查表。
与"正查 sizeIdx"配套的还有"反查规格大小"与"向上取整"两个方法:
java
io.netty.buffer.SizeClasses#sizeIdx2size / #normalizeSize

public int sizeIdx2size(int sizeIdx) {
    return sizeIdx2sizeTab[sizeIdx];
}

public int normalizeSize(int size) {
    if (size == 0) {
        return sizeIdx2sizeTab[0];
    }
    size = alignSizeIfNeeded(size, directMemoryCacheAlignment);
    if (size <= lookupMaxSize) {
        return sizeIdx2sizeTab[size2idxTab[size - 1 >> LOG2_QUANTUM]];
    }
    return normalizeSizeCompute(size);
}
sizeIdx2size 直接查表,normalizeSize 则先正查 sizeIdx 再反查规格大小,等价于"把任意大小向上取整到最近的合法规格"。有了这套规格表,PoolArena.allocate() 就能在入口处先归一化,再按边界三路分发。
三、分配入口与三路分发:newDirectBuffer 到 PoolArena.allocate
3.1 入口:绑定线程缓存与 Arena
用户写的 allocator.buffer(...) 最终会落到 PooledByteBufAllocator 的 newHeapBuffer / newDirectBuffer 上。以堆外内存为例:
java
io.netty.buffer.PooledByteBufAllocator#newDirectBuffer

@Override
protected ByteBuf newDirectBuffer(int initialCapacity, int maxCapacity) {
    PoolThreadCache cache = threadCache.get();
    PoolArena<ByteBuffer> directArena = cache.directArena;

    final AbstractByteBuf buf;
    if (directArena != null) {
        // 线程已绑定某个 direct arena,走池化分配
        buf = directArena.allocate(cache, initialCapacity, maxCapacity);
    } else {
        // 没有可用 arena(或被禁用),退化到非池化
        buf = UnsafeByteBufUtil.newDirectByteBuf(this, initialCapacity, maxCapacity);
        onAllocateBuffer(buf, false, false);
    }
    return toLeakAwareBuffer(buf);
}
这里的第一步 threadCache.get() 就是拿到线程绑定的 PoolThreadCache,而"绑定哪个 Arena"这件事发生在 PoolThreadLocalCache.initialValue() 里。注意 PoolThreadLocalCache 继承自 FastThreadLocal,所以它天然是按线程隔离的:
java
io.netty.buffer.PooledByteBufAllocator$PoolThreadLocalCache#initialValue

@Override
protected synchronized PoolThreadCache initialValue() {
    final PoolArena<byte[]> heapArena = leastUsedArena(heapArenas);
    final PoolArena<ByteBuffer> directArena = leastUsedArena(directArenas);

    final Thread current = Thread.currentThread();
    final EventExecutor executor = ThreadExecutorMap.currentExecutor();

    if (useCacheForAllThreads ||
            // 当前是 FastThreadLocalThread,总是启用缓存
            FastThreadLocalThread.currentThreadHasFastThreadLocal() ||
            // 线程被某个 EventExecutor 使用,大概率要频繁分配
            executor != null) {
        final PoolThreadCache cache = new PoolThreadCache(
                heapArena, directArena, smallCacheSize, normalCacheSize,
                DEFAULT_MAX_CACHED_BUFFER_CAPACITY, DEFAULT_CACHE_TRIM_INTERVAL, useCacheFinalizers());
        // ... trim 调度略
        return cache;
    }
    // 不启用缓存,cache size 全置 0
    return new PoolThreadCache(heapArena, directArena, 0, 0, 0, 0, false);
}
leastUsedArena 会从 Arena 数组里挑出"当前被最少线程缓存引用"的那个(以 numThreadCaches 计数为准),这样就能让所有 Arena 的负载尽量均衡。选出 Arena 之后,真正的分配逻辑收敛到 PoolArena.allocate()。
3.2 三路分发:Small / Normal / Huge
PoolArena.allocate() 是本文的"总调度站",它的核心就是先归一化、再按 sizeIdx 三分支:
java
io.netty.buffer.PoolArena#allocate

PooledByteBuf<T> allocate(PoolThreadCache cache, int reqCapacity, int maxCapacity) {
    PooledByteBuf<T> buf = newByteBuf(maxCapacity);
    allocate(cache, buf, reqCapacity);
    return buf;
}

private void allocate(PoolThreadCache cache, PooledByteBuf<T> buf, final int reqCapacity) {
    final int sizeIdx = sizeClass.size2SizeIdx(reqCapacity);

    if (sizeIdx <= sizeClass.smallMaxSizeIdx) {
        tcacheAllocateSmall(cache, buf, reqCapacity, sizeIdx);      // Small:subpage 路径
    } else if (sizeIdx < sizeClass.nSizes) {
        tcacheAllocateNormal(cache, buf, reqCapacity, sizeIdx);     // Normal:run 路径
    } else {
        int normCapacity = sizeClass.directMemoryCacheAlignment > 0
                ? sizeClass.normalizeSize(reqCapacity) : reqCapacity;
        allocateHuge(buf, normCapacity);                            // Huge:非池化
    }
}
三路的分界正是上一章提到的 smallMaxSizeIdx 与 nSizes。先看 Small 与 Normal 两条路径(它们都优先尝试线程缓存,缓存命中细节本文作为黑盒、聚焦 Arena 层):
java
io.netty.buffer.PoolArena#tcacheAllocateSmall

private void tcacheAllocateSmall(PoolThreadCache cache, PooledByteBuf<T> buf, final int reqCapacity,
                                 final int sizeIdx) {

    if (cache.allocateSmall(this, buf, reqCapacity, sizeIdx)) {
        return;                              // 缓存命中,直接返回
    }

    // 未命中:对同规格 subpage 池头节点加锁,取头后第一个 subpage
    final PoolSubpage<T> head = smallSubpagePools[sizeIdx];
    final boolean needsNormalAllocation;
    head.lock();
    try {
        final PoolSubpage<T> s = head.next;
        needsNormalAllocation = s == head;   // 池里还没有可用 subpage
        if (!needsNormalAllocation) {
            assert s.doNotDestroy && s.elemSize == sizeClass.sizeIdx2size(sizeIdx);
            long handle = s.allocate();
            assert handle >= 0;
            s.chunk.initBufWithSubpage(buf, null, handle, reqCapacity, cache, false);
        }
    } finally {
        head.unlock();
    }

    if (needsNormalAllocation) {
        lock();
        try {
            allocateNormal(buf, reqCapacity, sizeIdx, cache);  // 池空,需要一块新 run 建 subpage
        } finally {
            unlock();
        }
    }
    incSmallAllocation();
}
java
io.netty.buffer.PoolArena#tcacheAllocateNormal

private void tcacheAllocateNormal(PoolThreadCache cache, PooledByteBuf<T> buf, final int reqCapacity,
                                  final int sizeIdx) {
    if (cache.allocateNormal(this, buf, reqCapacity, sizeIdx)) {
        return;                              // 缓存命中
    }
    lock();
    try {
        allocateNormal(buf, reqCapacity, sizeIdx, cache);      // 走六级链表分配
        ++allocationsNormal;
    } finally {
        unlock();
    }
}
两条路径的并发模型也不同:Small 路径锁的是"同规格 subpage 池"的头节点,锁粒度更细,但当头节点下没有可用 subpage 时会回退到 Arena 锁;Normal 路径锁的是整个 Arena 的 ReentrantLock。而超大的 Huge 请求则完全绕开池化,直接造一块"非池化"的 chunk:
java
io.netty.buffer.PoolArena#allocateHuge

private void allocateHuge(PooledByteBuf<T> buf, int reqCapacity) {
    PoolChunk<T> chunk = newUnpooledChunk(reqCapacity);
    PooledByteBufAllocator.onAllocateChunk(chunk, false);
    activeBytesHuge.add(chunk.chunkSize());
    buf.initUnpooled(chunk, reqCapacity);
    allocationsHuge.increment();
}
把这三路串起来,一次 directBuffer 的完整分发链路如下:
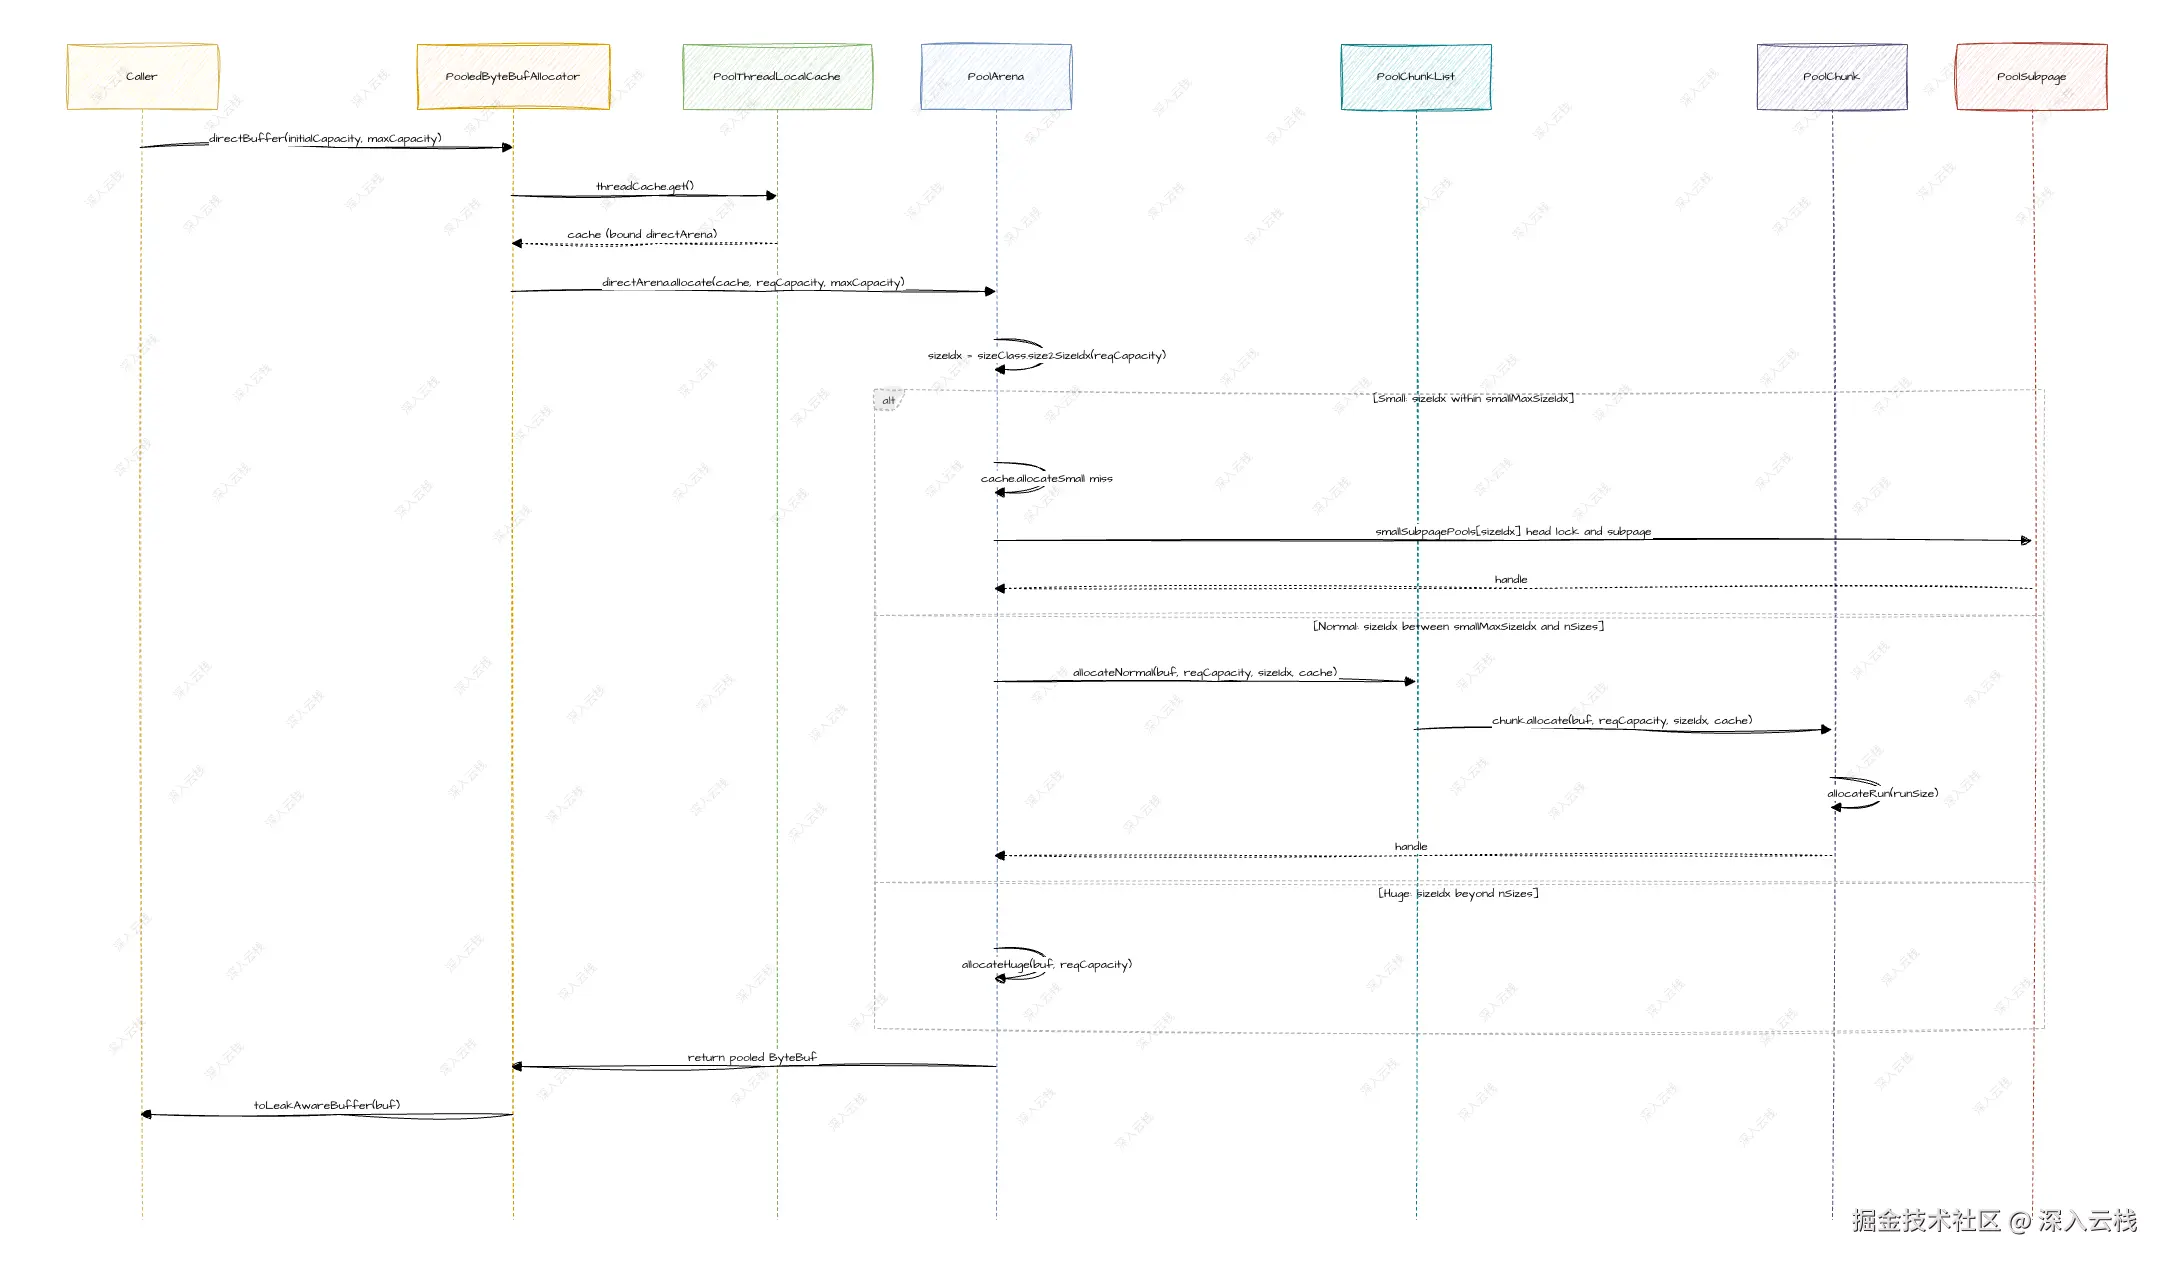
上面的时序图清楚地展示了三个层次的分工:入口层负责线程到 Arena 的绑定,allocate 层负责按 sizeIdx 切分,真正"动手"分内存的则是 PoolChunk.allocate()。接下来的第四、五章就分别深入 run 分配与 subpage 切分这两个动作。
四、PoolChunk 的 run-based 分配:handle 位图与 runsAvail 优先队列
4.1 handle 位图与内部结构
PoolChunk 是池化分配器的"心脏",一块 chunk 就是一次从 JVM 或内核申领的连续内存。PoolChunk 采用 run-based 分配:所谓 run,就是一块"连续若干页"的内存段;分配时从空闲 run 中找一块够大的,回收时再把相邻的空闲 run 合并起来。
这套算法最核心的抽象是一个 64 位的 handle,它把"一块内存"的全部元信息压缩进一个 long:
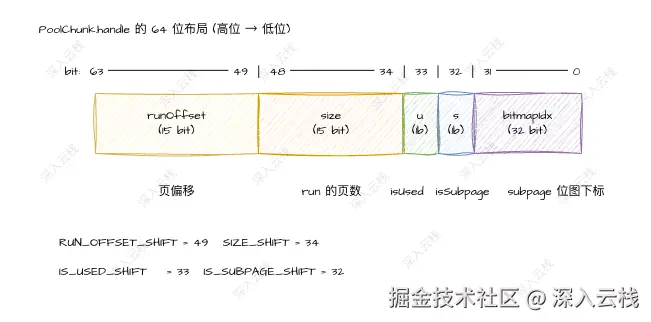
runOffset 表示这段 run 在 chunk 内的起始页偏移,size 表示 run 占用的页数,两者各占 15 位;isUsed 与 isSubpage 各占 1 位;最低的 32 位只有当 isSubpage 为真时才有意义,用来存 subpage 的位图下标。对应这几个位段的位移常量与字段声明如下:
java
io.netty.buffer.PoolChunk

final class PoolChunk<T> implements PoolChunkMetric, ChunkInfo {
    private static final int SIZE_BIT_LENGTH = 15;
    private static final int INUSED_BIT_LENGTH = 1;
    private static final int SUBPAGE_BIT_LENGTH = 1;
    private static final int BITMAP_IDX_BIT_LENGTH = 32;

    static final int IS_SUBPAGE_SHIFT = BITMAP_IDX_BIT_LENGTH;
    static final int IS_USED_SHIFT = SUBPAGE_BIT_LENGTH + IS_SUBPAGE_SHIFT;
    static final int SIZE_SHIFT = INUSED_BIT_LENGTH + IS_USED_SHIFT;
    static final int RUN_OFFSET_SHIFT = SIZE_BIT_LENGTH + SIZE_SHIFT;

    final PoolArena<T> arena;
    final Object base;
    final T memory;
    final boolean unpooled;

    // 存储每个空闲 run 的首/末页偏移,key=页偏移, value=handle
    private final LongLongHashMap runsAvailMap;

    // 按 run 页数分桶的优先队列数组,队内按页偏移升序
    private final IntPriorityQueue[] runsAvail;

    private final ReentrantLock runsAvailLock;

    // 管理本 chunk 内所有 subpage
    private final PoolSubpage<T>[] subpages;

    // 正在被 ByteBuf 占用的内存统计(可关闭)
    private final LongAdder pinnedBytes;

    final int pageSize;
    final int pageShifts;
    final int chunkSize;
    final int maxPageIdx;

    // 缓存从 memory 派生的 ByteBuffer 包装,减少 GC
    private final Deque<ByteBuffer> cachedNioBuffers;

    int freeBytes;

    PoolChunkList<T> parent;
    PoolChunk<T> prev;
    PoolChunk<T> next;
    // ...
}
两个配合 handle 的核心结构是 runsAvailMap 与 runsAvail。前者是一个 LongLongHashMap,页数大于 1 时把首页与末页偏移都映射为 handle,单页 run 只登记首页,用于回收时 O(1) 探测相邻 run 是否也空闲;后者是一个 IntPriorityQueue[],下标是 run 页数对应的 pageIdx,队内按页偏移升序排列。构造器初始化时,把整块 chunk 当成一个"从 0 起、占满全部页"的大 run 塞进去:
java
io.netty.buffer.PoolChunk

PoolChunk(PoolArena<T> arena, CleanableDirectBuffer cleanable, Object base, T memory, int pageSize, int pageShifts,
          int chunkSize, int maxPageIdx) {
    unpooled = false;
    this.arena = arena;
    this.cleanable = cleanable;
    this.base = base;
    this.memory = memory;
    this.pageSize = pageSize;
    this.pageShifts = pageShifts;
    this.chunkSize = chunkSize;
    this.maxPageIdx = maxPageIdx;
    freeBytes = chunkSize;

    runsAvail = newRunsAvailqueueArray(maxPageIdx);
    runsAvailLock = new ReentrantLock();
    runsAvailMap = new LongLongHashMap(-1);
    subpages = new PoolSubpage[chunkSize >> pageShifts];

    // 插入初始 run:offset = 0,页数 = chunkSize / pageSize
    int pages = chunkSize >> pageShifts;
    long initHandle = (long) pages << SIZE_SHIFT;
    insertAvailRun(0, pages, initHandle);

    cachedNioBuffers = new ArrayDeque<>(8);
    this.pinnedBytes = trackPinnedMemory ? new LongAdder() : null;
}
4.2 allocateRun:最小偏移优先的 run 分配
分配入口 allocate() 先按 sizeIdx 判断是走 subpage 还是直接走 run。Normal 请求的 runSize 一定是页大小的整数倍,所以直接 allocateRun:
java
io.netty.buffer.PoolChunk#allocate

boolean allocate(PooledByteBuf<T> buf, int reqCapacity, int sizeIdx, PoolThreadCache cache) {
    final long handle;
    if (sizeIdx <= arena.sizeClass.smallMaxSizeIdx) {
        // small:走到 subpage 池(详见第五章)
        PoolSubpage<T> head = arena.smallSubpagePools[sizeIdx];
        head.lock();
        try {
            PoolSubpage<T> nextSub = head.next;
            if (nextSub != head) {
                handle = nextSub.allocate();
                nextSub.chunk.initBufWithSubpage(buf, null, handle, reqCapacity, cache, false);
                return true;
            }
            handle = allocateSubpage(sizeIdx, head);
            if (handle < 0) {
                return false;
            }
        } finally {
            head.unlock();
        }
    } else {
        // normal:runSize 必须是 pageSize 的整数倍
        int runSize = arena.sizeClass.sizeIdx2size(sizeIdx);
        handle = allocateRun(runSize);
        if (handle < 0) {
            return false;
        }
    }

    ByteBuffer nioBuffer = cachedNioBuffers != null? cachedNioBuffers.pollLast() : null;
    initBuf(buf, nioBuffer, handle, reqCapacity, cache, false);
    return true;
}
allocateRun 的逻辑可以拆成三步:找队列、取最小偏移 run、切分多余页。三步都在 runsAvailLock 锁内完成:
java
io.netty.buffer.PoolChunk#allocateRun

private long allocateRun(int runSize) {
    int pages = runSize >> pageShifts;
    int pageIdx = arena.sizeClass.pages2pageIdx(pages);

    runsAvailLock.lock();
    try {
        // 找到第一个"有足够大 run"的队列
        int queueIdx = runFirstBestFit(pageIdx);
        if (queueIdx == -1) {
            return -1;
        }

        // 取该队列中页偏移最小的 run
        IntPriorityQueue queue = runsAvail[queueIdx];
        long handle = queue.poll();
        handle <<= BITMAP_IDX_BIT_LENGTH;
        assert !isUsed(handle) : "invalid handle: " + handle;

        removeAvailRun0(handle);

        // 若 run 页数超过需求,切出尾段空闲页
        handle = splitLargeRun(handle, pages);

        int pinnedSize = runSize(pageShifts, handle);
        freeBytes -= pinnedSize;
        return handle;
    } finally {
        runsAvailLock.unlock();
    }
}
runFirstBestFit 是"从需求页数往上找到第一个非空队列"的近似 best-fit:首次分配时 freeBytes == chunkSize,直接返回最大的 nPSizes - 1 队列(此时整块还是那个初始大 run);否则从 pageIdx 一路往上扫:
java
io.netty.buffer.PoolChunk#runFirstBestFit

private int runFirstBestFit(int pageIdx) {
    if (freeBytes == chunkSize) {
        return arena.sizeClass.nPSizes - 1;      // 尚未切分,整个 chunk 就是最大 run
    }
    for (int i = pageIdx; i < arena.sizeClass.nPSizes; i++) {
        IntPriorityQueue queue = runsAvail[i];
        if (queue != null && !queue.isEmpty()) {
            return i;
        }
    }
    return -1;
}
splitLargeRun 处理"run 比需求大"的情况:把 runOffset + needPages 起、共 remPages 页的尾段构造成一个新的空闲 run 存回去,前半段标记 isUsed 返回。这是避免大 run 被小请求整块占用的关键,真正抑制外部碎片的是回收阶段 collapsePast / collapseNext 的相邻 run 合并:
java
io.netty.buffer.PoolChunk#splitLargeRun

private long splitLargeRun(long handle, int needPages) {
    assert needPages > 0;

    int totalPages = runPages(handle);
    assert needPages <= totalPages;

    int remPages = totalPages - needPages;

    if (remPages > 0) {
        int runOffset = runOffset(handle);

        // 保留尾段未用页,供后续分配使用
        int availOffset = runOffset + needPages;
        long availRun = toRunHandle(availOffset, remPages, 0);
        insertAvailRun(availOffset, remPages, availRun);

        // 前半段标记为已用
        return toRunHandle(runOffset, needPages, 1);
    }

    // 正好用完,直接置 isUsed 位
    handle |= 1L << IS_USED_SHIFT;
    return handle;
}
insertAvailRun 同时维护 runsAvail 队列与 runsAvailMap 两个结构:页数大于 1 时登记 run 的首页与末页,单页 run 只登记首页,这正是第七章回收时能 O(1) 判定相邻 run 是否空闲的基础。把整条分配链路串起来:
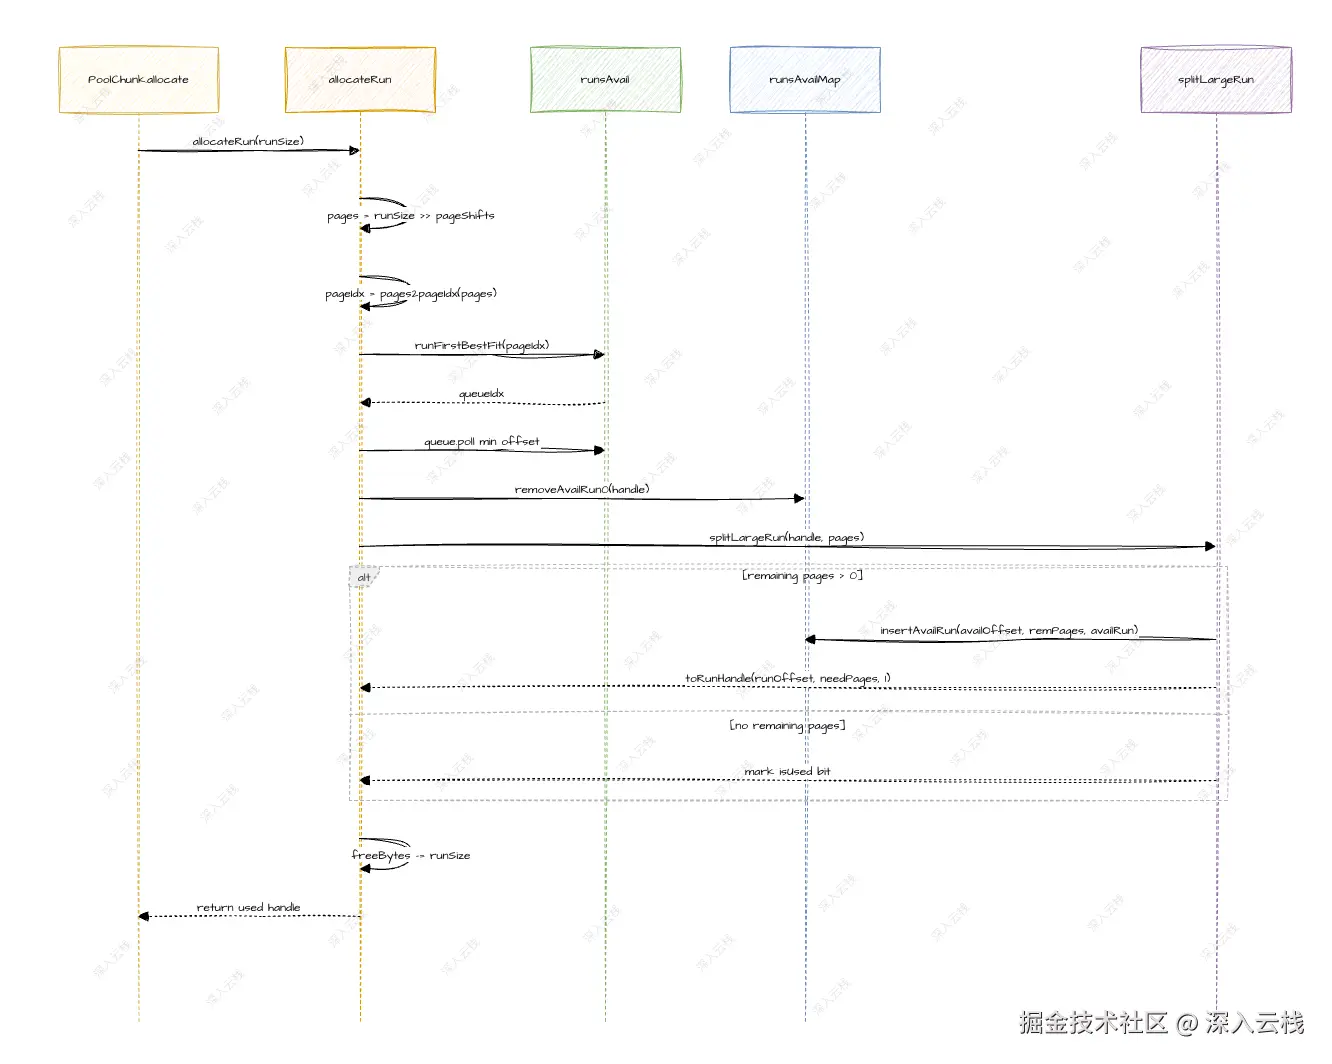
以上就是 Normal 请求的完整分配路径。而对于小于一页的小请求,PoolChunk 不会拿整个 run 去伺候它,而是先切出一段 run、再交给 PoolSubpage 用位图细分成小块,这正是下一章的内容。
五、PoolSubpage 的位图管理:bitmap、doNotDestroy 与 subpage 池
5.1 位图与分配
PoolSubpage 解决的是"小对象也吃一整个 run"的浪费:它把 run 里的一整段页再切成 elemSize 大小的等长小块,每个小块用 bitmap 里的一个 bit 记录是否被占用。构造器里初始化位图容量并把自己挂进所属规格的 subpage 池:
java
io.netty.buffer.PoolSubpage

PoolSubpage(PoolSubpage<T> head, PoolChunk<T> chunk, int pageShifts, int runOffset, int runSize, int elemSize) {
    this.headIndex = head.headIndex;
    this.chunk = chunk;
    this.pageShifts = pageShifts;
    this.runOffset = runOffset;
    this.runSize = runSize;
    this.elemSize = elemSize;

    doNotDestroy = true;

    // 可容纳的最大元素数 = runSize / elemSize
    maxNumElems = numAvail = runSize / elemSize;
    int bitmapLength = maxNumElems >>> 6;
    if ((maxNumElems & 63) != 0) {
        bitmapLength ++;
    }
    this.bitmapLength = bitmapLength;
    bitmap = new long[bitmapLength];          // 每个 long 有 64 个 bit,对应 64 个小块
    nextAvail = 0;

    lock = null;
    addToPool(head);                          // 挂进同规格 subpage 池
}
long[] 里每个 long 有 64 位,所以 bitmapLength = ceil(maxNumElems / 64)。分配一个元素就是"找到第一个 0 位并置 1":
java
io.netty.buffer.PoolSubpage#allocate

long allocate() {
    if (numAvail == 0 || !doNotDestroy) {
        return -1;
    }

    final int bitmapIdx = getNextAvail();     // bitmapIdx < 0 的异常保护已省略
    int q = bitmapIdx >>> 6;                  // 定位到第几个 long
    int r = bitmapIdx & 63;                   // 定位到 long 内的第几位
    assert (bitmap[q] >>> r & 1) == 0;
    bitmap[q] |= 1L << r;                     // 置位,标记小块已占用

    if (-- numAvail == 0) {
        removeFromPool();                     // 全满,从池中摘除,避免下次空查
    }

    return toHandle(bitmapIdx);
}
getNextAvail 有个巧妙的加速:它先用 nextAvail 缓存"最近被释放的那个位",如果能直接命中就省去线性扫描;否则才退化为 findNextAvail 逐 long 找 0 位。这个缓存位来自释放路径,使得"释放后紧跟着再分配"这种高频场景几乎不用扫描。
5.2 doNotDestroy 与回收
free 是 allocate 的逆操作,置位改为清位,并把 nextAvail 指向这个刚释放的下标。真正精巧的是后半段:当 subpage 被完全清空、且池里还有别的同类 subpage 时,把它摘除并置 doNotDestroy = false,这样整段 run 就能被回收:
java
io.netty.buffer.PoolSubpage#free

boolean free(PoolSubpage<T> head, int bitmapIdx) {
    int q = bitmapIdx >>> 6;
    int r = bitmapIdx & 63;
    bitmap[q] ^= 1L << r;                     // 清位

    setNextAvail(bitmapIdx);                  // 缓存下一次分配的候选位

    if (numAvail ++ == 0) {
        addToPool(head);                      // 从"已摘除"状态回到池中

        // 元素数只有 1 时的边界:回收后仍是满池,需特殊返回
        if (maxNumElems > 1) {
            return true;
        }
    }

    if (numAvail != maxNumElems) {
        return true;                          // 仍在使用中
    } else {
        // 整块 subpage 已空
        if (prev == next) {
            // 池里只剩这一个 subpage,保留它避免反复建销
            return true;
        }
        // 池里还有其他 subpage,摘除本块,允许整个 run 被回收
        doNotDestroy = false;
        removeFromPool();
        return false;
    }
}
doNotDestroy 字段的设计意图在这里呼之欲出:它保证同类 subpage 池里至少保留一个"空壳",避免频繁地创建和销毁 subpage 对象 。只有 free 返回 false(整个 subpage 被清空且池里还有其他可用块)时,上层才会进一步回收这段 run。
那么一个 run 什么时候会变成 subpage 呢?答案是 PoolChunk.allocateSubpage。它先算出需要多大的 run、再 allocateRun 出一段、最后建 subpage 并从中分配:
java
io.netty.buffer.PoolChunk#allocateSubpage

private long allocateSubpage(int sizeIdx, PoolSubpage<T> head) {
    // 计算既能整除 elemSize、又是 pageSize 倍数的 run 大小
    int runSize = calculateRunSize(sizeIdx);
    long runHandle = allocateRun(runSize);
    if (runHandle < 0) {
        return -1;
    }

    int runOffset = runOffset(runHandle);
    int elemSize = arena.sizeClass.sizeIdx2size(sizeIdx);

    PoolSubpage<T> subpage = new PoolSubpage<T>(head, this, pageShifts, runOffset,
            runSize(pageShifts, runHandle), elemSize);

    subpages[runOffset] = subpage;
    return subpage.allocate();
}
calculateRunSize 做的事并不直观:给定 elemSize,它要找一个"既是 pageSize 倍数、又恰好能被 elemSize 整除"的最小 run 大小,否则位图切分时会留下没法整除的残角。它从一页起步往上加页,直到 runSize 被 elemSize 整除,同时还受 maxElements(单个 subpage 位图元素上限)约束,一旦超过上限还会回退减页再重算。这一整套"run 供给 + bitmap 切分"的组合,就是 small 请求的高效归宿。
5.3 subpage 池的链表结构
PoolSubpage 之间用 prev / next 串成双向链表,PoolArena.smallSubpagePools[sizeIdx] 是一个哨兵头节点,形成"头 → 实体 → 头"的环。命中已有 subpage 时,分配与释放都只对这个头节点加锁,用更细粒度的锁替代整 Arena 锁;没有可用 subpage 时则回退到 Arena 锁:
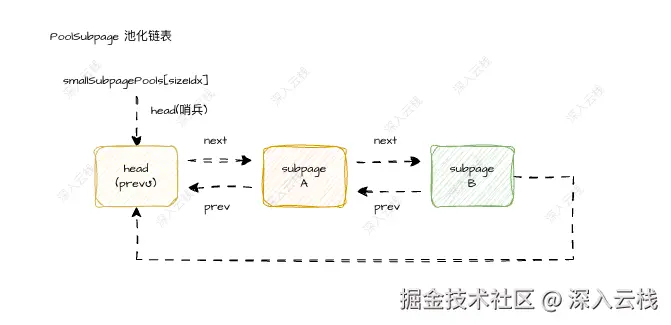
到这里,Chunk 内部"大块用 run、小块用 subpage"的两级切分已经讲完。还剩最后一环:这么多 chunk 放在哪里、用完后如何按使用率流转,这正是 PoolChunkList 的职责。
六、PoolChunkList 的六级链表:使用率分档与 chunk 迁移
6.1 分档与阈值
PoolChunkList 本身是一条 chunk 双向链表,但它的 minUsage / maxUsage 把"使用率"这个概念量化成了档位。回顾第一章的构造:qInit 是 [0,25)、q000 是 [1,50)、q025 是 [25,75)、q050 是 [50,100)、q075 是 [75,100)、q100 是 [100,∞)。
使用率这个百分比不好直接和 chunk 的 freeBytes 比较,于是构造器把百分比阈值预先换算成 freeBytes 的绝对阈值:
java
io.netty.buffer.PoolChunkList

PoolChunkList(PoolArena<T> arena, PoolChunkList<T> nextList, int minUsage, int maxUsage, int chunkSize) {
    assert minUsage <= maxUsage;
    this.arena = arena;
    this.nextList = nextList;
    this.minUsage = minUsage;
    this.maxUsage = maxUsage;
    maxCapacity = calculateMaxCapacity(minUsage, chunkSize);

    // 阈值与 PoolChunk.usage() 的对齐:usage() = 100 - freeBytes * 100L / chunkSize
    // 例如 (usage() >= maxUsage) 可换算为 freeBytes <= chunkSize * (100 - maxUsage) / 100
    // 由于 usage() 向下取整,绝对阈值需要做一次取整步进的 +0.99999999 补偿
    freeMinThreshold = (maxUsage == 100) ? 0 : (int) (chunkSize * (100.0 - maxUsage + 0.99999999) / 100L);
    freeMaxThreshold = (minUsage == 100) ? 0 : (int) (chunkSize * (100.0 - minUsage + 0.99999999) / 100L);
}
calculateMaxCapacity 还有一个隐藏用途:本档 chunk 的"可分配最大容量"等于 chunkSize * (100 - minUsage) / 100,分配时先拿它做快速剪枝:如果请求的规格比本档理论上能挤出的最大容量还大,直接返回 false,跳到下一档。
6.2 分配与迁移
分配时沿本档的 chunk 链表逐个尝试,成功后就检查要不要把 chunk"上移"到使用率更高的一档:
java
io.netty.buffer.PoolChunkList#allocate

boolean allocate(PooledByteBuf<T> buf, int reqCapacity, int sizeIdx, PoolThreadCache threadCache) {
    int normCapacity = arena.sizeClass.sizeIdx2size(sizeIdx);
    if (normCapacity > maxCapacity) {
        // 本档容不下该规格,直接放弃
        return false;
    }

    for (PoolChunk<T> cur = head; cur != null; cur = cur.next) {
        if (cur.allocate(buf, reqCapacity, sizeIdx, threadCache)) {
            if (cur.freeBytes <= freeMinThreshold) {
                remove(cur);                  // 使用率升到上界,上移到更高使用率档
                nextList.add(cur);
            }
            return true;
        }
    }
    return false;
}
释放时则反向下移,chunk 的使用率跌破本档下界,就把它往"更低使用率"的 prevList 方向挪:
java
io.netty.buffer.PoolChunkList#free / #move0

boolean free(PoolChunk<T> chunk, long handle, int normCapacity, ByteBuffer nioBuffer) {
    chunk.free(handle, normCapacity, nioBuffer);
    if (chunk.freeBytes > freeMaxThreshold) {
        remove(chunk);
        return move0(chunk);                  // 使用率跌破下界,向下迁移
    }
    return true;
}

private boolean move0(PoolChunk<T> chunk) {
    if (prevList == null) {
        // 已经是最低档之前,usage == 0,可销毁归零
        assert chunk.usage() == 0;
        return false;                          // 返回 false 触发上层销毁该 chunk
    }
    return prevList.move(chunk);               // 递归交给更低使用率档处理
}
move0 追到 prevList == null(即 q000.prevList 为 null)时返回 false,这个 false 会一路传导到 PoolArena.freeChunk,最终触发对空 chunk 的销毁。qInit 的 minUsage 是 Integer.MIN_VALUE,换算出的 freeMaxThreshold 会饱和到 Integer.MAX_VALUE,因此 qInit 里的 chunk 不会向下迁移,它的 prevList 自指实际上不会被走到。DirectArena 的销毁通过 cleanable.clean() 立即归还堆外内存;HeapArena 则释放引用交给 GC,并额外保留一个 chunk 供下次复用。
而 PoolArena.allocateNormal 中六级链表的查找顺序是 q050 → q025 → q000 → qInit → q075。这个顺序没有把 q100 与 q075 放进常规查找:q100 已满、没有分配价值,q075 只在 chunk 从 q100 下移时才会进入。优先命中"中等使用率"的 chunk,可以让空闲页尽量集中、减少碎片,也避免每次分配都去新建 chunk。
七、回收路径:PoolChunk.free 的 run 合并算法
7.1 回收入口
PooledByteBuf 引用计数归零触发释放时,会一路走到 PoolArena.free。它先判断 chunk 是不是"非池化"的(Huge 直接销毁),否则优先尝试把内存写回线程缓存,缓存放不下才真正执行 freeChunk:
java
io.netty.buffer.PoolArena#free

void free(PoolChunk<T> chunk, ByteBuffer nioBuffer, long handle, int normCapacity, PoolThreadCache cache) {
    chunk.decrementPinnedMemory(normCapacity);
    if (chunk.unpooled) {
        // Huge 分配不走池化,直接销毁
        int size = chunk.chunkSize();
        destroyChunk(chunk);
        activeBytesHuge.add(-size);
        deallocationsHuge.increment();
    } else {
        SizeClass sizeClass = sizeClass(handle);
        if (cache != null && cache.add(this, chunk, nioBuffer, handle, normCapacity, sizeClass)) {
            // 写回线程缓存成功,暂不真正释放
            return;
        }
        freeChunk(chunk, handle, normCapacity, sizeClass, nioBuffer, false);
    }
}
freeChunk 则持 Arena 锁,调用 chunk.parent.free(...) 并据其返回值决定是否销毁 chunk:
java
io.netty.buffer.PoolArena#freeChunk

void freeChunk(PoolChunk<T> chunk, long handle, int normCapacity, SizeClass sizeClass, ByteBuffer nioBuffer,
               boolean finalizer) {
    final boolean destroyChunk;
    lock();
    try {
        if (!finalizer) {
            switch (sizeClass) {
                case Normal:
                    ++deallocationsNormal;
                    break;
                case Small:
                    ++deallocationsSmall;
                    break;
                default:
                    throw new Error("Unexpected size class: " + sizeClass);
            }
        }
        // parent 即 chunk 所属的 PoolChunkList,返回 false 表示 chunk 已空可销毁
        destroyChunk = !chunk.parent.free(chunk, handle, normCapacity, nioBuffer);
        if (destroyChunk) {
            ++pooledChunkDeallocations;
        }
    } finally {
        unlock();
    }
    if (destroyChunk) {
        destroyChunk(chunk);                  // 锁外销毁,回收内存
    }
}
7.2 连续 run 的合并
真正还内存给 chunk 的动作在 PoolChunk.free。它先处理 subpage 情况(还回 bit 位,若整个 subpage 被清空则该段 run 可回收),再进入 run 的合并回收:
java
io.netty.buffer.PoolChunk#free

void free(long handle, int normCapacity, ByteBuffer nioBuffer) {
    if (isSubpage(handle)) {
        int sIdx = runOffset(handle);
        PoolSubpage<T> subpage = subpages[sIdx];
        PoolSubpage<T> head = subpage.chunk.arena.smallSubpagePools[subpage.headIndex];
        head.lock();
        try {
            if (subpage.free(head, bitmapIdx(handle))) {
                return;                       // subpage 仍在使用,到此为止
            }
            subpages[sIdx] = null;            // 整个 subpage 已空,run 可回收
        } finally {
            head.unlock();
        }
    }

    int runSize = runSize(pageShifts, handle);
    runsAvailLock.lock();
    try {
        // 先向左/右合并相邻空闲 run
        long finalRun = collapseRuns(handle);

        // 清 isUsed / isSubpage 位,恢复为纯 run
        finalRun &= ~(1L << IS_USED_SHIFT);
        finalRun &= ~(1L << IS_SUBPAGE_SHIFT);

        insertAvailRun(runOffset(finalRun), runPages(finalRun), finalRun);
        freeBytes += runSize;
    } finally {
        runsAvailLock.unlock();
    }
    // 缓存 ByteBuffer 包装,减少下次分配的 GC
    if (nioBuffer != null && cachedNioBuffers != null &&
        cachedNioBuffers.size() < PooledByteBufAllocator.DEFAULT_MAX_CACHED_BYTEBUFFERS_PER_CHUNK) {
        cachedNioBuffers.offer(nioBuffer);
    }
}
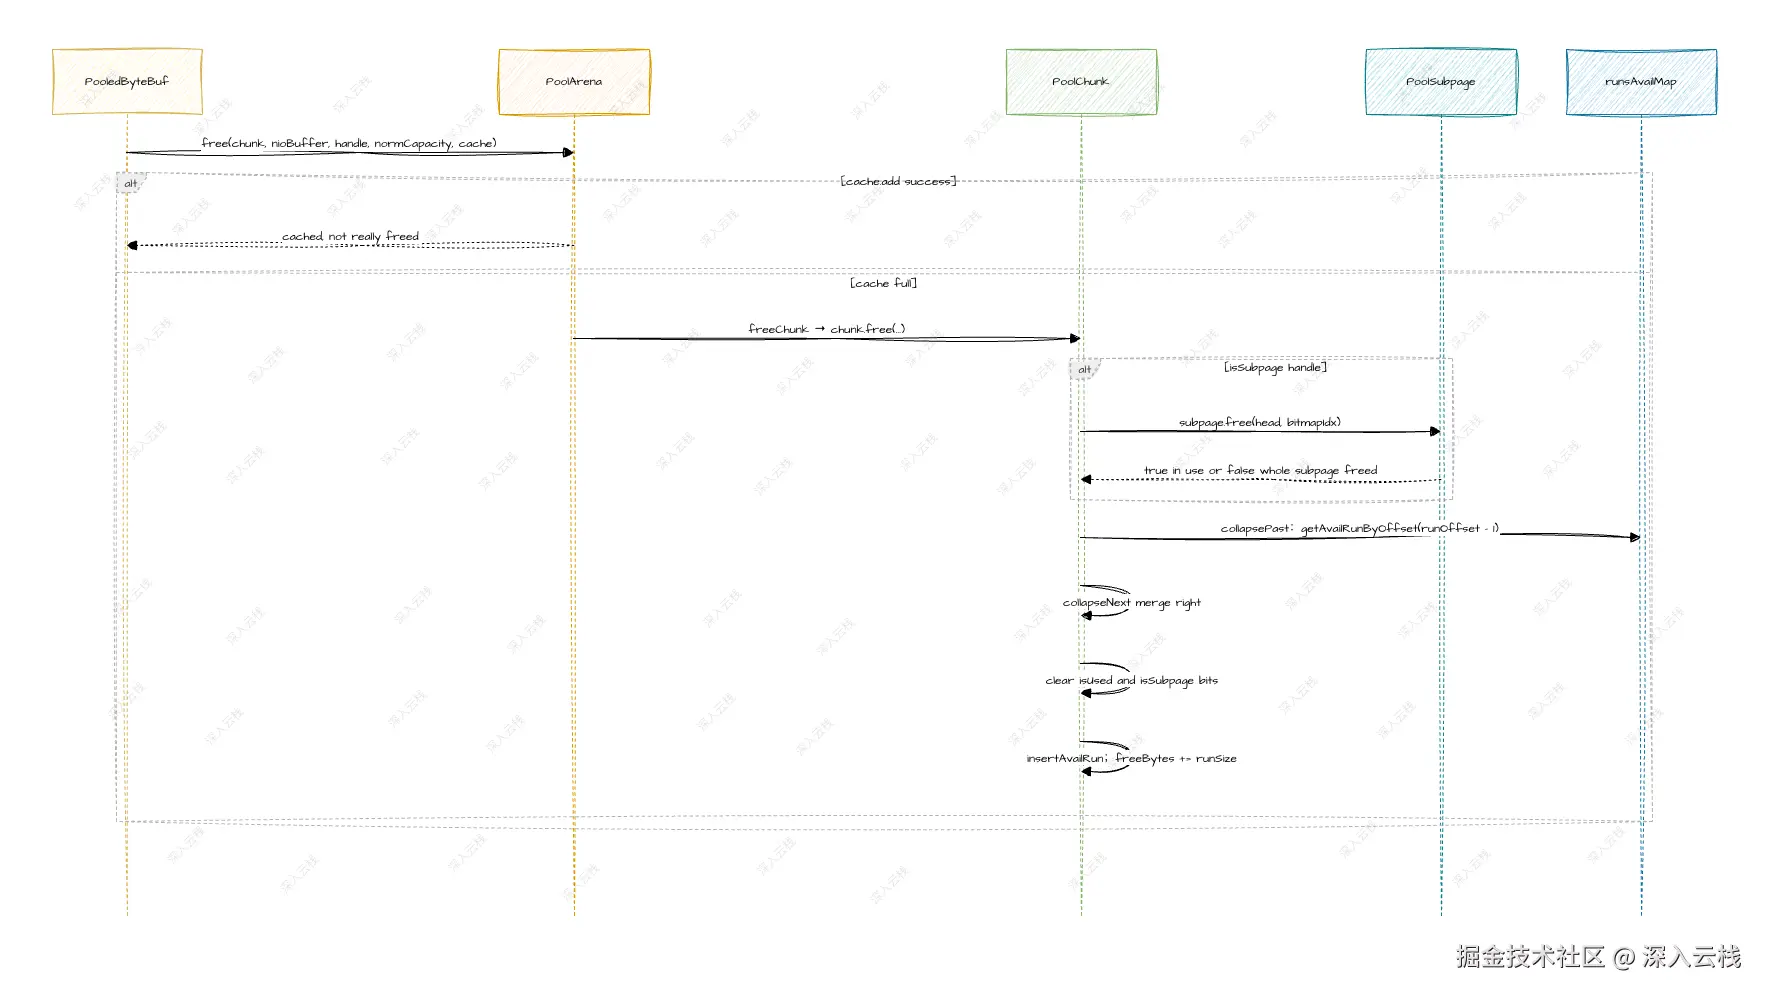
合并的精髓在 collapseRuns,它分成"向左合并 collapsePast"与"向右合并 collapseNext"两步。以向左合并为例,它靠 runsAvailMap 里只登记了"空闲 run 首末页"这个事实,用 getAvailRunByOffset(runOffset - 1) 就能 O(1) 判断左边紧邻的页是否属于一个空闲 run:
java
io.netty.buffer.PoolChunk#collapsePast / #collapseNext

private long collapsePast(long handle) {
    for (;;) {
        int runOffset = runOffset(handle);
        int runPages = runPages(handle);

        long pastRun = getAvailRunByOffset(runOffset - 1);
        if (pastRun == -1) {
            return handle;                    // 左边没有空闲 run 了
        }

        int pastOffset = runOffset(pastRun);
        int pastPages = runPages(pastRun);

        // 相邻(前一个 run 的末页紧贴本 run 的首页)则合并
        if (pastRun != handle && pastOffset + pastPages == runOffset) {
            removeAvailRun(pastRun);
            handle = toRunHandle(pastOffset, pastPages + runPages, 0);
        } else {
            return handle;
        }
    }
}

private long collapseNext(long handle) {
    for (;;) {
        int runOffset = runOffset(handle);
        int runPages = runPages(handle);

        long nextRun = getAvailRunByOffset(runOffset + runPages);
        if (nextRun == -1) {
            return handle;
        }

        int nextOffset = runOffset(nextRun);
        int nextPages = runPages(nextRun);

        if (nextRun != handle && runOffset + runPages == nextOffset) {
            removeAvailRun(nextRun);
            handle = toRunHandle(runOffset, runPages + nextPages, 0);
        } else {
            return handle;
        }
    }
}
合并成一个更大的连续 run 后,再 insertAvailRun 存回 runsAvailMap 与 runsAvail。这种"释放即合并"的策略,让 chunk 内部的空闲页尽量保持连续,为后续大块分配留出空间,是 run-based 算法相较于固定分块的一大优势。整条回收链路整理如下:
八、整体链路串联
把前七章的内容串起来,一次池化分配的完整闭环是这样的:directBuffer() 先经 PoolThreadLocalCache.get() 绑定到线程的 Arena,allocator.allocate() 用 size2SizeIdx 把请求大小归一化,随后按 sizeIdx 三路分发:Small 走 subpage 池、Normal 走六级链表加 allocateRun、Huge 走 newUnpooledChunk。回收时,subpage 先还回 small 池,run 经 collapsePast / collapseNext 合并成连续段,chunk 再根据 freeBytes 在六级链表间下移,最空的 chunk 最终被销毁、内存归还。
这一路贯穿了三条并行主线:规格线(SizeClasses 把连续大小离散为 size class)、载体线(PoolChunk 的 run 分配与 PoolSubpage 的位图切分)、路由线(PoolChunkList 六级链表与 smallSubpagePools 头节点)。三者的分工与并发策略可以对照如下:
| 层次 | 数据结构 | 分配粒度 | 并发控制 | 回收要点 |
|---|---|---|---|---|
| PooledByteBufAllocator | arena 数组 + 线程缓存 | 按线程绑定 Arena | FastThreadLocal | 缓存 trim |
| PoolArena | 六级 ChunkList + subpage 池 | sizeIdx 路由 | ReentrantLock / subpage 头锁 | freeChunk |
| PoolChunkList | chunk 双向链表 + 使用率阈值 | chunk 档位 | Arena 锁 | 按 freeBytes 上下迁移 |
| PoolChunk | runsAvailMap + 优先队列 | run(页段) | runsAvailLock | collapse 合并 |
| PoolSubpage | bitmap 位图 | elemSize 小块 | head 锁 | doNotDestroy 防抖 |
如果要用一句话凝练 Netty 池化内存分配的设计思想,那就是**"规格归一化 + 多级缓存 + run 切分 + 位图复用"**:SizeClasses 用 size2idxTab 为 lookupMaxSize 以内的大小提供 O(1) 归一化,超出部分退回对数定位,PoolChunk 用 run 优先队列按"最小偏移"分配、回收时合并相邻空闲 run,PoolSubpage 用 bitmap 位图与 doNotDestroy 抵抗小块的高频建销,PoolChunkList 用六级使用率链表在"避免碎片"与"及时回收"之间取得平衡。这套自上而下的分层设计,正是 Netty 能在高并发网络场景下保持内存低抖动、低碎片的根基。
全文小结
本文聚焦 Netty 池化内存分配器的核心架构,从层次结构与分配算法两个维度,深入分析了 PooledByteBufAllocator 的默认参数、SizeClasses 的规格归一化、PoolArena 的三路分发、PoolChunk 的 run-based 分配、PoolSubpage 的位图管理以及 PoolChunkList 的使用率迁移。
在架构层面,PooledByteBufAllocator 以 pageSize = 8KB、maxOrder = 9、chunkSize = 4 MiB 为默认值,Arena 数量取 min(2 * availableProcessors, maxMemory / chunkSize / 2 / 3),并把 HeapArena(byte[])与 DirectArena(ByteBuffer)纳入统一的五层结构。在规格层面,SizeClasses 用 log2Group / log2Delta / nDelta 生成全部规格,size2idxTab 为查找表覆盖范围内的请求大小提供 O(1) 归一化,SizeClass 只有 Small 与 Normal 两值、Huge 作为越界分支。在分发层面,allocate 按 sizeIdx 三路分流,Small 走 subpage 池、Normal 走六级链表、越界走 allocateHuge。在 run 分配层面,PoolChunk 以 64 位 handle 编码 runOffset/size/isUsed/isSubpage/bitmapIdx,用 runsAvail 优先队列按最小偏移分配并 splitLargeRun 切分尾段。在 subpage 层面,PoolSubpage 用 bitmap 位图管理小块、nextAvail 缓存候选位、doNotDestroy 防止频繁建销。在迁移层面,PoolChunkList 以 freeMinThreshold / freeMaxThreshold 把使用率换算为 freeBytes 阈值,驱动 chunk 在 qInit 至 q100 之间上移或下移。在回收层面,PoolChunk.free 先还 subpage 再经 collapsePast / collapseNext 合并相邻空闲 run,最终空 chunk 被销毁释放内存。
原创不易,如果本文对您有帮助,带来了些许灵感或启发,烦请动动小手点赞、关注、转发、收藏。这是作者持续更新的动力源泉,衷心感谢您的支持。我会尽量在工作之余,为大家带来更高品质的内容,努力保持周更。