我把 HAMi 摆回一台双卡机器上跑了一遍:GPU 编排的性能账,到底记在谁头上
作 者:吴佳浩Alben
撰稿时间:2026.11.18
引言:
上一篇写 Run:ai 开源的时候,很多筒子都在问一个问题:GPU 编排到底值不值?
这个问题其实不好回答。
光看架构图,看不出来;光讲原理,也说服不了人。
更重要的是,这两年国产算力越来越多,企业机房里已经很难做到只有一种 GPU。从 NVIDIA,到昇腾、寒武纪、摩尔线程、壁仞、沐曦、海光......异构已经不是未来,而是很多企业的现状。
**HAMi 恰好就是国内目前最成熟的开源 GPU 编排项目之一,也是少数一开始就把多厂商异构支持作为核心目标来设计的方案。**它的意义已经不仅仅是给 NVIDIA 做 GPU Sharing,而是希望让不同厂商的 GPU 能在 Kubernetes 里使用统一的资源模型和调度方式。
所以这次我没有继续分析,而是把一台双卡机器腾空,把 HAMi 装起来,把八个真实业务搬进去重新跑了一遍。
结果和我原来想的不太一样。
🔸 一、先说结论
先把三件事摆在前面:
- 性能成本不在"切分",在"限核"。八个实例同卡,容器化加 vGPU 切分的差异是 0.2% ,在噪声范围内。但一加
gpucores限核,吞吐掉了 48%,p95 从 1.34 秒涨到 4.77 秒。 - 控制面真正难的不是"能不能切",而是"切完以后谁看得见谁"。我踩到最狠的一个坑:调度器看不见不归它管的显存占用,把 Pod 派到了一张已经快满的卡上,直接 OOM。
- 异构已经是现状,谈不上选不选。这一层要开放,不是因为理念,是因为你手里已经不太可能只有一种卡了。
上一篇我说控制面决定算力值不值钱。这一篇算是把这句话换成了能验证的数字。验证出来的结果,比我预期的好一些,也比我预期的乱一些。
🔸 二、先把实验台搭起来
机器长这样
一台双卡机,两张卡不是同一代:
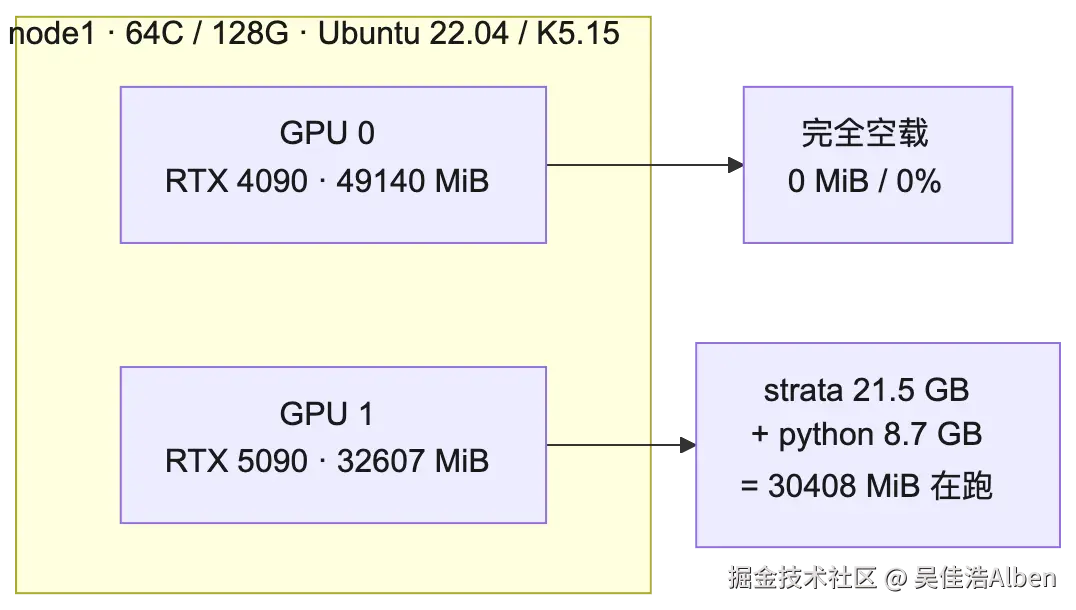
图里有个不对称,是我故意留的:5090 上压着 30.4 GB 的生产负载,4090 是空的。
我要的就是"一张卡在跑生产,另一张可以随便折腾"这种环境,因为真实集群里的混部现场基本就长这样。
"停服务"到底怎么停
第一步是把 4090 上所有东西停掉。
做的时候我发现,这件事的重点不是杀进程,而是把入口掐掉,不然进程停了又会被拉起来。
顺手记一个判定上的坑:有个容器 strata 带着 NVIDIA_VISIBLE_DEVICES=all,看上去像是要占 4090,但它的 DeviceRequests 明确只给了 ["1"],实际只用 5090。判断一个容器到底用哪张卡,要看 DeviceRequests,环境变量往往是历史残留,会误导人。
九项验证
入口掐完之后,我跑了九项验收:
| # | 检查项 | 判据 | 结果 |
|---|---|---|---|
| 1 | 计算进程(30 秒 10 次采样) | 峰值 = 0 | ✅ |
| 2 | 显存占用 | < 1024 MiB(实测 0) | ✅ |
| 3 | 利用率 | == 0% | ✅ |
| 4 | /dev/nvidia0 句柄 |
仅 HAMi 自身组件 | ✅ |
| 5-7 | 容器 / 自动拉起 / k8s Pod | 均无占用 4090 的 | ✅ |
| 8 | 系统服务自启 | 已 disabled | ✅ |
| 9 | 对照组:5090 | 30408 MiB → 30408 MiB | ✅ |
第 9 项是我特意加的。做资源回收这类操作,最容易出的事故就是顺手把生产也动了。所以全程我都盯着 5090 的数字,它没变,才算这次操作是干净的。
🔸 三、切分这件事,硬不硬
节点上的 HAMi 是 v2.11.0 ,hami-core 模式,两张卡各切 10 份:
json
[{"id":"GPU-86d14e75...","count":10,"devmem":49140,"devcore":100,
  "type":"NVIDIA GeForce RTX 4090","mode":"hami-core","health":true},
 {"id":"GPU-6b12533d...","index":1,"count":10,"devmem":32607,"devcore":100,
  "type":"NVIDIA GeForce RTX 5090","mode":"hami-core","health":true}]
节点 allocatable: nvidia.com/gpu = 20。
先验一个最小的:4 GiB 切片
我给一个 Pod 申请 nvidia.com/gpumem: 4096,让它自己去问 CUDA"这块卡有多大":
csharp
[1] cuInit            -> 0
[2] cuDeviceGetCount  -> 1
[3] 设备               -> NVIDIA GeForce RTX 4090
[4] cuCtxCreate       -> 0
[5] 容器看到的显存     -> total 4.00 GiB / free 4.00 GiB   ← 物理 48 GiB 被抹掉
[6] 申请 2 GiB        -> 0 成功
[7] 申请 6 GiB        -> 2 CUDA_ERROR_OUT_OF_MEMORY
HAMi 侧同时打出了拦截日志:
markdown
[HAMI-core ERROR (allocator.c:40)]: Device 0 OOM 6442450944 / 42949672966 GiB 是 6442450944,配额是 4294967296,限额精确到字节,而且是在 CUDA 分配器这一层拦下来的。
这是控制面最基础的一件事:应用问"我有多大显存",答案由编排层说了算,不由硬件说了算。这一步成立之后,一张 24 GB 的卡才能被当成四张 6 GB 的卡来用,GPU 也才算从"设备"变成了"资源"。
再验一次共享:两个租户同卡
两个 Pod 各要 8 GiB,同时钉在 4090 上:
| Pod | 分配到的卡 | 切片 | 内部视角 | 实际占用 |
|---|---|---|---|---|
hami-share-1 |
GPU-86d14e75... |
8192 MiB | total 8.00 GiB |
3458 MiB |
hami-share-2 |
GPU-86d14e75... |
8192 MiB | total 8.00 GiB |
3458 MiB |
宿主机这边看到的是:
yaml
index  name          used        util
0      RTX 4090      6930 MiB    0 %      ← 两个租户叠加
1      RTX 5090      30408 MiB   0 %      ← 全程未变

GPU-86d14e75..., 1731329, python3, 3458 MiB
GPU-86d14e75..., 1731626, python3, 3458 MiB   ← 同一张卡两个进程
两个 Pod 各自看到的都是自己的 8 GiB,而不是共享的 48 GiB。
所以隔离的含义不只是"你用不了我的",还包括"你根本看不见我的"。
🔸 四、把八个真实业务搬进去
切分能跑通,只是及格线。我真正关心的是:把生产负载搬进来,会不会变慢。
对照组设计
我找了八个同构的容器,是同一套 VL 的 Embedding + Reranker 服务(FastAPI,内部端口 8004,2B 模型),八个实例各自处理自己的分片。
对照是这样设的:
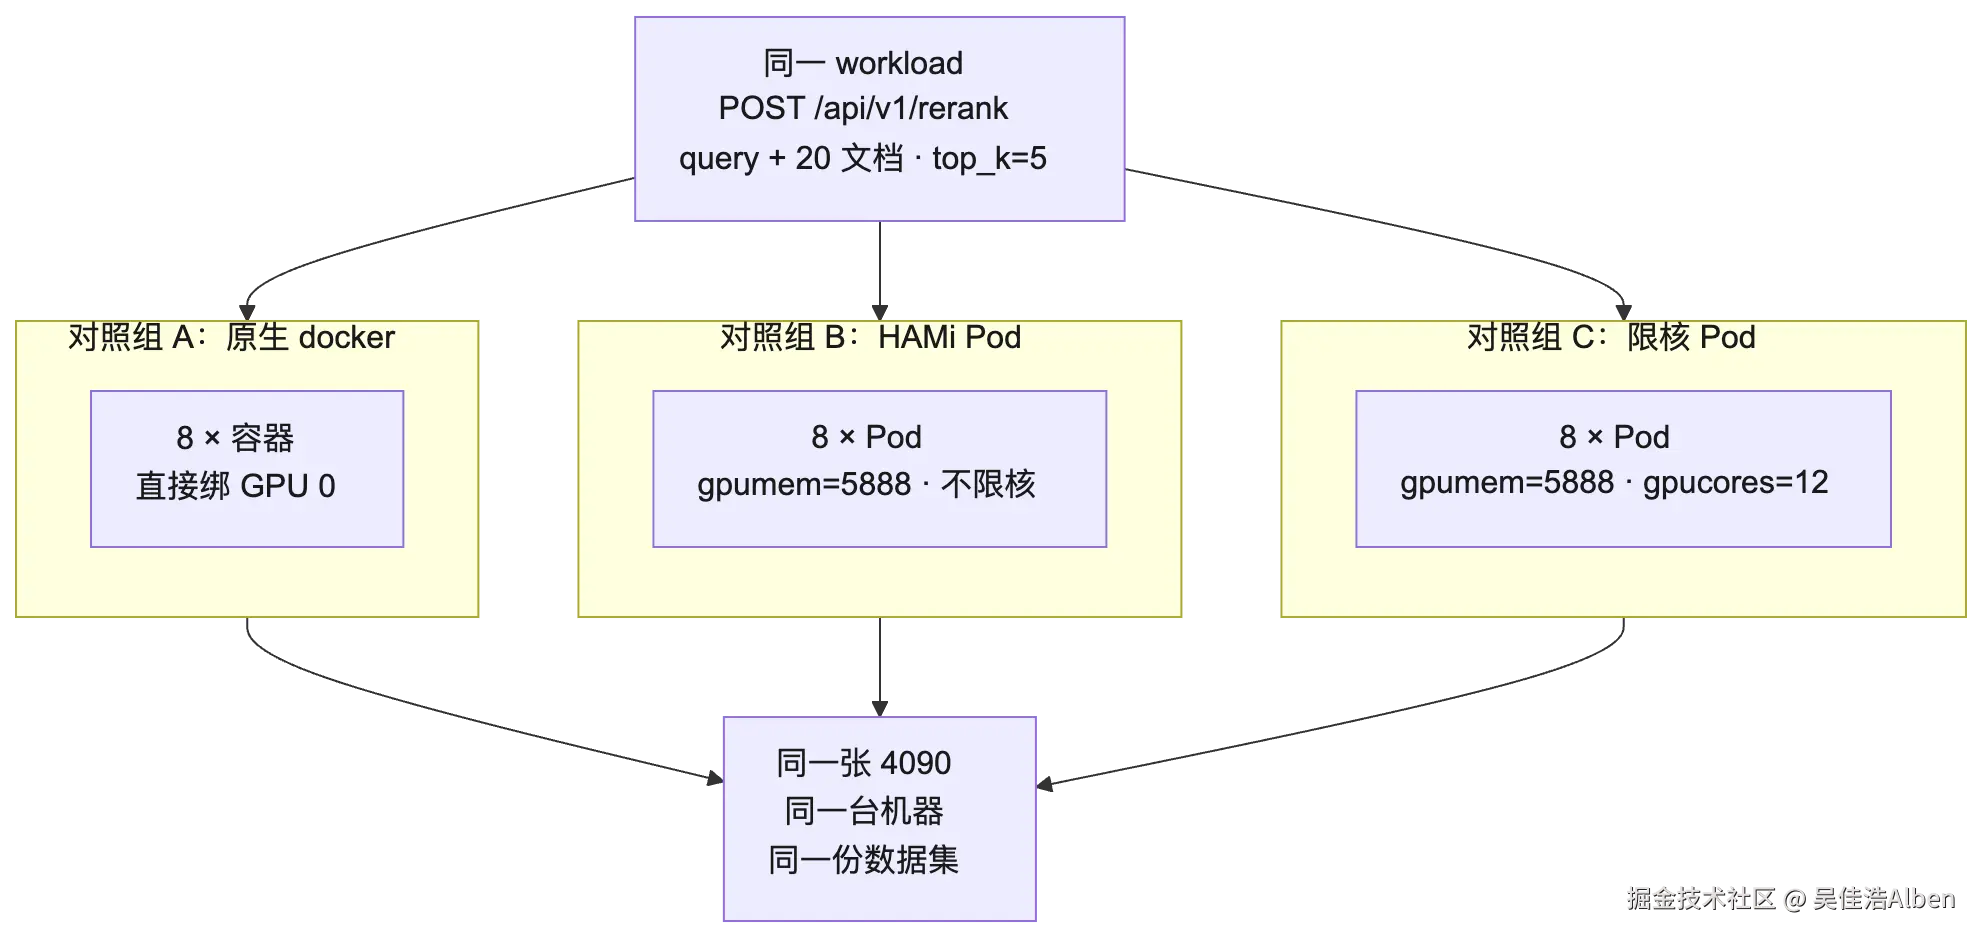
三组都跑在同一张 4090 上,网络路径都是"宿主机端口 → 容器 8004",工作负载完全一致。
先看单实例独占。这种情况干扰最少,能直接看出容器化本身的开销:
| 指标 | docker 原生 | HAMi pod | 差异 |
|---|---|---|---|
| 串行 mean | 560.3 ms | 560.8 ms | +0.09% |
| 串行 rps | 1.78 | 1.78 | 0 |
| 并发 4 mean | 2102.2 ms | 2070.1 ms | −1.5%(pod 略快) |
| 并发 4 rps | 1.82 | 1.84 | +1.1% |
再看八实例同卡,也就是真实的生产形态:
| 指标 | 8 × docker 容器 | 8 × HAMi pod(只切显存) | 差异 |
|---|---|---|---|
| 聚合吞吐 | 5.97 req/s | 5.98 req/s | +0.2% |
| 单实例 mean | 1333.0 ms | 1330.5 ms | −0.2% |
| p50 | 1334.1 ms | 1329.7 ms | −0.3% |
| p95 | 1340.7 ms | 1343.0 ms | +0.2% |
| 显存占用 | 36432 MiB | 36432 MiB | 完全一致 |
| 失败请求 | 0 / 96 | 0 / 96 | --- |
我怕样本太少,又加厚到 320 个请求 重跑了一遍,结果几乎没动:5.95 req/s,p95 1341 ms,0 失败。
同时我也抓了 GPU 侧的遥测:
matlab
采样点 55 个 / 55 秒
GPU 利用率 : mean 96%   max 100%
显存       : mean 36463 MiB
功耗       : mean 254 W  max 269 W
温度       : mean 46 C   max 53 C
SM 频率    : mean 2614 MHz  max 2715 MHz
这组里最值得看的是利用率 96%。
它说明 5.95 req/s 不是被编排层拖出来的,而是这张卡本身已经被压满了。八个实例如果线性叠加,理论上应该是 1.78 × 8 ≈ 14.2 req/s,实际只有 5.95,差的那部分是 GPU 上的争抢,和容器化没有关系。
那损失到底在哪
看第三组。还是这八个 Pod,只多加一条 nvidia.com/gpucores: 12:
| 指标 | 不限核 | gpucores=12 |
变化 |
|---|---|---|---|
| 聚合吞吐 | 5.98 req/s | 3.10 req/s | −48% |
| 单实例 mean | 1330.5 ms | 1874.8 ms | +41% |
| p50 | 1329.7 ms | 1443.2 ms | +8.5% |
| p95 | 1343.0 ms | 4773.6 ms | +255% |
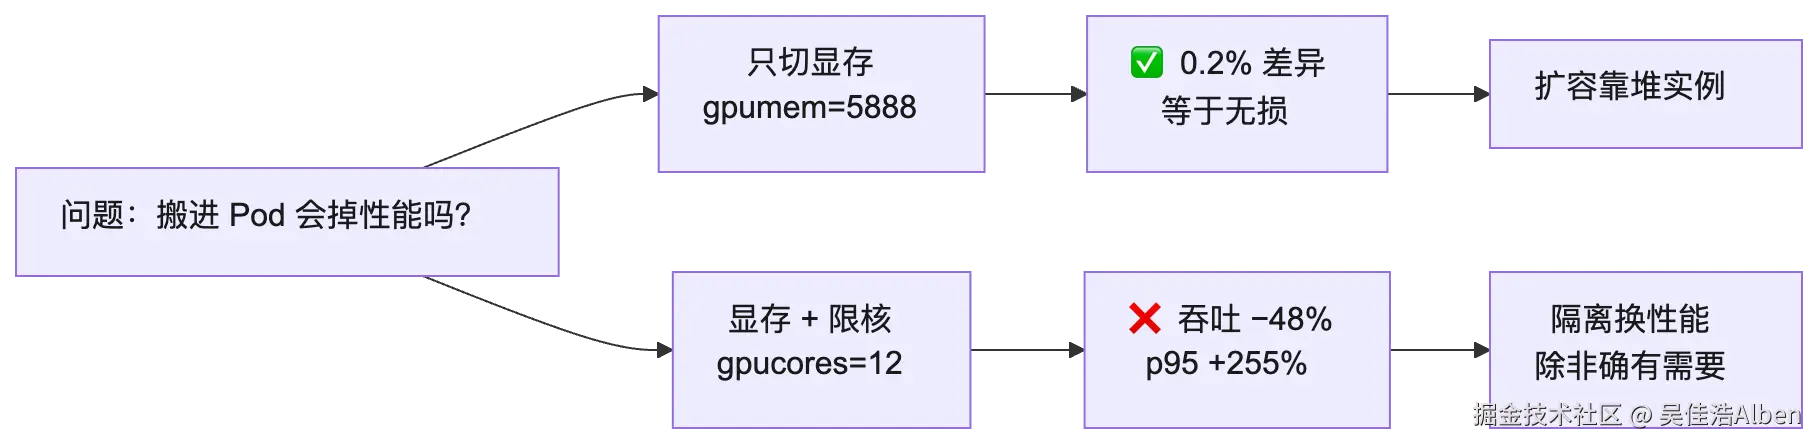
隔离是有代价的,但这个代价记在 SM 配额上,不记在容器化上。
以前大家常担心"上 Kubernetes 之后 GPU 会变慢",从这次的数据看,这个担心基本不成立:K8s 沙箱、vGPU 拦截、hostPath 挂载,三样加起来是 0.2%,在统计上都站不住。真正会让你变慢的,是你自己在 gpucores 里填的那个数。
三个顺带的发现
① 冷启动多了 2.6 秒。 Pod 从创建到 API 可用要 8.5 s ,docker 从 run 到 API 可用是 5.9 s。多出来的时间花在调度、沙箱创建和 hostPath 挂载上。小规模弹性场景里,这笔开销是实打实的,别指望 Pod 能秒级扩容。
② 这个服务本身是串行的。 单实例并发 4 时吞吐 1.82 rps,串行时 1.78 rps,并发基本没提速,延迟反而从 560 ms 涨到了 2100 ms。原因是代码里给模型加载加了互斥锁。
所以这个服务的扩容只能堆实例,没法靠堆并发,这恰好就是 GPU 切分的适用场景。八个 Pod 的 5.95 rps,就是八个独立实例叠出来的。
③ 文档数基本是线性放大的。 同一实例串行:
| 文档数 | mean |
|---|---|
| 5 | 171 ms |
| 20 | 551 ms |
| 50 | 1377 ms |
| 100 | 2755 ms |
每多一个文档大约 +27 ms。这条曲线平不平,直接决定一张卡上能塞几个实例。
🔸 五、三个必须说的问题
好的部分放后面讲,先说问题,都是我实测里踩出来的。
问题一:看不见的显存,是混部的杀手
这是这次踩得最狠的坑。
第一次做多租户测试时,调度器把第二个 Pod 派到了 5090 上,然后直接 OOM。
原因是 5090 上有 30408 MiB 被两个普通 docker 容器占着(strata 21.5 GB,加一个 python 8.7 GB)。这两个容器不归 HAMi 管,HAMi 对它们一无所知。
在 HAMi 的台账里,5090 的 32607 MiB 是满的、全新的、随便切的,于是它很大方地批了一个 8 GiB 的切片,容器一申请就爆了。
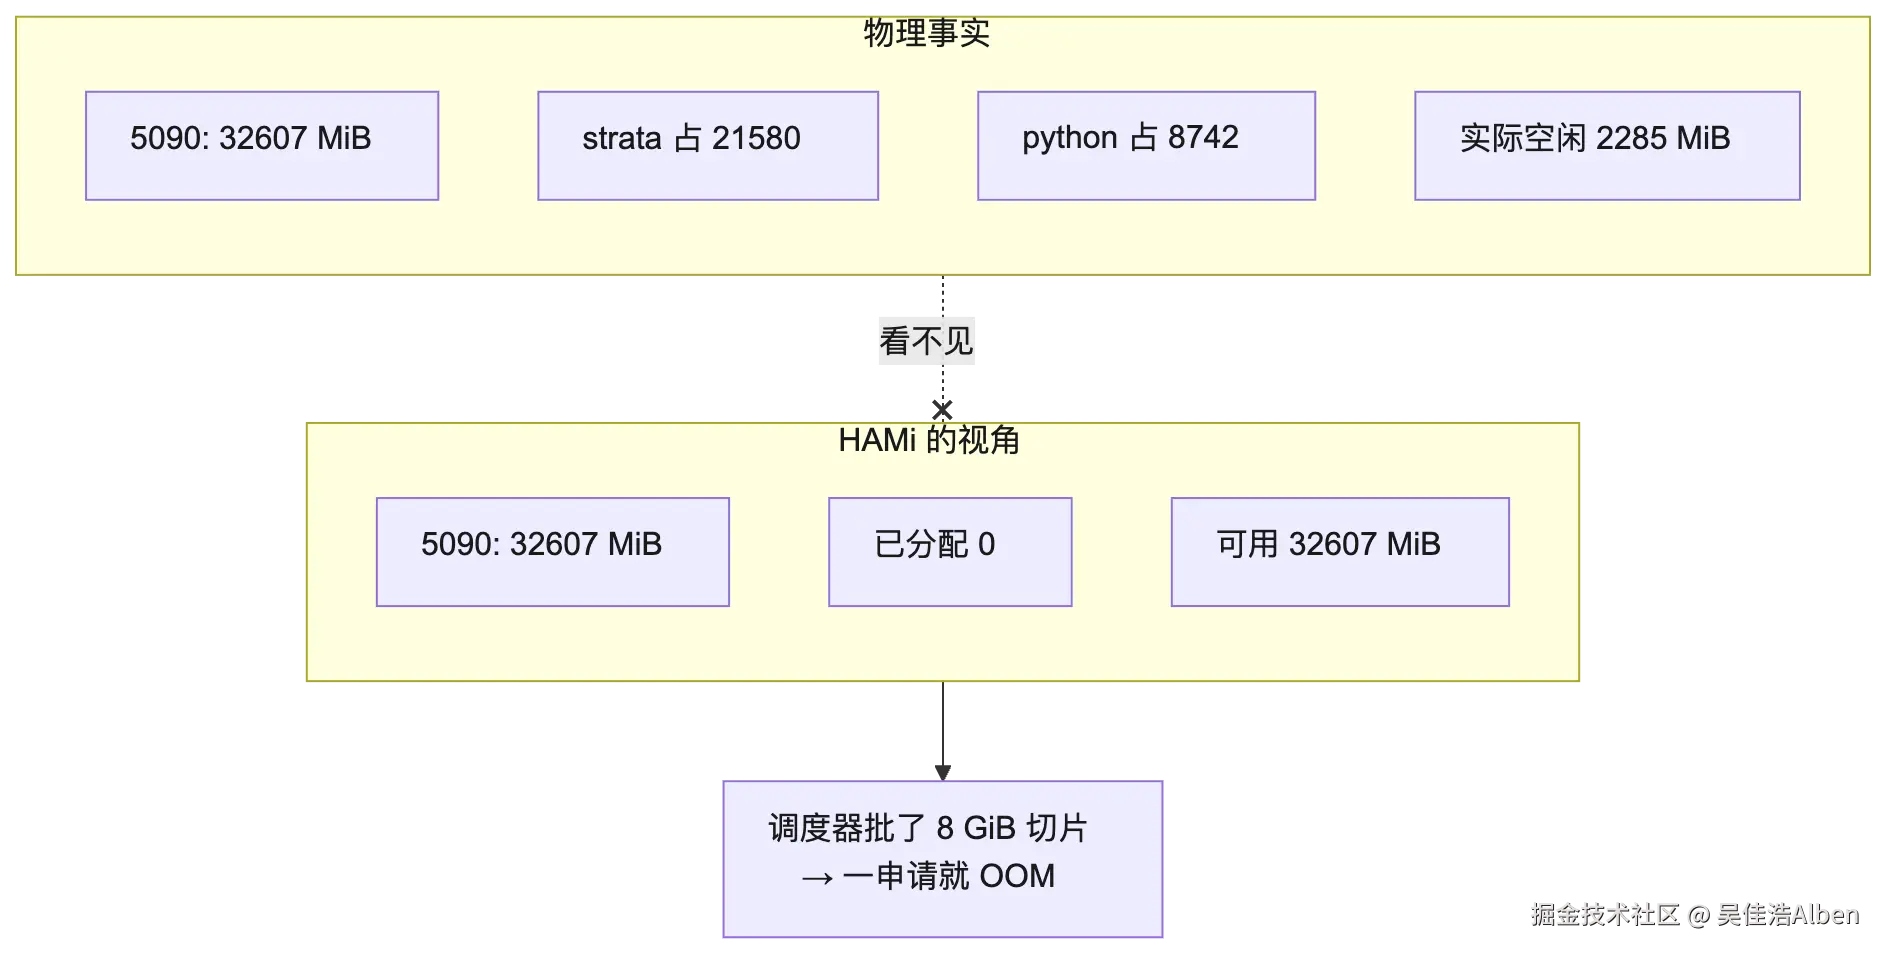
这不算配置错误,是架构上天然的观测盲区。HAMi 统计的只是它自己调度出去的 Pod,直接 docker run 起来的容器它管不到,也看不到。
规避办法有,但得自己主动去做:
yaml
metadata:
  annotations:
    nvidia.com/nouse-gpuuuid: "GPU-6b12533d-..."   # 把混部卡排除出切片池
也可以在 device-config 里用 filterdevices 按 uuid 或 index 过滤。我最后是用 use-gpuuuid 把八个 Pod 全部钉在 4090 上,问题就没再出现。
但这个坑我觉得做混部的人都该记一下:编排层看到的世界,和机器真实的世界,可以差出 30 GB。
问题二:gpucores 是硬节流,不是软配额
12% × 8 = 96%,看着像是给每个实例分了一小份。实际表现是 p95 从 1343 ms 直接跳到了 4773 ms,尾部放大了三倍半,均值却只涨了 41%。
这说明 SM 配额是硬切的:配额用完,请求就停在那里等,不会"稍微超一点"。所以:
- 平均延迟会骗人(只涨了 41%)
- p95 才反映真实情况(涨了 255%)
- 如果面向用户的 SLA 是按 p95 定的,
gpucores这一栏就得填得很小心
我的建议是:没有强隔离需求,就别填 gpucores,上面那张表已经把代价列清楚了。
问题三:device-config 的默认值是个占位符
hami-device-plugin 的 ConfigMap 里,nodeconfig 的节点名默认值是:
json
{"nodeconfig": [{"name": "your-node-name", "operatingmode": "hami-core", ...}]}而我的节点叫 node1。
名字对不上的时候,它不会报错,只会悄悄走默认配置。这次碰巧默认值就合理(devicesplitcount: 10),所以结果是对的。但如果有人给某个节点改了特殊参数,改完发现没生效,就会很懵。
这种"静默降级",比直接报错难查得多。
🔸 六、异构:这一层为什么必须开放
回到上一篇的那个判断。
我当时说,Run:ai 开源的意义,在于 NVIDIA 认可了 GPU 编排是一个必须开放的公共层。这篇我想补一句更实际的:这一层非开放不可,不是因为理念,是因为供给。
供给已经不只是技术问题
这两年算力方面最大的变量不在技术,在供给。
一张卡能不能按时到,到的是什么型号,下一批还是不是同一个型号,这些问题的答案越来越不确定。
结果就是,一家公司的 GPU 库存,正在从"一种卡若干张"变成"几种卡各若干张"。
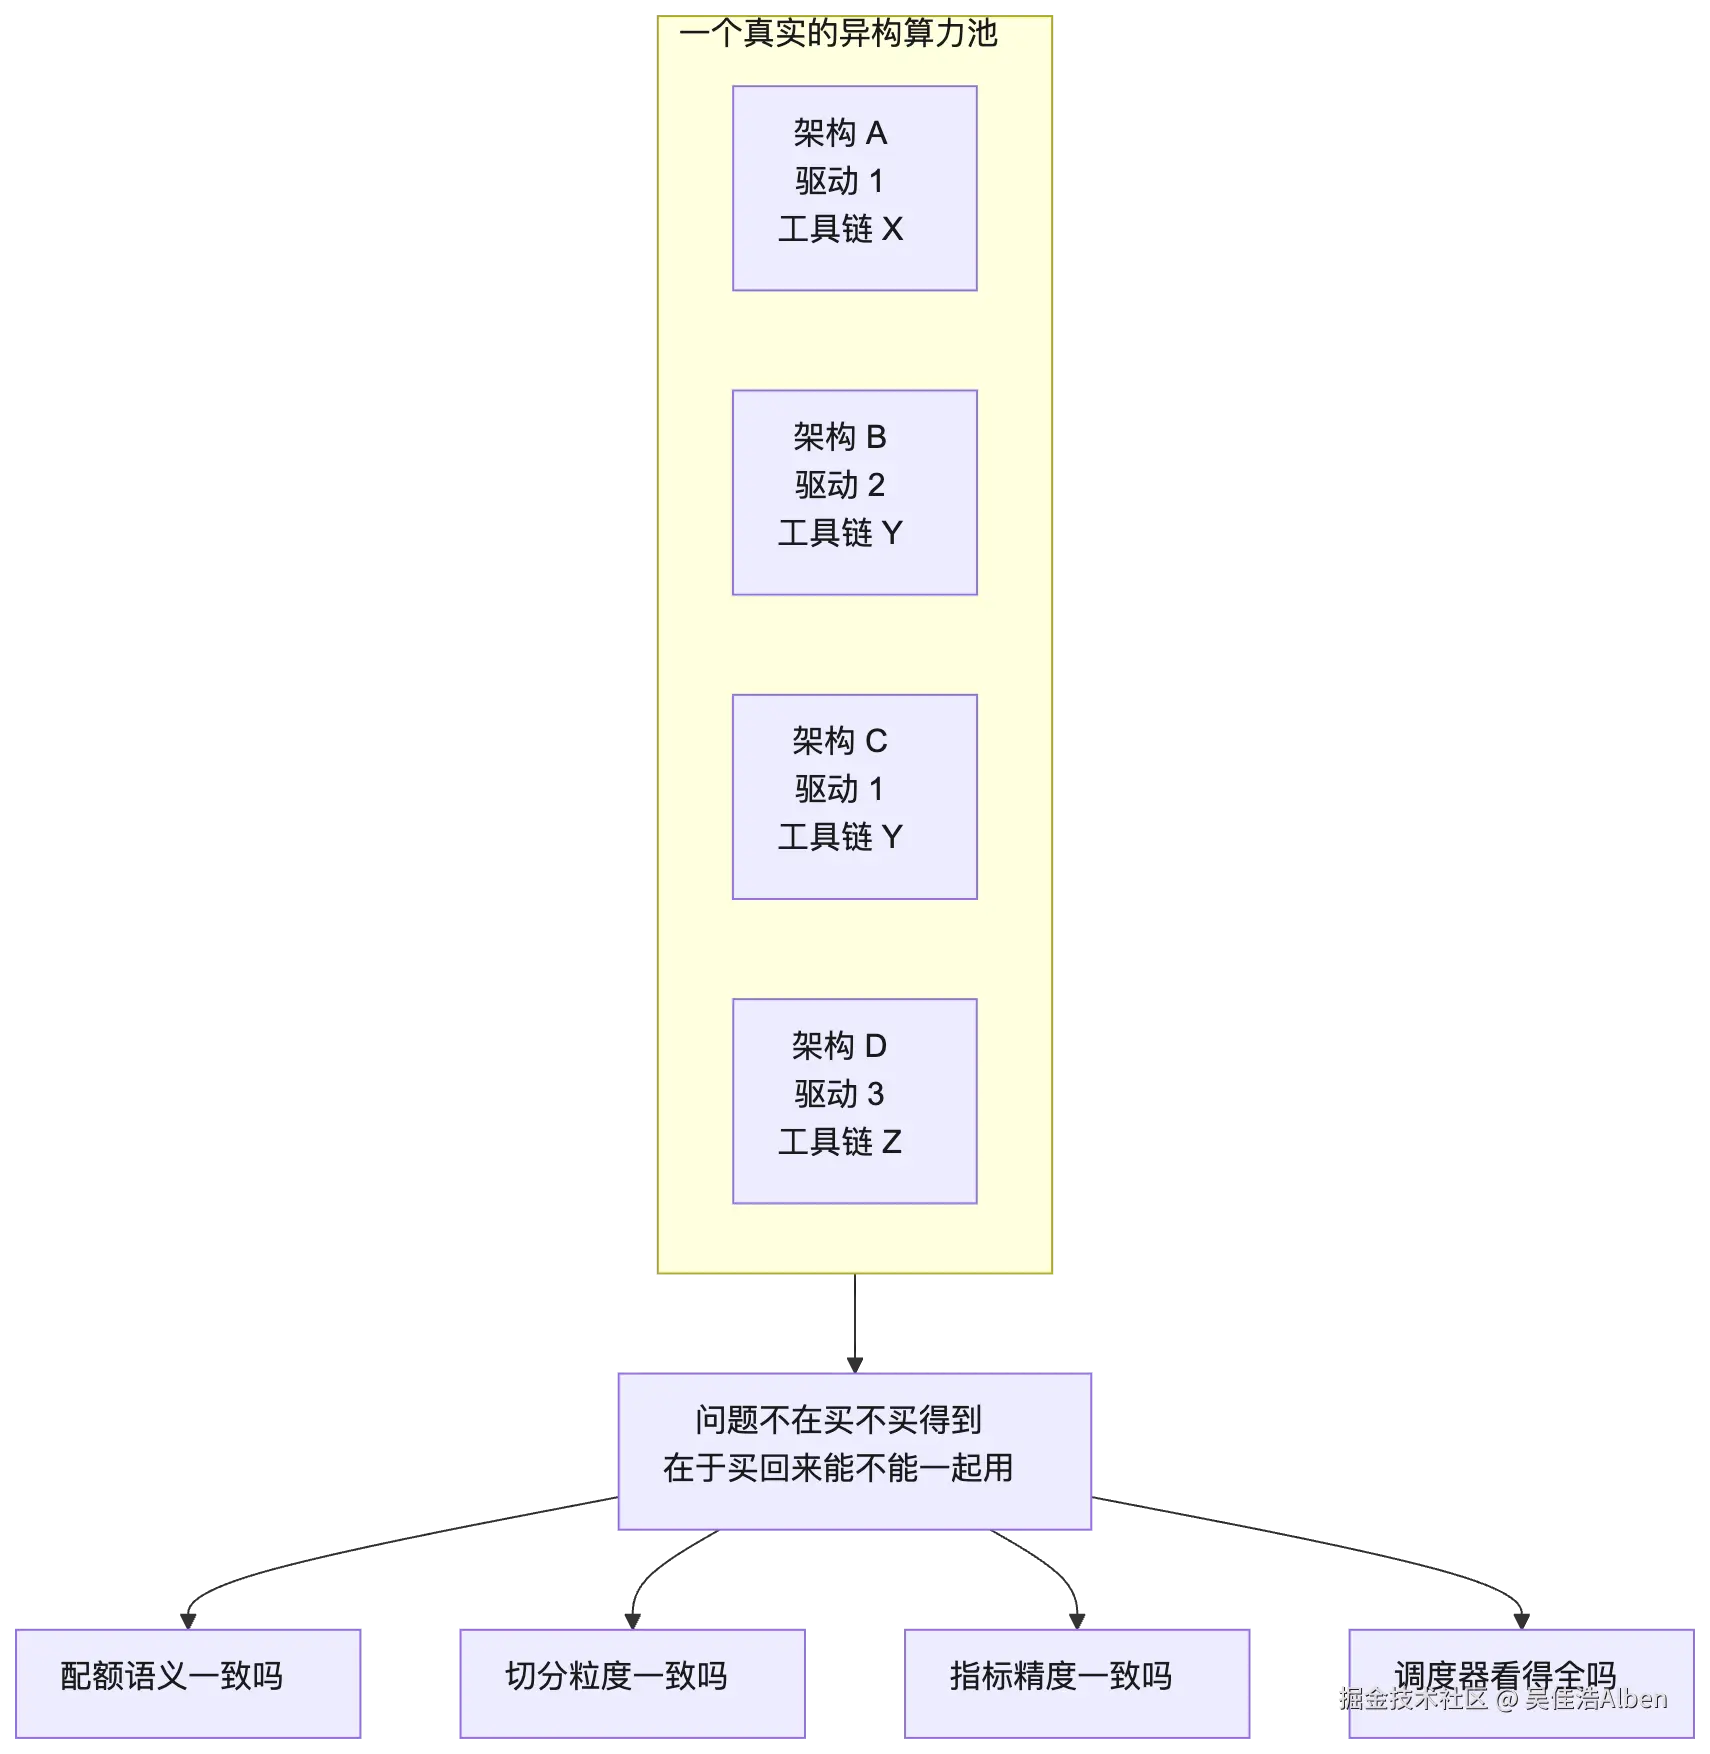
异构不是谁选出来的架构,它就是现状。
同一套调度语义能不能同时覆盖这几种架构,决定了这些卡是资产,还是躺在机房里的库存。
HAMi 在这一层的价值
HAMi 的做法是把这件事当成第一性问题来设计:不是先做好 NVIDIA,再去兼容别人,而是一开始就把设备抽象单独拉出来,让调度器面对的是"设备"这个统一概念,而不是某一家厂商的 API。
它列出的国产卡覆盖了昇腾、寒武纪、海光、沐曦、天数、壁仞、摩尔线程这一批,并且共用同一个 hami-scheduler、nvidia.com/gpu 之外同一套资源名语义、同一个 quota 模型。
这件事的分量,做过混部的人才体会得到:统一的意义不在于"支持了多少卡",而在于不用为每种卡重写一遍调度策略。
nvidia.com/gpumem 的语义在异构池里保持一致,运维才有可能只维护一套 SLO。
但"无损适配"要拆开看
这里我得说句实话,不然就成吹了。
HAMi 说的"无损",准确含义是"应用不用改":同一份代码、同一个镜像、同一个 cudaMalloc 调用,换一张卡还能跑。这个价值很大,不要小看。
但它不等于"能力对齐"。我这次实测的是 NVIDIA 这条线,能做到显存加算力双维度切分,能做到字节级硬上限,能给出 Pod 级指标。换成别的架构,不同厂商、不同驱动版本能提供的切分粒度并不一样:有的能到显存加算力,有的只能到整卡,有的指标精度差一截。
所以比较合适的心态是,把 HAMi 当成"统一的最小公约数",而不是指望所有卡都变成 H100。
这个差距不能算 HAMi 的问题,是硬件和驱动能力本来就不同。但用的人得清楚自己是在最小公约数上做设计,别默认每家都能给你同样的切分能力。
🔸 七、两条路线:驱动强制 vs 运行时拦截
这次实测还让我看清了一件事:Run:ai 和 HAMi 在"怎么切"上,走的是两条不同的路。
我上一篇提到,Run:ai 已经把原来的专有分片实现退役,改用 CUDA 13.4 原生的 GPU fractioning,由驱动强制执行每个负载的显存硬上限。当时我写了一句"能力下沉到了 CUDA"。
这次在 HAMi 上,我看到的日志是这样的:
markdown
[HAMI-core ERROR (allocator.c:40)]: Device 0 OOM 6442450944 / 4294967296文件名是 allocator.c,说明是在 CUDA 分配器这一层拦截的,靠 libvgpu.so 通过 LD_PRELOAD 注入实现。
两条路对照起来是这样:
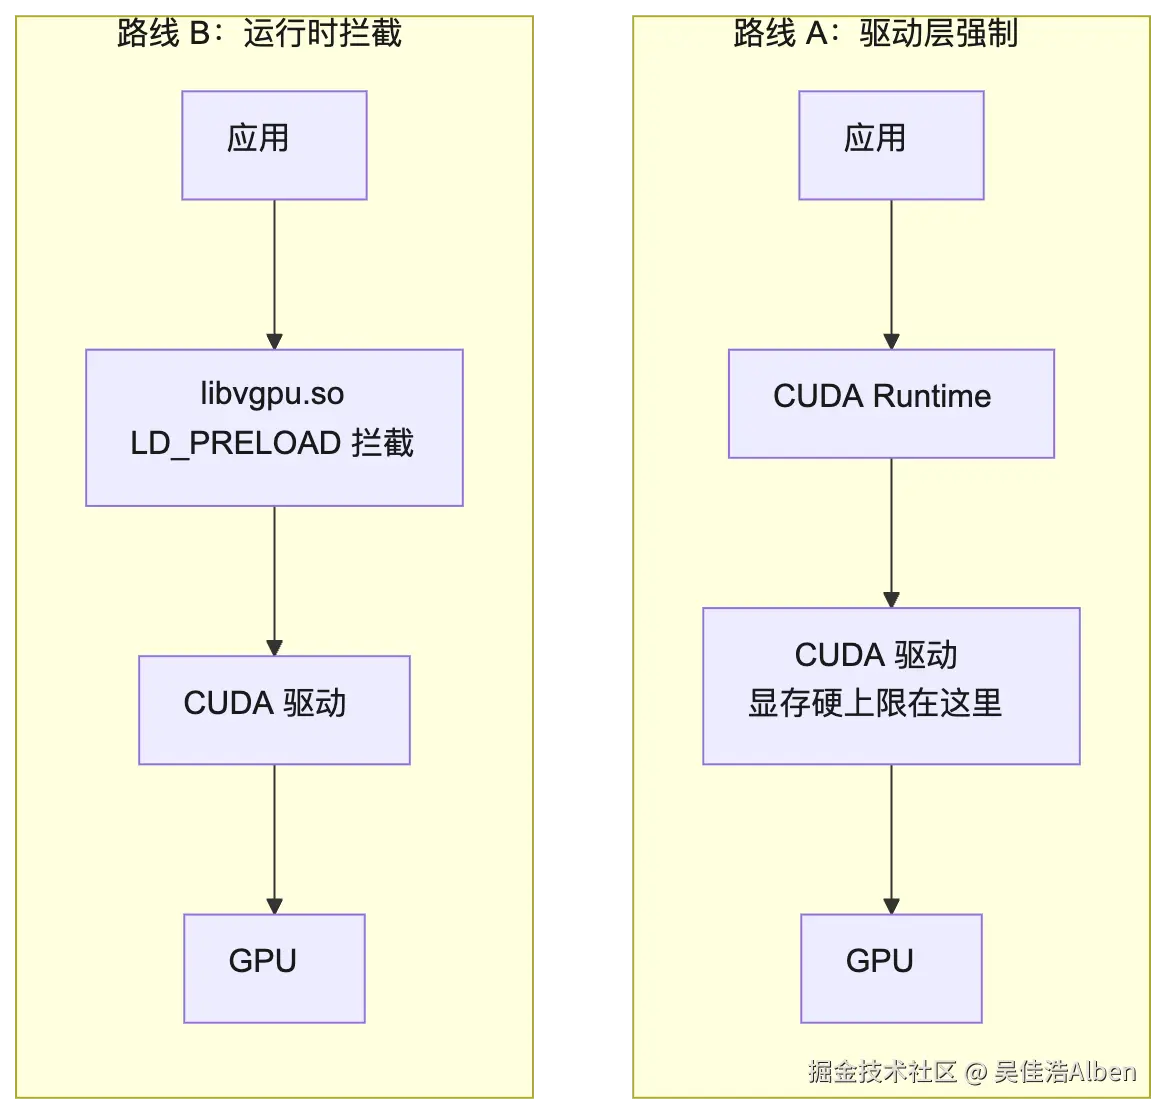
| 驱动层强制(CUDA 原生) | 运行时拦截(HAMi-core) | |
|---|---|---|
| 强制位置 | 驱动,应用绕不过 | 用户态,拦截 API 调用 |
| 对旧卡/旧驱动 | 需要新驱动 | 通吃,这正是它的价值 |
| 对异构 | 每家的驱动得各自实现 | 一套拦截逻辑覆盖所有 |
| 强度 | 硬边界(安全级) | 软边界(管理级) |
我觉得两条路各有道理,短期内也会并存。
驱动层强制更硬、更安全,但前提是驱动要跟得上,而在异构池里,你没法要求每张卡的驱动版本都同步到最新。
运行时拦截要软一些,但它是"老驱动加多厂商"这个现实约束下,唯一能立刻落地的方案。
这对国产卡这条线尤其合适:不用等驱动升级,先把卡管起来再说。
顺便说一句,这个差异也解释了前面问题一的性质。用户态拦截只能看见经过它的调用,没走 libvgpu.so 的容器,对 HAMi 来说就是透明的,所以才会有那个 30 GB 的观测盲区。这两件事是同一个设计选择的两面。
🔸 八、把两张表放一起看
上一篇我给过一张分工表,这次可以把实测数字补进去了:
| 层 | 关注点 | 优化什么 | 本次实测 |
|---|---|---|---|
| Runtime(vLLM / SGLang) | 如何让 Token 更快出来 | 执行效率 | 双侧一致,560 ms |
| Scheduler(HAMi / Run:ai) | 如何让 GPU 不浪费 | 资源效率 | 切分 0.2% 开销;限核 −48% |
| Cluster(Kubernetes) | 如何让机器不浪费 | 机器效率 | 冷启动 +2.6 s |
上一篇我写过这么一句:
Runtime 优化的是执行效率(Execution Efficiency);Scheduler 优化的是资源效率(Resource Efficiency)。
当时这还只是个概念,现在它有数了:
- 执行效率:单个请求多快。560 ms,编排层不碰它。
- 资源效率:一张卡能同时服务几个。从 1 个到 8 个,这是编排层给的。
把这两个数放在一起,价值就很直观:
一个实例 1.78 rps,八个实例 5.95 rps。 你多花的不是延迟,是三层楼的机柜。
还有那个 96% 的利用率,也提醒我这张卡已经被榨干了,剩下的提升空间不在编排层,在服务本身(那个串行的互斥锁)。
编排层的贡献是"让八个一起跑",不是"让一个跑得更快",这也基本就是这一层的边界。
🔸 九、落到工程师身上
上一篇我写过"你可能只有一张 5090,明天要管几十张 H100"。
现在我想换个说法:你可能已经有三张不同架构的卡了。
那么这次实测里,有几条可以直接拿去用:
- 别怕把 GPU 负载搬进 K8s。 容器化本身只有 0.2% 的开销,不是 20%。真正会变慢的,是你自己填的
gpucores。 gpucores慎填。 平均延迟只涨 41%,p95 涨了 255%,如果你按均值做容量规划,会被打脸。- 混部之前,先查"看不见的显存"。
nvidia-smi和 HAMi 台账对不上的时候,信nvidia-smi。 - 扩容靠堆实例,别指望堆并发。 前提是服务本身是串行的,很多推理服务都是这样。
- 冷启动按秒算,不按毫秒算。 建一个 Pod 要 8.5 秒,弹性策略得按这个量级来设计。
理解 Runtime,能让一张卡跑得更快;理解 Scheduler,才能让一堆卡跑得更值。这句话我上一篇写过,这一篇算是把它从判断变成了测量结果。而且结果是站在 Scheduler 这边的,我挺高兴。
🔸 十、最后
回到开头的问题:GPU 编排到底该不该单独成一章。
我的答案没变,但理由换了。
上一篇的理由是"它同时管钱和管卡"。这一篇的理由是:它管的那部分,是唯一有 8 倍空间的那部分。
一个实例 1.78 rps,八个实例 5.95 rps。Runtime 再怎么优化,也给不了 8 倍,因为它优化的是一张卡的内部。只有编排层,才能把"一张卡"变成"八份可以卖的东西"。
这一层正在从闭源走向开放,从单一厂商走向异构。这个方向不是哪一家公司决定的,是供给结构推着走的。
开源不等于胜利。但当一个池子里必然同时存在好几种架构时,"能统一管理"本身就已经是刚需了。
差点忘了说:这次实测的脚本、配置和原始数据都在我本地,包括那个 30 GB 观测盲区的复现步骤,感兴趣的可以留言,一起看。
【一句话总结】把八个真实业务从 docker 搬进 HAMi Pod,容器化加 vGPU 切分只带来 0.2% 的差异,基本等于无损;真正的性能代价记在你填的 gpucores 上,限核 12% 换来吞吐 −48%、p95 +255%。所以 GPU 编排这一层的价值,不在让一张卡跑得更快,而在让一张卡变成八份能卖的东西;它之所以必须开放、必须支持异构,不是因为理念先进,而是因为你下一个算力池里大概率不会只有一种卡。
最近阿里的PPU很火你听说了么?