假设一段内部日志不方便上传,你打算让本地模型找出最先失败的调用。笔记本上还开着 IDE 和浏览器,模型读完日志需要一点时间,你也只想等它给出一条能验证的线索。
Tarek Ziadé 的实验正好给这个场景提供了一个参照。他在 32 GB 统一内存的 M5 MacBook 上跑起了 1800 亿参数的 Qwen3.8-Flash-Next。优化后,短回答的生成速度接近每秒 14 个 token。早期方案处理约 6000 token 的文档时,设备内存峰值到了 25.4 GiB,得关掉浏览器才能避免 macOS 开始用磁盘补内存。Tarek Ziadé 的实验记录
我更关心把模型放回日常工作时,磁盘还要空多少、内存还剩多少、拿到一次有用的结果要多久。
先选专家,再读权重
Qwen3.8-Flash-Next 是 MoE(混合专家模型)。每个 MoE 层有 512 个可选的路由专家。处理一个 token(文本片段)时,路由器从中选出 10 个参与计算。各层还有始终参与计算的共享专家。
一份最直接的实现可以按层加载,把整层的专家权重一次搬过来。对这个模型来说,每走到一层就要搬 512 份路由专家的权重,真正参与计算的是其中 10 份。Tarek 的做法是先让路由器选出专家,再去找那几份权重。有缓存就直接用,缺哪一份就从 SSD 补哪一份。计算当前层时,也能尝试预读下一层可能用到的专家。Transformers 实验实现
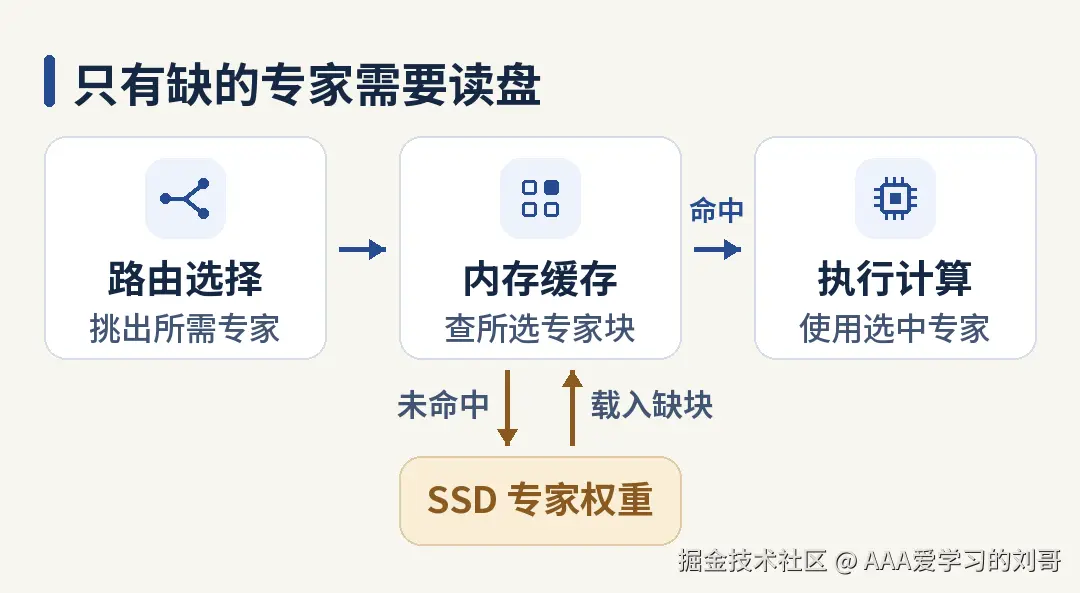
对这台 Mac 来说,CPU 和 GPU 共用统一内存,往 CPU 那边挪权重也会占用这 32 GB。把暂时用不到的专家放到 SSD,才腾得出空间。
专家放到 SSD,内存仍要留给长文档
Tarek 的早期方案把专家量化到约 3 bit(用更少位数存权重),在磁盘上占约 49 GB,设备端的专家缓存设为 12 GiB。模型还有一张约 51 GB 的 n-gram 嵌入表(存放短序列的向量),也单独留在 SSD,按需读行。加上常驻内存的其他权重,完成加载后实际占用约 18 GiB。早期方案的权重配置
这些数字回答的是三个不同的问题。磁盘能不能放得下文件,加载后还有多少内存,以及处理真实输入时峰值会到哪儿。前面说的 25.4 GiB 来自一轮约 6000 token 的测试,里面还有处理长文档需要的临时空间。只看启动后的内存占用,会把这部分余量估得太乐观。
短输出的速度,怎么换算成任务的等待时间
Tarek 继续换用更小的专家权重,并调整了 GPU 调度和预读。同一台 32 GB M5 上,Transformers 的生成速度从每秒 10 个 token 提到了 13.9 个。读过约 6000 token 的文档以后,生成速度从每秒 7.3 个提到 12.4 个。另一次约 4000 token 的输入测试里,优化后的预填充(处理输入文本)速度为每秒 228 个 token。同机对照数据
按 13.9 token/秒算,光生成一段 200 token 的诊断就要约 14 秒。只排查一段日志,我能接受这十几秒的输出时间。编程 Agent 通常要读文件、改代码、跑测试,再根据新输出决定下一步。假如经过五轮,每轮各生成 200 token,仅生成就超过一分钟,读输入和执行工具的时间还要另外算。Tarek 最后也把主要的编程工作留在了台式机。Tarek Ziadé 的使用判断
用一份日志决定要不要留下这个模型
选一份有已知故障原因的日志,平时怎么开浏览器和 IDE,测试时就怎么开。让能完整驻留内存的小模型和这套方案分别回答同一个问题,每次只运行一个,记下完整用时和内存峰值,再检查它们给出的报错位置能不能对上。
如果两个模型都能准确定位故障,我会选更快给出结果的那个。如果小模型漏掉了关键线索,而大模型能指出具体调用和证据,那多花一点磁盘和等待时间就有价值。下次碰到类似问题,我就知道该打开哪个模型。