短期记忆管理一共分3步
存储 → 截断 → 压缩
短期记忆的工程实现。短期记忆听起来简单------不就是把消息历史存起来吗?但真正的挑战在于:对话轮次增长后,如何在不丢失关键信息 的同时控制传入 LLM 的 Token 数量。
我们从最简单的存储开始,逐步引出截断策略和压缩摘要机制,最终实现一个完整的 SessionManager。三个小节环环相扣:先有数据,再谈截断,最后引入摘要------这是任何生产级短期记忆系统都必须经历的设计演进路径。
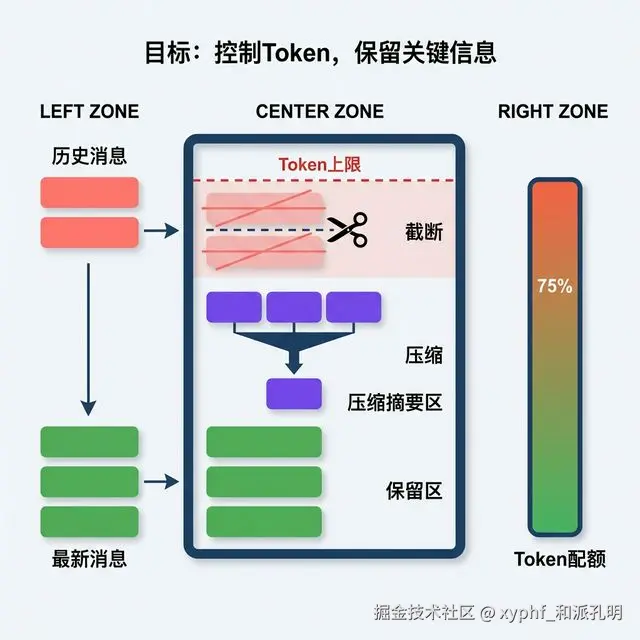
短期记忆的上下文窗口管理本质上只解决一件事:让传入 LLM 的消息历史永远不超过 Token 上限 。工程上有三个层次的手段------截断 是最直接的,超出就丢弃最旧的消息;压缩 是更精细的,把旧消息摘要后压缩替换,用更少的 Token 保留更多的语义;两者共同服务于同一个目标:在有限的上下文窗口内,最大化保留对当前对话有用的信息。下图直观呈现了这三者的关系。
会话存储结构
- 一个完整的会话存储对象包含四个核心字段,我们逐字段来看
| 字段 | 字段名称 | 字段值(示例) | 作用 |
|---|---|---|---|
| session_id | 会话id | "sess_abc123" | 唯一标识一次完整对话会话,用于跨请求追踪上下文归属 |
| messages | 消息列表 | {role: user, content: ...}, ... | 存储所有对话轮次,每条含 role(user / assistant / system)和 content 字段 |
| compressed_context | 压缩摘要 | "用户为后端工程师,主要关注 LangChain 集成..." | 历史对话不能无限制存储下去,当消息超过阈值后,旧消息被提炼为此摘要块,注入到 system 消息头部 |
| metadata | 元数据 | {created_at, last_active, token_count, compress_count} | 可以自定义,记录创建时间、最近活跃时间、Token 消耗统计、压缩次数等运营信息 |
1. 最简单的短期记忆:对话历史存储
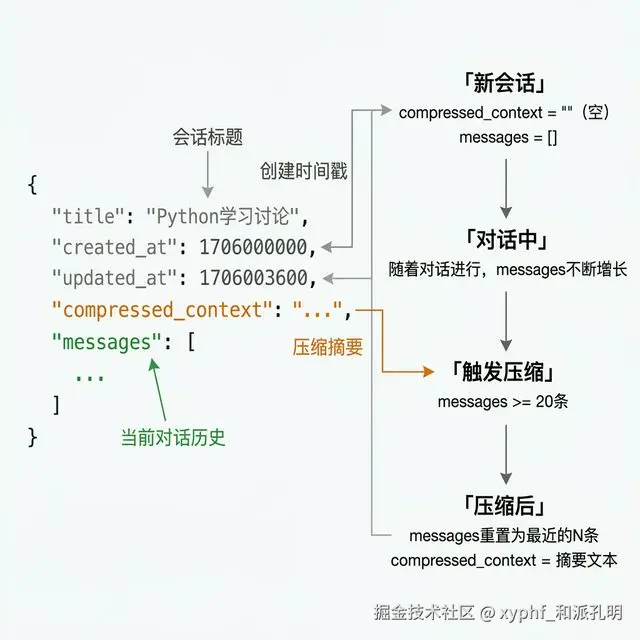
已经给出了短期记忆最原始的形态------一个 messages 列表。现在我们把它稍微工程化一点,加上会话持久化的能力:关闭程序后重启,历史对话依然在。
OpenClaw 使用 JSON 文件存储每个会话。下面是最小可运行的会话存储实现:
python
import json
import os
import time

SESSIONS_DIR = "./sessions"  # 会话文件存储目录
os.makedirs(SESSIONS_DIR, exist_ok=True)

def load_session(session_id: str) -> dict:
    """加载会话,不存在则创建新会话"""
    path = os.path.join(SESSIONS_DIR, f"{session_id}.json")
    if os.path.exists(path):
        with open(path, "r", encoding="utf-8") as f:
            return json.load(f)
    # 新会话的初始结构
    return {
        "title": "",
        "created_at": int(time.time()),
        "updated_at": int(time.time()),
        "compressed_context": "",   # 压缩摘要(暂时为空,3.3节会填充)
        "messages": []              # 当前对话历史
    }

def save_session(session_id: str, session: dict):
    """保存会话到 JSON 文件"""
    session["updated_at"] = int(time.time())
    path = os.path.join(SESSIONS_DIR, f"{session_id}.json")
    with open(path, "w", encoding="utf-8") as f:
        json.dump(session, f, ensure_ascii=False, indent=2)

# 测试:加载会话 → 添加消息 → 保存 → 重新加载验证
session = load_session("test_user_001")
session["messages"].append({"role": "user", "content": "我叫小明"})
save_session("test_user_001", session)

# 重新加载,验证持久化
loaded = load_session("test_user_001")
print(f"持久化验证:{loaded['messages'][-1]['content']}")持久化验证:我叫小明 这段代码建立了短期记忆的存储骨架:每个用户对应一个 JSON 文件,messages 字段存放完整对话历史,compressed_context 字段预留给压缩摘要(下一小节会用到)。注意 ensure_ascii=False------这是中文存储的必要配置,否则中文内容会被转义成 \u 序列。
下图展示了一个真实会话 JSON 文件的结构,以及各字段在 SessionManager 生命周期中的作用:
现在来思考一个问题:这个 messages 列表会无限增长,第 50 轮对话时 messages 里已经有 100 条消息。如果把 100 条消息全部传给 LLM,Token 成本是第 1 轮的 100 倍,推理延迟也会显著上升。怎么解决?
2. 消息截断策略
最直接的解法是只保留最近 N 条消息 传给 LLM。我们开发的很多Agent项目的默认配置是 MAX_HISTORY = 20,即最多传入最近 20 条对话记录。
为什么是 20 条?deepseek-chat 模型(DeepSeek-V4)支持 1M Token 的上下文窗口。20 条消息的设定来自工程经验:在典型对话场景下,这个数量能覆盖完整的多轮问答上下文,同时把单次请求的 Token 占用控制在窗口的极小比例,为 System Prompt、压缩摘要和模型推理空间留出充足余量。相比之下,设置过小(如 5 条)会让 Agent 显得「健忘」,在连续对话中频繁失去上下文;设置过大(如 100 条)则会在长会话中推高 Token 成本,增加响应延迟。20 是在「记忆完整性」和「成本控制」之间的合理平衡点,实际项目中可根据平均消息长度和业务需求按比例调整。如需精确计算 Token 数,可使用 tiktoken 库对实际消息进行测量。
python
MAX_HISTORY = 20  #根据模型上下文窗口调整

def get_messages_for_llm(session: dict) -> list:
    """
    构造实际传给 LLM 的消息列表。
    策略:如果有压缩摘要,先注入摘要;再取最近 MAX_HISTORY 条。
    """
    messages_to_send = []

    # 如果存在压缩摘要,作为 system 消息插在最前面
    if session.get("compressed_context"):
        messages_to_send.append({
            "role": "system",
            "content": session["compressed_context"]
        })

    # 只取最近 MAX_HISTORY 条对话
    recent_messages = session["messages"][-MAX_HISTORY:]
    messages_to_send.extend(recent_messages)

    return messages_to_send

# 验证:超过 20 条时只取最近 20 条
test_session = {"compressed_context": "", "messages": [{"role": "user", "content": f"消息{i}"} for i in range(30)]}
result = get_messages_for_llm(test_session)
print(f"截断验证:传入 LLM 的消息数 = {len(result)}(应为 20)")
print(f" 第一条内容:{result[0]['content']}(应为 消息10)")截断验证:传入 LLM 的消息数 = 20(应为 20)
第一条内容:消息10(应为 消息10)截断策略实现简单,但有一个明显的副作用。
> ⚠️ 踩坑预警 :直接截断会丢失早期的关键上下文。用户在第 3 轮说「我叫小明,我在做机器学习项目」,到第 25 轮问「帮我继续优化上次那个模型」------如果第 3 轮的消息已经被截断,Agent 不知道「小明」是谁、「上次那个模型」是什么。这就是压缩摘要要解决的核心问题。
3. 压缩摘要机制(本章核心)
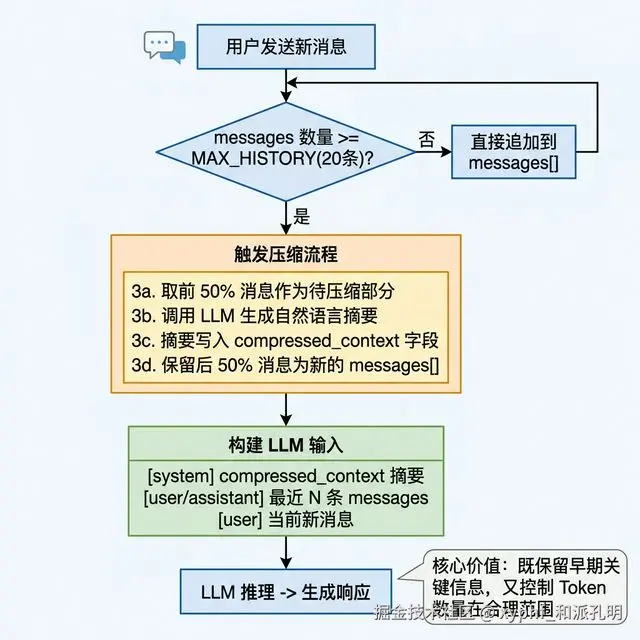
压缩摘要的核心思路是:用 LLM 来总结 LLM 。当对话历史超过阈值时,把较早的对话让 LLM 压缩成一段自然语言摘要,存入 compressed_context 字段。下次对话时,先注入这段摘要,再跟上最近 N 条历史------既保留了早期关键信息,又把 Token 数量控制在可接受的范围内。
压缩的四个保留维度
- 一个好的压缩 Prompt 应明确要求模型保留以下四个维度的信息
| 压缩保留维度 | 作用 |
|---|---|
| 用户身份 | 用户的角色、背景、偏好------Agent 跨轮次保持个性化的基础 |
| 重要决策 | 已达成的结论和方向------避免 Agent 在后续轮次中推翻已有共识 |
| 技术细节 | 具体的技术选型、参数、约束条件------保证后续建议的一致性 |
| 未完成任务 | 用户提到但尚未处理的需求------防止 Agent 遗忘承诺或待办事项 |
整个机制的工作流如下:
下面是 OpenClaw 中 compress.py 的核心实现:
python
COMPRESSED_CONTEXT_PREFIX = "[以下是之前对话的摘要]"

def compress_session(session: dict, client) -> dict:
    """
    压缩会话历史。
    策略:取前 50% 的消息作为待压缩部分(至少 4 条),
    调用 LLM 生成摘要后更新 compressed_context 字段,保留后 50% 的消息继续使用。
    """
    messages = session["messages"]
    if len(messages) < 4:
        return session  # 消息太少,不压缩

    # 取前 50% 作为待压缩部分(至少 4 条)
    compress_count = max(4, len(messages) // 2)
    to_compress = messages[:compress_count]
    to_keep = messages[compress_count:]

    # 构造压缩 prompt
    history_text = "\n".join(
        f"{m['role'].upper()}: {m['content']}" for m in to_compress
    )
    # 滚动摘要:把已有摘要 + 新消息一起压缩成统一摘要
    existing = session.get("compressed_context", "")
    if existing:
        to_compress_text = f"[之前的摘要]\n{existing}\n\n[新增对话]\n{history_text}"
    else:
        to_compress_text = history_text

    compress_prompt = f"""请将以下内容压缩成一段简洁的统一摘要,保留所有关键信息(用户身份、重要决策、技术细节、未完成的任务)。

    对话历史:
    {to_compress_text}

    要求:
    - 用第三人称描述(「用户」「助手」)
    - 保留所有关键事实,不遗漏重要细节
    - 100-200字以内
    - 以「[以下是之前对话的摘要]」开头"""

    response = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": compress_prompt}],
        timeout=30
    )
    summary = response.choices[0].message.content

    # 用新的统一摘要替换旧的(不追加)
    session["compressed_context"] = summary
    session["messages"] = to_keep
    return session

# 演示压缩效果
test_session = {
    "compressed_context": "",
    "messages": [
        {"role": "user", "content": "我叫小明,我在学 Python 数据科学"},
        {"role": "assistant", "content": "你好小明!Python 数据科学很有前途。"},
        {"role": "user", "content": "我已经学完了 pandas 的 groupby"},
        {"role": "assistant", "content": "很好!下一步可以学 sklearn。"},
        {"role": "user", "content": "sklearn 的 Pipeline 怎么用?"},
        {"role": "assistant", "content": "Pipeline 是 sklearn 的核心工具..."},
    ]
}
print(f"压缩前:{len(test_session['messages'])} 条消息")
compressed = compress_session(test_session, client)  # 取消注释可实际运行
print(f"压缩后:{len(compressed['messages'])} 条消息")
print(f"摘要内容:{compressed['compressed_context']}")
print("压缩函数定义完成(取消注释可实际调用 LLM 执行压缩)")
css
压缩前:6 条消息
压缩后:2 条消息
摘要内容:[以下是之前对话的摘要]
用户小明介绍自己正在学习Python数据科学。助手表示欢迎并鼓励,认为该方向很有前途。随后小明说明自己已经学完了pandas中的groupby操作。助手肯定了这一进展,并给出下一步学习建议:学习sklearn。因此,当前用户已完成pandas groupby的学习,未完成或待进行的任务是按照建议继续学习sklearn。
压缩函数定义完成(取消注释可实际调用 LLM 执行压缩) 这段实现有几个值得关注的设计细节。首先是取前 50% 而非固定数量 ------这样随着对话增长,每次压缩的幅度是自适应的,不会出现「压缩后仍然超过阈值」的问题。其次是压缩 prompt 的措辞 :明确要求保留「用户身份、重要决策、技术细节、未完成的任务」,这四类信息是 Agent 在后续对话中最常需要的。最后是结构分离 :compressed_context 和 messages 分开存放,压缩摘要以 system 角色注入,不混入对话历史,语义边界清晰。
> ⚠️ 常见误区 :很多初学者把压缩摘要和对话历史混在一起存储,导致下次传给 LLM 时摘要被当成普通对话处理,LLM 可能误以为是用户说的话。生产中的做法是将摘要作为独立的 system 消息注入,明确区分「背景知识」和「对话过程」。