长期记忆如何管理,我们首先要解决3个问题
问题一:存哪里
长期记忆应该存到哪里?或者说在什么场景下应该选择什么样的存储引擎?
问题二:存什么
什么情况下需求存长期记忆?我们需要记录什么?
问题三:怎么用
假设长期记忆已经存储好了,在什么样的时机使用?以及怎么使用?
长期记忆四种存储类型介绍
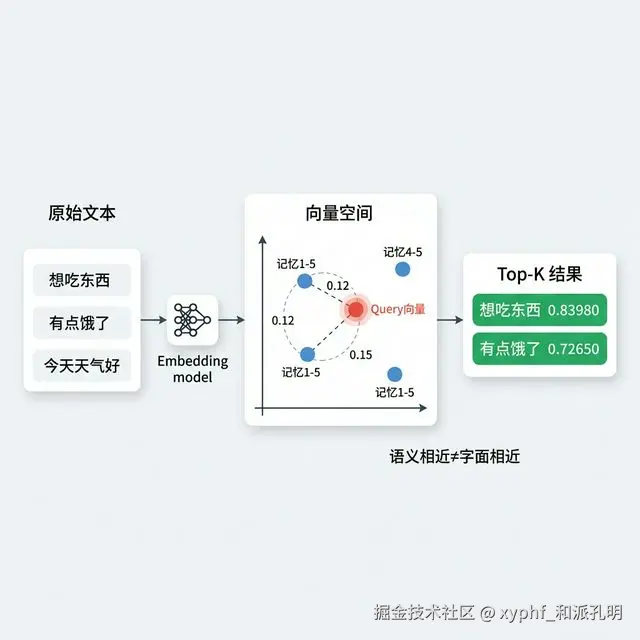
- 工程实践中,长期记忆的存储方案主要分为四类:向量数据库、KV 存储、图数据库、关系型数据库。这四类工具在技术社区里都很成熟,但它们解决的是完全不同维度的问题。这个选择背后有清晰的工程逻辑,本章的目标就是把这套逻辑讲透,让你在面对不同场景时能独立做出判断。
- 根据检索方式与持久性,选择最合适的存储方案
第一种: 直接存到文件系统
- In-Context Storage
- Prompt 内直接注入,精确可控
- 典型工具:MEMORY.md / system prompt
- 适用场景:小体积高频访问的核心事实
第二种: 存到Redis等数据库
- External KV Store
- 键值精确查找,结构化存储
- 典型工具:Redis / SQLite
- 适用场景:用户画像 JSON、会话元数据
第三种: 存到向量数据库Vector DB
- 语义检索,模糊匹配记忆片段
- 典型工具:Chroma / FAISS
- 适用场景:「和上次类似的问题」等语义查询
第三种: 存关系型数据库Relational DB
- 结构化查询,复杂关系建模
- 典型工具:PostgreSQL / SQLite
- 适用场景:多表关联的业务数据
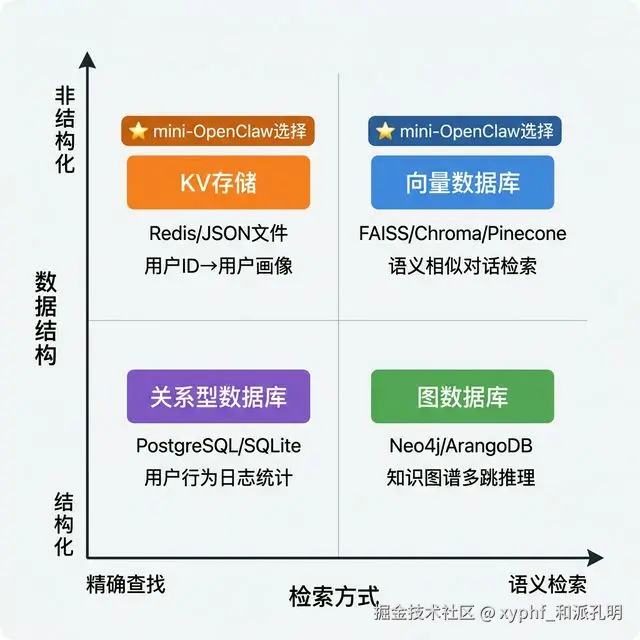
如何选择长期记忆存储引擎
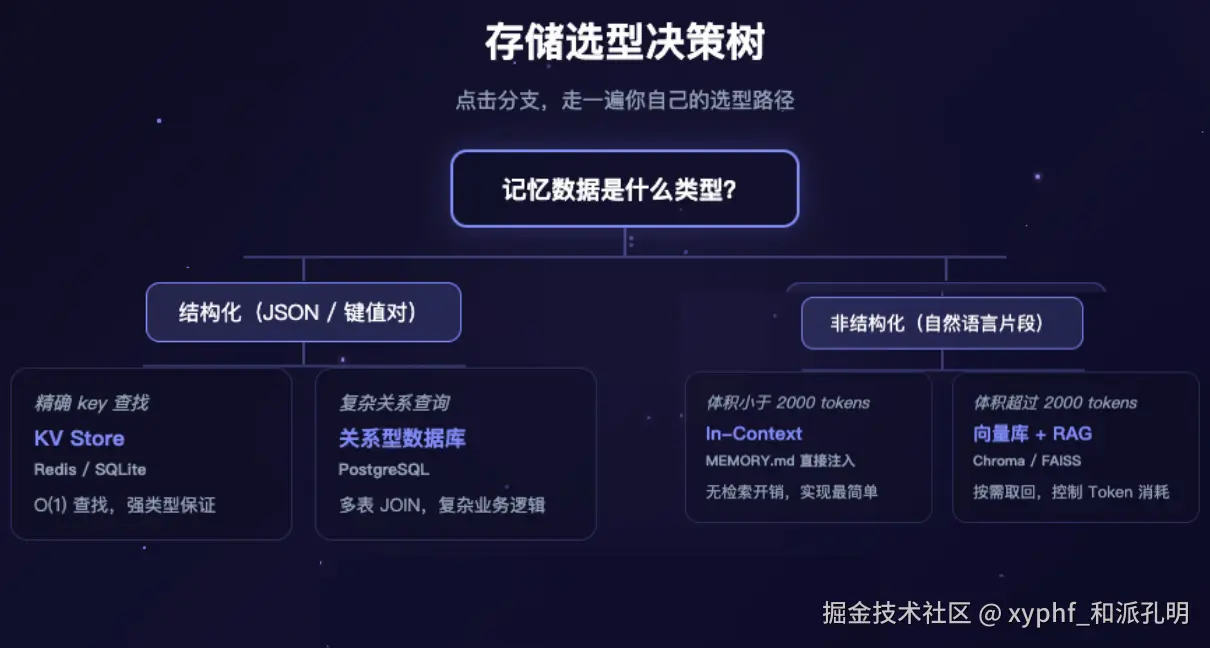
向量数据库介绍:语义相似度检索
向量数据库是长期记忆系统中最核心、也最容易被误解的存储类型。它解决的问题是:当用户说「上次我提到的那个 Python 项目」时,Agent 怎么在几百条历史记忆中找到相关片段------即便用户的措辞和原始记忆里的文字完全不同。
它的工作机制分三步:首先用 Embedding 模型将文本转换为高维向量(比如 1536 维的浮点数数组),代表文本的「语义位置」;然后把所有记忆条目的向量存入向量索引;检索时,将用户 query 转换为同维度向量,计算它与所有存储向量的距离(通常是余弦相似度或 L2 距离),返回距离最近的 Top-K 条记忆。关键洞察:向量距离近 = 语义相近,而不是字面相近。「想吃东西」和「有点饿了」在向量空间里距离很近,传统关键词搜索找不到,向量检索能找到。
举例,我们可以使用 LlamaIndex 的 VectorStoreIndex 配合 OpenAIEmbedding 实现向量检索。这里我们完全复用源项目的技术栈------用 SentenceSplitter 切分文档、用 VectorStoreIndex 构建索引、用 as_retriever 执行语义检索,和 memory_indexer.py 中的实现方式一致:
python
from llama_index.core import Document, VectorStoreIndex
from llama_index.core.node_parser import SentenceSplitter
from llama_index.core.settings import Settings
from llama_index.embeddings.openai import OpenAIEmbedding
from dotenv import load_dotenv
import os

load_dotenv()

# 配置 Embedding 模型
# 注意:Embedding 用 OPENAI_API_KEY,与 LLM 的 DEEPSEEK_API_KEY 分开
Settings.embed_model = OpenAIEmbedding(
    model=os.getenv("EMBEDDING_MODEL", "text-embedding-3-small"),
    api_key=os.getenv("OPENAI_API_KEY"),
    api_base=os.getenv("OPENAI_BASE_URL", "https://chatapi.littlewheat.com/v1"),
)

# 构造记忆条目(模拟 Agent 积累的用户画像)
memory_texts = [
    "用户叫小明,是一名 Python 开发者,主要做数据分析",
    "用户正在学习 LangChain,上次讨论到 RAG 架构",
    "用户不喜欢 SQL,更偏向用 Pandas 处理数据",
    "用户的项目用 FastAPI 作为后端框架",
    "用户有 3 年 Python 经验,对机器学习基础了解",
]

# 用 Document + SentenceSplitter 构建索引(与 memory_indexer.py 相同流程)
docs = [Document(text=t) for t in memory_texts]
splitter = SentenceSplitter(chunk_size=256, chunk_overlap=32)
nodes = splitter.get_nodes_from_documents(docs)
index = VectorStoreIndex(nodes)
print(f"向量索引创建完成,共 {len(nodes)} 个节点")

# 语义检索:用 retriever 找最相关的 2 条记忆
retriever = index.as_retriever(similarity_top_k=2)
query = "用户用什么数据处理工具"
results = retriever.retrieve(query)

print(f"\n查询:'{query}'")
print("\n检索结果(分数越高越相似):")
for node in results:
    print(f"  [{node.score:.4f}] {node.text}")
csharp
向量索引创建完成,共 5 个节点

查询:'用户用什么数据处理工具'

检索结果(分数越高越相似):
  [0.5309] 用户不喜欢 SQL,更偏向用 Pandas 处理数据
  [0.4807] 用户叫小明,是一名 Python 开发者,主要做数据分析
执行后可以看到:即便 query「用什么数据处理工具」和记忆条目「不喜欢 SQL,更偏向用 Pandas」字面上几乎没有重叠词,向量检索仍然能把它排在前列。这正是向量数据库的核心价值所在------OpenAIEmbedding 将文本转换为真实的语义向量,语义相近的文本在向量空间中距离自然更近。retriever.retrieve 返回的 score 是余弦相似度,分数越高代表语义越相关。
图数据库:关系网络检索
图数据库解决的是「多跳关系推理」问题------当记忆内容本身存在复杂的网络关系,且你需要沿着关系路径查询时,向量库和 KV 存储都无法胜任。典型场景:「小明的导师的研究方向是什么」、「和小明协作过的同事都用什么技术栈」------这类查询需要跨越多个节点和边,只有图数据库的图遍历算法才能高效处理。
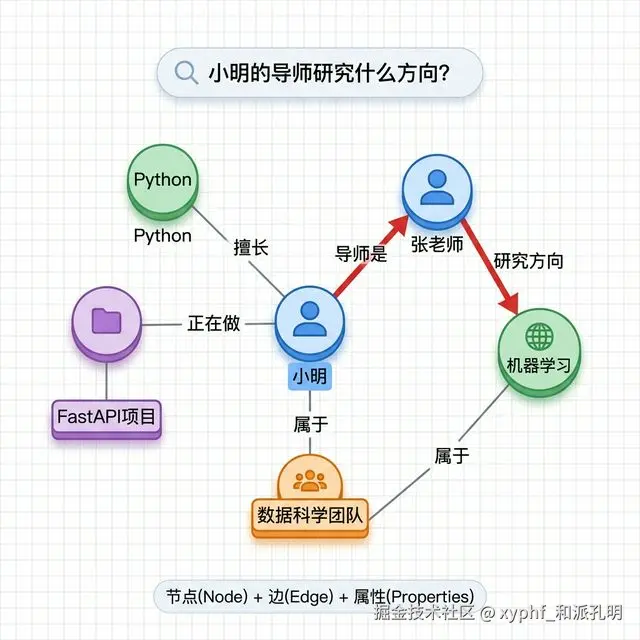
图数据库的数据模型是节点(Node)+ 边(Edge)+ 属性(Properties)。节点代表实体(人、概念、项目),边代表关系(认识、使用、属于),属性是附加的元数据(姓名、时间、权重)。Neo4j 是最主流的图数据库,使用 Cypher 查询语言,语法类似 SQL 但专为图遍历设计。
何时应该考虑图数据库:当你的 Agent 需要管理复杂的知识图谱(如企业内部知识库、学术文献关系网络),或者记忆条目之间存在大量显式关联关系(「A 是 B 的上级」「C 和 D 曾经合作过项目 E」),且需要频繁沿这些关系路径查询时,图数据库是合适的选择。对于大多数对话 Agent,向量库已经足够。