目录
- [1 题目](#1 题目)
- [2 建表语句](#2 建表语句)
- [3 题解](#3 题解)
1 题目
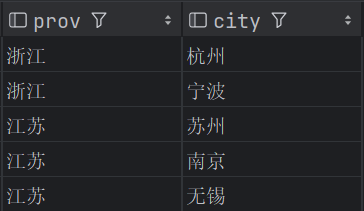
现有各省地级市的gdp数据,求从高到底累加刚好超过各省GDP40%的地市名称,临界地市也需要。例如:
浙江省的杭州24% 宁波 20% ,杭州+宁波=44% 大于40% 取出杭州、宁波
江苏省的苏州19% 南京 14% 无锡 12%,苏州+南京=33% ,苏州+南京+无锡=45%,取出 苏州、南京、无锡。
+-------+-------+-----------+
| prov  | city  |  gdp_amt  |
+-------+-------+-----------+
| 浙江    | 杭州    | 20059.00  |
| 浙江    | 宁波    | 16452.80  |
| 浙江    | 温州    | 8730.60   |
| 浙江    | 绍兴    | 7791.00   |
| 浙江    | 嘉兴    | 7062.45   |
| 浙江    | 台州    | 6240.68   |
| 浙江    | 金华    | 6011.27   |
| 浙江    | 湖州    | 4015.10   |
| 浙江    | 衢州    | 2125.20   |
| 浙江    | 舟山    | 2100.80   |
| 浙江    | 丽水    | 1964.40   |
| 江苏    | 苏州    | 24653.37  |
| 江苏    | 南京    | 17421.40  |
| 江苏    | 无锡    | 15456.19  |
| 江苏    | 南通    | 11813.27  |
| 江苏    | 常州    | 10116.36  |
| 江苏    | 徐州    | 8900.44   |
| 江苏    | 扬州    | 7423.26   |
| 江苏    | 盐城    | 7403.87   |
| 江苏    | 泰州    | 6731.66   |
| 江苏    | 镇江    | 5264.07   |
| 江苏    | 淮安    | 5015.06   |
| 江苏    | 宿迁    | 4398.07   |
| 江苏    | 连云港   | 4363.61   |
+-------+-------+-----------+
2 建表语句
sql
--建表语句
CREATE TABLE t_gdp (
prov string COMMENT '省份',
city string COMMENT '城市',
gdp_amt decimal(10,2) comment  'GDP'
) COMMENT '各省地市GDP'
ROW FORMAT DELIMITED FIELDS TERMINATED BY '\t'
;
--插入数据
insert  into t_gdp(prov,city,gdp_amt)
values
('浙江','杭州',20059),
('浙江','宁波',16452.8),
('浙江','温州',8730.6),
('浙江','绍兴',7791),
('浙江','嘉兴',7062.45),
('浙江','台州',6240.68),
('浙江','金华',6011.27),
('浙江','湖州',4015.1),
('浙江','衢州',2125.2),
('浙江','舟山',2100.8),
('浙江','丽水',1964.4),
('江苏','苏州',24653.37),
('江苏','南京',17421.4),
('江苏','无锡',15456.19),
('江苏','南通',11813.27),
('江苏','常州',10116.36),
('江苏','徐州',8900.44),
('江苏','扬州',7423.26),
('江苏','盐城',7403.87),
('江苏','泰州',6731.66),
('江苏','镇江',5264.07),
('江苏','淮安',5015.06),
('江苏','宿迁',4398.07),
('江苏','连云港',4363.61);
3 题解
第一步:计算每个城市占比,累积占比。
sql
select
    *,
    round(lj_gdp_amt/pro_gdp_amt,2) lj_precent
from
    (select
        *,
        sum(gdp_amt) over(partition by prov) pro_gdp_amt,
        sum(gdp_amt) over(partition by prov order by gdp_amt) lj_gdp_amt
    from t_gdp)t
执行结果

第二步:求取累加求和 <60% 的数据
sql
select
    *,
    round(lj_gdp_amt/pro_gdp_amt,2) lj_precent
from
    (select
        *,
        sum(gdp_amt) over(partition by prov) pro_gdp_amt,
        sum(gdp_amt) over(partition by prov order by gdp_amt) lj_gdp_amt
    from t_gdp)t
where round(lj_gdp_amt/pro_gdp_amt,2)<0.6; -- 不能写 lj_precent <0.6
执行结果

第三步:求补集,得到最后结果。
sql
select
    t1.prov,
    t1.city
from
    t_gdp t1
left join
    (select
        *,
        round(lj_gdp_amt/pro_gdp_amt,2) lj_precent
    from
        (select
            *,
            sum(gdp_amt) over(partition by prov) pro_gdp_amt,
            sum(gdp_amt) over(partition by prov order by gdp_amt) lj_gdp_amt
        from t_gdp)t
    where round(lj_gdp_amt/pro_gdp_amt,2)<0.6)t2
on t1.prov=t2.prov and t1.city=t2.city
where t2.city is null;
执行结果