Python学习从0开始------Kaggle特征工程001
- 一、什么是特征工程
- 二、互信息
- 三、创建特征
- [四、使用 K-Means 进行聚类](#四、使用 K-Means 进行聚类)
- 五、主成分分析PCA
- 六、目标编码
一、什么是特征工程
1.目标
特征工程的目标仅仅是使你的数据更适合手头的问题。考虑"表观温度"测量,如热指数和风寒。这些量试图根据空气温度、湿度和风速来测量人类感知的温度,这些都是我们可以直接测量的。你可以把表面温度看作是一种特征工程的结果,它试图使观察到的数据与我们真正关心的东西更相关:外界的实际感觉。执行特征工程来:提高模型的预测性能,减少计算或数据需求,提高结果的可解释性。
2.指导原则
对于有用的特征,它必须与模型能够学习的目标有关系。例如,线性模型只能学习线性关系。因此,当使用线性模型时,你的目标是转换特征以使它们与目标的关系成为线性的。
这里的关键思想是,应用于特性的转换实质上成为模型本身的一部分。比方说,你试图从一块土地的边长来预测一块土地的价格。将线性模型直接拟合到Length会得到很差的结果:关系不是线性的。
然而,如果我们将长度特征平方得到"面积",我们就创造了一个线性关系。向特征集添加面积意味着这个线性模型现在可以拟合抛物线。换句话说,对特征进行平方,使线性模型具有拟合平方特征的能力。
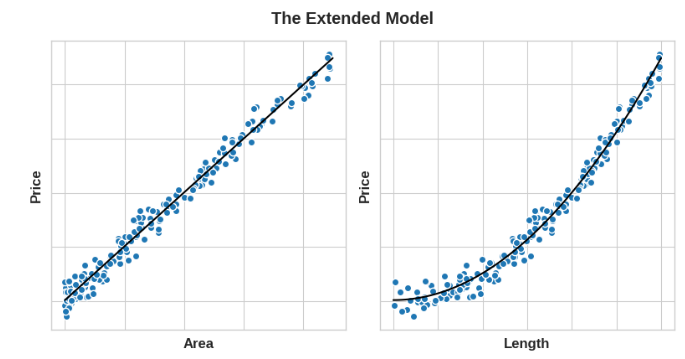
这将向你展示为什么在特征工程上投入的时间可以获得如此高的回报。无论你的模型无法学习到什么关系,你都可以转换并提供给自己。在开发特性集时,请考虑可以使用哪些信息来实现最佳性能。
3.举例
为了说明这些想法,我们将看到如何向数据集添加一些合成特征来提高随机森林模型的预测性能。混凝土数据集包含各种混凝土配方和最终产品的抗压强度,这是衡量这种混凝土可以承受多少载荷的一种措施。该数据集的任务是预测给定其配方的混凝土的抗压强度。
python
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import cross_val_score

df = pd.read_csv("../input/fe-course-data/concrete.csv")
df.head()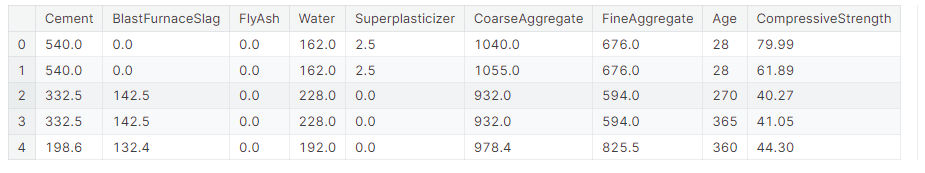
你可以在这里看到每种混凝土的不同成分。我们将首先通过在未增强的数据集上训练模型来建立基线。这将帮助我们确定新功能是否真的有用。在特征工程过程开始时建立这样的基线是一种很好的实践。基线分数可以帮助你决定新功能是保留,还是尝试其他方法。
python
X = df.copy()
y = X.pop("CompressiveStrength")

# 训练和评分基线模型
baseline = RandomForestRegressor(criterion="absolute_error", random_state=0)
baseline_score = cross_val_score(
    baseline, X, y, cv=5, scoring="neg_mean_absolute_error"
)
baseline_score = -1 * baseline_score.mean()

print(f"MAE Baseline Score: {baseline_score:.4}")

--------------输出-----------------------
MAE Baseline Score: 8.232
下面的单元格向数据集添加了三个新的特征:
python
X = df.copy()
y = X.pop("CompressiveStrength")

# 创建特征
X["FCRatio"] = X["FineAggregate"] / X["CoarseAggregate"]
X["AggCmtRatio"] = (X["CoarseAggregate"] + X["FineAggregate"]) / X["Cement"]
X["WtrCmtRatio"] = X["Water"] / X["Cement"]

# 使用额外的特征在数据集上训练和评分模型
model = RandomForestRegressor(criterion="absolute_error", random_state=0)
score = cross_val_score(
    model, X, y, cv=5, scoring="neg_mean_absolute_error"
)
score = -1 * score.mean()

print(f"MAE Score with Ratio Features: {score:.4}")

----------------------输出------------------------
MAE Score with Ratio Features: 7.948
性能提高了,这些新的特征向模型暴露了以前没有检测到的重要信息。
二、互信息
1.介绍
首次遇到新数据集时,的第一步是,根据特征效用度量(衡量特征与目标之间关联性的函数)构建一个排名。然后,你可以选择最初开发最有用的特征子集,并更有信心你的时间将得到充分利用。我们将使用的度量标准称为"互信息"。互信息与相关性非常相似,都衡量两个量之间的关系。互信息的优势在于,它可以检测任何类型的关系,而相关性只能检测线性关系。互信息是一个很好的通用度量标准,尤其在不知道要使用什么模型的特征开发初期非常有用。它具有以下特点:易用且易于解释,计算效率高,理论上依据充分,抗过拟合,并能检测任何类型的关系。
2.衡量标准
互信息用不确定性来描述关系。两个量之间的互信息(MI)是对一个量的知识减少另一个量的不确定性程度的度量。

这是艾姆斯住房数据的一个例子。该图显示了房屋外观质量与售价之间的关系。每个点代表一个房子。从图中我们可以看出,知道了ExterQual的值,你就会更加确定对应的SalePrice------每个类别的ExterQual都倾向于将SalePrice集中到一定的范围内。ExterQual与SalePrice之间的互信息是SalePrice在四个external值上的不确定性减少的平均值。例如,由于"公平"的出现频率低于"典型",因此"公平"在MI得分中的权重较低。
我们所说的不确定性是用信息论中的"熵"来衡量的。一个变量的熵大致意味着:"平均而言,你需要多少个是或否的问题来描述该变量的一次出现。"你要问的问题越多,你对变量的不确定性就越大。互信息是指你希望这个特征能回答多少个关于目标的问题。
3.解读
数量之间最小可能的互信息是0.0。当MI为零时,这两个量是独立的:任何一个都不能告诉你关于另一个的任何信息。相反,理论上MI没有上限。但在实践中,高于2.0左右的值并不常见。(互信息是一个对数量,所以它的增长非常缓慢。)下一个图显示MI值如何对应于特征与目标的关联类型和程度。

在应用互信息时,需要记住以下几点:
- MI可以帮助你理解单个特征作为目标预测器的相对潜力。
- 在与其他功能交互时,一个功能可能提供非常丰富的信息,但单独提供的信息并不多。人工智能无法检测功能之间的交互。它是一个单变量度规。功能的实际用途取决于与之一起使用的模型。
- 一个特征只有在它与目标的关系是你的模型可以学习的范围内才有用。只有一个特征具有较高的MI得分并不意味着你的模型将能够使用该信息做任何事情。你需要首先转换特性以公开关联。
4.示例
python
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns

plt.style.use("seaborn-whitegrid")

df = pd.read_csv("../input/fe-course-data/autos.csv")
df.head()
人工智能的scikit-learn算法将离散特征与连续特征区别对待。因此,你需要告诉它哪个是哪个。根据经验,任何必须具有float类型的东西都不是离散的。通过给范畴(对象或范畴d型)一个标签编码,它们可以被视为离散的。
python
X = df.copy()
y = X.pop("price")

# 分类的标签编码
for colname in X.select_dtypes("object"):
    X[colname], _ = X[colname].factorize()

# 所有离散特征现在都应该具有整数dtypes
discrete_features = X.dtypes == int
Scikit-learn在其feature_selection模块中有两个互信息度量:一个用于实值目标(mutual_info_regression),另一个用于分类目标(mutual_info_classif)。我们的目标价格是实际值,下一个单元计算我们的特征的MI分数,并将它们封装在一个数据框中。
python
from sklearn.feature_selection import mutual_info_regression

def make_mi_scores(X, y, discrete_features):
    mi_scores = mutual_info_regression(X, y, discrete_features=discrete_features)
    mi_scores = pd.Series(mi_scores, name="MI Scores", index=X.columns)
    mi_scores = mi_scores.sort_values(ascending=False)
    return mi_scores

mi_scores = make_mi_scores(X, y, discrete_features)
mi_scores[::3]  # 用他们的MI分数来展示一些特征

------------------输出-------------------------------
curb_weight          1.540126
highway_mpg          0.951700
length               0.621566
fuel_system          0.485085
stroke               0.389321
num_of_cylinders     0.330988
compression_ratio    0.133927
fuel_type            0.048139
Name: MI Scores, dtype: float64
python
def plot_mi_scores(scores):
    scores = scores.sort_values(ascending=True)
    width = np.arange(len(scores))
    ticks = list(scores.index)
    plt.barh(width, scores)
    plt.yticks(width, ticks)
    plt.title("Mutual Information Scores")

#  可视化展示
plt.figure(dpi=100, figsize=(8, 5))
plot_mi_scores(mi_scores)
# 高分的curb_weight特征与目标价格表现出很强的关系。
sns.relplot(x="curb_weight", y="price", data=df);

sns.lmplot(x="horsepower", y="price", hue="fuel_type", data=df);


fuel_type特性的MI得分相当低,但是从图中可以看出,它在马力特性中清楚地区分了两个具有不同趋势的价格群体。这表明fuel_type有助于产生交互效果,并且可能并非不重要。在根据MI分数决定一个功能是否不重要之前,最好先调查一下任何可能的交互效果------相关的领域知识有助于识别。
三、创建特征
1.数字变换
在Automobile数据集中是描述汽车引擎的特征。研究产生了各种各样的公式来创建潜在有用的新功能。组合越复杂,模型学习起来就越困难,就像下面这个计算引擎"排量"(衡量引擎功率的一种方法)的公式:
python
autos["displacement"] = (
    np.pi * ((0.5 * autos.bore) ** 2) * autos.stroke * autos.num_of_cylinders
)
数据可视化可以建议转换,通常是通过幂或对数对特征进行"重塑"。例如,风速在美国事故中的分布是高度倾斜的。在这种情况下,可以使用对数规范化:
python
# 如果特征值为0.0,则使用np.log1p (log(1+x))而不是np.log
accidents["LogWindSpeed"] = accidents.WindSpeed.apply(np.log1p)

# Plot a comparison
fig, axs = plt.subplots(1, 2, figsize=(8, 4))
sns.kdeplot(accidents.WindSpeed, shade=True, ax=axs[0])
sns.kdeplot(accidents.LogWindSpeed, shade=True, ax=axs[1]);
2.计数
描述某物存在或不存在的特征通常以集合的形式出现,比如一种疾病的风险因素集合。你可以通过创建计数来聚合这些特性。这些特征将是二进制(1表示存在,0表示缺席)或布尔(True或False)。在Python中,布尔值可以像整数一样相加。在交通事故中,有几个特征表明事故附近是否有道路物体。这将使用sum方法创建一个附近道路特征总数的计数:
python
roadway_features = ["Amenity", "Bump", "Crossing", "GiveWay",
    "Junction", "NoExit", "Railway", "Roundabout", "Station", "Stop",
    "TrafficCalming", "TrafficSignal"]
accidents["RoadwayFeatures"] = accidents[roadway_features].sum(axis=1)

accidents[roadway_features + ["RoadwayFeatures"]].head(10)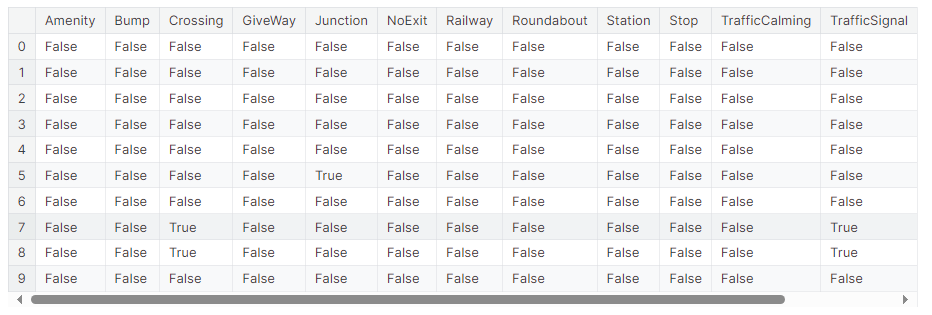
还可以使用数据框架的内置方法来创建布尔值。在Concrete数据集中,是具体配方中成分的数量。许多公式缺少一个或多个组件(也就是说,组件的值为0)。这将使用数据框架的内置大于方法"gt"计算公式中有多少组件:
python
components = [ "Cement", "BlastFurnaceSlag", "FlyAsh", "Water",
               "Superplasticizer", "CoarseAggregate", "FineAggregate"]
concrete["Components"] = concrete[components].gt(0).sum(axis=1)

concrete[components + ["Components"]].head(10)
3.构建和分解功能
一些复杂的字符串可以拆分:
- ID numbers: '123-45-6789'
- Phone numbers: '(999) 555-0123'
- Street addresses: '8241 Kaggle Ln., Goose City, NV'
- Internet addresses: 'http://www.kaggle.com
- Product codes: '0 36000 29145 2'
- Dates and times: 'Mon Sep 30 07:06:05 2013'
像这样的特征通常会有一些你可以利用的结构。例如,美国的电话号码有一个区号("999"部分),告诉你打电话的人的位置。str访问器允许split等操作字符串的方法用在列上。Customer Lifetime Value数据集包含描述保险公司客户的特征。在Policy特性中,我们可以将Type从覆盖级别中分离出来:
python
customer[["Type", "Level"]] = (  # 创建两个新特性
    customer["Policy"]           # 来自Policy特性
    .str                         # 通过字符串访问器
    .split(" ", expand=True)     # 通过" "分割
                                 # 并将结果扩展为单独的列
)

customer[["Policy", "Type", "Level"]].head(10)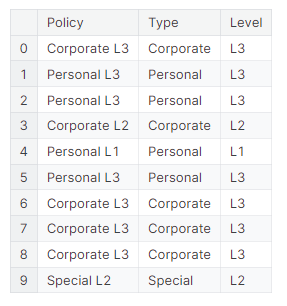
也可以将简单的功能连接到一个组合功能中:
python
autos["make_and_style"] = autos["make"] + "_" + autos["body_style"]
autos[["make", "body_style", "make_and_style"]].head()
4.组转换
最后,我们有Group转换,它跨按某种类别分组的多行聚合信息。通过群变换,你可以创建这样的功能:"一个人居住州的平均收入",或者"按类型划分,工作日上映的电影比例"。如果已经发现了一种相互影响的类别,那么在该类别上进行组转换可能是一个很好的研究对象。
使用聚合函数,组转换结合了两个特性:提供分组的分类特性和希望聚合其值的另一个特性。对于"按州划分的平均收入",可以选择state作为分组特征,mean作为聚合功能,income作为聚合特征。为了在Pandas中计算这个,我们使用groupby和transform方法:
python
customer["AverageIncome"] = (
    customer.groupby("State")  # 对于每个州
    ["Income"]                 # 选择收入
    .transform("mean")         # 并计算其均值
)

customer[["State", "Income", "AverageIncome"]].head(10)
mean函数是一个内置的数据框架方法,这意味着我们可以将它作为字符串传递给transform。还有max、min、median、var、std和count等方法可以使用。
可以使用这样的转换来为分类特征创建"频率编码":
python
customer["StateFreq"] = (
    customer.groupby("State")
    ["State"]
    .transform("count")
    / customer.State.count()
)
如果正在使训练和验证分离,为了保持它们的独立性,最好只使用训练集创建分组特征,然后将其加入验证集。我们可以在训练集上使用drop_duplicate创建一个唯一的值集后使用验证集的merge方法:
python
# 创建拆分
df_train = customer.sample(frac=0.5)
df_valid = customer.drop(df_train.index)

# 在训练集上按覆盖类型创建average claim
df_train["AverageClaim"] = df_train.groupby("Coverage")["ClaimAmount"].transform("mean")

# 将这些值合并到验证集中
df_valid = df_valid.merge(
    df_train[["Coverage", "AverageClaim"]].drop_duplicates(),
    on="Coverage",
    how="left",
)

df_valid[["Coverage", "AverageClaim"]].head(10)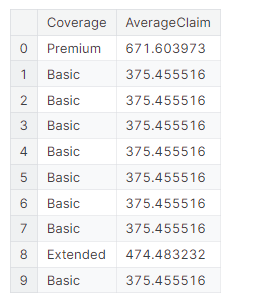
5.提示
在创建特性时,最好记住模型自身的优点和缺点。以下是一些指导原则:
- 线性模型自然地学习和和和差,但不能学习更复杂的东西。
- 对于大多数模型来说,比率似乎很难掌握。比率组合通常会带来一些简单的性能提升。
- 线性模型和神经网络通常能更好地处理归一化特征。神经网络尤其需要将特征缩放到离0不远的值。基于树的模型(如随机森林和XGBoost)有时可以从规范化中获益,但通常情况下获益较少。
- 树模型可以学习近似几乎任何特征的组合,但是当一个组合特别重要时,它们仍然可以从显式创建中受益,特别是在数据有限的情况下。
- 计数对树模型特别有帮助,因为这些模型没有一种自然的方式来一次跨许多特征聚合信息。
四、使用 K-Means 进行聚类
1.介绍
四和五将使用无监督学习算法,无监督算法不利用目标,它们的目的是学习数据的一些属性,以某种方式表示特征的结构。在用于预测的特征工程上下文中,可以将无监督算法视为"特征发现"技术。聚类仅仅意味着根据数据点彼此的相似程度将数据点分配给组。可以说,聚类算法使"物以类聚"。当用于特征工程时,我们可以尝试发现代表市场细分的客户组,例如,或具有相似天气模式的地理区域。添加聚类标签的特征可以帮助机器学习模型理清复杂的空间或邻近关系。
2.集群标签作为特征
应用于单个实值特征,聚类就像传统的"分箱binning"或"离散化discretization"变换。在多个特征上,它类似于"多维分仓multi-dimensional binning"(有时称为矢量量化vector quantization)。
添加聚类标签的动机是,聚类将把特征之间复杂的关系分解成更简单的块。这样,我们的模型就可以一个接一个地学习更简单的块,而不必一次学习复杂的整体。这是一个"分而治之"的策略。

该图显示了聚类如何改进一个简单的线性模型。YearBuilt和SalePrice之间的曲线关系对于这种模型来说太复杂了------它不够拟合。然而,在较小的块上,这种关系几乎是线性的,并且模型可以很容易地学习。
3.k-means聚类
聚类算法有很多。它们的主要区别在于如何衡量"相似性"或"接近性",以及它们使用的是哪种特征。我们将使用的算法k-means直观且易于应用于特征工程上下文中。使用时根据情况选择合适的算法。
K-means聚类使用普通直线距离(即欧几里得距离)度量相似性。它通过在特征空间中放置一些称为质心的点来创建集群。数据集中的每个点都被分配到最接近它的质心的聚类中。"k-means"中的"k"表示它创建了多少个质心(即簇),需要自己定义k。
你可以想象每个质心通过一系列辐射圆捕获点。当来自竞争质心的一组圆重叠时,它们形成一条线。结果就是所谓的Voronoi镶嵌。图中显示了未来的数据将分配给哪些集群;tessallation本质上是k-means从训练数据中学到的东西。

重点关注scikit-learn实现中的三个参数:n_clusters, max_iter, n_init。
这是一个简单的两步过程。该算法首先随机初始化一些预定义的质心数量(n_clusters)。然后迭代这两个操作:
- 将点分配到最近的聚类质心
- 移动每个质心以最小化到其点的距离
它迭代这两个步骤,直到质心不再移动,或者直到某个最大迭代次数(max_iter)通过。通常情况下,质心的初始随机位置会导致聚类效果不佳。由于这个原因,算法重复多次(n_init)并返回每个点与其质心之间总距离最小的聚类,即最优聚类。
对于大量的集群,可能需要增加max_iter,对于复杂的数据集,可能需要增加n_init。通常需要自己选择的唯一参数是n_clusters(即k)。一组特征的最佳划分取决于使用的模型和预测的内容,因此最好像调优任何超参数一样调优它(例如,通过交叉验证)。
4.使用
使用California Housing数据集,在这个例子中,我们将把这些数据与"中等收入MedInc"聚集在一起,以创建加州不同地区的经济细分。
python
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns
from sklearn.cluster import KMeans

plt.style.use("seaborn-whitegrid")
plt.rc("figure", autolayout=True)
plt.rc(
    "axes",
    labelweight="bold",
    labelsize="large",
    titleweight="bold",
    titlesize=14,
    titlepad=10,
)

df = pd.read_csv("../input/fe-course-data/housing.csv")
X = df.loc[:, ["MedInc", "Latitude", "Longitude"]]
X.head()
由于k-means聚类对规模很敏感,因此重新缩放或规范化极值数据是一个较好的选择。我们的特征已经大致处于相同的规模,所以保持原样就行。
python
# 创建集群特性
kmeans = KMeans(n_clusters=6)
X["Cluster"] = kmeans.fit_predict(X)
X["Cluster"] = X["Cluster"].astype("category")

X.head()
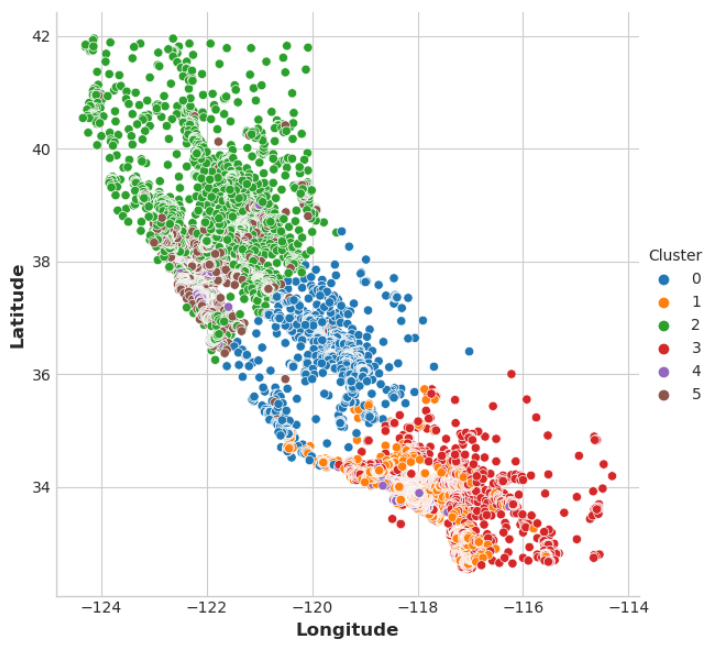
现在看几个图,首先是显示集群地理分布的散点图。该算法似乎为沿海地区的高收入地区创建了单独的细分市场:
python
sns.relplot(
    x="Longitude", y="Latitude", hue="Cluster", data=X, height=6,
);
这个数据集的目标是MedHouseVal(房屋中值)。下图显示了目标在每个集群中的分布。如果聚类是信息性的,那么这些分布在大多数情况下应该在MedHouseVal中分开,这确实是我们所看到的:
python
X["MedHouseVal"] = df["MedHouseVal"]
sns.catplot(x="MedHouseVal", y="Cluster", data=X, kind="boxen", height=6);
五、主成分分析PCA
就像聚类是基于接近度对数据集进行分区一样,可以将PCA视为数据变化的分区。PCA是一种常用的统计分析方法,用于降低数据维度并发现数据中的主要变化模式。它通过线性变换将原始数据转换为一组互相不相关的主成分,以便更好地理解和解释数据,可以帮助发现数据中的重要关系,也可以用来创建更多信息丰富的特征。(PCA通常应用于标准化数据。对于标准化数据,"变化"意味着"相关"。对于未标准化的数据,"变化"意味着"协方差"。)
1.PCA介绍
在Abalone数据集中,是对几千只塔斯马尼亚鲍鱼的物理测量。我们现在只看几个特征:它们外壳的"高度"和"直径"。想象在这些数据中有"变异轴"来描述鲍鱼彼此之间的差异。从图形上看,这些轴表现为沿着数据的自然维度运行的垂直线,每个轴代表一个原始特征。
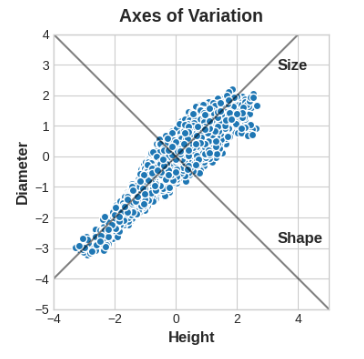
我们可以给这些变化轴命名,将较长的轴称为"Size"组件:小高度和小直径(左下)与大高度和大直径(右上)形成对比,将较短的轴称为"形状"组件:小高度和大直径(扁平形状)与大高度和小直径(圆形)形成对比。注意,我们可以用"大小"和"形状"来描述鲍鱼,而不是用"高度"和"直径"来描述鲍鱼,这就是PCA的整个思想:不是用原始特征来描述数据,而是用它的变化轴来描述它。变分轴成为新的特征。

新的特征PCA构造实际上只是原始特征的线性组合(加权和):
python
df["Size"] = 0.707 * X["Height"] + 0.707 * X["Diameter"]
df["Shape"] = 0.707 * X["Height"] - 0.707 * X["Diameter"]
这些新特征被称为数据的主成分。重量本身称为负载。原始数据集中有多少特征,就有多少主成分:如果我们使用10个特征而不是2个,我们最终会得到10个成分。
组件的负载通过符号和幅度告诉我们它所表达的变化:

这个加载表告诉我们,在尺寸分量中,高度和直径沿同一方向变化(相同的符号),但在形状分量中,它们沿相反的方向变化(相反的符号)。在每个组件中,负载都是相同的大小,因此特性对两者的贡献是相等的。
PCA还告诉我们每个成分的变化量。从图中我们可以看到,沿着Size分量的数据比沿着Shape分量的数据变化更大。PCA通过每个组成部分的解释方差百分比来精确计算。
Size组件捕获了高度和直径之间的大部分变化。然而,重要的是要记住,一个组成部分的方差并不一定对应于它作为预测器的好坏,而是取决于你想要预测的是什么。

2.特征工程中的PCA
有两种方法可以将PCA用于特征工程。
第一种方法是将其作为一种描述技巧。由于组件告诉你变化,因而可以计算组件的MI分数,并查看哪种变化最符合预测目标。这可以为你提供创建各种特征的想法------比如,如果"尺寸"很重要,就创建"高度"和"直径"的乘积;如果"形状"很重要,就创建"高度"和"直径"的比例。也可以尝试在一个或多个高分组件上进行集群化。
第二种方法是将组件本身用作特性。由于组件直接公开数据的变化结构,因此它们通常比原始特性提供更多信息。以下是一些用例:
- 降维:当你的特征是高度冗余的(特别是多重共线性的),PCA将把冗余划分为一个或多个接近零的方差组件,然后可以删除这些组件,因为它们将包含很少或不包含信息。
- 异常检测:不寻常的变化,不明显的原始特征,将经常出现在低方差成分。这些组件可以在异常或离群值检测任务中提供大量信息。
- 降噪:一组传感器读数通常会共享一些共同的背景噪声。PCA有时可以将(信息丰富的)信号收集成较少数量的特征,而不考虑噪声,从而提高信噪比。
- 去相关:一些ML算法在处理高度相关的特征时遇到了困难。PCA将相关的特征转换为不相关的组件,这对于算法来说可能更容易处理。
在应用PCA时,有几件事要记住:PCA只适用于数字特征,比如连续的数量或计数。PCA对尺度敏感。在应用PCA之前对数据进行标准化是一种很好的做法,除非有理由不做。考虑移除或限制异常值,因为它们可能对结果产生不适当的影响。
3.举例
python
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns
from IPython.display import display
from sklearn.feature_selection import mutual_info_regression


plt.style.use("seaborn-whitegrid")
plt.rc("figure", autolayout=True)
plt.rc(
    "axes",
    labelweight="bold",
    labelsize="large",
    titleweight="bold",
    titlesize=14,
    titlepad=10,
)


def plot_variance(pca, width=8, dpi=100):
    # 创建图
    fig, axs = plt.subplots(1, 2)
    n = pca.n_components_
    grid = np.arange(1, n + 1)
    # 解释变化
    evr = pca.explained_variance_ratio_
    axs[0].bar(grid, evr)
    axs[0].set(
        xlabel="Component", title="% Explained Variance", ylim=(0.0, 1.0)
    )
    # 累积变化
    cv = np.cumsum(evr)
    axs[1].plot(np.r_[0, grid], np.r_[0, cv], "o-")
    axs[1].set(
        xlabel="Component", title="% Cumulative Variance", ylim=(0.0, 1.0)
    )
    # 设置图
    fig.set(figwidth=8, dpi=100)
    return axs

def make_mi_scores(X, y, discrete_features):
    mi_scores = mutual_info_regression(X, y, discrete_features=discrete_features)
    mi_scores = pd.Series(mi_scores, name="MI Scores", index=X.columns)
    mi_scores = mi_scores.sort_values(ascending=False)
    return mi_scores


df = pd.read_csv("../input/fe-course-data/autos.csv")
我们选择了涵盖一系列属性的四个特性。这些功能中的每一个在目标价格上都有很高的MI得分。我们将对数据进行标准化,因为这些特征在自然尺度上并不相同。
python
features = ["highway_mpg", "engine_size", "horsepower", "curb_weight"]

X = df.copy()
y = X.pop('price')
X = X.loc[:, features]

# 标准化
X_scaled = (X - X.mean(axis=0)) / X.std(axis=0)

#拟合scikit-learn的主成分估计量并创建主成分
from sklearn.decomposition import PCA

# 创建主成分
pca = PCA()
X_pca = pca.fit_transform(X_scaled)

# 转换为数据框架
component_names = [f"PC{i+1}" for i in range(X_pca.shape[1])]
X_pca = pd.DataFrame(X_pca, columns=component_names)

X_pca.head()
拟合之后,PCA实例在其components_属性中包含加载。(不幸的是,PCA的术语并不一致。我们遵循将X_pca中转换后的列称为组件的惯例,否则这些列就没有名称。)我们将在一个数据框架中封装装载。
python
loadings = pd.DataFrame(
    pca.components_.T,  # 对负载矩阵进行转置
    columns=component_names,  # 列是主成分
    index=X.columns,  # 这些行是原始特征
)
loadings
回想一下,组件加载的符号和大小告诉我们它捕获了什么样的变化。第一个组成部分(PC1)显示了燃油里程较差的大型动力车辆与燃油里程较好的小型经济车辆之间的对比。我们可以称之为"豪华/经济"轴。下图显示了我们选择的四个功能主要沿着豪华/经济轴变化:
python
plot_variance(pca);
让我们再看一下组件的MI分数。毫不奇怪,PC1具有很高的信息量,尽管其余组件尽管差异很小,但仍然与价格有显著关系。通过分析这些组件,我们可以发现奢侈品/经济型主轴未捕捉到的关系。
python
mi_scores = make_mi_scores(X_pca, y, discrete_features=False)
mi_scores

-------------------------输出----------------------------------
PC1    1.013264
PC2    0.379156
PC3    0.306703
PC4    0.203329
Name: MI Scores, dtype: float64
第三个组成部分显示了马力和车身重量之间的对比------似乎是跑车与货车之间的对比:
python
# 显示按PC3排序的数据框
idx = X_pca["PC3"].sort_values(ascending=False).index
cols = ["make", "body_style", "horsepower", "curb_weight"]
df.loc[idx, cols]
为了表达这种对比,让我们创建一个新的比率特性:
python
df["sports_or_wagon"] = X.curb_weight / X.horsepower
sns.regplot(x="sports_or_wagon", y='price', data=df, order=2);
六、目标编码
1.介绍
目标编码,是用来处理分类特征的。它是一种将类别编码为数字的方法,就像one-hot或label编码一样,不同之处在于它也使用目标来创建编码。这就是我们所说的监督特征工程技术。
目标编码是任何一种编码,它用从目标中派生的一些数字来替换特征的类别。一个简单而有效的版本是应用三中的组聚合,比如均值。这种目标编码有时被称为平均编码,应用于二进制目标,它也被称为bin计数。(可能会遇到的其他名称包括:可能性编码、影响编码和略去编码。)
2.平滑化smoothing
然而,这样的编码会带来几个问题。首先是未知类别。目标编码产生过拟合的特殊风险,这意味着它们需要在独立的"编码"分割上进行训练。将编码加入到未来的分割时,Pandas将为编码分割中没有出现的任何类别填充缺失的值。这些缺失的值,你必须以某种方式加以推测。
然后是稀有类别。当一个类别在数据集中只出现几次时,对其组计算的任何统计数据都不太可能非常准确。在汽车数据集中,mercurcy只出现一次,我们计算的"平均"价格只是那辆车的价格,这可能不能很好地代表我们未来可能看到的任何mercurcy。目标编码罕见的类别可以使过拟合的可能性更大。解决这些问题的方法是添加smoothing。这个想法是将类别内平均值与整体平均值混合在一起。很少的类别在其类别平均值上的权重较低,而缺失的类别只得到总体平均值。
python
--------------例如公式:
encoding = weight * in_category + (1 - weight) * overall
# 其中权重是根据类别频率计算的 0 到 1之间的值。
# 确定权重值的一个简单方法是计算 m 估计:
weight = n / (n + m)
# 其中n是该类别在数据中出现的总次数。参数m决定了"平滑因子"。较大的m值对总体估计具有更大的权重。
在汽车数据集中,有三辆汽车的品牌是雪佛兰。如果选择m=2.0,则雪佛兰类别将被编码为雪佛兰平均价格的60%加上总体平均价格的40%:
python
chevrolet = 0.6 * 6000.00 + 0.4 * 13285.03在为m选择一个值时,考虑你期望的类别有多嘈杂。不同品牌的汽车价格差别很大吗?你是否需要大量的数据来得到好的估计?如果是这样,最好为m选择一个更大的值,如果每个品牌的平均价格相对稳定,那么较小的价格是可以接受的。
目标编码非常适合:
- 高基数特性:具有大量类别的特性编码可能会很麻烦,单热编码会生成太多的特性,而标签编码等替代方法可能不适合该特性。目标编码使用特性最重要的属性:它与目标的关系来为类别派生数字。
- 领域驱动的特性:根据以前的经验,可能会怀疑分类特性应该很重要,即使它在特性度量中得分很低。目标编码可以帮助揭示特征的真实信息量。
3.举例
MovieLens1M数据集包含MovieLens网站用户的100万部电影评分,并描述每个用户和电影的特征:
python
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns
import warnings

plt.style.use("seaborn-whitegrid")
plt.rc("figure", autolayout=True)
plt.rc(
    "axes",
    labelweight="bold",
    labelsize="large",
    titleweight="bold",
    titlesize=14,
    titlepad=10,
)
warnings.filterwarnings('ignore')

df = pd.read_csv("../input/fe-course-data/movielens1m.csv")
df = df.astype(np.uint8, errors='ignore') # reduce memory footprint
print("Number of Unique Zipcodes: {}".format(df["Zipcode"].nunique()))

-------------------------输出--------------------
Number of Unique Zipcodes: 3439
有了超过3000个类别,Zipcode特性成为目标编码的一个很好的候选,并且这个数据集的大小(超过一百万行)意味着我们可以节省一些数据来创建编码。
首先创建一个25%的分割来训练目标编码器:
python
X = df.copy()
y = X.pop('Rating')

X_encode = X.sample(frac=0.25)
y_encode = y[X_encode.index]
X_pretrain = X.drop(X_encode.index)
y_train = y[X_pretrain.index]
scikit-learn-contrib中的category_encoders包实现了一个m-estimate编码器,我们将使用它对Zipcode特性进行编码:
python
from category_encoders import MEstimateEncoder

# 创建编码器实例。选择m来控制噪音。
encoder = MEstimateEncoder(cols=["Zipcode"], m=5.0)
# 将编码器安装在编码分割上。
encoder.fit(X_encode, y_encode)
# 对Zipcode列进行编码以创建最终的训练数据
X_train = encoder.transform(X_pretrain)
最后比较:
python
plt.figure(dpi=90)
ax = sns.distplot(y, kde=False, norm_hist=True)
ax = sns.kdeplot(X_train.Zipcode, color='r', ax=ax)
ax.set_xlabel("Rating")
ax.legend(labels=['Zipcode', 'Rating']);
编码后的Zipcode特征的分布大致遵循实际评级的分布,这意味着电影观众的评级在邮编与邮编之间存在足够的差异,因此我们的目标编码能够捕获有用的信息。