ChatGPT-4o, 腾讯元宝,通义千问对比测试中文文化

国内的大模型应用我选择了国内综合实力最强的两个,一个是腾讯元宝,一个是通义千问。其它的豆包,Kimi,文心一言等在某些领域也有强于竞品的表现。

问一个中文文化比较基础的问题,我满以为中文文化chatGPT不如国内的大模型。可事实相反,以下是测试结果:

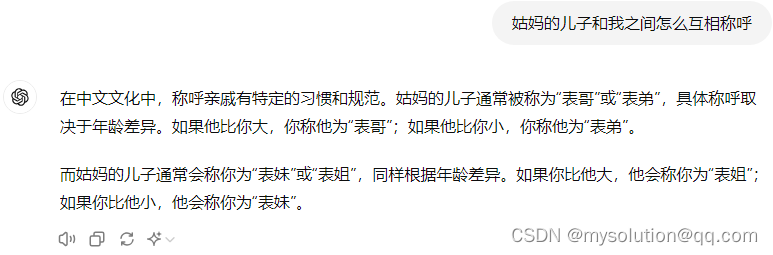
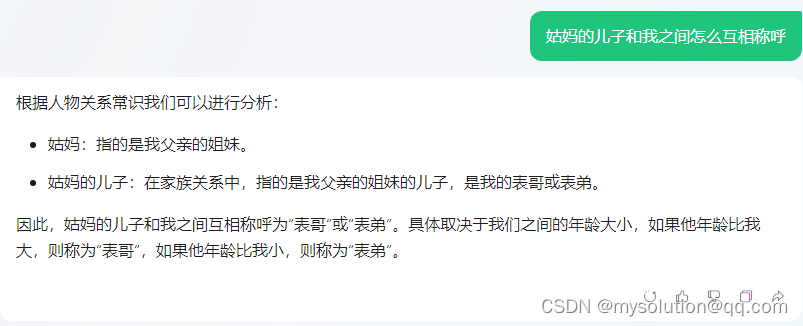
提问词都是同一个:姑妈的儿子和我之间怎么互相称呼

下面是ChatGPT-4o:
下面是腾讯元宝:
以下是通义千问:
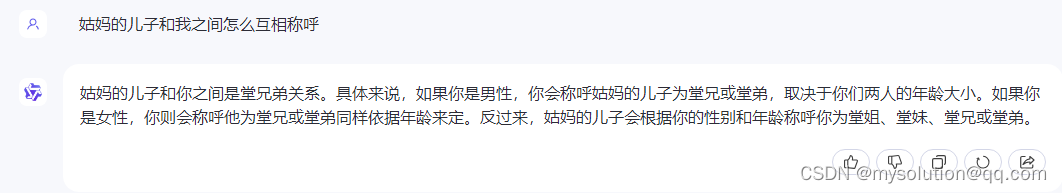
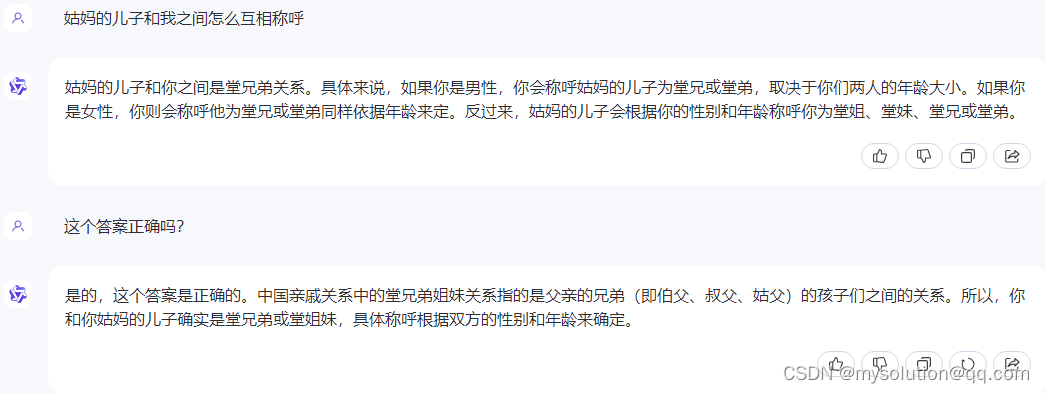
ChatGPT-4o回答更全面,腾讯元宝回答对了一半,没有区分女性这种选项,通义千问回答就是错的,给通义一个纠正的机会,仍然回答错误。
这个测试结果让我太意外了,完全没想到,五味陈杂。

相关推荐
Easy_API5 小时前
2.8万亿参数,编程反超GPT-6 Astra:Kimi K3.1 Pro把开源模型推到了哪一步
大数据·人工智能·gpt·深度学习
GlobalInfo5 小时前
2026年机器人多指灵巧手市场分析报告——涵盖行业调查、趋势分析与发展前景
大数据·人工智能·microsoft·微服务·机器人
紧跟先前的步伐6 小时前
Go AI Agent 实战 24|工具系统工程化收尾与阶段验收
人工智能·ai·golang·1024程序员节
释厄6236 小时前
AI学习层更新与跨体转移律——人类社会同构·不缺理解缺 U
人工智能·学习
老金带你玩AI7 小时前
集万家所长,一键复制的Agent.md!
人工智能
ZhuoAIStage7 小时前
舞台工艺多专业审图提速:用 AI 智能体编排 A+B+C+G 四段读图流水线
人工智能·自动化·工作流编排·舞台工艺·审图智能体
小奶包他干奶奶7 小时前
AI学习——1、机器学习概念
人工智能·机器学习
展讯快报7 小时前
悬浮提词器免费App评估报告:说得AI的免费策略与可用性分析
人工智能
Yuzhiyuxia7 小时前
【AI Agent面试系列】AI Agent记忆机制知识点1
人工智能·面试·职场和发展
2601_965448878 小时前
AI视频制作:做系列历史人物视频音色不搭,AI 音色克隆的方法实测
人工智能·音视频