如果得到的是一组样本在两个算法上的一次预测结果 ,其中每个样本都被赋予了一个为正样本的概率(例如,通过逻辑回归或朴素贝叶斯分类器得到的概率估计),那么可以通过改变不同的阈值点来利用这些预测结果画出PR曲线。
如果得到的是一组样本在两个算法上的一次预测结果 ,其中输出结果是每个样本的类别(例如决策树、支持向量机、k近邻算法),只能得到两个(R,P)点,无法直接画出完整的PR曲线,只能通过计算该情况下的fβ度量来衡量哪个算法好。
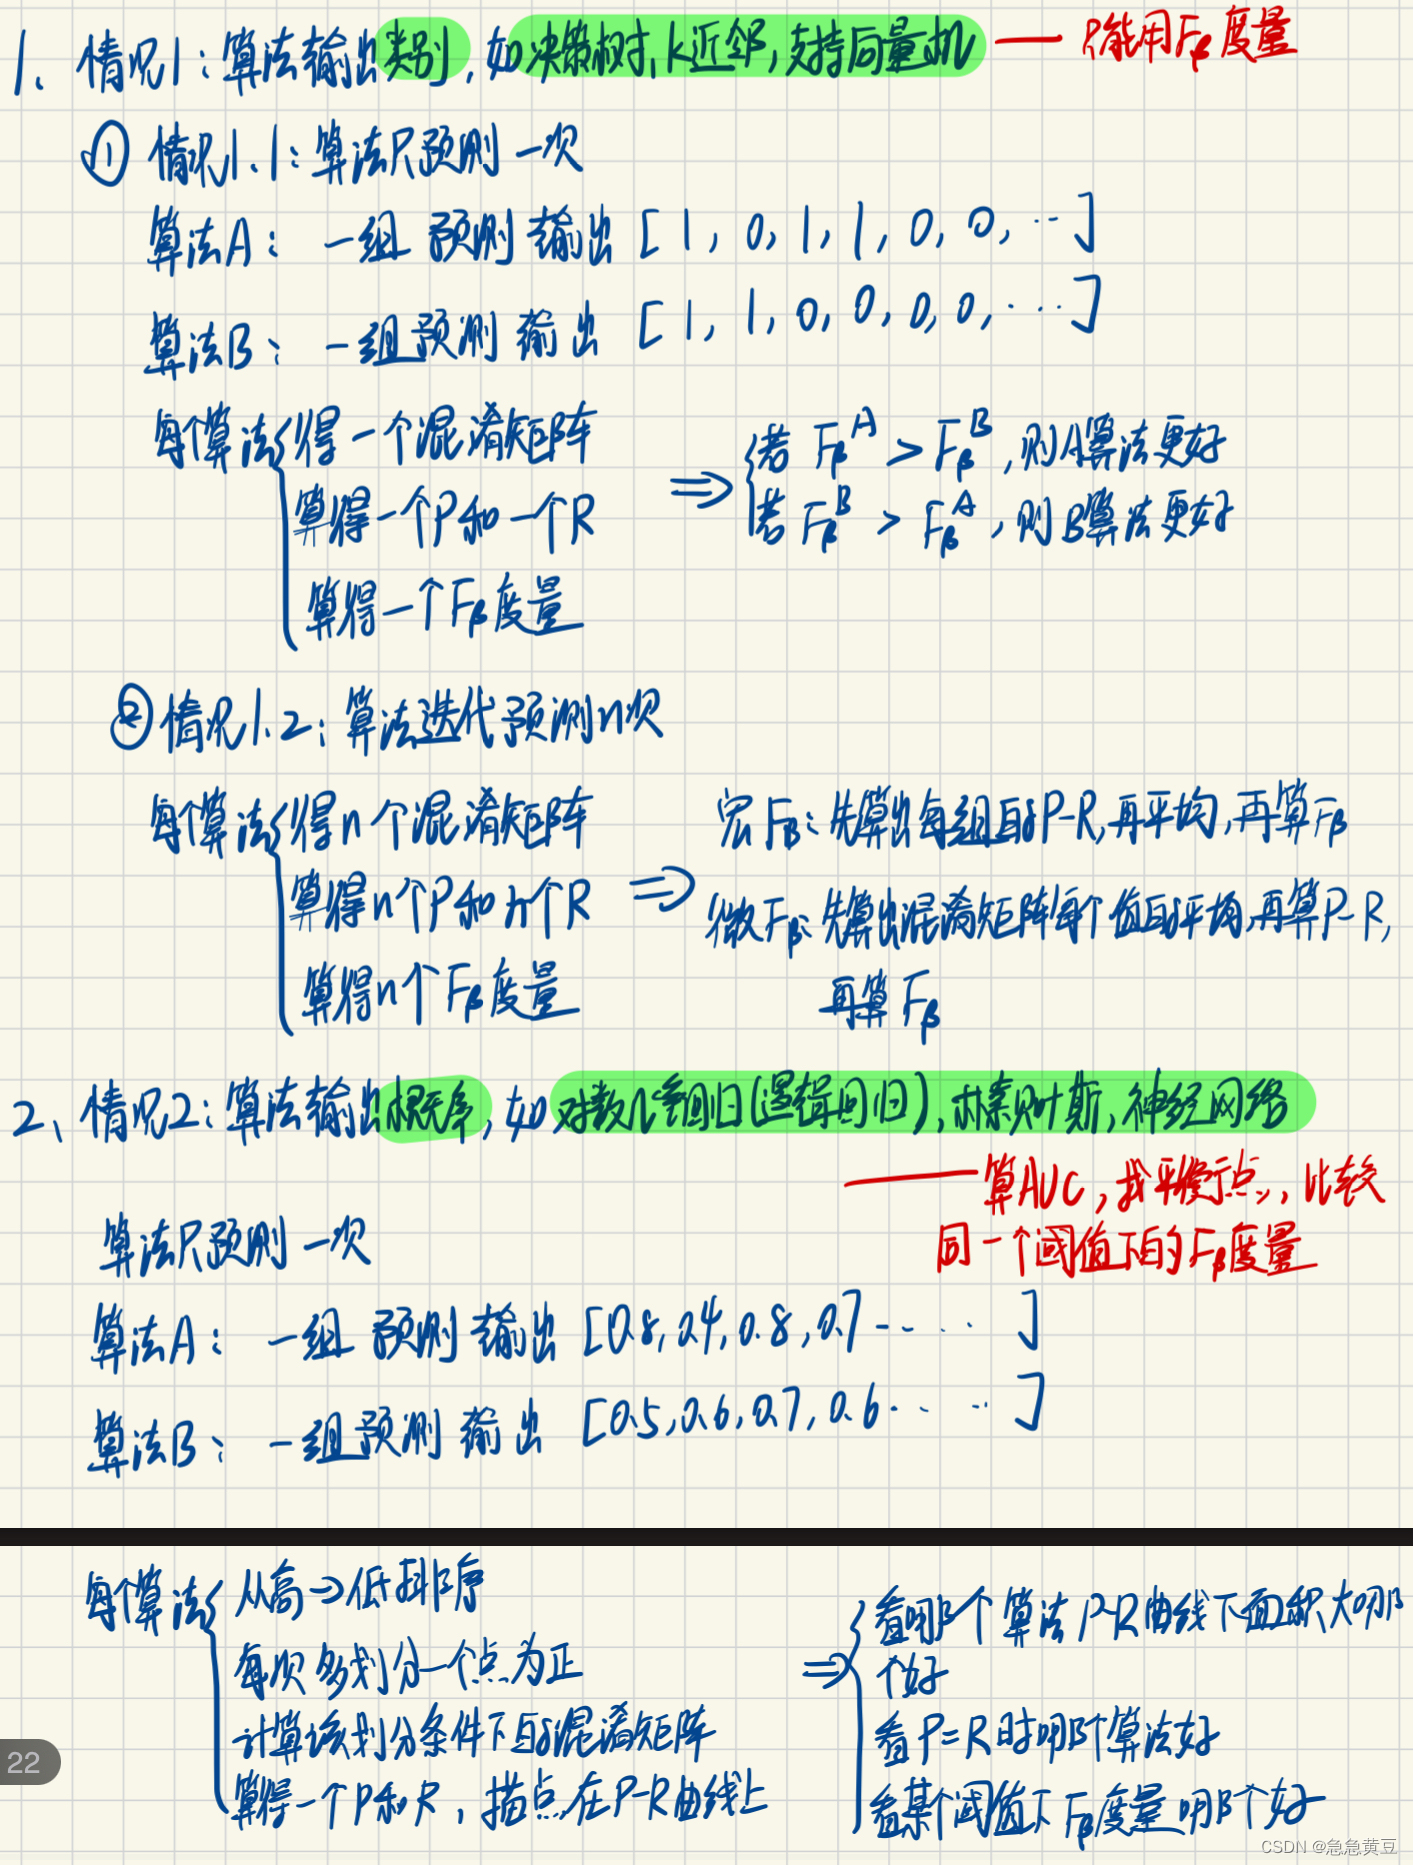
如果得到的是一组样本在两个算法上的一次预测结果 ,其中每个样本都被赋予了一个为正样本的概率(例如,通过逻辑回归或朴素贝叶斯分类器得到的概率估计),那么可以通过改变不同的阈值点来利用这些预测结果画出PR曲线。
如果得到的是一组样本在两个算法上的一次预测结果 ,其中输出结果是每个样本的类别(例如决策树、支持向量机、k近邻算法),只能得到两个(R,P)点,无法直接画出完整的PR曲线,只能通过计算该情况下的fβ度量来衡量哪个算法好。