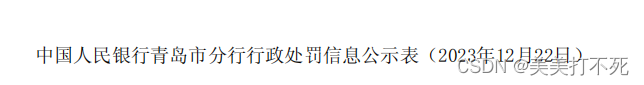
出现的问题:
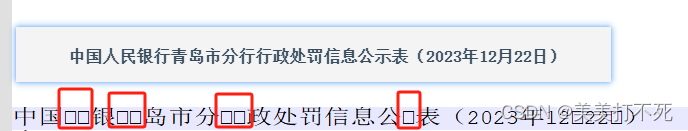
解决办法:
html
<html>
<head>
    <meta charset="UTF-8"/>
</head>
<style>
* {
    font-family:  Arial,SimSun !important;
}
</style>
</html>
在html字符串前面加上上面代码,意思是设置字体编码和样式
html示例:
html
<!DOCTYPE html>
<html>
      <head>
    <meta charset="UTF-8"/>
<style>
* {
    font-family:  Arial,SimSun;
}
</style>
</head>
 <br><br>
<body>
<table style="border:1px #A8a8a8 solid; " border="0" cellpadding="0" cellspacing="0" width="100%" bgcolor="#f4f4f4">
 <tbody>
    <table border="0" cellpadding="0" cellspacing="0" width="100%">
     <tbody>
      <tr>
       <td class="buleB16" height="80" valign="middle" align="center">中国人民银行青岛市分行行政处罚信息公示表(2023年12月22日)</td>
      </tr>
     </tbody>
  <br><br></body></html>
python代码示例:
python
import pdfkit
html_str = """上述html代码"""
# 设置wkhtmltopdf路径
config = pdfkit.configuration(wkhtmltopdf='/usr/local/bin/wkhtmltopdf')
options = {
    'encoding': "utf-8",
}
pdfkit.from_string(html_str, 'output.pdf', configuration=config, options=options)
结果如下: