最近面临导师灵魂拷问:
"你怎么知道你提出的这个方法前人都没有提出过呢?"
"你相比于之前的方法,创新点究竟在哪里?"
好吧,为了彻底杜绝这样的问题,开始学习使用谷歌学术。先来学习下关键词检索
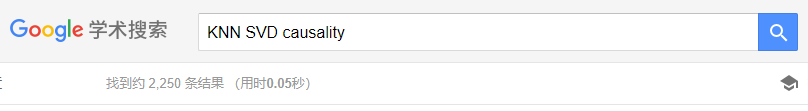
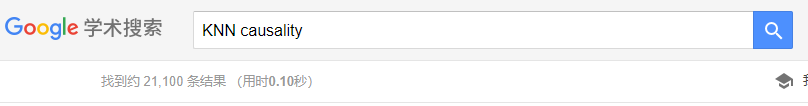
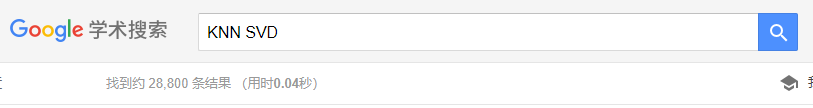
哈哈哈哈区区50000篇文章。。。。。。
我特么翻到何年何月呀!🙄
于是滋生了Python写爬虫的想法。
基本原理如下:
使用scholarly库。下面是一份简单、分步骤的指南:
-
安装
scholarly:bashpip install scholarly -
编写Python脚本:
pythonfrom scholarly import scholarly # 搜索关键词 搜索查询 = scholarly.search_pubs('你感兴趣的关键词') # 检索前5个结果 for i in range(5): 出版物 = next(搜索查询) 标题 = 出版物['bib']['title'] 作者 = ', '.join(出版物['bib']['author']) 摘要 = 出版物['bib'].get('abstract', '没有摘要可用') print(f"标题: {标题}") print(f"作者: {作者}") print(f"摘要: {摘要}\n") -
运行脚本:
bashpython 你的脚本.py
将'你感兴趣的关键词'替换为你实际感兴趣的关键词。脚本将打印前5个相关文献项目的标题、作者和摘要。
之后对代码进行了一些改进,包括
- 运行前,评估文献总数
- 增加合适的睡眠时长(防止请求太频繁被ban掉)
- 一边请求,一遍将数据写入本地文件中。防止被ban掉之后,数据全没了
目前一切正常

导入excel并进行分列,似乎效果还行

点赞👍+关注⭐+私信,免费获取代码
支持 👉 快速下载地址