文章目录
前言
今天完成电商数据分析第一问:
统计页面浏览量(每行记录就是一次浏览)
一、 项目要求
-
统计页面浏览量(每行记录就是一次浏览)
-
统计各个省份的浏览量 (需要解析IP)
-
日志的ETL操作(ETL:数据从来源端经过抽取(Extract)、转换(Transform)、加载(Load)至目的端的过程)
为什么要ETL:没有必要解析出所有数据,只需要解析出有价值的字段即可。本项目中需要解析出:ip、url、pageId(topicId对应的页面Id)、country、province、city
二、步骤
1.第一问代码结构

2.代码
创建PageViewDriver类
用于统计网页浏览量
c
package mr1;

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class PageViewDriver {

    public static void main(String[] args) throws Exception {
        if (args.length != 2) {
            System.err.println("Usage: PageViewDriver <input path> <output path>");
            System.exit(-1);
        }

        Configuration conf = new Configuration();
        Job job = Job.getInstance(conf, "Page View Count");

        job.setJarByClass(PageViewDriver.class);
        job.setMapperClass(PageViewMapper.class);
        job.setCombinerClass(PageViewReducer.class);
        job.setReducerClass(PageViewReducer.class);

        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(IntWritable.class);

        FileInputFormat.addInputPath(job, new Path(args[0]));
        FileOutputFormat.setOutputPath(job, new Path(args[1]));

        System.exit(job.waitForCompletion(true) ? 0 : 1);
    }
}
创建PageViewMapper类
用于处理输入数据并生成键值对
c
package mr1;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;
public class PageViewMapper extends Mapper<LongWritable, Text, Text, IntWritable> {

    @Override
    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {
        context.write(new Text("line"), new IntWritable(1));

    }

}
创建PageViewReducer类
对Map阶段的输出进行聚合和处理
c
package mr1;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Reducer;
import java.io.IOException;

public class PageViewReducer extends Reducer<Text, IntWritable, Text, IntWritable> {
    private IntWritable result = new IntWritable();
    @Override
    protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {
        int sum = 0;
        for (IntWritable val : values) {
            sum += val.get();
        }
        result.set(sum);
        context.write(key, result);
    }
}
3.打JAR包
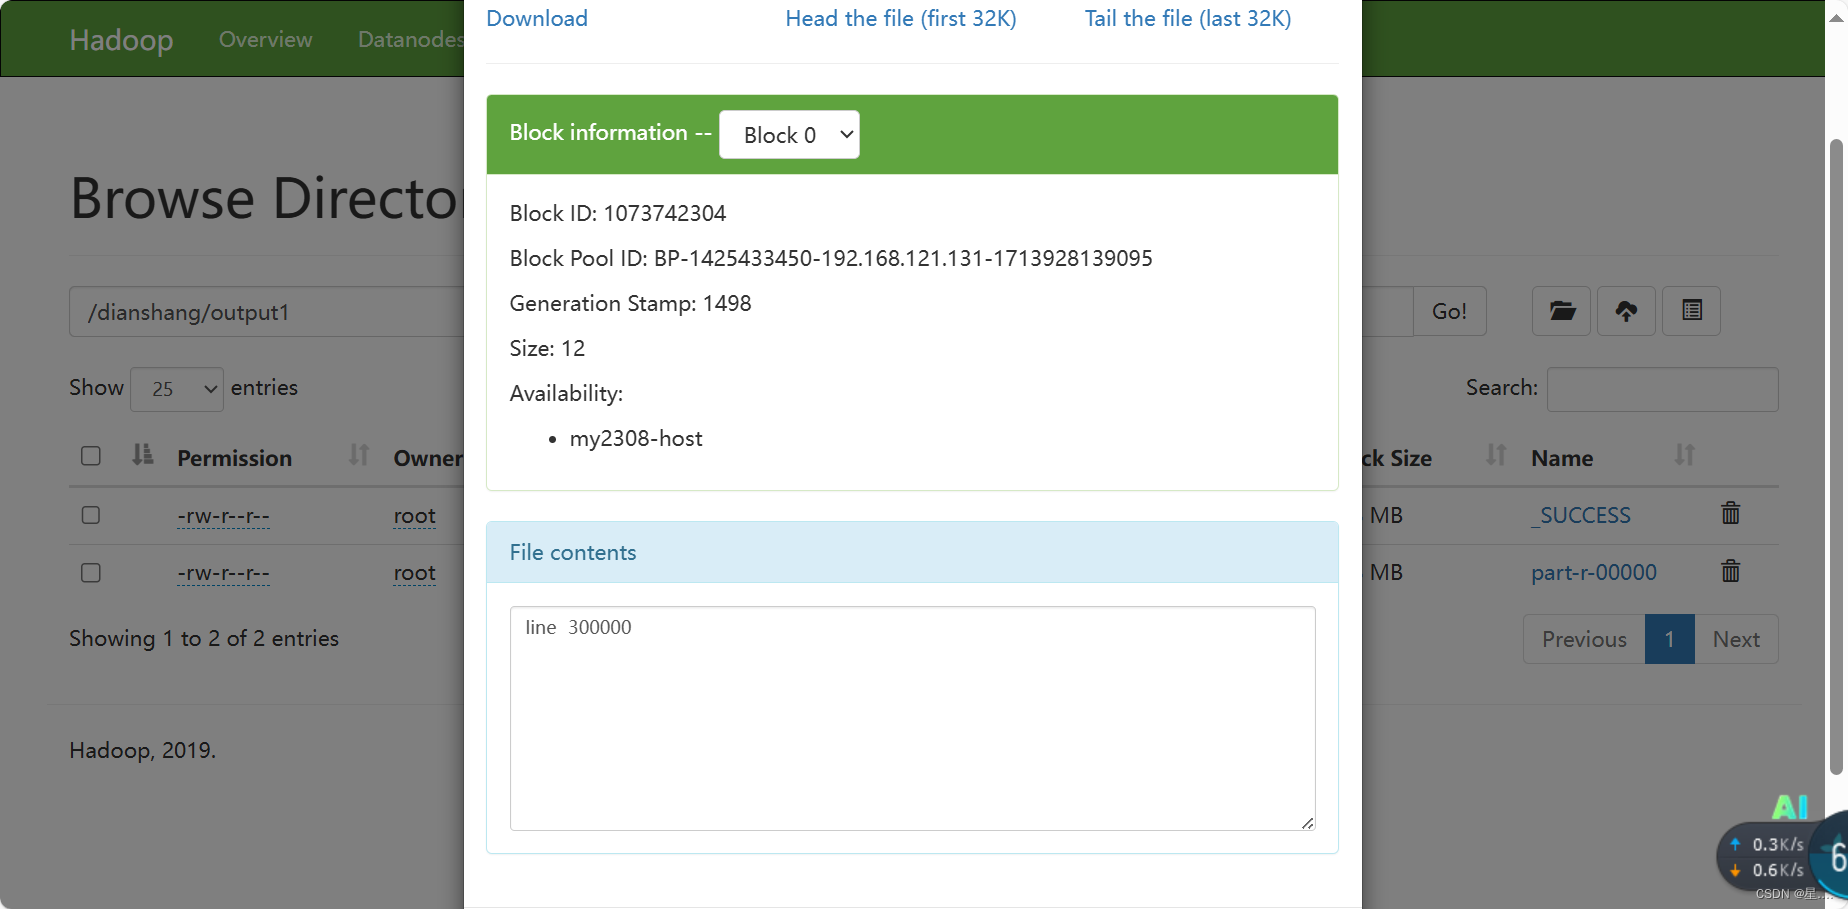
4.在Hadoop虚拟机运行提交HDFS
总结
这个基于Hadoop的MapReduce程序用于统计网页浏览量。它包含以下组件和功能:
PageViewDriver类是程序的入口点,负责设置作业的配置和运行。
PageViewMapper类是Mapper的实现,将输入数据处理为键值对。
PageViewReducer类是Reducer的实现,对Mapper的输出进行聚合和处理。
Mapper和Reducer的输出键值对类型都是Text和IntWritable。
程序使用Hadoop的FileInputFormat和FileOutputFormat来指定输入路径和输出路径。
通过Job对象的setJarByClass方法设置程序的主类。
通过Job对象的waitForCompletion方法提交作业并等待完成。