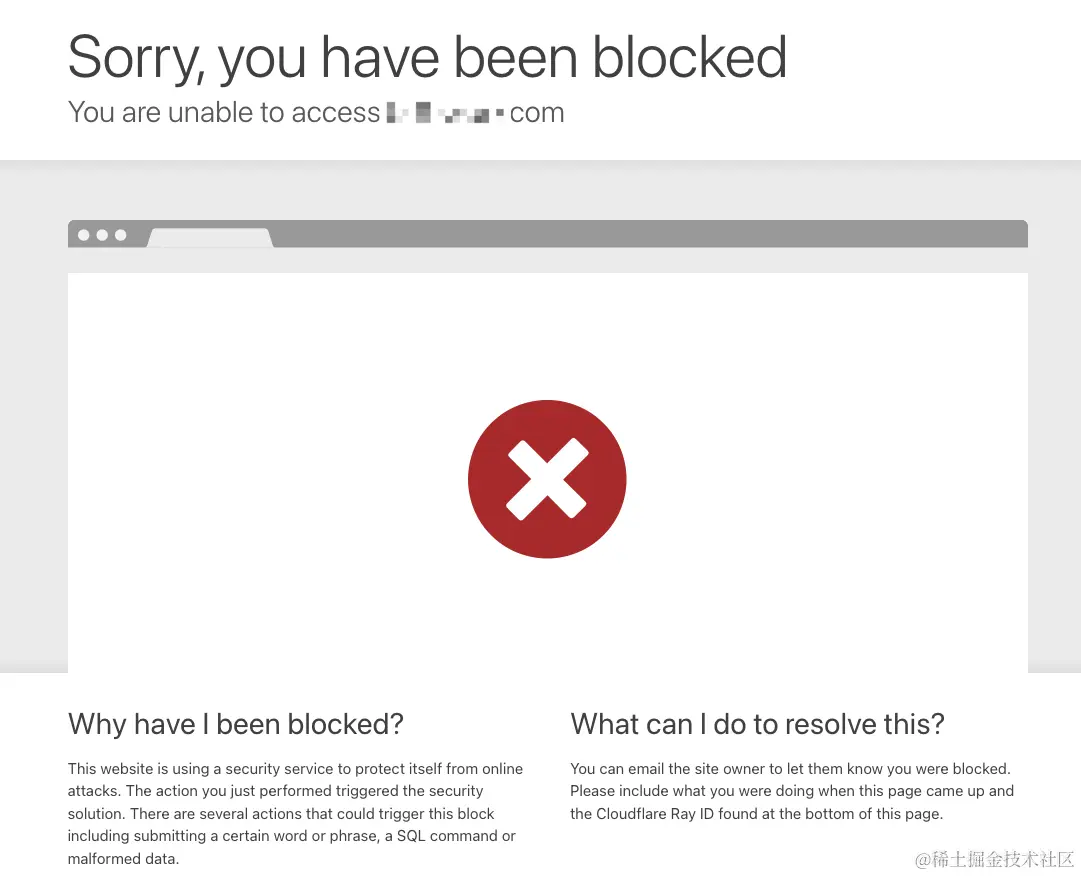
大多数python写爬虫都是当做工具在用,爬虫过程中都会遇到命中反爬导致无法继续访问。访问出现500或者其他服务器禁止错误,像下面这样
在这之前,默认你已经了解
python及scrapy。具体selenium的使用方法可以查阅官方文档。
我的处理办法:
- 使用
selenium打开浏览器,不再直接使用request请求url,这样看起来更像真人操作,当然你可以可以选择使用chrome以及chrome的驱动是同样的。 - 使用
fake-userAgent在每次请求前伪造UA - 使用
代理在每次请求更换代理进行请求
开始
三个处理办法对应着三个中间件,均放在本地爬虫目录的 middlewares.py文件内
1.伪造UA
使用fake_useragent
python
from fake_useragent import UserAgent
class RandomUserAgentMiddleware:
    def __init__(self):
        self.ua = UserAgent()
    def process_request(self, request, spider):
        # 为每个请求随机设置一个User-Agent
        request.headers.setdefault('User-Agent', self.ua.random)
2.proxy代理
代理可以自己购买,也可使用github上开源的然后在自己本地部署
- ProxyPool
- proxy_pool
python
import requests
class ProxyMiddleware(object):
    def process_request(self, request, spider):
        # 设置代理的URL
        request.meta['proxy'] = "这里写你具体使用代理服务器地址如:http://127.0.0.1:1234"
3.使用Selenium
python
from selenium import webdriver
from scrapy import signals
import random

class SeleniumMiddleware:
    def __init__(self):
        # 你在这可以选择使用chrome 或者 火狐
        # self.driver = webdriver.Chrome()
        self.driver = webdriver.Firefox()

    def process_request(self, request, spider):
        self.driver.get(request.url)

        # 随机停顿几秒,你可以不停顿,或者改的更长/更短的时间
        sleepSeconds = random.randint(2,6)
        time.sleep(sleepSeconds)

        body = self.driver.page_source
        return HtmlResponse(url=request.url, body=body, encoding='utf-8', request=request)

    @classmethod
    def from_crawler(cls, crawler):
        middleware = cls()
        crawler.signals.connect(middleware.spider_closed,
                                signal=signals.spider_closed)
        return middleware

    # 在爬虫退出时关闭浏览器
    def spider_closed(self):
        self.driver.quit()
最后一步
在settings中设置中间件,并关闭默认的UA中间件。需要注意的是中间件的顺序不要搞错了,后面的值表示中间件运行的顺序,Selenium在这三个里面一定是最后的,因为它就开始访问资源了
python
DOWNLOADER_MIDDLEWARES = {
    'scrapy.downloadermiddlewares.useragent.UserAgentMiddleware': None,
   "qiuzhi.middlewares.RandomUserAgentMiddleware": 200,
   "qiuzhi.middlewares.ProxyMiddleware": 300,
   "qiuzhi.middlewares.SeleniumMiddleware": 400,
}
有坑么?
大多数坑都是版本冲突的问题。因为我上次使用scrapy爬虫已经是两年前,但是在这中间时间可能在使用pandas或者其他库的时候,有更新到其他包。导致我这次运行的时候出现很多问题。如果你实在无法解决,尝试使用 --upgrade 或者 先卸载再重新安装的方式来解决
- selenium使用时,你可能会遇到报错:显示ValueError: Timeout value connect was ......, but it must be an int, float or None
这是因为版本冲突的原因,将你的urllib3版本改成1.26.2 问题解决参考:blog.csdn.net/weixin_6053...
如果你想很好的管理你的python环境,建议使用 Aconada Navigator
作者:蛋炒饭不加冰