scrapy模块是爬虫工作者最常用的一个模块之一,因它有许多好用的模板,和丰富的中间件,深受欢迎。
一,scrapy的安装
可以通过pypi的指引进行安装
在终端内输入以下代码:
python
pip install scrapy二,项目的建立
安装程序后,创建自己项目,在终端中输入以下代码
python
scrapy startproject yourprojectname运行完成后,在终端中会提示你执行以下两个命令
需要依次执行
python
cd yourprojectname创建你的爬虫模板
python
scrapy genspider name name.comname --根目录的名字, name.com --()域名
创建好之后,在pycharm中可以看到以下的目录:
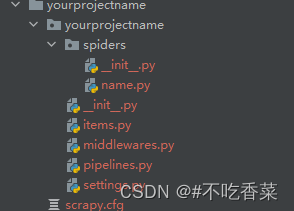
在name.py中编写爬虫项目,name.py文件中会自带以下代码
python
import scrapy

class NameSpider(scapy.Spider):
    name = "name"
    start_urls = [url, url....]

    def parse(self, response):
        pass
其中name为爬取数据的名字,自定义。
此外还要加入要爬取的链接列表。
pase方法为爬取数据的逻辑
使用命令来启动爬虫程序(在终端运行以下代码)
python
scapy crawl name也可新建一个文件,运行文件来启动爬虫程序,代码如下:
python
from scrapy import cmdline

cmdline.execute("scapy crawl name".split())
split()方法将其分割,因为在cmdline中是一个数组
也可将爬虫日志写入在文件中,避免输出在终端时,因终端可显示的长度有限,显示不完全。代码如下:
python
from scrapy import cmdline

cmdline.execute("scapy crawl name --logfile name.log".split())
爬取好的数据可以通过items.py文件中进行配置
将想要的数据进行保存
python
import scrapy


class HaodaifuItem(scrapy.Item):
    # define the fields for your item here like:
    # name = scrapy.Field()
存储的项目通过进入piplines.py文件中(pipelines.py在settings中默认不开启,需要手动开启 )
python
# Configure item pipelines
# See https://docs.scrapy.org/en/latest/topics/item-pipeline.html
# 项目管道
ITEM_PIPELINES = {
   "xxx.pipelines.Pipeline": 300,
    "xxx.pipelines.xxxPipeline":300,
}
pipslines.py文件中的项目名:数值
数值越小,优先级越高,越先启动,数值相同他们的启动顺序将是随机的,无法确定哪一个会先启动。在这种情况下,scrapy将根据实际情况来决定启动顺序。