基本语法:
json
GET /索引库名/_search
{
  "query": {
    "查询类型": {"查询条件"}
  }
}RestClient的导入在RestClient操作索引库和文档有介绍
查询所有:
json
# 查询所有
GET /test/_search
{
  "query": {
    "match_all": {}
  }
}
java
SearchRequest request = new SearchRequest("test");
request.source().query(QueryBuilders.matchAllQuery());
SearchResponse response = client.search(request, RequestOptions.DEFAULT);
全文检索查询 :
对用户输入的内容进行分词,然后去倒排索引库进行检索,常用于搜索框
json
# match查询
GET /test/_search
{
  "query": {
    "match": {
      "字段": "文本"
    }
  }
}
java
SearchRequest request = new SearchRequest("test");
request.source().query(QueryBuilders.matchQuery("字段","文本"));
SearchResponse response = client.search(request, RequestOptions.DEFAULT);
System.out.println(response.getHits().getTotalHits().value);
json
# mutil_match查询
GET /test/_search
{
  "query": {
    "multi_match": {
      "query": "文本",
      "fields": ["字段1", "字段2", ...]
    }
  }
}
一般情况下,多字段查询都会copy_to到一个字段中,然后使用match查询来替代multi_match查询,能够提高查询效率。
精确查询 :
精确查询不会对搜索条件进行分词,一般查找keyword,数值,日期,boolean等字段。
- trem :根据词条精确查找,类似于mysql的
=。 - range :根据词条的范围查询。
gt gte lt lte分别是大于 大于等于 小于 小于等于
json
# term查询,查找price是8的文档
GET /test/_search
{
  "query": {
    "term": {
      "price": {
        "value": "8"
      }
    }
  }
}
# 查询price大于10并且小于20的文档
GET /test/_search
{
  "query": {
    "range": {
      "price": {
        "gte": 10,
        "lte": 20
      }
    }
  }
}
java
SearchRequest request = new SearchRequest("test");
request.source().query(QueryBuilders.termQuery("字段","文本"));
request.source().query(QueryBuilders.rangeQuery("price").gt(1).lt(5))
SearchResponse response = client.search(request, RequestOptions.DEFAULT);
System.out.println(response.getHits().getTotalHits().value);
Function Score Query :
我们在使用match查询的时候,展示的文档的顺序会根据改文档与搜索词条的相关性(抽象为一个分数,es进行打分)进行排序。
而常见的相关性算法是TF-IDF和BM25:
在es5.0之前使用的是TF-IDF算法,而之后使用的是BM25算法。随着词频的增加,TF-IDF会无限变大,而BM25就比较稳定。
而Function Score Query ,可以修改文档的相关性算分。

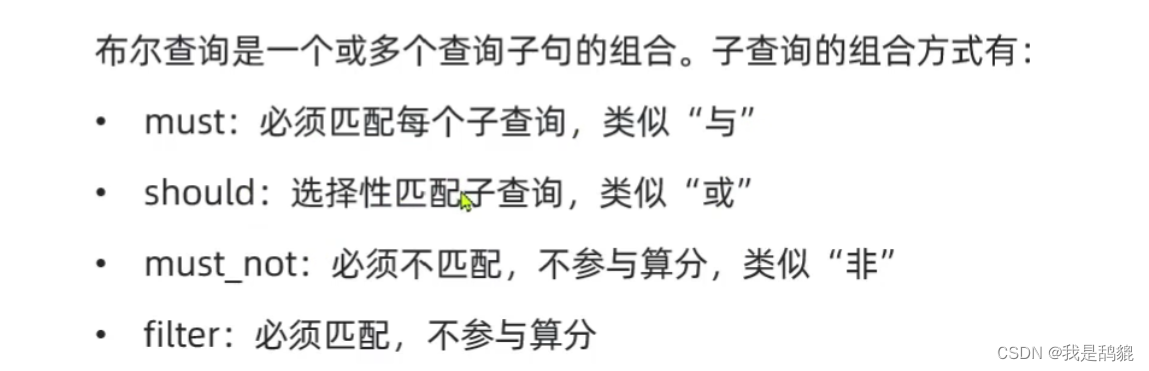
复合查询(Boolean Query)
java
SearchRequest request = new SearchRequest("test");
BoolQueryBuilder boolQuery = QueryBuilders.boolQuery();
boolQuery.must(QueryBuilders.matchAllQuery());// boolQuery.must(QueryBuilders.matchQuery("all", key));
boolQuery.filter(QueryBuilders.termQuery("字段","文本"));
String sortBy = params.getSortBy();
if (!sortBy.equals("default")) {
    request.source().sort(sortBy);
}
request.source().query(boolQuery);
Integer size = params.getSize();
Integer page = params.getPage();
request.source().from((page - 1) * size).size(size);
SearchResponse response = client.search(request, RequestOptions.DEFAULT);