【IJCAI2024】LeMeViT: Efficient Vision Transformer with Learnable Meta Tokens

【IJCAI2024】LeMeViT: Efficient Vision Transformer with Learnable Meta Tokens for Remote Sensing Image Interpretation
论文:https://arxiv.org/abs/2405.09789

代码:https://github.com/ViTAE-Transformer/LeMeViT

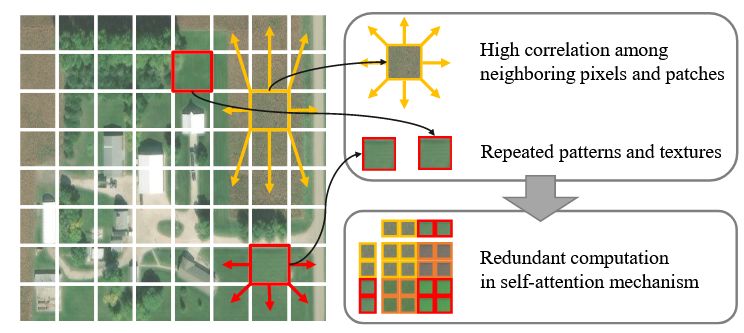
由于相邻像素和图像块之间的高度相关性,以及遥感图像中纹理和模式的重复性质,存在大量的空间冗余。如下图所示,ViT 中的自注意力机制计算每两个图像块之间的相似性,相似的token对特征表示的贡献很小,但消耗了大量的计算负载,影响了模型性能。
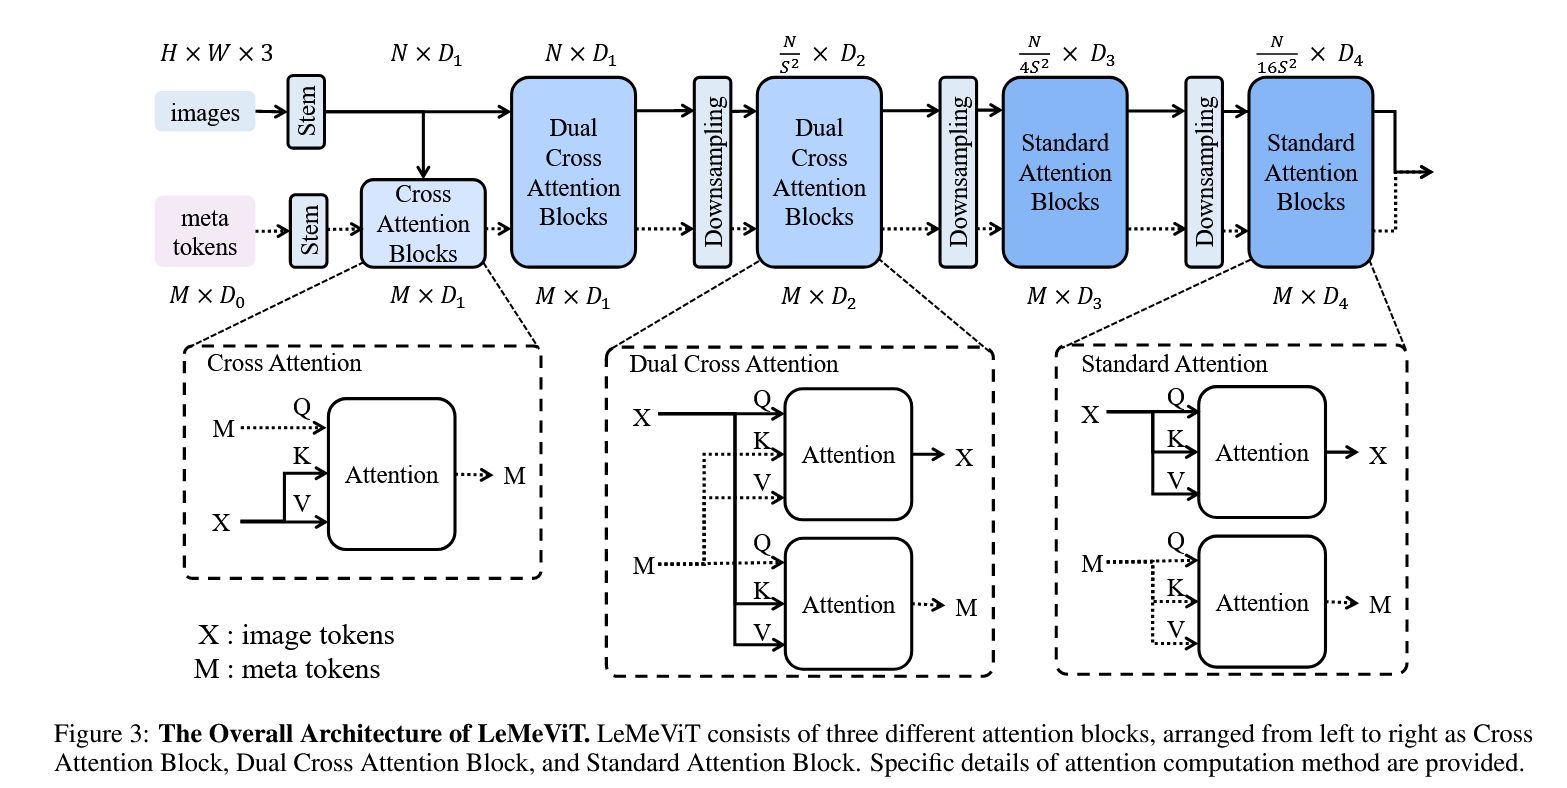
为此,作者提出了下图所示的框架。本质上引入了一个可学习的 meta token(类似于原型或者记忆),不断的进行 image token 和 meta token 的信息交换。值得注意的是,网络的浅层使用的是cross-attention,深层使用的是自注意力(作者解释是自注意力的性能更高)。
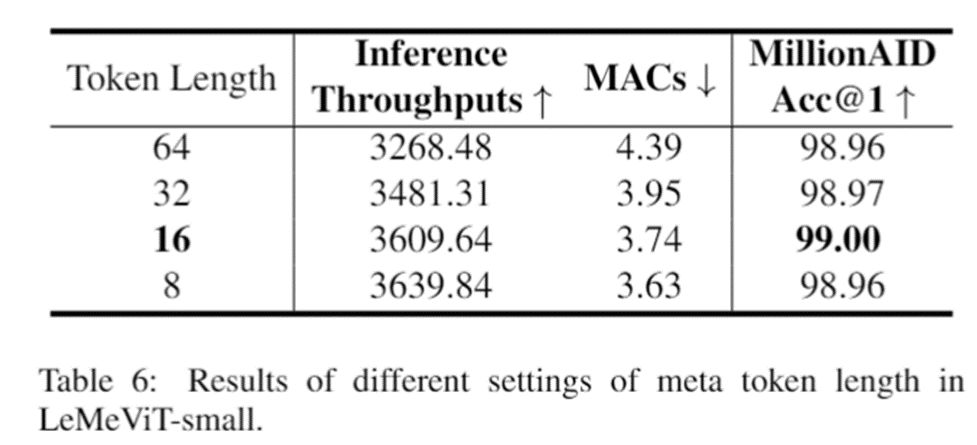
作者在语义分割、目标检测等多个应用上做了大量实验,结果表明该方法具有较好的性能。有个有趣的消融实验是meta token 长度对性能的影响。长度为 64、32、16 和 8时,准确率几乎相同。这进一步证实了注意力计算的冗余,表明使用较少数量的 meta token 来表示密集图像 token 的动机。最后,考虑到效率和准确性,作者选择 16 作为 meta token 长度的默认设置。
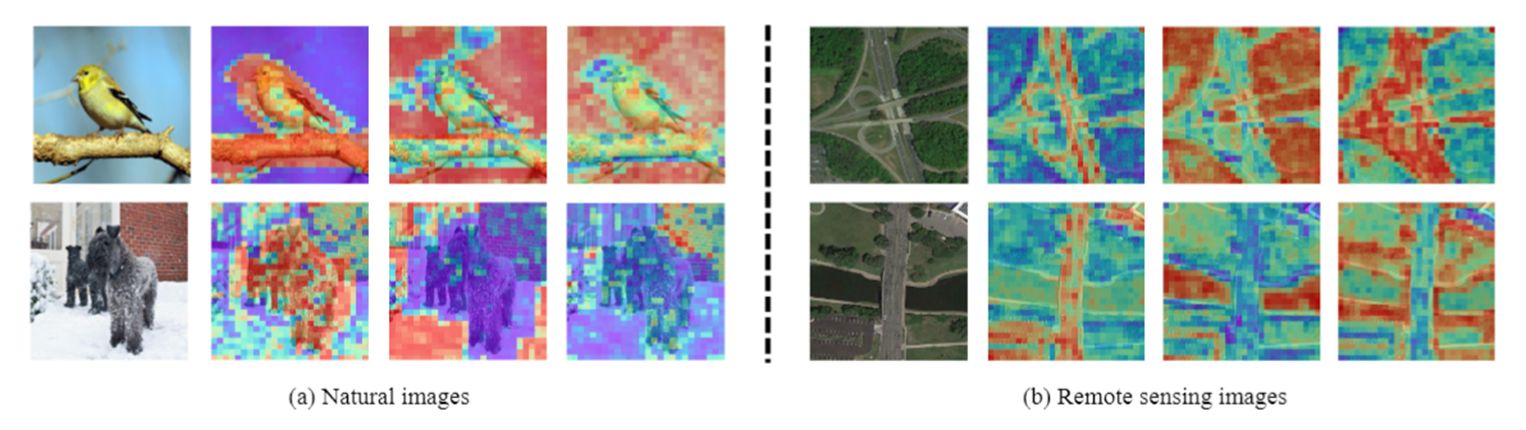
作者还可视化了 dual cross attention最后一个块中,交叉注意映射结果。自然图像上的实验结果表明,学习到的 meta token 可以很好地关注图像中的目标,有助于提高分类精度。遥感图像上的实验结果则表明不同的 meta token 负责图像的不同语义部分。
相关推荐
Bowen_J23 分钟前
Apple Foundation Models:Apple AI核心框架
人工智能·ai编程·apple
IT_陈寒35 分钟前
Redis那个过期删除策略,差点让我线上崩了
前端·人工智能·后端
阿里云大数据AI技术1 小时前
AI 原生大数据服务 ADA 快速入门:完成首次对话式数据分析
大数据·人工智能
字节跳动开源1 小时前
小红书/抖音图文排版利器——一个杂志风skill
人工智能·开源·设计
Bacon1 小时前
我把 Codex 塞进了 Touch Bar:一个 30pt 高的额度与对话面板
人工智能
衡石科技1 小时前
企业级 BI 的安全治理:衡石如何贯通认证、数据权限与审计
大数据·人工智能·安全·商业智能
网易云信2 小时前
折叠屏适配,iPhone Duo 真机已交付:网易云信 IMUIKit Swift 的实践
人工智能
Be for thing3 小时前
Pytorch【12】transforms进阶|图像数据增强实战,提升模型泛化能力
人工智能·pytorch·机器学习
十有八七3 小时前
手搓 Agent(一):先有大脑——大模型只会做一件事
前端·人工智能·后端
锋行天下3 小时前
「踩坑实录」给 LangGraph Agent 接两个 FastMCP,我被 langchain 偷偷改了工具名
前端·人工智能·后端