引言
由于部署浏览器爬虫的机器浏览器版本不同,同时也不想因为部署了爬虫导致影响系统浏览器数据,以及避免爬虫过程中遇到的chrome与webdriver版本冲突。我决定将特定版本的chrome浏览器与webdriver下载到项目目录内,同时chrome_driver在初始化时指定项目目录内的chrome与webdriver。
下载指定版本的chrome与webdriver
选择版本为:version: 123.0.6312.122 (r1262506)
机器为windows 64位系统,按照以下操作下载chrome与webdriver
chrome下载链接
chrome webdriver下载链接
chrome webdriver下载链接
下载完毕后将压缩包解压,将webdriver目录下的chromedriver.exe文件放到chrome应用目录内

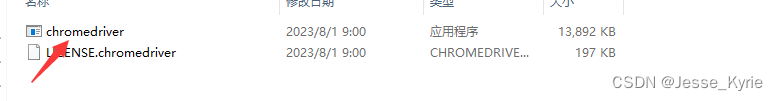
移动过后可以时这样放置,只要在项目的爬虫通过相对路径能访问到即可
更新webdriver初始化代码
python
# 指定chrome的位置
chrome_binary_path = r'./Chrome/chrome-win64/chrome.exe'
# 指定 Chrome 驱动的位置
chrome_driver_path = r'./Chrome/chromedriver.exe'


def driver_init_new():
    ############################ chrome指定版本与特定位置初始化 ############################
    # 创建 ChromeOptions 对象并设置 Chrome 应用程序位置
    chrome_options = webdriver.ChromeOptions()
    chrome_options.binary_location = chrome_binary_path
    # chrome_options.add_argument('--headless') # 无头模式
    chrome_options.add_experimental_option("excludeSwitches", ['enable-automation'])
    # 禁止显示浏览器窗口
    # chrome_options.add_argument('--window-position=-32000,-32000')
    # 创建 Service 对象
    chrome_service = webdriver.chrome.service.Service(chrome_driver_path)
    # 创建 Chrome 浏览器驱动对象,使用 options 和 service 参数
    browser = webdriver.Chrome(options=chrome_options, service=chrome_service)
    return browser
sql
chrome_options.binary_location = chrome_binary_path
chrome_service = webdriver.chrome.service.Service(chrome_driver_path)
这两行代码指定特chrome的路径与driver的位置,这样就能直接使用我们刚刚配置的chrome浏览器用于爬虫开发了。