方法有以下这些,只要按照异常值缺失指处理-数据重编码-处理样本不均衡-特征衍生-特征筛选
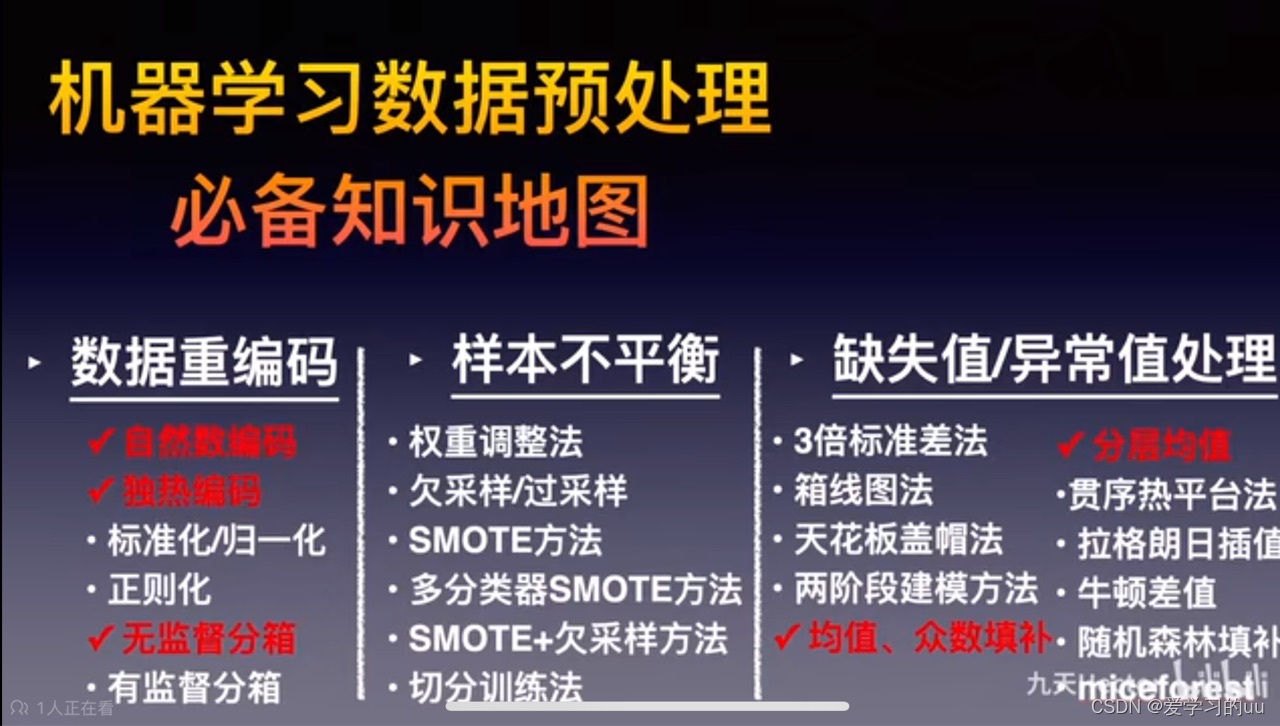


首先看数据有没有重复值、缺失值情况
离散:独热
连续变量:离散化(也成为分箱)
作用:1.消除异常值影响
2.引入非线性因素,提升模型表现能力
3.缺点是会损失一些信息
怎么分:
1.根据业务指标分(比如>10000是高收入人群)
2.固定方法(等宽、等频、聚类、有监督)等宽就是没类数值区间长度一样
等频就是每个里面样本个数一致
一个矛盾点:等宽会受异常值影响,等频则完全忽略异常值影响,要兼顾则用聚类分箱,公认效果好(因为它会把异常值单独分成一类)
特征衍生:
1.分组统计法(即a特征根据b特征的不同取值求统计值,注意b特征得是离散的,且取值要多些。离散变量不要只用离散统计值。统计值结果可以和变量再做四则运算衍生)
2.时序特征:
先处理成datetime格式,然后用函数提取
a.提取其年月日为特征
b.季度特征,是否在周末等,周几
c.和关键时间点的差值
为什么有用:同一组内的用户表现出类似的特效,方便预测
如何做衍生:考虑自然周期和业务周期
特征筛选:(分为指标筛选、递归筛选、模型筛选)
1.方差分析法:
step1:提出两个相反的假设(两个群体的xx指标是否有差异)
step2:判断两个群体是否分部一致,转换为和整体分布是否一致,看统计量是否一致
step3:设计统计量(算出ssb和sse然后用F检验)
step4:计算F后查表看是否接受
注意,方差分析只是用到了F检验。方差分析能够同时检验多个样本,而t检验只能检验两个样本
2.RFE方法:(递归消除法)
计算特征重要度,每次删除最低的几个,循环计算
存在的问题:模型会过拟合且输出结果随机
解决方法:用一个已经训练好的模型去筛选(在全量样本上先训练一个),每轮筛选都训练一个新的,效果也会提升
注意:方差分析等一般用于指标初筛,RFE用于精筛
进一步优化:交叉验证
缺失值处理:
首先,要当心有些0就是缺失值,不一定是none或者np.nan
具体思路图如上
为什么要处理缺失值:
1.异常值可能有额外信息
2.有些算法不会自动填补缺失值,有些算法在sklearn里面不能填补
一.分层均值:先聚类,再按层的均值填补
热平台法:以点估点,用其他有值的类似点估计这个点(分为最近邻(用聚类求)、序贯(计算相关性后看)、随机)
二.模型法:KNN、决策树、随机森林、SVM,把缺失列作为目标列,没有缺失的作为训练集,缺失的作为测试集
当有多列都有缺失值时如何处理
整体思路:
三.多重插补
目前效果最好的是miceforest法:比如有三列有缺失值,先都随机填,然后用完整的bc列预测a列,再用ab列预测c,不断循环直到值不太变
以上讲了三种方法,那么如何选择呢?
这里的效率指运算效率