UnicodeDecodeError: 'utf-8' codec can't decode bytes in position 10
目录
[UnicodeDecodeError: 'utf-8' codec can't decode bytes in position 10](#UnicodeDecodeError: ‘utf-8’ codec can’t decode bytes in position 10)
欢迎来到英杰社区 https://bbs.csdn.net/topics/617804998
欢迎来到我的主页,我是博主英杰,211科班出身,就职于医疗科技公司,热衷分享知识,武汉城市开发者社区主理人
擅长.net、C++、python开发, 如果遇到技术问题,即可私聊博主,博主一对一为您解答
修改代码、商务合作:
Yan--yingjie
Yan--yingjie
Yan--yingjie
【常见模块错误】
如果出现模块错误
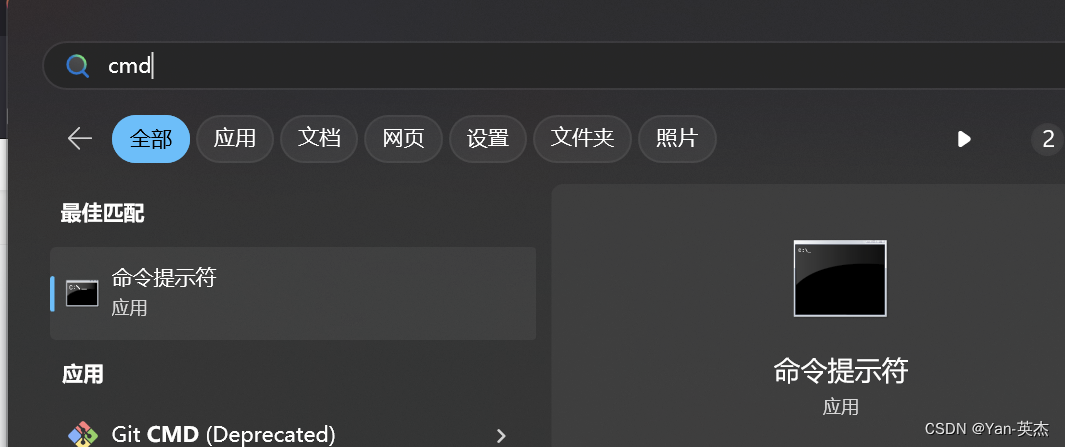
python
进入控制台输入:建议使用国内镜像源

pip install 模块名称 -i https://mirrors.aliyun.com/pypi/simple

我大致罗列了以下几种国内镜像源:

清华大学
https://pypi.tuna.tsinghua.edu.cn/simple

阿里云
https://mirrors.aliyun.com/pypi/simple/

豆瓣
https://pypi.douban.com/simple/

百度云
https://mirror.baidu.com/pypi/simple/

中科大
https://pypi.mirrors.ustc.edu.cn/simple/

华为云
https://mirrors.huaweicloud.com/repository/pypi/simple/

腾讯云
https://mirrors.cloud.tencent.com/pypi/simple/
【解决方案】
UnicodeDecodeError: 'utf-8' codec can't decode bytes in position 10 错误通常发生在尝试将字节序列解码为UTF-8编码的Unicode字符串时,某些字节无法按照UTF-8规范进行解码。以下是详细的解决方案:
-
检查文件编码 :
- 确认文件的实际编码方式。有时文件可能不是以UTF-8编码保存的,例如ISO 8859-1、GB2312等。
- 使用工具如chardet来检测文件的编码格式。可以使用以下Python代码:
import chardet
with open('yourfile.txt ', 'rb') as f:
result = chardet.detect (f.read ())
print(result['encoding'])
这将帮助你确定正确的编码方式。
-
使用正确的编码方式打开文件 :
- 如果确认文件是其他编码方式,请在读取文件时指定正确的编码方式。例如,如果文件是GB2312编码的,可以这样打开文件:
with open('yourfile.txt ', 'r', encoding='gb2312') as f:
content = f.read ()
这样可以避免因编码不匹配导致的错误。
-
忽略或替换无效字节 :
- 如果某些字节确实无法解码,可以选择忽略这些字节或者用特定字符替换它们。例如,在读取文件时使用
errors='ignore'或errors='replace'参数:
with open('yourfile.txt ', 'r', encoding='utf-8', errors='ignore') as f:
content = f.read () - 如果某些字节确实无法解码,可以选择忽略这些字节或者用特定字符替换它们。例如,在读取文件时使用
或者:
with open('yourfile.txt ', 'r', encoding='utf-8', errors='replace') as f:
content = f.read ()
这样可以防止程序因为个别无效字节而崩溃。
-
检查文件内容:
- 检查文件内容,确保没有包含非法的字节序列。某些字节组合在UTF-8中是不允许的,比如连续两个起始字节(如
0xC0和0xC1)。
- 检查文件内容,确保没有包含非法的字节序列。某些字节组合在UTF-8中是不允许的,比如连续两个起始字节(如
-
修改文件权限:
- 在某些情况下,权限问题也可能导致解码错误。例如,被压缩的目录本身是root权限可能导致报错。可以通过提升权限来解决这个问题。
通过以上步骤,应该能够有效解决UnicodeDecodeError: 'utf-8' codec can't decode bytes in position 10错误。