1.元素定位后的操作
"find_element"仅仅能够获取元素,不能够直接获取其中的数据,如果需要获取数据需要使用以下方法"。下面列出了两个方法:
获取文本 element.text 通过定位获取的标签对象的 text 属性,获取文本内容
获取属性值 element.get_attribute("属性名") 通过定位获取的标签对象的 get_attribute 函数,传入属性名,来获取属性的值
python
# -*- coding: utf-8 -*-
from selenium import webdriver
from selenium.webdriver.common.by import By

# 打开目标URL
url = 'https://cq.58.com/hezu/?PGTID=0d100000-0002-59f0-74d2-1a2d488460c0&ClickID=5'

# 初始化Edge浏览器
driver = webdriver.Edge()

# 打开页面
driver.get(url)

# 使用 find_elements 获取所有匹配的元素
el_list = driver.find_elements(By.XPATH, '/html/body/div[6]/div[2]/ul/li/div[2]/h2/a')

# 遍历并打印每个元素
for el in el_list:
    print(el.text, el.get_attribute('href'))  # 打印元素的文本内容

# 关闭浏览器
driver.quit()

# el.click() 点击操作
# el.send_keys(data) el:text inpput
# el.clear() 对输入框做清空操作
2.selenium控制标签页切换
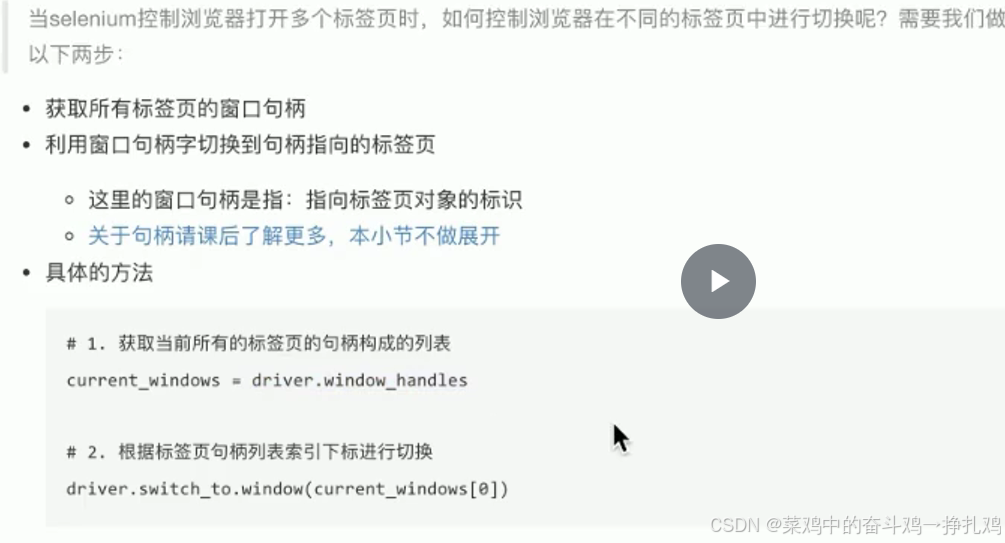
cpp
# -*- coding: utf-8 -*-
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC

# 设置 URL 和驱动
url = 'https://cq.58.com/'
driver = webdriver.Edge()
driver.get(url)

print(driver.current_url)
print(driver.window_handles)

# 定位并点击合租链接
el = driver.find_elements(By.XPATH, '/html/body/div[3]/div[1]/div[1]/div/div[1]/div[1]/span[3]/a')
if el:
    el[0].click()
else:
    print("元素未找到!")

# 切换到新窗口/标签页
driver.switch_to.window(driver.window_handles[-1])

# 处理动态加载,使用显示等待,等待所需元素加载
try:
    # 等待直到指定的元素在 DOM 中存在
    el_list = WebDriverWait(driver, 10).until(
        EC.presence_of_all_elements_located((By.XPATH, '/html/body/div[6]/div[2]/ul/li/div[2]/h2/a'))
    )
    print(len(el_list))  # 现在应该能正确打印元素的数量
except Exception as e:
    print(f"发生错误:{e}")

# 使用完毕后,记得关闭驱动
driver.quit()
3.窗口切换(存在内部框架)
QQ空间登录窗口切换
cpp
# -*- coding: utf-8 -*-
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC

url = 'https://qzone.qq.com/'
driver = webdriver.Edge()
driver.get(url)
driver.implicitly_wait(10)

# 等待 iframe 可用并切换到 iframe
try:
    # 使用 ID 查找 iframe,确保使用正确的选择器
    WebDriverWait(driver, 10).until(
        EC.frame_to_be_available_and_switch_to_it((By.ID, "login_frame"))
    )

    # 需要点击操作
    driver.find_element(By.ID, 'switcher_plogin').click()
    driver.find_element(By.ID, 'u').send_keys('账号')  # 请替换成您的账号
    driver.find_element(By.ID, 'p').send_keys('密码')  # 请替换成您的密码
    driver.find_element(By.ID, 'login_button').click()

except Exception as e:
    print(f"An error occurred: {e}")

finally:
    # 关闭浏览器
    driver.quit()
163邮箱登录窗口切换
python
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC
import time

# 创建浏览器驱动driver
driver = webdriver.Edge()
mail_url = "http://www.mail.163.com"

# 访问指定网页
driver.get(mail_url)
driver.implicitly_wait(10)

# 有内嵌网页,需要先切换到内嵌frame网页再进行定位
# 等待 iframe 加载并切换到 iframe
WebDriverWait(driver, 10).until(
    EC.frame_to_be_available_and_switch_to_it((By.TAG_NAME, "iframe"))
)

# 定位账号输入框
email_input = driver.find_element(By.XPATH, '//input[@name="email"]')
email_input.clear()  # 删除提示信息
email_input.send_keys("账号")  # 测试过程中替换成自己的账号名

# 定位密码输入框
password_input = driver.find_element(By.NAME, "password")
password_input.clear()  # 删除提示信息
password_input.send_keys("密码")  # 测试过程中替换成自己的密码

# 定位登录按钮并点击
driver.find_element(By.ID, "dologin").click()

# 等待登录过程完成
time.sleep(2)  # 可根据需要调整等待时间

# 关闭浏览器
driver.quit()
4.selenium的cookies操作
python
# -*- coding: utf-8 -*-
from selenium import webdriver

url = 'http://www.baidu.com'
driver = webdriver.Edge()
driver.get(url)
print(driver.get_cookies())

# cookies = {}
# for data in driver.get_cookies():
#     cookies[data['name']] = data['value']

cookies = {data['name']: data['value'] for data in driver.get_cookies()}

print(cookies)

# # 删除cookie
# driver.delete_cookie('CookieName')
# # 删除所有cookie
# driver.delete_all_cookies()