一,前言
在AI领域,训练一个大型语言模型(LLM)是一个耗时且复杂的过程。几乎每个做大型语言模型(LLM)训练的人都会被问到:"从零开始,训练大语言模型需要多久和花多少钱?"虽然网上有很多关于训练技巧和模型评估的文章,但很少有直接告诉你如何估算训练时间和成本的。
前面分享了一些关于大模型/本地知识库的安装部署方法,无需编写代码,即可使用Ollama+AnythingLLM搭建企业私有知识库,或者,三步完成Llama3.2在算力魔方的INT4量化和部署...
本篇文章就教你一个简单的方法,帮你快速估算基于大语言模型权重大小、数据量以及可用GPU算力训练大语言模型所需的时间和成本。
二,估算方法
训练模型时,处理数据和更新模型参数需要大量的计算,我们用浮点运算次数(FLOPs)来表示。首先,我们要估算处理一个token所需的FLOPs,包括前向传递和反向传递两个部分。
- 前向传递:
每个token的前向传递涉及的加乘操作数大约为:
FLOPsforward = 2 x N²+2 x N x Dmodel
这里N表示模型的参数量,Dmodel是模型的维度。系数2来源于矩阵乘法中的累加操作。
- 反向传递:
大约需要前向传递的两倍计算量,因为要计算权重和激活值的梯度。
FLOPsbackward =(2 x N²+2 x N x Dmodel)x 2
- 所以,**一个token总的计算量大概是前向传递的三倍。**因此,每个训练token的浮点运算可以估算为:
FLOPstotal =(2 x N²+2 x N x Dmodel)x 3
三,GPU性能
现在大多数模型都是用GPU来训练的。不同的GPU有不同的性能,比如NVIDIA的H100、A100或V100。每个GPU的性能可以用每秒浮点运算次数(FLOPS)来衡量。不过,实际训练时,由于多GPU之间的通信等因素,实际性能可能达不到理论上的最高值。
|---------------|-----------------------|
| GPU Model | Peak FLOPS (FP32) |
| H100 | 67 TFLOPS |
| A100 | 19.5 TFLOPS |
| V100 | 14 TFLOPS |
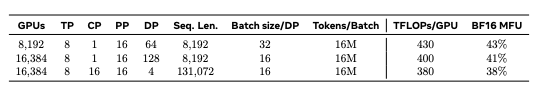
一个重要的概念是模型FLOPS利用率(MFU),它反映了实际计算效率与理论最大值的比例。通常情况下,随着GPU数量的增加,MFU会下降。LLaMA 3的研究者们用16,000个GPU训练模型时,每个GPU的实际效率为380 teraflops,MFU为38%。
四,实际案例
1,l Llama 3 405B 参数模型
LLaMA 3.1(405B参数)是在15.6万亿token的数据集上训练的。训练这样一个规模的模型所需的总FLOPs可以通过以下方式计算:
-
模型大小 N = 405B
-
数据集大小 P = 15.6T
模型使用了16,000个H100 GPU进行训练。据了解,平均吞吐量为每个GPU 400 teraflops。这意味着训练基础设施可以提供的总吞吐量为:
TotalThroughput
= 400TFLOPs/GPU×16,000GPUs
= 6.4ExaFLOPs
最后,通过将所需的总FLOPs除以可用吞吐量,并将结果转换为天数(因为我们真正关心的是训练天数),我们可以得到训练时间。
3.8 x 1025FLOPs ÷ 6.4 x10¹⁸FLOPs/秒 = 61天
2,成本估算
训练模型不仅耗时,还非常昂贵。以LLaMA 3.1为例,如果一个H100 GPU每小时的费用是2美元,那么用16,000个H100训练这个模型的总成本大约为2 x 24 x 61 x 16,000 = 46,848,000美元。
五,总结
训练大型语言模型是一项技术复杂且资金密集的任务。从零开始,把一个LLaMA 3.1(405B参数)的模型在15.6万亿token数据集上训练出来,大约需要花费61天(假设没有训练中断)和46,848,000美元(仅估算GPU租金、数据集制作费用和研发人力成本未计入),你算对了吗?