Neo4j 是开源的 Graph 数据库,Graph 数据通过三元组进行表示,两个顶点+一条边,从语意上可以理解为:主语、谓语和宾语。GraphDB 能够通过图来表达复杂的结构,非常适合存储知识型数据,本文将通过大语言实现图数据库的创建。
首先,需要安装 LangChain 对应的依赖。
langchain==0.3.7
python-dotenv==1.0.1
langchain-google-genai==2.0.4
langserve==0.3.0
langchain-community==0.3.5
dashscope==1.20.12
langgraph==0.2.45
tavily-python==0.5.0
langchain-experimental==0.3.3
初始化模型
本文我们使用 Qwen-Turbo。
from langchain_community.chat_models import ChatTongyi
llm = ChatTongyi(model="qwen-turbo")
使用 LLMGraphTransformer 创建
创建的图关系为英文,这是因为 Langchain 提示词是英文,可以自行修改。
### 创建 Graph
from langchain_core.documents import Document
from langchain_experimental.graph_transformers import LLMGraphTransformer
from langchain_core.output_parsers import StrOutputParser
from IPython.display import Markdown, display
parser = StrOutputParser()

llm_transformer = LLMGraphTransformer(llm=llm)

content = """
1 、项目编号:遂政采 [2024]G 049 号
2 、项目名称:无人机设备采购项目
3 、项目预算: 1550967.00元 4 、最高限价: 1550967.00元

1 、本项目投标截止时间和开标时间为 2024 年 9 月 11 日 10 点 00 分 (北京
时间)。投标人必须在投标截止时间前将电子投标文件上传至江西省公共资源
交易网,逾期为无效投标。
2 、开标地点:江西省公共资源交易网不见面开标大厅。
"""
with open("out.md", "r", encoding="utf-8") as file:
    markdown_content = file.read()

chain = llm | parser
# display(Markdown(chain.invoke("转换为 Graph 三元组, 请用中文回答,并只返回 Cypher QL, 。 {} " + content)))

documents = [Document(page_content=content)]
graph_documents = llm_transformer.convert_to_graph_documents(documents)
print(f"Nodes:{graph_documents[0].nodes}")
print(f"Relationships:{graph_documents[0].relationships}")
graph.add_graph_documents(graph_documents, include_source=False)
使用 Cypher 创建
Neo4j 提供了使用 Cypher 进行数据创建、查询等,类似于关系数据库中的 SQL。用模型生成 Cypher 语句。
### 创建 Graph
from langchain_core.documents import Document
from langchain_experimental.graph_transformers import LLMGraphTransformer
from langchain_core.output_parsers import StrOutputParser
from IPython.display import Markdown, display
parser = StrOutputParser()

llm_transformer = LLMGraphTransformer(llm=llm)

content = """
1 、项目编号:遂政采 [2024]G 049 号
2 、项目名称:无人机设备采购项目
3 、项目预算: 1550967.00元 4 、最高限价: 1550967.00元

1 、本项目投标截止时间和开标时间为 2024 年 9 月 11 日 10 点 00 分 (北京
时间)。投标人必须在投标截止时间前将电子投标文件上传至江西省公共资源
交易网,逾期为无效投标。
2 、开标地点:江西省公共资源交易网不见面开标大厅。
"""
with open("out.md", "r", encoding="utf-8") as file:
    markdown_content = file.read()

chain = llm | parser
display(Markdown(chain.invoke("转换为 Graph 三元组, 请用中文回答,并只返回 Cypher QL, 。 {} " + content)))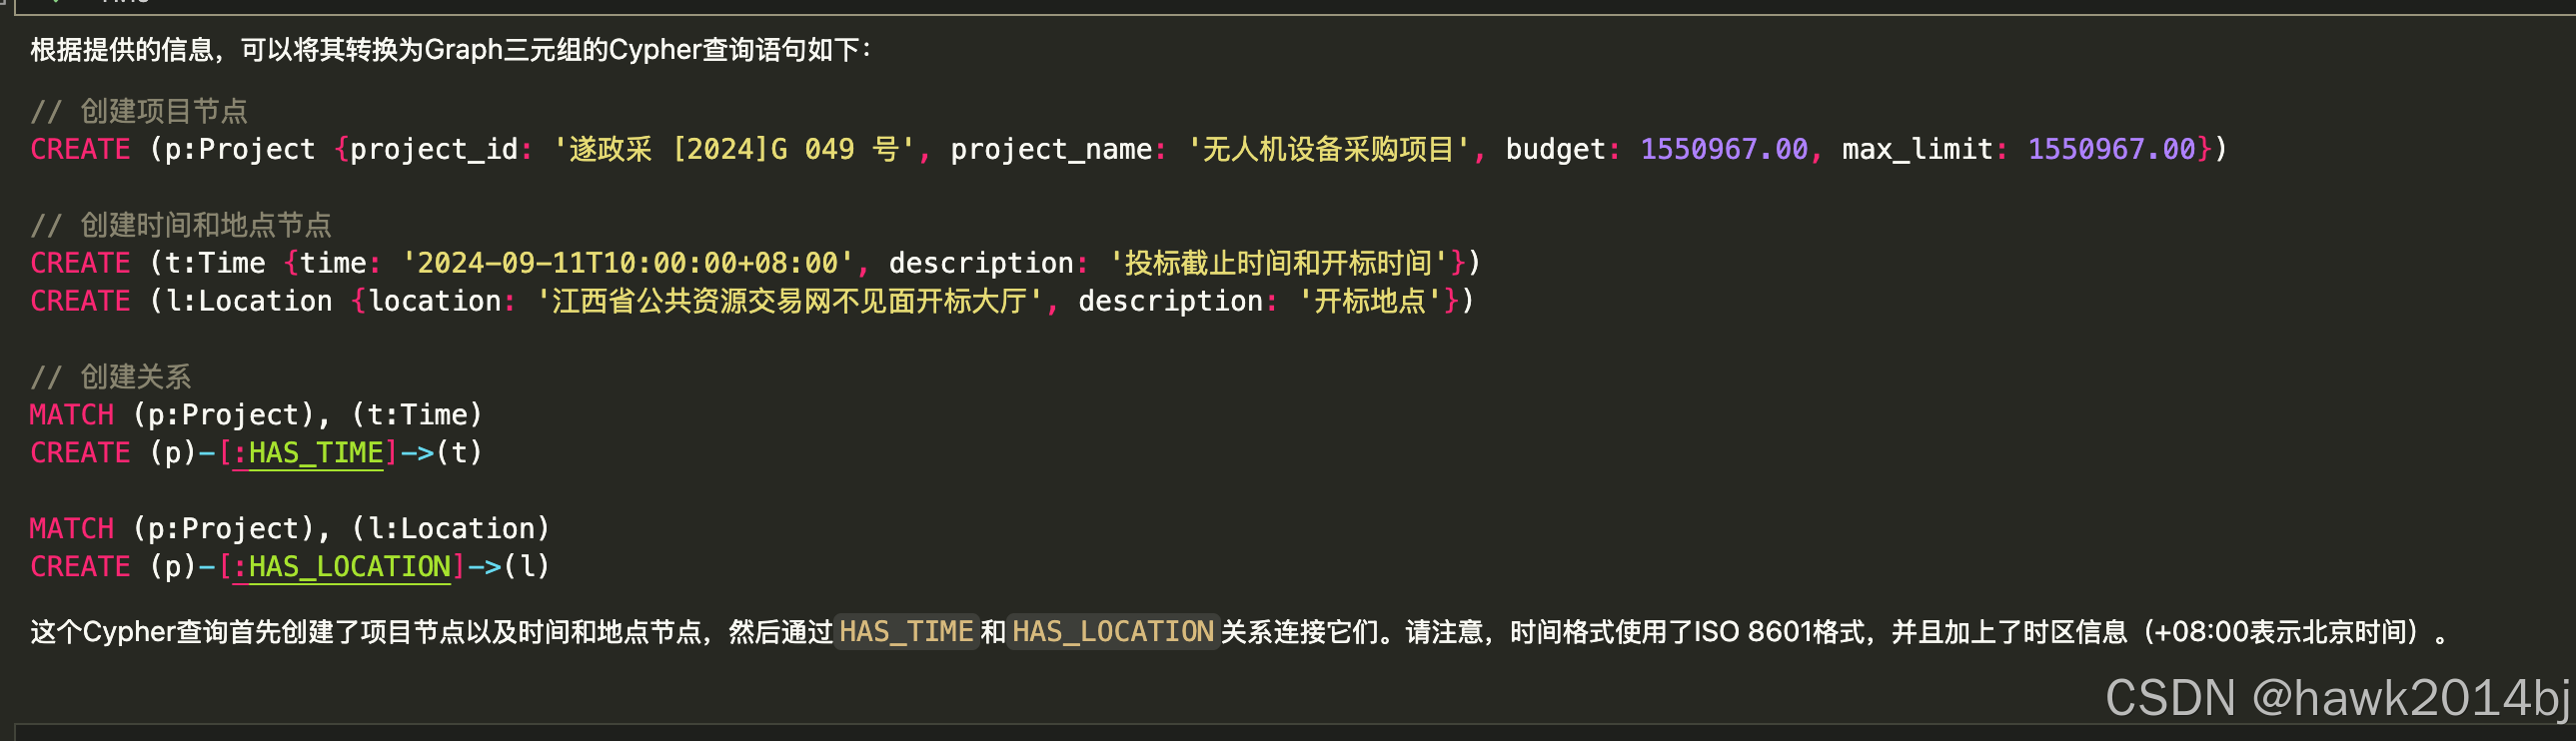
总结
本文介绍了如何使用大语言模型创建图数据,同样的方式也可以创建其他类型的数据源,只需要对提示词进行修改即可。