本论文深入研究并实现了一种基于YOLOV8深度学习模型的医学影像骨折检测与诊断系统,旨在为医学影像中的骨折检测提供高效且准确的自动化解决方案。随着医疗影像技术的快速发展,临床医生需要从大量复杂的医学图像中精确、快速地识别病灶区域,特别是骨折区域的检测至关重要。传统的人工检查方法不仅耗时费力,而且容易受限于主观经验,导致误诊或漏诊的风险。因此,基于深度学习的自动化骨折检测系统应运而生,能够为医生提供智能化的辅助诊断工具,提升诊断效率与准确性。
本系统采用YOLOV8(You Only Look Once Version 8)作为核心检测模型,YOLO系列模型以其实时性和高效性著称,适用于检测医学影像中的目标,如骨折部位。为了提升用户体验,系统结合了PyQt5开发框架,构建了直观、易操作的用户界面。医生和用户可以通过该界面导入医学影像数据,系统会自动进行骨折区域的检测,并将检测结果以图形化的方式展示在用户界面上,便于医生快速做出诊断决策。
在数据准备方面,系统使用了一个经过标准化和预处理的医学影像数据集,包含了多种骨折类型的影像。通过对该数据集进行YOLOV8模型的训练,系统能够学习和识别不同骨折区域的特征,实现高精度的自动检测。为了验证系统的有效性,进行了大量实验测试,结果表明,基于YOLOV8的骨折检测系统在识别骨折区域时表现出较高的准确率,并且具备较好的实时性,能够迅速处理输入的影像并提供检测结果。这不仅减轻了医生的工作负担,还减少了主观误差带来的诊断风险。
算法流程

项目数据
通过搜集关于数据集为各种各样的骨折相关图像,并使用Labelimg标注工具对每张图片进行标注,分1个检测类别,分别是Fracture表示"骨折"。
目标检测标注工具
(1)labelimg:开源的图像标注工具,标签可用于分类和目标检测,它是用python写的,并使用Qt作为其图形界面,简单好用(虽然是英文版的)。其注释以 PASCAL VOC格式保存为XML文件,这是ImageNet使用的格式。此外,它还支持 COCO数据集格式。
(2)安装labelimg 在cmd输入以下命令 pip install labelimg -i https://pypi.tuna.tsinghua.edu.cn/simple

结束后,在cmd中输入labelimg

初识labelimg
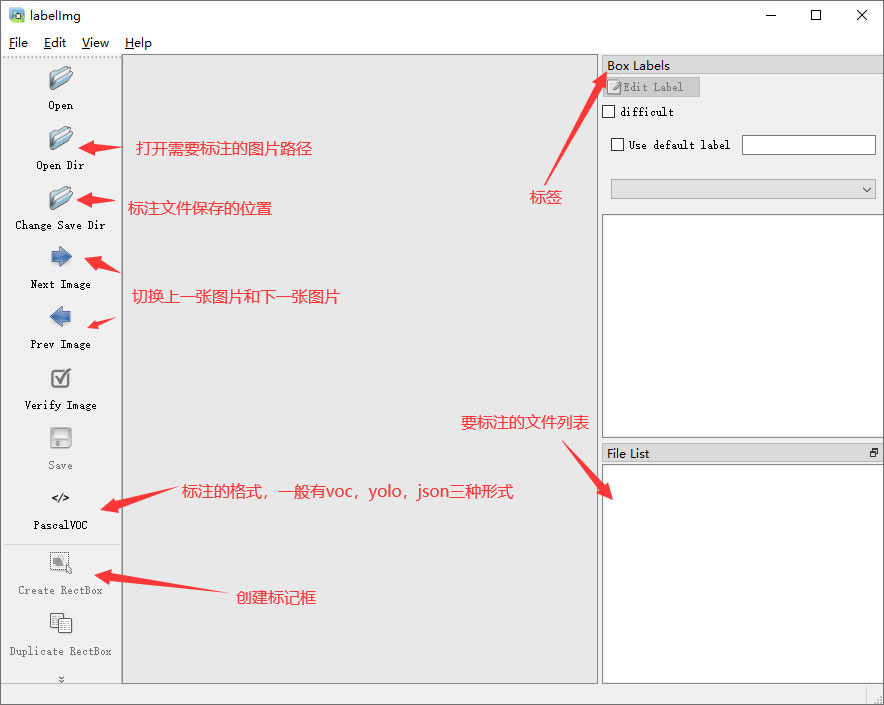
打开后,我们自己设置一下
在View中勾选Auto Save mode

接下来我们打开需要标注的图片文件夹
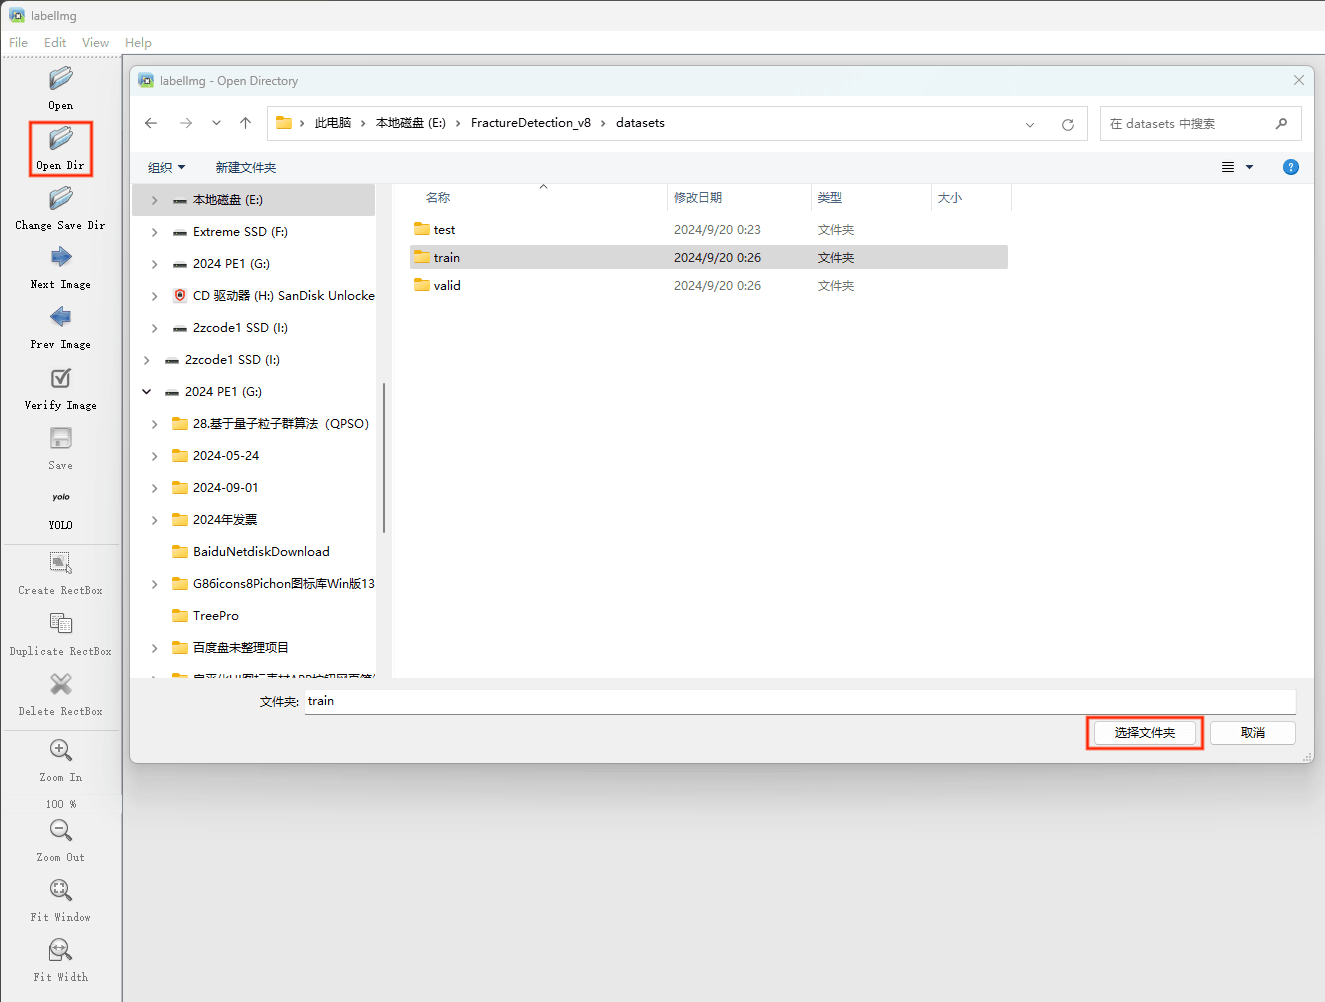
并设置标注文件保存的目录(上图中的Change Save Dir)
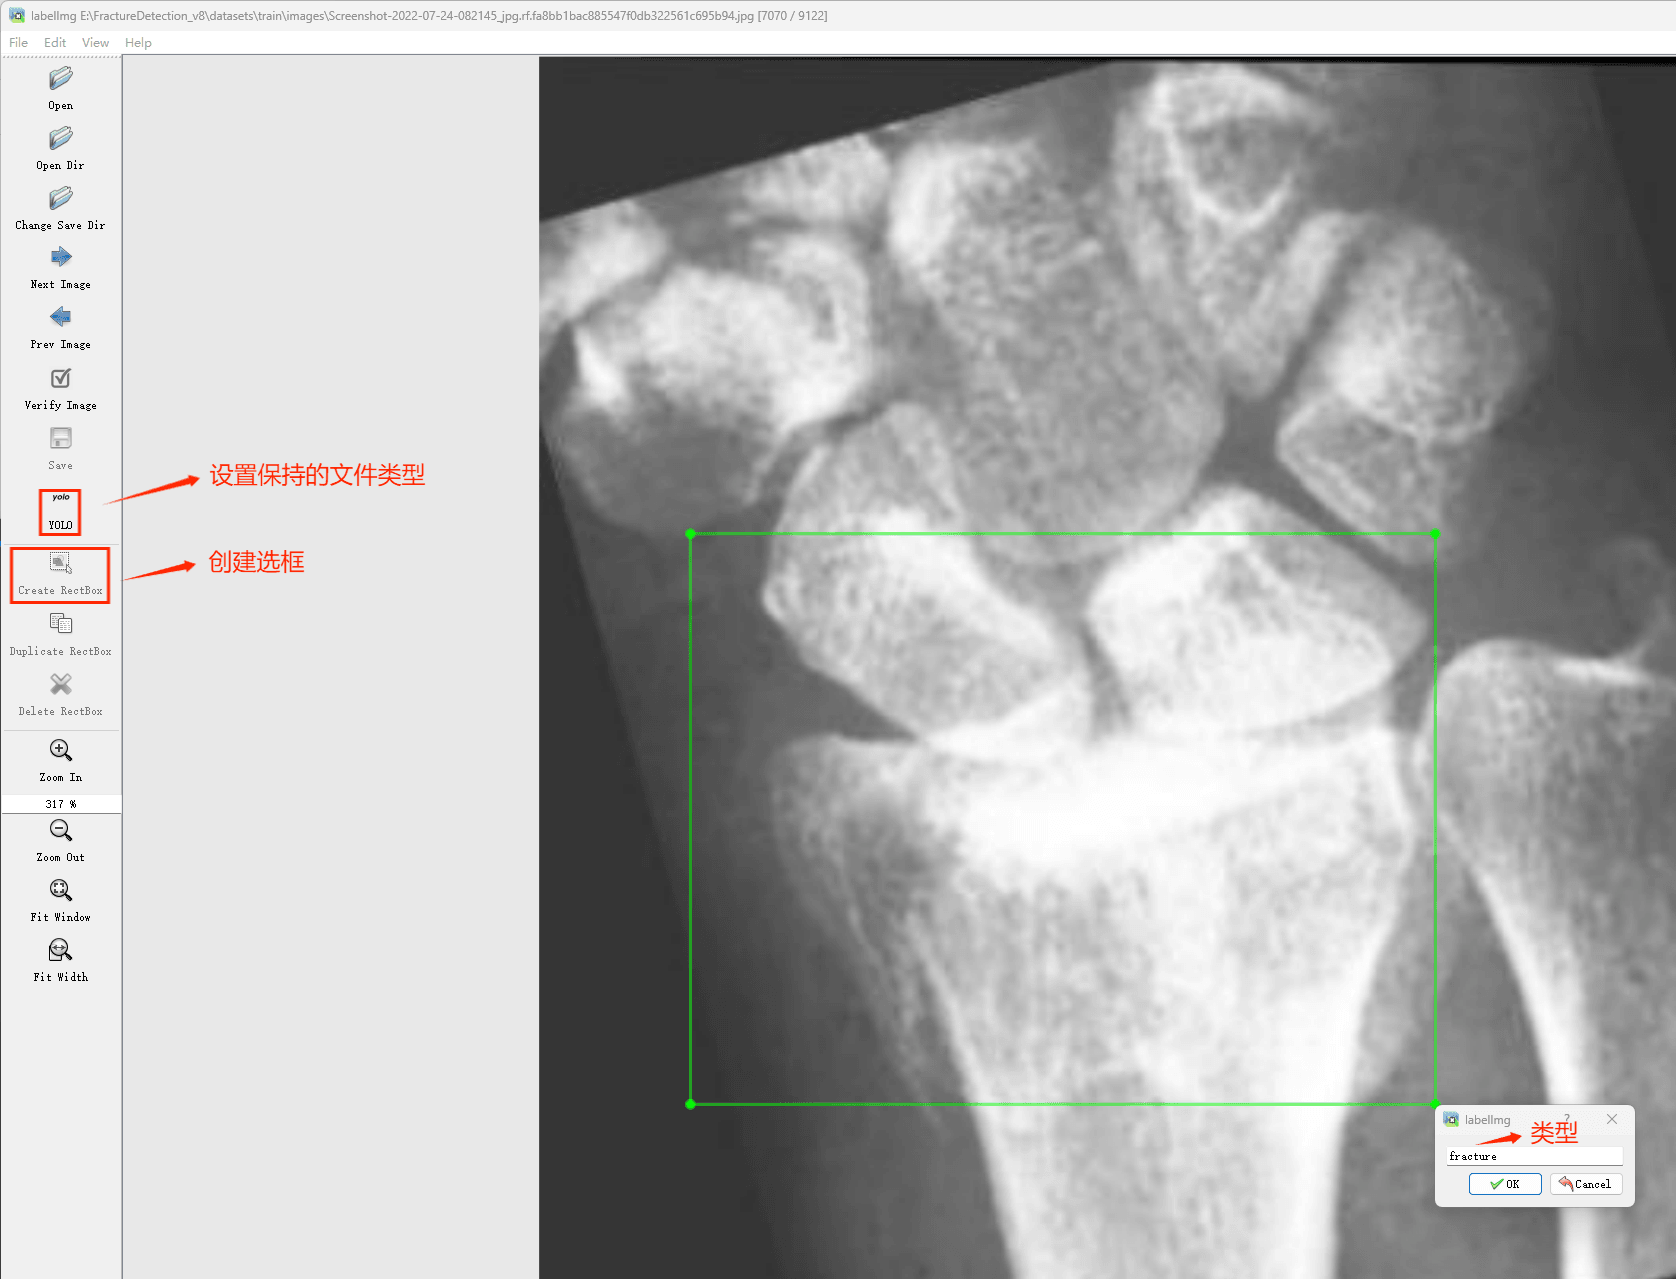
接下来就开始标注,画框,标记目标的label,然后d切换到下一张继续标注,不断重复重复。
Labelimg的快捷键

(3)数据准备
这里建议新建一个名为data的文件夹(这个是约定俗成,不这么做也行),里面创建一个名为images的文件夹存放我们需要打标签的图片文件;再创建一个名为labels存放标注的标签文件;最后创建一个名为 classes.txt 的txt文件来存放所要标注的类别名称。
data的目录结构如下:
│─img_data
│─images 存放需要打标签的图片文件
│─labels 存放标注的标签文件
└ classes.txt 定义自己要标注的所有类别(这个文件可有可无,但是在我们定义类别比较多的时候,最好有这个创建一个这样的txt文件来存放类别)
首先在images这个文件夹放置待标注的图片。
生成文件如下:
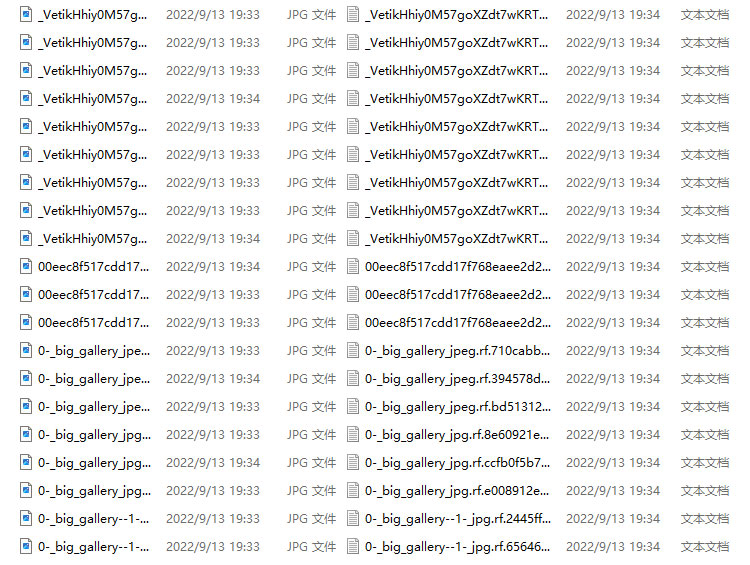
"classes.txt"定义了你的 YOLO 标签所引用的类名列表。

(4)YOLO模式创建标签的样式
存放标签信息的文件的文件名为与图片名相同,内容由N行5列数据组成。
每一行代表标注的一个目标,通常包括五个数据,从左到右依次为:类别id、x_center、y_center、width、height。
其中:
--x类别id代表标注目标的类别;
--x_center和y_center代表标注框的相对中心坐标;
--xwidth和height代表标注框的相对宽和高。
注意:这里的中心点坐标、宽和高都是相对数据!!!
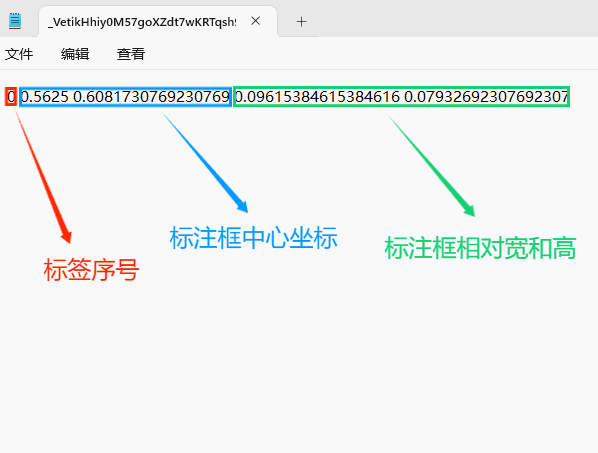
存放标签类别的文件的文件名为classes.txt (固定不变),用于存放创建的标签类别。
完成后可进行后续的yolo训练方面的操作。
模型训练
模型的训练、评估与推理
1.YOLOv8的基本原理
YOLOv8是一个SOTA模型,它建立在Yolo系列历史版本的基础上,并引入了新的功能和改进点,以进一步提升性能和灵活性,使其成为实现目标检测、图像分割、姿态估计等任务的最佳选择。其具体创新点包括一个新的骨干网络、一个新的Ancher-Free检测头和一个新的损失函数,可在CPU到GPU的多种硬件平台上运行。

YOLOv8是Yolo系列模型的最新王者,各种指标全面超越现有对象检测与实例分割模型,借鉴了Yolov5、Yolov6、YoloX等模型的设计优点,在全面提升改进Yolov5模型结构的基础上实现,同时保持了Yolov5工程化简洁易用的优势。
Yolov8模型网络结构图如下图所示:

2.数据集准备与训练
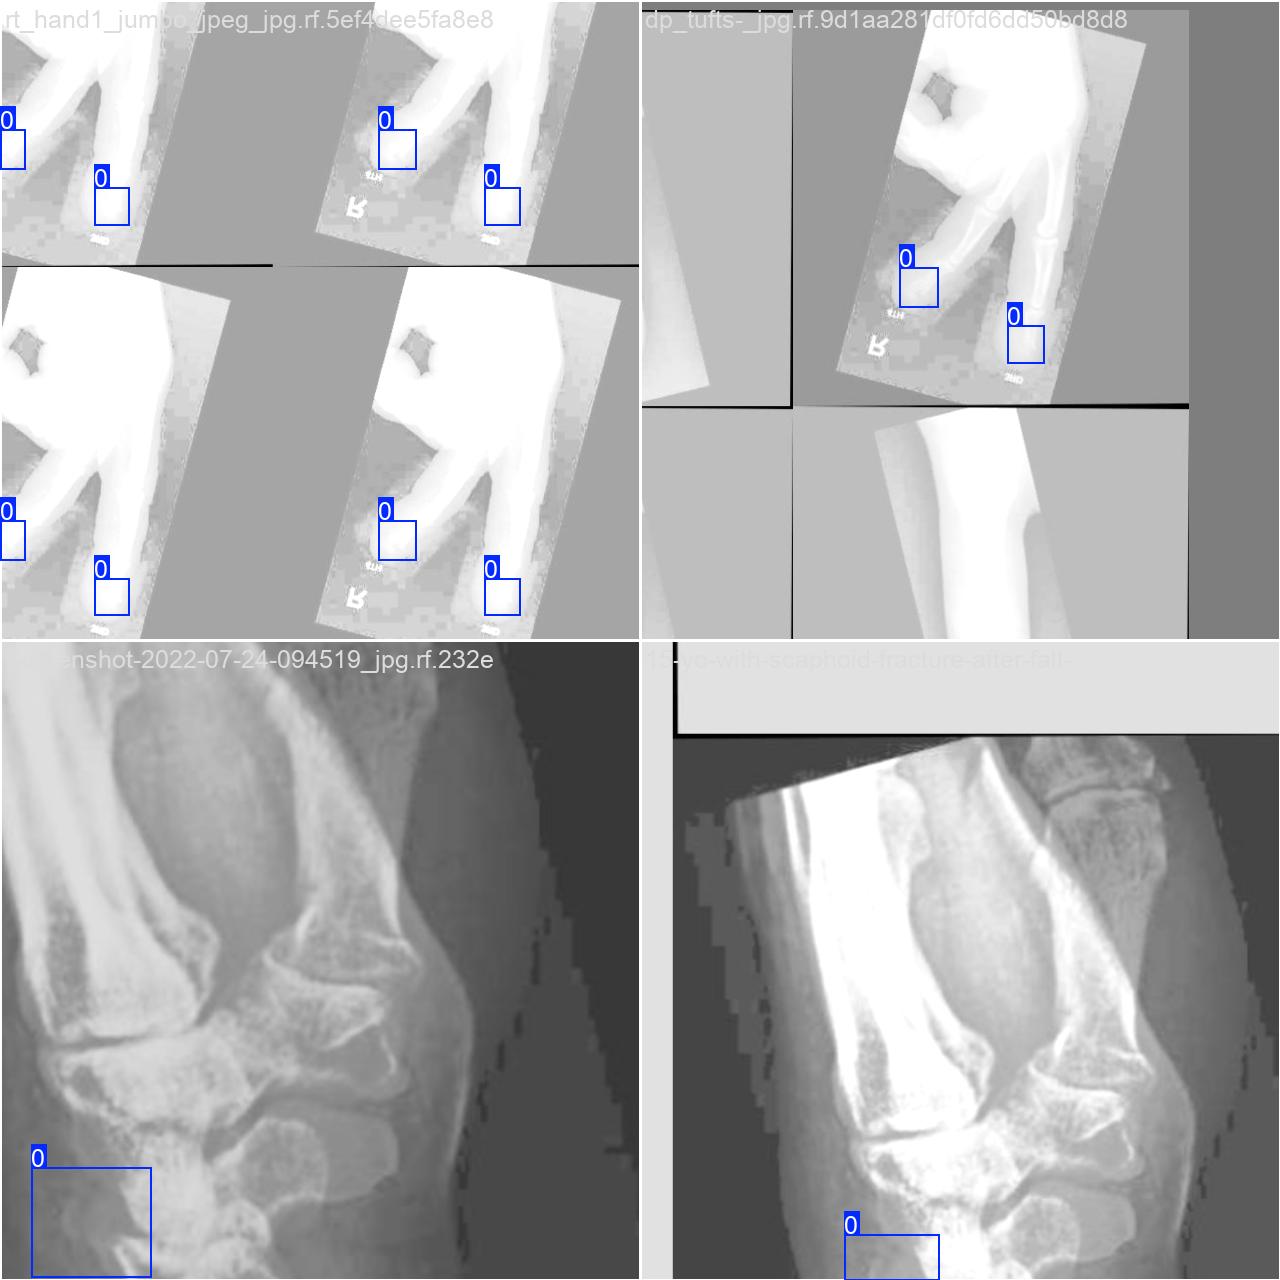
本研究使用了包含各种骨折相关图像的数据集,并通过Labelimg标注工具对每张图像中的目标边框(Bounding Box)及其类别进行标注。然后主要基于YOLOv8n这种模型进行模型的训练,训练完成后对模型在验证集上的表现进行全面的性能评估及对比分析。模型训练和评估流程基本一致,包括:数据集准备、模型训练、模型评估。本次标注的目标类别为骨折,数据集中共计包含10412张图像,其中训练集占9122张,验证集占843张,测试集占447张。部分图像如下图所示:

部分标注如下图所示:
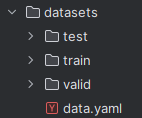
图片数据的存放格式如下,在项目目录中新建datasets目录,同时将检测的图片分为训练集与验证集放入datasets目录下。
接着需要新建一个data.yaml文件,用于存储训练数据的路径及模型需要进行检测的类别。YOLOv8在进行模型训练时,会读取该文件的信息,用于进行模型的训练与验证。
data.yaml的具体内容如下:

train: E:/FractureDetection_v8/datasets/train/images 训练集的路径
val: E:/FractureDetection_v8/datasets/valid/images 验证集的路径
test: E:/FractureDetection_v8/datasets/test/images 测试集的路径
nc: 1 模型检测的类别数,共有1个类别。
names: 'fracture'
这个文件定义了用于模型训练和验证的数据集路径,以及模型将要检测的目标类别。
数据准备完成后,通过调用train.py文件进行模型训练,epochs参数用于调整训练的轮数,batch参数用于调整训练的批次大小(根据内存大小调整,最小为1)。
CPU/GPU训练代码如下:
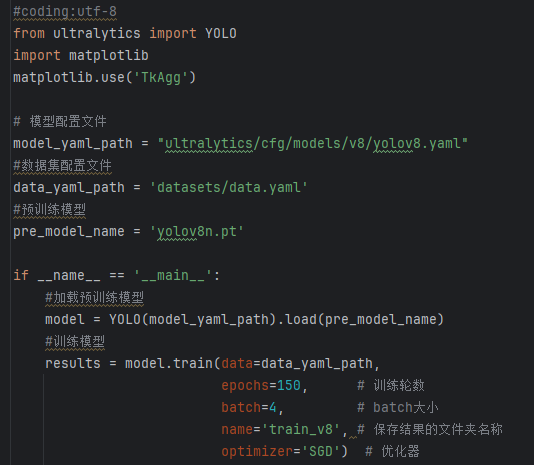
加载名为 yolov8n.pt 的预训练YOLOv8模型,yolov8n.pt是预先训练好的模型文件。
使用YOLO模型进行训练,主要参数说明如下:
(1)data=data_yaml_path: 指定了用于训练的数据集配置文件。
(2)epochs=150: 设定训练的轮数为150轮。
(3)batch=4: 指定了每个批次的样本数量为4。
(4)optimizer='SGD'):SGD 优化器。
(7)name='train_v8′: 指定了此次训练的命名标签,用于区分不同的训练实验。
3.训练结果评估
在深度学习的过程中,我们通常通过观察损失函数下降的曲线来了解模型的训练情况。对于YOLOv8模型的训练,主要涉及三类损失:定位损失(box_loss)、分类损失(cls_loss)以及动态特征损失(dfl_loss)。训练完成后,相关的训练过程和结果文件会保存在 runs/ 目录下,具体如下:
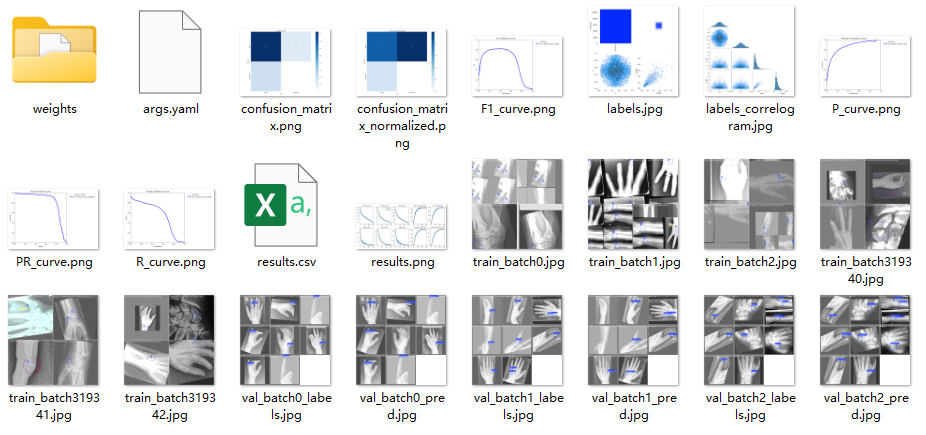
各损失函数作用说明:
定位损失box_loss:预测框与标定框之间的误差(GIoU),越小定位得越准;
分类损失cls_loss:计算锚框与对应的标定分类是否正确,越小分类得越准;
动态特征损失(dfl_loss):DFLLoss是一种用于回归预测框与目标框之间距离的损失函数。在计算损失时,目标框需要缩放到特征图尺度,即除以相应的stride,并与预测的边界框计算Ciou Loss,同时与预测的anchors中心点到各边的距离计算回归DFLLoss。这个过程是YOLOv8训练流程中的一部分,通过计算DFLLoss可以更准确地调整预测框的位置,提高目标检测的准确性。
训练结果如下:
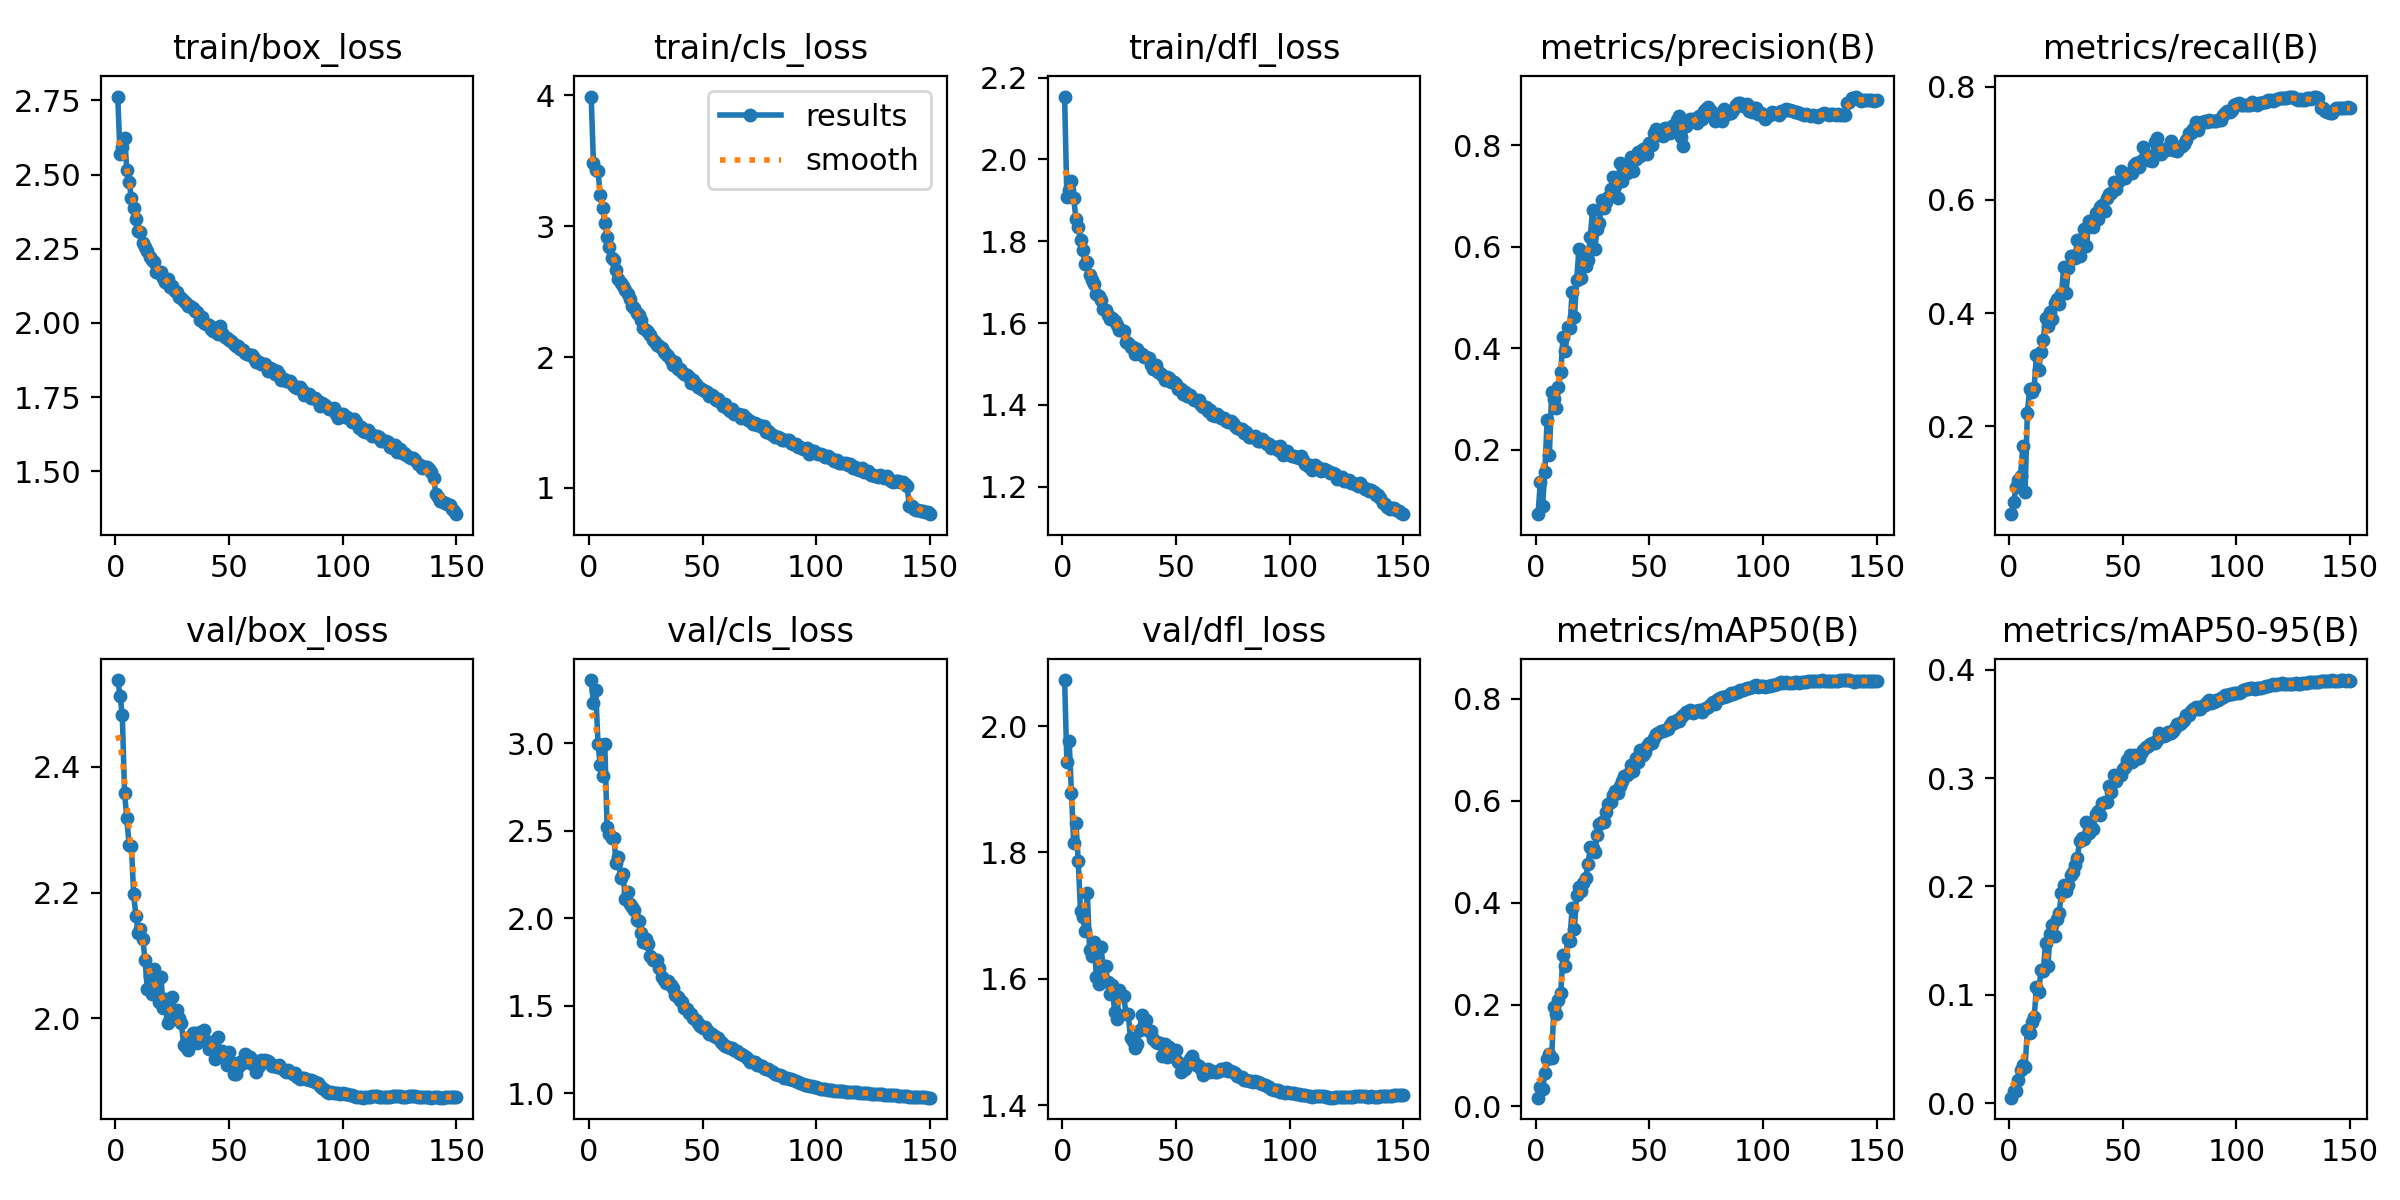
这张图展示了YOLOv8模型在训练和验证过程中的多个重要指标的变化趋势,具体如下:
train/box_loss:
(1)这是模型在训练过程中计算的边界框损失(Bounding Box Loss)。
(2)随着训练迭代次数增加,损失逐渐减少,表明模型在定位物体的边界框方面越来越准确。
train/cls_loss:
(1)这是分类损失(Classification Loss),表示模型在预测类别时的误差。
(2)曲线显示损失在逐步下降,说明模型在识别物体类别方面的准确度在提升。
train/dfl_loss:
(1)这是分布焦点损失(Distribution Focal Loss),用来优化边界框的定位。
(2)损失的下降表明模型在精细调整边界框时表现良好。
metrics/precision(B):
(1)训练过程中精确率(Precision)的变化。
(2)精确率反映了模型预测的正样本中有多少是正确的。曲线显示精确率随着训练逐渐提升,模型预测的正样本越来越准确。
metrics/recall(B):
(1)召回率(Recall)的变化。
(2)召回率反映了所有真实正样本中被正确检测出的比例。随着训练的进行,召回率也在不断提高,表明模型能够检测到更多的真实物体。
val/box_loss:
(1)验证集上的边界框损失。
(2)与训练集类似,验证集的边界框损失随着训练逐渐下降,表明模型在验证集上的目标框定位也在改善。
val/cls_loss:
(1)验证集上的分类损失。
(2)同样,随着迭代次数的增加,分类损失持续减少,表明模型在验证数据上也能较好地预测物体类别。
val/dfl_loss:
(1)验证集上的分布焦点损失。
(2)这条曲线的下降趋势表明模型在验证数据上的边界框预测也得到了不断优化。
metrics/mAP50(B):
(1)mAP50表示在IoU阈值为0.5时的平均精度(Mean Average Precision)。
(2)随着训练的进行,mAP50逐渐上升,表明模型在检测物体时的整体表现越来越好。
metrics/mAP50-95(B):
(1)mAP50-95表示在IoU阈值从0.5到0.95的平均精度。
(2)这个值比mAP50更加严格,显示了模型在更高要求下的表现。随着迭代的进行,mAP50-95曲线不断上升,表明模型在各个IoU阈值下的精度逐渐提高。
这组图表反映了模型在训练和验证过程中的表现。损失函数(box_loss、cls_loss、dfl_loss)不断降低,精确率、召回率和mAP值逐渐上升,说明模型在学习过程中不断优化并趋于收敛,最终在训练和验证数据上都表现出良好的检测能力。

这张图展示的是 Precision-Recall 曲线,用于评估模型在不同类别下的检测性能。以下是详细解释:
Precision-Recall 曲线的含义:
(1)Precision(精度):表示模型预测为正类的样本中,有多少是真正的正类样本。
(2)Recall(召回率):表示所有正类样本中,有多少被模型正确检测出来。
(3)Precision-Recall 曲线:随着模型预测阈值的变化,精度和召回率的关系也随之变化。理想情况下,精度和召回率都应该接近1。
曲线的形状:
(1)该曲线表示在不同的召回率下,模型的精确率如何变化。
(2)通常情况下,随着召回率的增加,精确率会下降,这表明模型在努力提高召回率的同时,可能会引入更多的错误检测。
骨折检测类的mAP:
(1)图例显示,骨折检测的平均精度(mAP@0.5)为0.835,表示在IoU阈值为0.5的情况下,模型的整体精确度较高。
(2)曲线表示的是"all classes"(所有类别)的检测性能,但因为图例只显示了"fracture"类别,说明这次检测主要集中在骨折的识别上。
整体评估:
(1)从曲线可以看出,模型在大部分召回率范围内保持了较高的精确率,但当召回率接近1.0时,精确率开始迅速下降。
(2)这是正常现象,因为当模型试图捕获所有可能的正样本时,可能会引入更多的错误预测。
该精确率-召回率曲线显示了模型在骨折检测任务中的整体表现,mAP@0.5为0.835,表明模型具有较高的检测性能,同时也能够较好地平衡精确率和召回率。
4.检测结果识别
模型训练完成后,我们可以得到一个最佳的训练结果模型best.pt文件,在runs/train/weights目录下。我们可以使用该文件进行后续的推理检测。
imgTest.py 图片检测代码如下:

加载所需库:
(1)from ultralytics import YOLO:导入YOLO模型类,用于进行目标检测。
(2)import cv2:导入OpenCV库,用于图像处理和显示。
加载模型路径和图片路径:
(1)path = 'models/best.pt':指定预训练模型的路径,这个模型将用于目标检测任务。
(2)img_path = "TestFiles/imagetest.jpg":指定需要进行检测的图片文件的路径。
加载预训练模型:
(1)model = YOLO(path, task='detect'):使用指定路径加载YOLO模型,并指定检测任务为目标检测 (detect)。
(2)通过 conf 参数设置目标检测的置信度阈值,通过 iou 参数设置非极大值抑制(NMS)的交并比(IoU)阈值。
检测图片:
(1)results = model(img_path):对指定的图片执行目标检测,results 包含检测结果。
显示检测结果:
(1)res = results0.plot():将检测到的结果绘制在图片上。
(2)cv2.imshow("YOLOv8 Detection", res):使用OpenCV显示检测后的图片,窗口标题为"YOLOv8 Detection"。
(3)cv2.waitKey(0):等待用户按键关闭显示窗口
此代码的功能是加载一个预训练的YOLOv8模型,对指定的图片进行目标检测,并将检测结果显示出来。
执行imgTest.py代码后,会将执行的结果直接标注在图片上,结果如下:
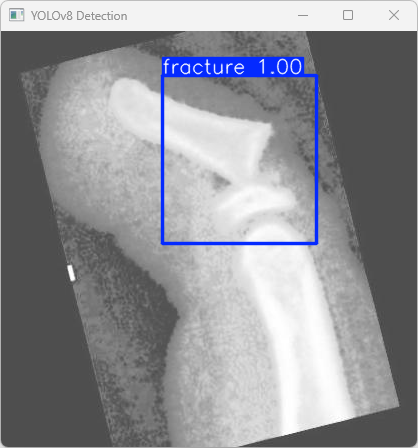
这段输出是基于YOLOv8模型对图片"imagetest.jpg"进行检测的结果,具体内容如下:
图像信息:
(1)处理的图像路径为:TestFiles/imagetest.jpg。
(2)图像尺寸为 640×640 像素。
检测结果:
(1)模型检测到图片中有1个骨折 (fracture)。
(2)每张图片的推理时间4.0毫秒。
处理速度:
(1)预处理时间:4.4毫秒,用于准备输入图像数据。
(2)推理时间:4.0毫秒,用于模型推理,即检测骨折的时间。
(3)后处理时间:48.7毫秒,用于将推理结果转换为可视化或保存的结果。
显示了YOLOv8模型成功地检测到了一张测试图像中的一个骨折,检测速度较快,且结果已保存到指定的文件夹中。
运行效果
-- 运行 MainProgram.py

1.主要功能:
(1)可用于实时检测目标图片中的骨折;
(2)支持图片、视频及摄像头进行检测,同时支持图片的批量检测;
(3)界面可实时显示目标位置、目标总数、置信度、用时等信息;
(4)支持图片或者视频的检测结果保存。
2.检测结果说明:

这张图表显示了基于YOLOv8模型的目标检测系统的检测结果界面。以下是各个字段的含义解释:
用时(Time taken):
(1)这表示模型完成检测所用的时间为0.014秒。
(2)这显示了模型的实时性,检测速度非常快。
目标数目(Number of objects detected):
(1)检测到的目标数目为1,表示这是当前检测到的第1个目标。
目标选择(下拉菜单):全部:
(1)这里有一个下拉菜单,用户可以选择要查看的目标类型。
(2)在当前情况下,选择的是"全部",意味着显示所有检测到的目标信息。
类型(Type):
(1)当前选中的类型为 "骨折",表示系统正在高亮显示检测到的"Fracture"。
置信度(Confidence):
(1)这表示模型对检测到的目标属于"骨折"类别的置信度为97.60%。
(2)置信度反映了模型的信心,置信度越高,模型对这个检测结果越有信心。
目标位置(Object location):
(1)xmin: 115, ymin: 152:目标的左上角的坐标(xmin, ymin),表示目标区域在图像中的位置。
(2)xmax: 224, ymax: 276:目标的右下角的坐标(xmax, ymax),表示目标区域的边界。
这些坐标表示在图像中的目标区域范围,框定了检测到的"骨折"的位置。
这张图展示了骨折检测系统的一次检测结果,包括检测时间、检测到的种类、各行为的置信度、目标的位置信息等。用户可以通过界面查看并分析检测结果,提升医生诊断的效率。
3.图片检测说明

点击打开图片按钮,选择需要检测的图片,或者点击打开文件夹按钮,选择需要批量检测图片所在的文件夹。
操作演示如下:
(1)点击目标下拉框后,可以选定指定目标的结果信息进行显示。
(2)点击保存按钮,会对检测结果进行保存,存储路径为:save_data目录下。
检测结果:系统识别出图片中的骨折,并显示检测结果,包括总目标数、用时、目标类型、置信度、以及目标的位置坐标信息。
4.视频检测说明
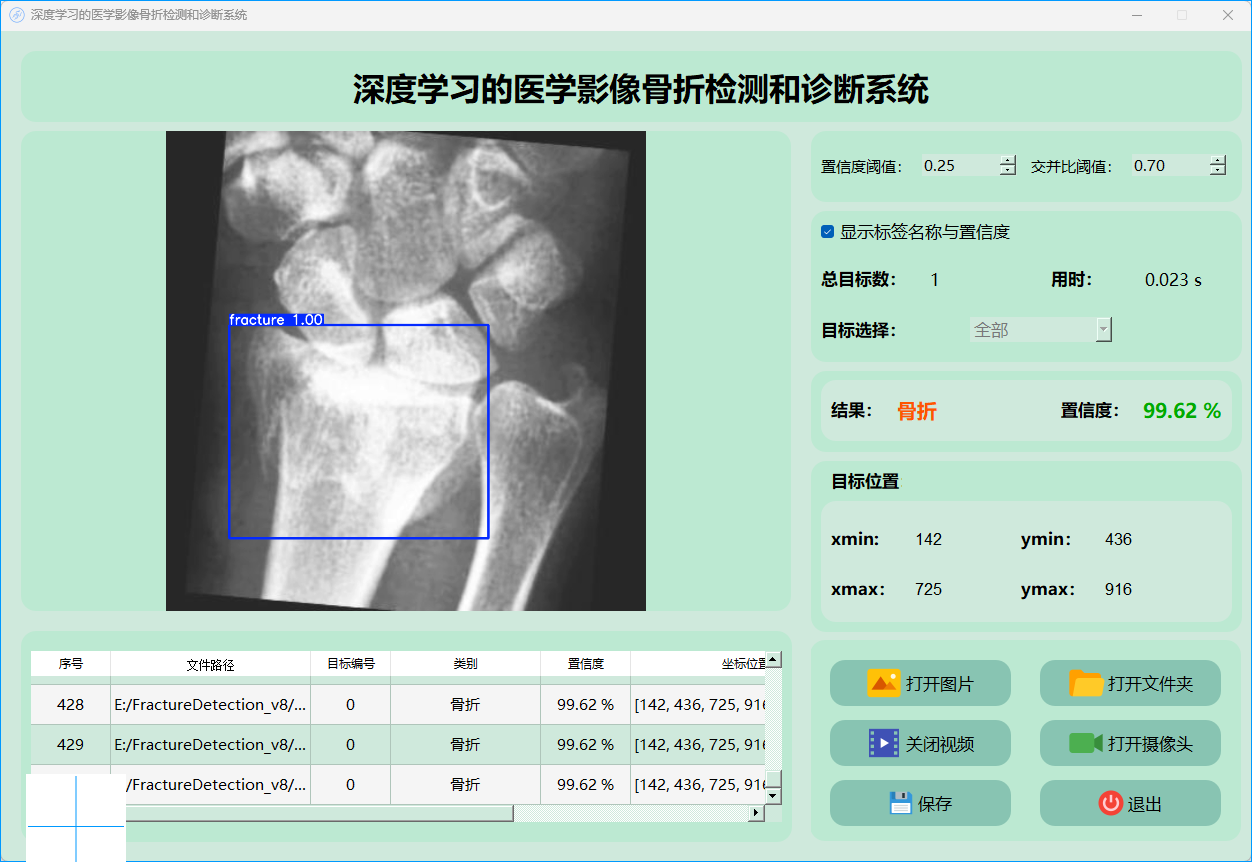
点击视频按钮,打开选择需要检测的视频,就会自动显示检测结果,再次点击可以关闭视频。
点击保存按钮,会对视频检测结果进行保存,存储路径为:save_data目录下。
检测结果:系统对视频进行实时分析,检测到骨折并显示检测结果。表格显示了视频中多个检测结果的置信度和位置信息。
这个界面展示了系统对视频帧中的多目标检测能力,能够准确识别骨折,并提供详细的检测结果和置信度评分。
5.摄像头检测说明

点击打开摄像头按钮,可以打开摄像头,可以实时进行检测,再次点击,可关闭摄像头。
检测结果:系统连接摄像头进行实时分析,检测到骨折并显示检测结果。实时显示摄像头画面,并将检测到的行为位置标注在图像上,表格下方记录了每一帧中检测结果的详细信息。
6.保存图片与视频检测说明
点击保存按钮后,会将当前选择的图片(含批量图片)或者视频的检测结果进行保存。
检测的图片与视频结果会存储在save_data目录下。
保存的检测结果文件如下:

图片文件保存的csv文件内容如下,包括图片路径、目标在图片中的编号、目标类别、置信度、目标坐标位置。
注:其中坐标位置是代表检测框的左上角与右下角两个点的x、y坐标。
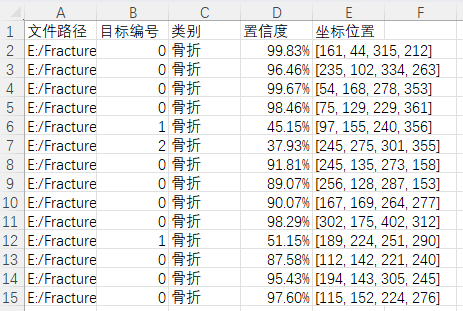
(1)图片保存
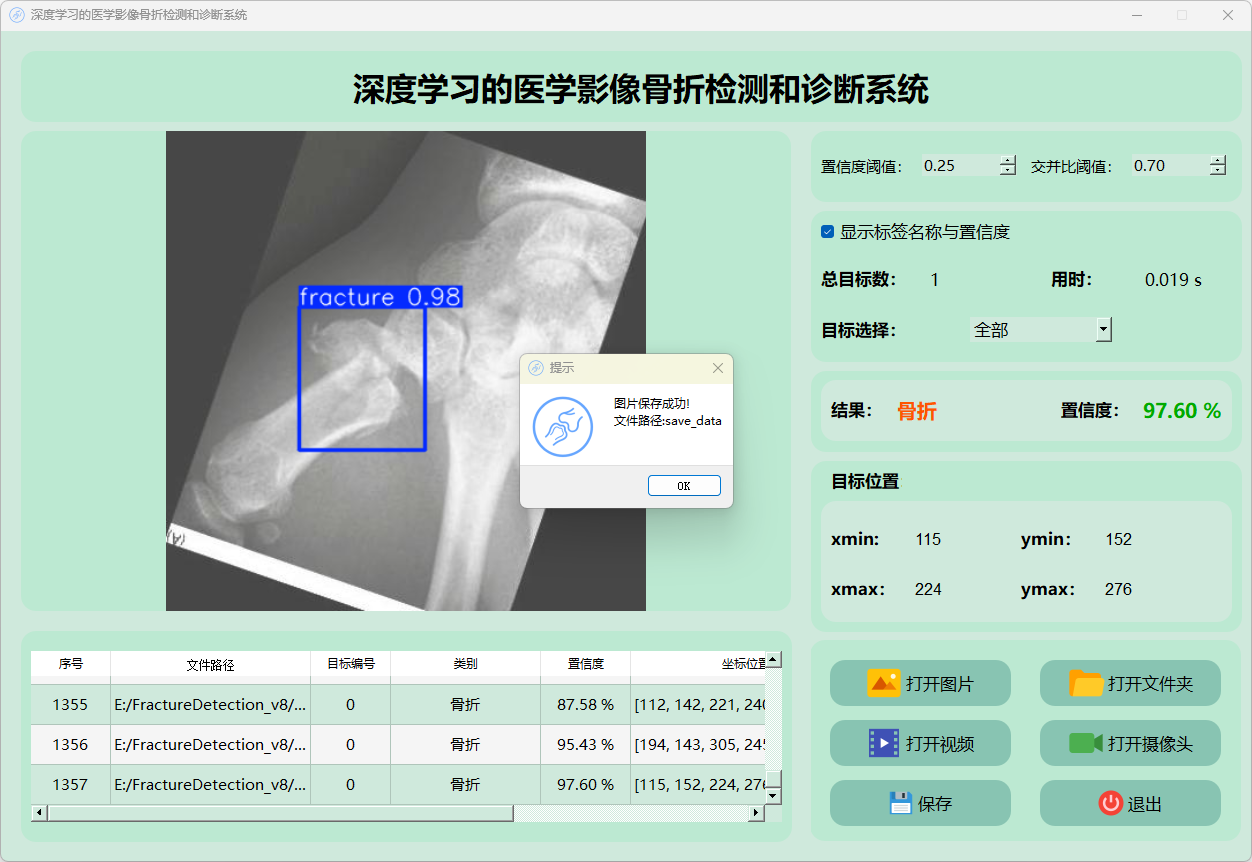
(2)视频保存

-- 运行 train.py
1.训练参数设置
(1)data=data_yaml_path: 使用data.yaml中定义的数据集。
(2)epochs=150: 训练的轮数设置为150轮。
(3)batch=4: 每个批次的图像数量为4(批次大小)。
(4)name='train_v8′: 训练结果将保存到以train_v8为名字的目录中。
(5)optimizer='SGD': 使用随机梯度下降法(SGD)作为优化器。
虽然在大多数深度学习任务中,GPU通常会提供更快的训练速度。
但在某些情况下,可能由于硬件限制或其他原因,用户需要在CPU上进行训练。
温馨提示:在CPU上训练深度学习模型通常会比在GPU上慢得多,尤其是像YOLOv8这样的计算密集型模型。除非特定需要,通常建议在GPU上进行训练以节省时间。
2.训练日志结果
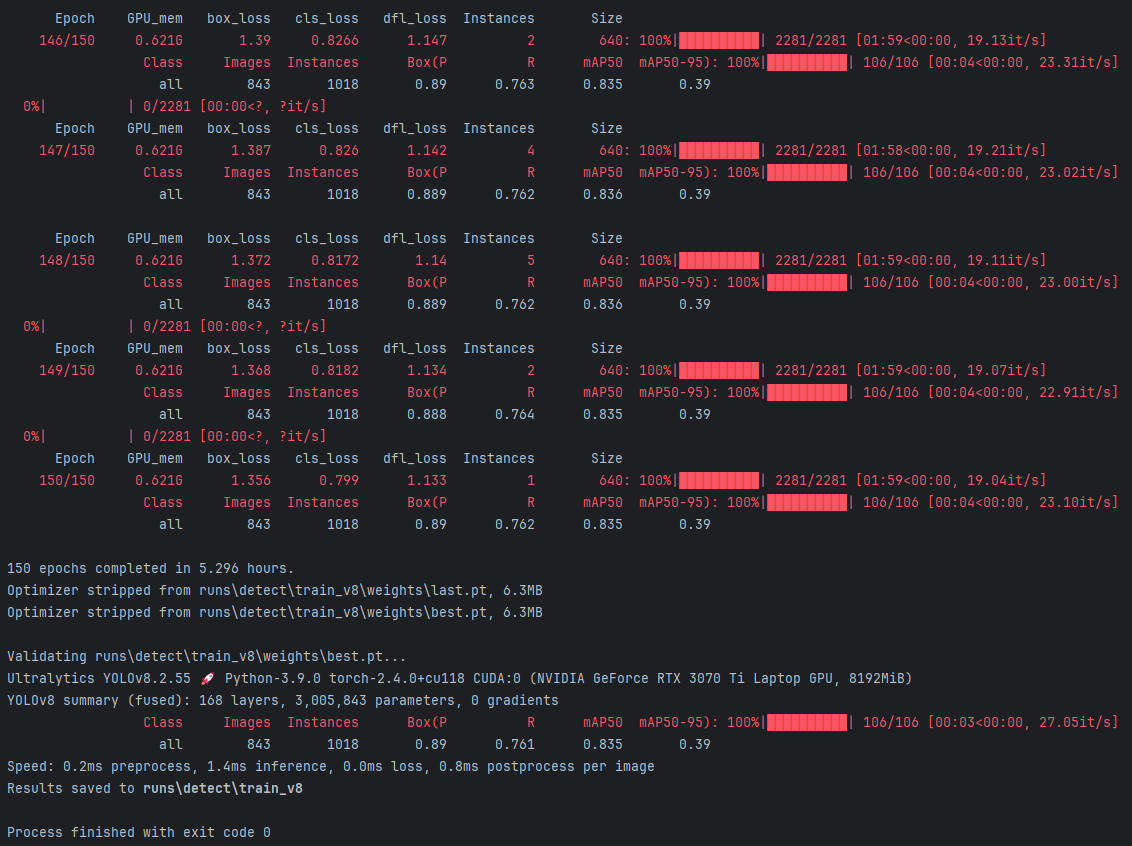
这张图展示了使用YOLOv8进行模型训练的详细过程和结果。
训练总时长:
(1)模型在训练了150轮后,总共耗时5.296小时。
mAP50 (平均精度 @ IoU=50%):
(1)表示在IoU(交并比)阈值为0.5时,模型的平均精度(Mean Average Precision, mAP)为83.5%。
(2)这是一个常用的衡量检测性能的指标。
mAP50-95 (平均精度 @ IoU=50%-95%):
(1)表示在IoU阈值从0.5到0.95变化范围内的平均精度为0.39%。
(2)相比mAP50,这个值更严格,因此数值较低。
推理速度:
(1)预处理时间:0.2ms
(2)推理时间:4.1ms
(3)后处理时间:0.8ms
结果保存:
(1)Results saved to runs\detect\train_v8:验证结果保存在 runs\detect\train_v8 目录下。
完成信息:
(1)Process finished with exit code 0:表示整个验证过程顺利完成,没有报错。
该图显示了YOLOv8模型在检测任务中的表现,表明其在较低IoU阈值下有较好的精确度和召回率,同时推理速度也相对较快。