Jsoup 是一款 Java 的 HTML 解析器,可直接解析某个 URL 地址、HTML 文本内容。它提供了一套非常省力的 API,可通过 DOM,CSS 以及类似于 JQuery 的操作方法来取出和操作数据。
中文文档:Jsoup 快速入门 | JAVA-TUTORIAL
1. Jsoup相关概念
- Document
- 定义:Document 对象表示整个 HTML 文档。
- 用途:用于解析 HTML 字符串或从 URL 获取 HTML 内容。
- Element
- 定义:Element 对象表示 HTML 中的一个标签元素。
- 用途:用于选择和操作具体的 HTML 元素。
- Elements
- 定义:Elements 对象是一个 Element 对象的集合。
- 用途:用于存储多个匹配的元素。
- Node
- 定义:Node 是 Element 和 Text 的基类,表示 HTML 文档中的节点。
- 用途:用于更细粒度的操作,如处理注释、文档类型声明等。
- TextNode
- 定义:TextNode 表示 HTML 文档中的纯文本节点。
- 用途:用于处理元素内的文本内容。
- CSS 选择器
- 定义:CSS 选择器是一种用于选择 HTML 元素的语法。
- 用途:用于精确选择文档中的特定元素。
- 常用选择器:
- #id:选择具有指定 ID 的元素。
- .class:选择具有指定类的元素。
- tag:选择指定标签的元素。
- tagattr:选择具有指定属性的元素。
- tagattr=value:选择具有指定属性值的元素。
- 连接和请求
- 定义:Jsoup 提供了连接到 URL 并获取 HTML 文档的功能。
- 用途:用于从远程服务器获取 HTML 内容。
2.Jsoup 的优点
1.易用性:
- 简洁的 API:Jsoup 提供了非常简洁和直观的 API,使得开发者可以快速上手。
- 链式调用:支持链式调用,使代码更加简洁和可读。
2.强大的解析能力:
- HTML 解析:能够解析不规范的 HTML,即使 HTML 结构不完整也能正确解析。
- CSS 选择器:支持类似于 jQuery 的 CSS 选择器,方便提取和操作 HTML 元素。
3.网络请求:
- HTTP 请求:内置了简单的 HTTP 客户端,可以方便地发送 GET 和 POST 请求。
- 自动处理重定向:支持自动处理 HTTP 重定向。
4.安全性:
- HTML 清洗:提供了 Jsoup.clean 方法,可以清理 HTML 以防止 XSS 攻击,确保输出的安全性。
3.Jsoup 的缺点
1.性能问题:
- 内存消耗:在处理大文件或大量数据时,Jsoup 可能会消耗较多的内存,尤其是在解析复杂的 HTML 文档时。
- 速度较慢:与一些低级别的解析库相比,Jsoup 的解析速度可能稍慢,特别是在高并发场景下。
2.功能限制:
- 有限的 HTTP 功能:虽然内置了 HTTP 客户端,但功能相对简单,对于复杂的需求(如多线程请求、高级认证等)可能需要额外的库支持。
- 缺乏高级特性:相比于一些更专业的爬虫框架(如 Scrapy),Jsoup 缺乏一些高级特性,如分布式爬取、自动反爬机制等。
3.依赖管理:
- 依赖项:Jsoup 本身依赖较少,但在实际项目中可能需要引入其他库来补充其功能,增加了项目的复杂性。
4.错误处理:
- 异常处理:Jsoup 的异常处理机制较为简单,对于一些复杂的错误情况可能需要开发者自行处理。
4. 执行流程

4.1. 添加依赖
<dependency>
    <groupId>org.jsoup</groupId>
    <artifactId>jsoup</artifactId>
    <version>1.14.3</version>
</dependency>
4.2. 获取 Document
Jsoup 类方法列表:
方法名称
是否静态
参数
返回值
描述
parse(String html)
是
String html
Document
从字符串中解析 HTML 并返回一个 Document 对象。
parse(File in, String charsetName)
是
File in, String charsetName
Document
从文件中解析 HTML 并返回一个 Document 对象。
parse(URL url, int timeoutMillis)
是
URL url, int timeoutMillis
Document
从 URL 中解析 HTML 并返回一个 Document 对象。
connect(String url)
是
String url
Connection
创建一个新的 Connection 对象,用于发送 HTTP 请求。
Connection 类方法列表:
方法名称
是否静态
参数
返回值
描述
method(Method method)
否
Method method
Connection
设置请求方法(GET、POST 等)。
url(URL url)
否
URL url
Connection
设置请求的 URL。
requestBody(String requestBody)
否
String requestBody
Connection
设置请求体内容。
data(String key, String value)
否
String key, String value
Connection
添加表单数据。
header(String key, String value)
否
String key, String value
Connection
添加请求头。
userAgent(String userAgent)
否
String userAgent
Connection
设置 User-Agent。
referrer(String referrer)
否
String referrer
Connection
设置 Referer。
timeout(int millis)
否
int millis
Connection
设置连接超时时间(毫秒)。
followRedirects(boolean follow)
否
boolean follow
Connection
设置是否自动跟随重定向。
ignoreHttpErrors(boolean ignore)
否
boolean ignore
Connection
设置是否忽略 HTTP 错误(如 404)。
ignoreContentType(boolean ignore)
否
boolean ignore
Connection
设置是否忽略内容类型检查。
maxBodySize(int maxSize)
否
int maxSize
Connection
设置响应体的最大大小(字节)。
cookie(String key, String value)
否
String key, String value
Connection
添加 Cookie。
cookies(Map<String, String> cookies)
否
Map<String, String> cookies
Connection
添加多个 Cookie。
execute()
否
无
Connection.Response
执行请求并返回响应对象。
get()
否
无
Document
发送 GET 请求并返回解析后的 Document 对象。
post()
否
无
Document
发送 POST 请求并返回解析后的 Document 对象。
Connection.Response 类方法列表:
方法名称
是否静态
参数
返回值
描述
body()
否
无
String
获取响应体内容。
parse()
否
无
Document
解析响应体为 Document 对象。
statusCode()
否
无
int
获取响应状态码。
statusMessage()
否
无
String
获取响应状态消息。
url()
否
无
URL
获取最终请求的 URL(可能经过重定向)。
headers()
否
无
Map<String, List>
获取响应头。
header(String key)
否
String key
String
获取指定响应头的值。
cookies()
否
无
Map<String, String>
获取响应中的 Cookie。
cookie(String key)
否
String key
String
获取指定 Cookie 的值。
4.3. 获取Element 或 Elements 及 文本内容
Document 类方法列表:
方法名称
是否静态
参数
返回值
描述
title()
否
无
String
获取文档的标题。
select(String cssQuery)
否
String cssQuery
Elements
使用 CSS 选择器选择元素。
getElementsByTag(String tagName)
否
String tagName
Elements
获取指定标签名的所有元素。
getElementById(String id)
否
String id
Element
获取指定 ID 的元素。
html()
否
无
String
获取文档的 HTML 内容。
text()
否
无
String
获取文档的文本内容。
Elements 类方法列表:
方法名称
是否静态
参数
返回值
描述
first()
否
无
Element
获取第一个元素。
last()
否
无
Element
获取最后一个元素。
size()
否
无
int
获取元素的数量。
get(int index)
否
int index
Element
获取指定索引的元素。
eachText()
否
无
List
获取所有元素的文本内容列表。
eachAttr(String attributeKey)
否
String attributeKey
List
获取所有元素的指定属性值列表。
Element 类方法列表:
方法名称
是否静态
参数
返回值
描述
attr(String key)
否
String key
String
获取元素的属性值。
removeAttr(String key)
否
String key
Element
移除元素的属性。
addClass(String className)
否
String className
Element
添加 CSS 类。
removeClass(String className)
否
String className
Element
移除 CSS 类。
text()
否
无
String
获取元素的文本内容。
html()
否
无
String
获取元素的 HTML 内容。
append(String html)
否
String html
Element
在元素末尾追加 HTML。
prepend(String html)
否
String html
Element
在元素开头插入 HTML。
select(String cssQuery)
否
String cssQuery
Elements
使用 CSS 选择器选择子元素。
5.CSS 选择器
5.1.基本选择器
1.标签选择器
- 选择所有
标签:div - 选择所有 标签:a
2.类选择器
- 选择所有带有 class="example" 的元素:.example
3.ID 选择器
- 选择 ID 为 example 的元素:#example
4.属性选择器
- 选择所有带有 href 属性的 标签:ahref
- 选择所有 href 属性值为 http://example.com 的 标签:ahref="http://example.com"
- 选择所有 href 属性值包含 example 的 标签:ahref\*="example"
- 选择所有 href 属性值以 http 开头的 标签:ahref\^="http"
- 选择所有 href 属性值以 .html 结尾的 标签:ahref$=".html"
- 选择所有 src 属性值匹配正则表达式的 标签:imgsrc\~=(i)(png\|jpeg)
5.命名空间选择器
- 选择所有在 fb 命名空间中的 name 标签:fb|name
6.通配符选择器
- 选择所有元素:*
5.2.组合选择器
1.后代选择器
-
选择所有在
内部的标签:div p
2.子选择器
-
选择所有直接在
内部的标签:div > p
3.相邻兄弟选择器
-
选择所有紧接在
后面的
标签:h1 + p
4.通用兄弟选择器
-
选择所有在
后面的
标签:h1 ~ p
5.元素+ID
- 选择所有带有 ID 为 logo 的
标签:div#logo
6.元素+类
- 选择所有带有 class="title" 的
标签:div.title
7.元素+属性
- 选择所有带有 href 属性的 标签:ahref
- 多个类选择器
- 选择所有同时带有 class="info" 和 class="active" 的元素:.info.active
9.多个选择器组合
- 选择所有带有 class="highlight" 且带有 href 属性的 标签:ahref.highlight
5.3.伪类选择器
1.索引选择器
-
选择索引值小于 3 的 标签:td:lt(3)
-
选择索引值大于 2 的 标签:div p:gt(2)
-
选择索引值等于 1 的 标签:form input:eq(1)
- 包含选择器
-
选择包含 标签的
标签:div:has§
-
选择不包含 class="logo" 的所有
标签:div:not(.logo)
3.文本匹配选择器
-
选择包含文本 jsoup 的 标签:p:contains(jsoup)
-
选择直接包含文本 jsoup 的 标签:p:containsOwn(jsoup)
4.正则表达式匹配选择器
- 选择文本匹配正则表达式的
标签:div:matches((i)login) - 选择自身包含文本匹配正则表达式的
标签:div:matchesOwn((i)login)
6. 实战示例
以爬取https://ssr3.scrape.center/这个网站为例:
-
获取所有电影信息。
import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;
import org.jsoup.nodes.Element;
import org.jsoup.select.Elements;
import org.junit.jupiter.api.Test;
import org.springframework.boot.test.context.SpringBootTest;
import org.springframework.http.HttpHeaders;import java.io.IOException;
@SpringBootTest
public class JsoupTests {
@Test
public void testJsoup() throws IOException {
String url = "https://ssr3.scrape.center/";
Document document = Jsoup.connect(url)
.header(HttpHeaders.AUTHORIZATION, "Basic YWRtaW46YWRtaW4=")
.get();
// 解析电影信息
Elements movieItems = document.select(".el-card__body");
for (Element item : movieItems) {
// 提取电影名称和链接
Element nameLink = item.select("a.name").first();
if (nameLink != null) {
String movieName = nameLink.select("h2").text();
String movieUrl = nameLink.attr("href");// 提取电影封面URL Element coverImage = item.select("img.cover").first(); String coverImageUrl = coverImage != null ? coverImage.attr("src") : "N/A"; // 提取电影类别 String category = item.select(".el-button.category").text(); // 提取国家和片长 Elements infoElements = item.select(".info"); String countryAndDuration = infoElements.get(0).text(); String[] parts = countryAndDuration.split(" / "); String country = parts[0]; String duration = parts[1]; // 提取上映日期 String releaseDate = infoElements.get(1).text(); // 提取评分 String score = item.select(".score").text(); // 提取星级评分 String starRating = item.select(".el-rate").attr("aria-valuenow"); // 打印提取的信息 System.out.println("电影名称: " + movieName); System.out.println("电影链接: " + movieUrl); System.out.println("电影封面URL: " + coverImageUrl); System.out.println("电影类别: " + category); System.out.println("国家: " + country); System.out.println("片长: " + duration); System.out.println("上映日期: " + releaseDate); System.out.println("评分: " + score); System.out.println("星级评分: " + starRating); System.out.println("----------------------------"); } } }}
测试结果为:

-
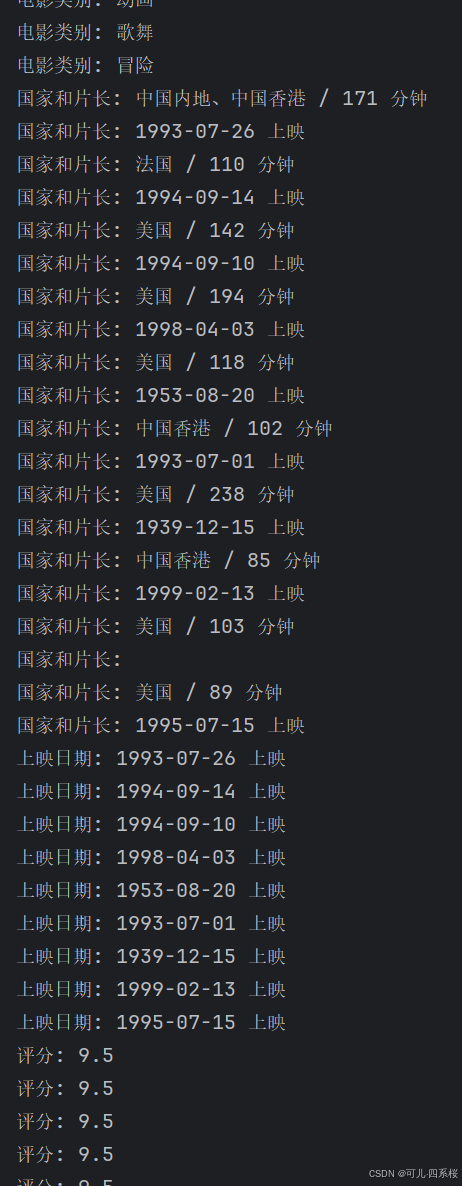
打印所有电影的电影类别、国家和片长、上映日期、评分、星级评分、总条数及页面链接
import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;
import org.jsoup.nodes.Element;
import org.jsoup.select.Elements;
import org.junit.jupiter.api.Test;
import org.springframework.boot.test.context.SpringBootTest;
import org.springframework.http.HttpHeaders;import java.io.IOException;
@SpringBootTest
public class JsoupTests {
public static void main(String[] args) {
String url = "https://ssr3.scrape.center/";try { // 连接并获取文档 Document document = Jsoup.connect(url) .header("Authorization", "Basic YWRtaW46YWRtaW4=") .get(); // 提取电影类别 Elements categoryButtons = document.select(".el-button.category"); for (Element button : categoryButtons) { System.out.println("电影类别: " + button.text()); } // 提取国家和片长 Elements infoDivs = document.select(".info"); for (Element div : infoDivs) { System.out.println("国家和片长: " + div.text()); } // 提取上映日期 Elements releaseDateDivs = document.select(".info:contains(上映)"); for (Element div : releaseDateDivs) { System.out.println("上映日期: " + div.text()); } // 提取评分 Elements scoreElements = document.select(".score"); for (Element score : scoreElements) { System.out.println("评分: " + score.text()); } // 提取星级评分 Elements rateElements = document.select(".el-rate"); for (Element rate : rateElements) { int fullStars = rate.select(".el-rate__icon.el-icon-star-on").size(); int halfStar = rate.select(".el-rate__decimal.el-icon-star-on").size(); double rating = fullStars + (halfStar > 0 ? 0.5 : 0); System.out.println("星级评分: " + rating); } // 提取分页信息 Element pagination = document.select(".el-pagination").first(); if (pagination != null) { String totalItems = pagination.select(".el-pagination__total").text(); System.out.println("总条数: " + totalItems); Elements pageLinks = pagination.select(".el-pager li.number a"); for (Element link : pageLinks) { System.out.println("页面链接: " + link.attr("href")); } } } catch (IOException e) { e.printStackTrace(); } }}
打印结果: