我们遇到一些自己喜欢内容,想保存下来,手动复制粘贴很麻烦,我们使用 python 来爬取这些内容。
一、代码
python
import os
import requests
from bs4 import BeautifulSoup
from urllib.parse import urljoin
# 目标网页(可以更改)
url = "https://www.baidu.com"
# 指定保存的文件夹和 Markdown 文件名
save_folder = "web_md"
os.makedirs(save_folder, exist_ok=True)
md_filename = os.path.join(save_folder, "page.md")
images_folder = os.path.join(save_folder, "images")
os.makedirs(images_folder, exist_ok=True)
# 获取网页内容
response = requests.get(url)
response.encoding = response.apparent_encoding
soup = BeautifulSoup(response.text, "html.parser")
# 打开 Markdown 文件
with open(md_filename, "w", encoding="utf-8") as md_file:
md_file.write(f"# {soup.title.string.strip()}\n\n")
for element in soup.body.find_all(["p", "a", "code", "img", "h1", "h2", "h3", "h4", "h5", "h6", "pre"], recursive=True):
if element.name == "h1":
md_file.write(f"\n# {element.get_text(strip=True)}\n\n")
elif element.name == "h2":
md_file.write(f"\n## {element.get_text(strip=True)}\n\n")
elif element.name == "h3":
md_file.write(f"\n### {element.get_text(strip=True)}\n\n")
elif element.name == "h4":
md_file.write(f"\n#### {element.get_text(strip=True)}\n\n")
elif element.name == "p":
md_file.write(f"{element.get_text(strip=True)}\n\n")
elif element.name == "a":
link_text = element.get_text(strip=True)
href = urljoin(url, element["href"])
md_file.write(f"[{link_text}]({href})\n\n")
elif element.name == "code":
md_file.write(f"```\n{element.get_text(strip=True)}\n```\n\n")
elif element.name == "pre":
md_file.write(f"```\n{element.get_text()}\n```\n\n")
elif element.name == "img":
img_url = urljoin(url, element["src"])
img_name = os.path.basename(img_url).split("?")[0]
img_path = os.path.join(images_folder, img_name)
try:
img_data = requests.get(img_url).content
with open(img_path, "wb") as img_file:
img_file.write(img_data)
md_file.write(f"\n\n")
except Exception as e:
print(f"下载 {img_url} 失败: {e}")
print(f"Markdown 文件已保存至 {md_filename}")二、安装环境
- 安装 python
- 管理员运行 cmd,最好挂梯子
bash
pip install requests beautifulsoup4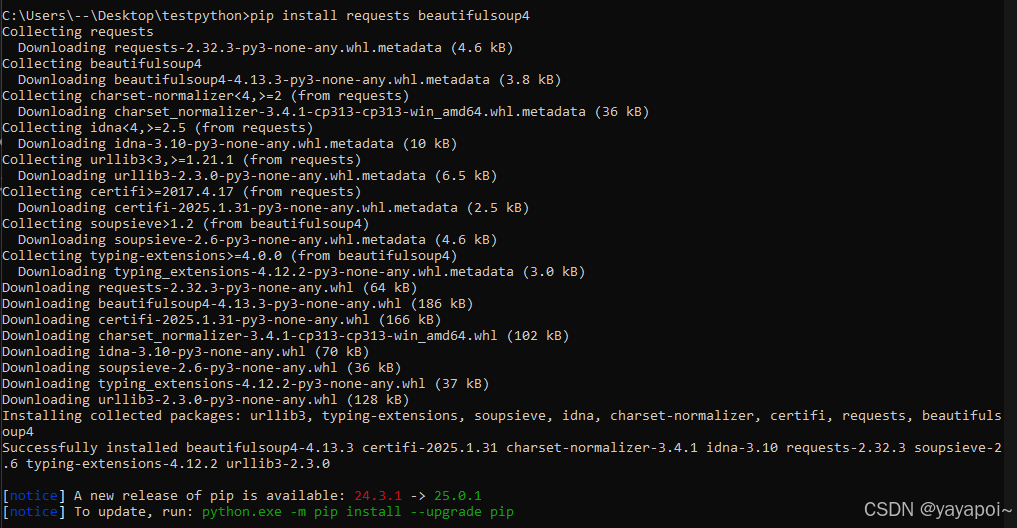
- 在 downlod.py 同级目录下运行cmd
bash
python download.py


三、vscode + markdown all in one
- 安装 vscode
- vscode 的扩展安装 markdown all in one

- vscode 打开下载的 md 文件
- 点击右上角的 预览 按钮,即可预览转换后的 md 文件

- ctrl + shift + p,打开命令模式
- 输入 markdown ,使用这个命令,可以将md转为 html 格式

