文章目录
- 每日一句正能量
- [第4章 Spark SQL结构化数据文件处理](#第4章 Spark SQL结构化数据文件处理)
- 章节概要
-
- [4.4 RDD转换DataFrame](#4.4 RDD转换DataFrame)
-
- [4.4.1 反射机制推断Schema](#4.4.1 反射机制推断Schema)
- [4.4.2 编程方式定义Schema](#4.4.2 编程方式定义Schema)

每日一句正能量
一个人若想拥有聪明才智,便需要不断地学习积累。
第4章 Spark SQL结构化数据文件处理
章节概要
在很多情况下,开发工程师并不了解Scala语言,也不了解Spark常用API,但又非常想要使用Spark框架提供的强大的数据分析能力。Spark的开发工程师们考虑到了这个问题,利用SQL语言的语法简洁、学习门槛低以及在编程语言普及程度和流行程度高等诸多优势,从而开发了Spark SQL模块,通过Spark SQL,开发人员能够通过使用SQL语句,实现对结构化数据的处理。本章将针对Spark SQL的基本原理、使用方式进行详细讲解。
4.4 RDD转换DataFrame
- Spark官方提供了两种方法实现从RDD转换得到DataFrame。
- 第一种方法是利用反射机制来推断包含特定类型对象的Schema,这种方式适用于对已知数据结构的RDD转换
- 第二种方法通过编程接口构造一个Schema,并将其应用在已知的RDD数据中。
4.4.1 反射机制推断Schema
Windows系统开发Scala代码,可使用本地环境测试(需要先准备本地数据文件)。我们可以很容易的分析出当前数据文件中字段的信息,但计算机无法直观感受字段的实际含义,因此需要通过反射机制来推断包含特定类型对象的Schema信息,实现将RDD转换成DataFrame。
在Windows系统下开发Scala代码,可以使用本地环境测试,因此我们首先需要在本地磁盘准备文本数据文件,这里将HDFS中的/spark/person.txt文件下载到本地D:/spark/person.txt路径下。我们需要通过反射机制来推断包含特定类型对象的Schema信息。
接下来我们打开IDEA开发工具,创建名为""spark_chapter04""的Maven工程,讲解实现反射机制推断Schema的开发流程。
具体步骤
1.创建Maven工程。
打开IDEA开发工具,创建名为"spark_chapter04"的Maven工程。
2.添加依赖。在pom.xml文件中添加Spark SQL依赖。,代码片段如下所示。
xml
<dependency>
<groupId>org.apache.spark</groupId>
<artifactId>spark-sql_2.11</artifactId>
<version>2.3.2</version>
</dependency>
3.定义case class样例类、字段和属性,样例类的参数名会被利用反射机制作为列名。通过sc对象读取文件生成一个RDD,将RDD 与样例类匹配,调用toDF()方法将RDD转换为DataFrame。代码如下所示
scala
package cn.itcast.sql

import org.apache.spark.SparkContext
import org.apache.spark.rdd.RDD
import org.apache.spark.sql.{DataFrame, Row, SparkSession}

case class Person(id:Int,name:String,age:Int)
object CaseClassSchema {
    def main(args: Array[String]): Unit = {
        //1.构建SparkSession
        val spark : SparkSession = SparkSession.builder()
                .appName("CaseClassSchema")
                .master("local[2]")
                .getOrCreate();
        //2.获取SparkContext
        val sc : SparkContext =spark.sparkContext;
        //设置日志打印级别
        sc.setLogLevel("WARN")
        //3.读取文件
        val data: RDD[Array[String]] =
  sc.textFile("D://spark//person.txt").map(x=>x.split(" "));
        //4.将RDD与样例类关联
        val personRdd: RDD[Person] = data.map(x=>Person(x(0).toInt,x(1),x(2).toInt))
        //5.获取DF
        //手动导入隐式转换
        import spark.implicits._
        val personDF: DataFrame = personRdd.toDF
        //------------DSL语法操作开始-------------
        //1、显示DataFrame的数据,默认显示20行
        personDF.show()
        //2、显示DataFrame的schema信息
        personDF.printSchema()
        //3、显示DataFrame记录数
        println(personDF.count())
        //4、显示DataFrame的所有字段
        personDF.columns.foreach(println)
        //5、取出DataFrame的第一行记录
        println(personDF.head())
        //6、显示DataFrame中name字段的所有值
        personDF.select("name").show()
        //7、过滤出DataFrame中年龄大于30的记录
        personDF.filter($"age" > 30).show()
        //8、统计DataFrame中年龄大于30的人数
        println(personDF.filter($"age">30).count())
        //9、统计DataFrame中按照年龄进行分组,求每个组的人数
        personDF.groupBy("age").count().show()
        //-----------DSL语法操作结束-------------
        //-----------SQL操作风格开始-------------
        //将DataFrame注册成表
        personDF.createOrReplaceTempView("t_person")
        //传入sql语句,进行操作
        spark.sql("select * from t_person").show()
        spark.sql("select * from t_person where name='zhangsan'").show()
        spark.sql("select * from t_person order by age desc").show()
        //-----------SQL操作风格结束-------------
        //关闭操作
        sc.stop()
        spark.stop()
    }
}
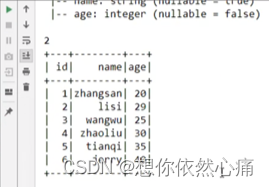
运行结果如下图所示
4.4.2 编程方式定义Schema
当Case类不能提前定义的时候,就需要采用编程方式定义Schema信息,实现RDD转换DataFrame的功能主要包含3个步骤,具体如下:
1.创建一个Row对象结构的RDD;
2.基于StructType类型创建Schema;
3.通过SparkSession提供的createDataFrame()方法来拼接Schema。
根据上述步骤,创建SparkSqISchema.scala文件,使用编程方式定义Schema信息的具体代码如下所示。
scala
package cn.itcast.sql
import org.apache.spark.SparkContext
import org.apache.spark.rdd.RDD
import org.apache.spark.sql.types.{IntegerType, StringType, StructField, StructType}
import org.apache.spark.sql.{DataFrame, Row, SparkSession}
object SparkSqlSchema {
    def main(args: Array[String]): Unit = {
        //1.创建SparkSession
        val spark: SparkSession = SparkSession.builder()
                .appName("SparkSqlSchema")
                .master("local[2]")
                .getOrCreate()
        //2.获取sparkContext对象
        val sc: SparkContext = spark.sparkContext
        //设置日志打印级别
        sc.setLogLevel("WARN")
        //3.加载数据
        val dataRDD: RDD[String] = sc.textFile("D://spark//person.txt")
        //4.切分每一行
        val dataArrayRDD: RDD[Array[String]] = dataRDD.map(_.split(" "))
        //5.加载数据到Row对象中
        val personRDD: RDD[Row] = dataArrayRDD.map(x=>Row(x(0).toInt,x(1),x(2).toInt))
        //6.创建Schema
        val schema:StructType= StructType(Seq(
            StructField("id", IntegerType, false),
            StructField("name", StringType, false),
            StructField("age", IntegerType, false)
        ))
        //7.利用personRDD与Schema创建DataFrame
        val personDF: DataFrame = spark.createDataFrame(personRDD,schema)
        //8.DSL操作显示DataFrame的数据结果
        personDF.show()
        //9.将DataFrame注册成表
        personDF.createOrReplaceTempView("t_person")
        //10.sql语句操作
        spark.sql("select * from t_person").show()
        //11.关闭资源
        sc.stop()
        spark.stop()
    }
}转载自:https://blog.csdn.net/u014727709/article/details/136033354
欢迎 👍点赞✍评论⭐收藏,欢迎指正