深度学习基本原理:梯度下降公式,将损失函数越来越小,最终预测值和实际值误差比较小。
交叉熵:-p(x)logq(x),p(x)是one-hot形式。如果不使用softmax计算交叉熵,是不行的。损失函数可能会非常大,或者预测的概率是-0.1,0.3,0.5,log不接收负值。pytorch默认给你加softmax。
如果softmax改成sigmoid也不行,如sigmoid过完以后,0.9,0.99,0.99,计算以后0.99的影响会被忽略,得到的结果是不正确。
adam和sgd区别:adam会考虑之前的计算,自动调节学习率,在通过梯度平方控制学习率的调节,让训练可以比较平稳又可以加速。
transformer和rnn区别:长距离依赖问题,rnn越远影响越弱。
调参经验:batch_size,max_length,学习率增大batch_size应该怎么调整,加数据量,打乱数据顺序。
训练词向量:将one-hot乘以一个矩阵进行训练,cbow,skip-gram,共现矩阵,keans聚类。
语言模型:PPL评价语言模型,不能成句也可能PPL比较低,所以PPL评价不太好。
传统方法和预训练方法:
Transformer里的dk是hidden_size/ head_num,是实验结果。
数据稀疏问题:标注更多数据,大模型生成更多数据,换模型,调整阈值,召回率换准确率。重新定义类别,减少类别,增加规则弥补。
文本匹配:表示型,直接计算,交互型,速度慢,更准确。文本向量化:文本和句子分别过一个模型,优化模型,使文本和句子相似,如果是句子和句子可以用相同模型,最后得到的参数作为向量数据库。表示型:一个句子直接向量化,交互型:必须进入两个句子算得分。
向量数据库查找:KD树。
序列标注:crf会用维特比解码,bean search在大模型里使用,n * D *B,复杂度小很多
ner:加标点任务。
序列标注重复:多个模型,生成式任务,输出两个标记。
自回归语言模型:下三角mask,预测下一个词。
teacher-forcing,使用真实标签预测,提高效率。
采样策略:topk,topp,bean-size,temperature(大模型)。
bert变体:albert减少参数,roberta(动态mask,去掉nsp任务)
stf用于大模型问答,相当于encoder-decoder,bert是encoder,通过mask可以实现decoder自回归语言模型(文本生成)。
旋转位置编码:解决词嵌入位置编码长度外推性,找到映射f,满足
< f_q(x_m,m), f_k(x_n,n)> = g(x_m, x_n, m - n)。初始条件m = 0, f(q,0) = q。
https://zhuanlan.zhihu.com/p/580739696
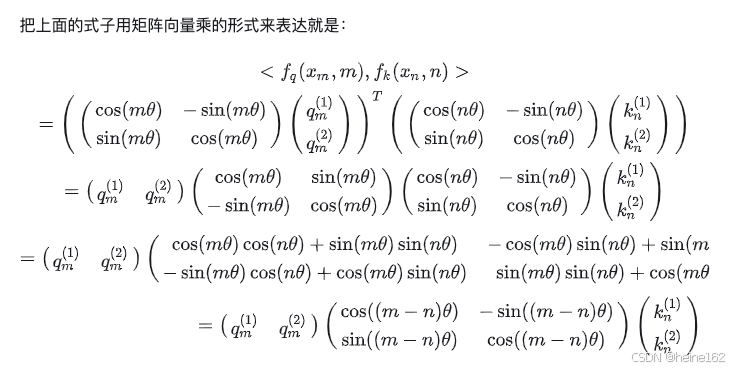
qm(1),qm(2)是原来的Wq和xm相乘的局部结果,即xm.dot(Wq)
余弦值位置编码中:固定i,则pos的改变会使位置编码有周期性,固定pos修改i,则一开始周期较小,容易捕捉相邻字的差别,随着i变大,周期越来越长
moe专家模型(一个MLP层就是一个专家),deepseek使用共享专家。deepseek在qkv计算的过程中,q和k拆成两部分,其中一部分注入rope位置信息,另一部分不处理。减少运算量。
bbpe:解决多语种,不用统计词,既不是中文词表也不是英文词表,具有跨语种的优点。bpe是基于字符,bbpe是转化为unicode编码,然后合并,是基于字节的。
知识图谱:方法一是基于模板+文本匹配,类似于faq库问答,相似度可以用bm25,jaccard距离,或者余弦距离。方法二:拆解成多个分类或抽取问题处理。方法三:利用大语言LLM的生成能力
推荐系统:基于相似用户、相似物品的推荐。