1 马尔可夫决策过程
马尔可夫决策过程(Markov Decision Process, MDP)是一种数学框架,用于建模智能体(agent)在随机环境中做决策的问题。它假设环境的状态转换具有马尔可夫性质,即未来的状态只依赖于当前状态和智能体采取的动作,而与过去的历史无关。MDP 是强化学习(Reinforcement Learning, RL)的基础模型,许多强化学习算法和理论都建立在 MDP 之上。
2 部分可观测马尔可夫决策过程
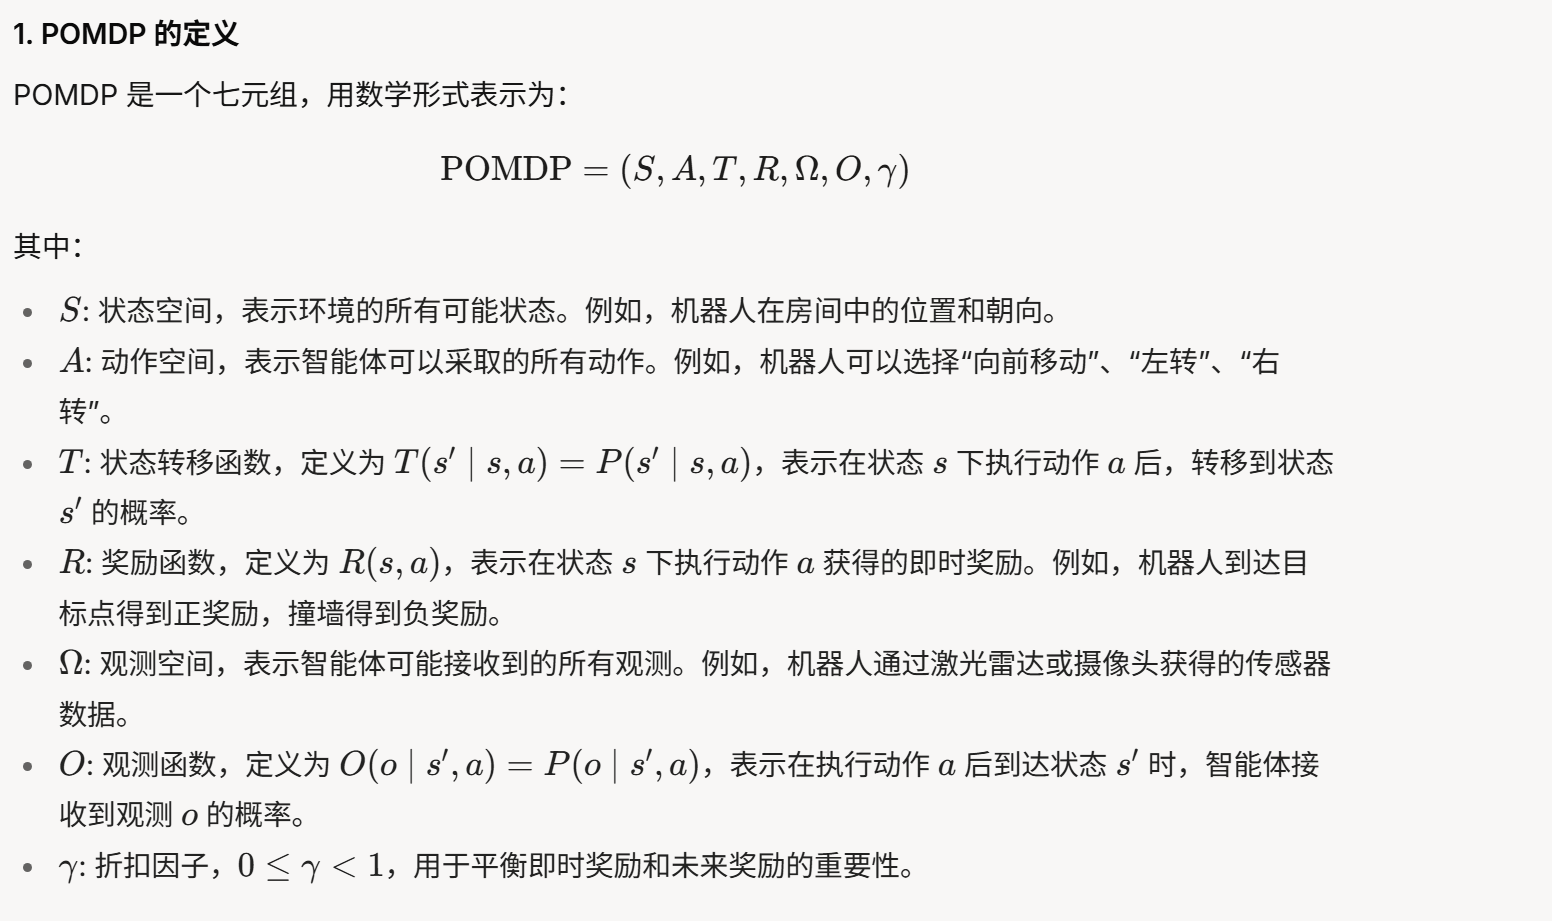
(Partially Observable Markov Decision Process, POMDP)
在单智能体的强化学习中,如果环境的状态不能完全被智能体观测到(例如,机器人传感器有噪声或视野受限),问题就被建模为 POMDP。POMDP 假设环境的动态满足马尔可夫性质(即下一状态仅依赖于当前状态和动作),但智能体只能通过部分观测(observation)间接推测状态。
3 Dec-POMDP(去中心化部分可观测马尔可夫决策过程)
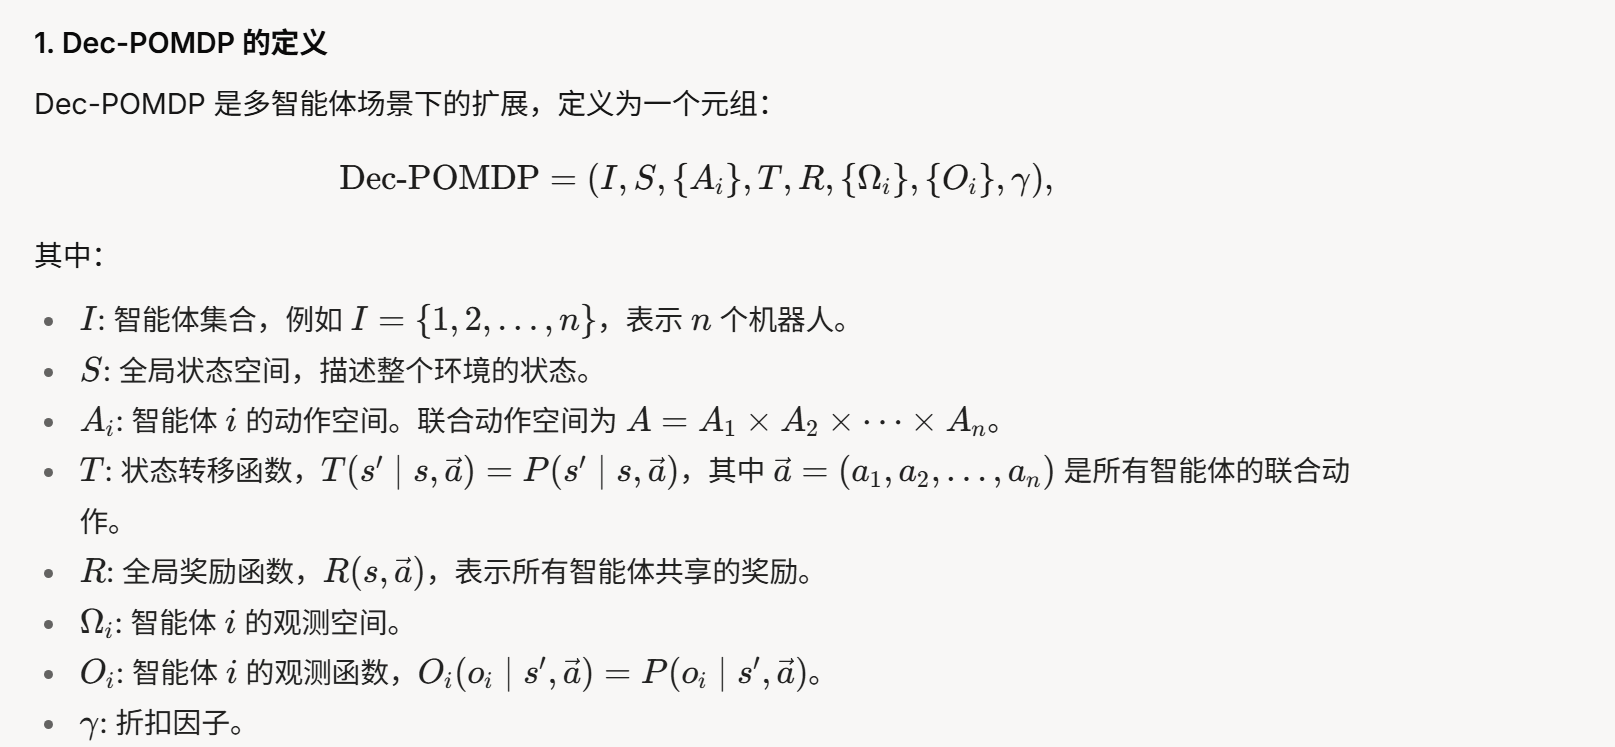
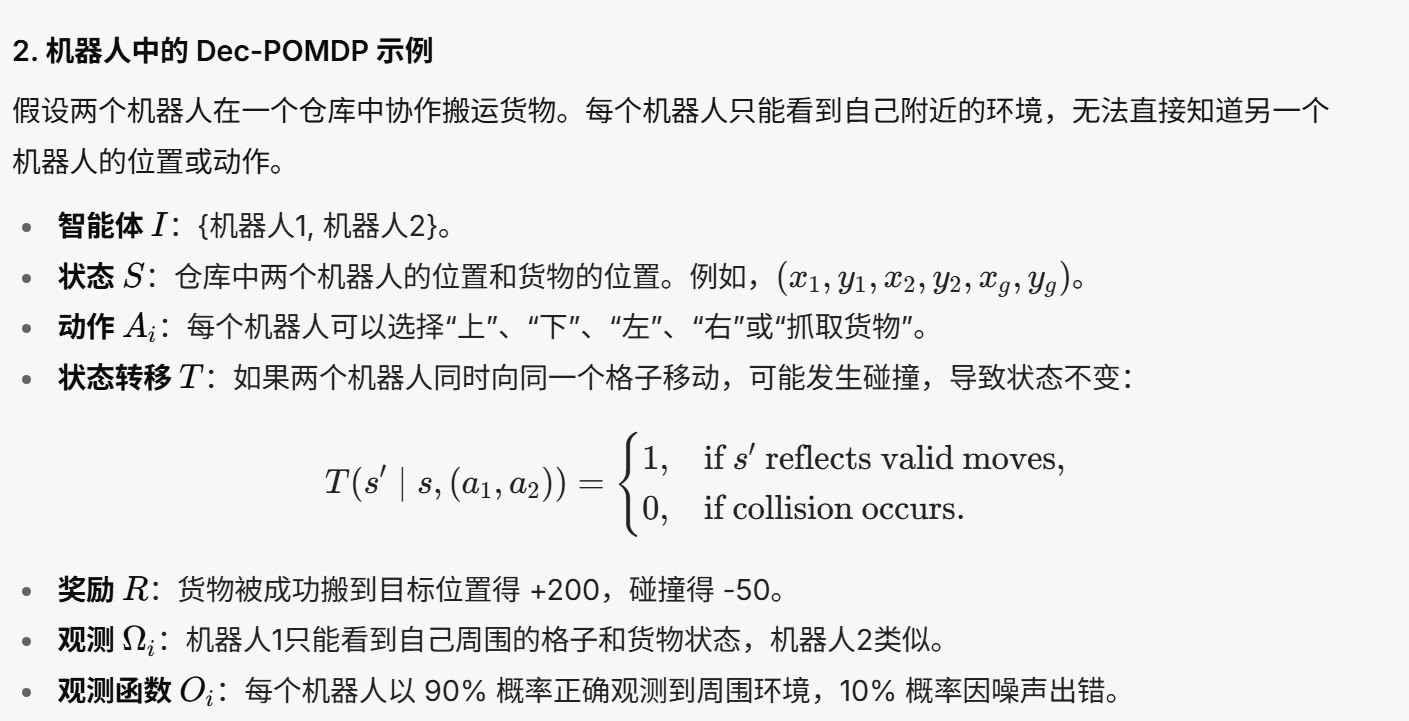
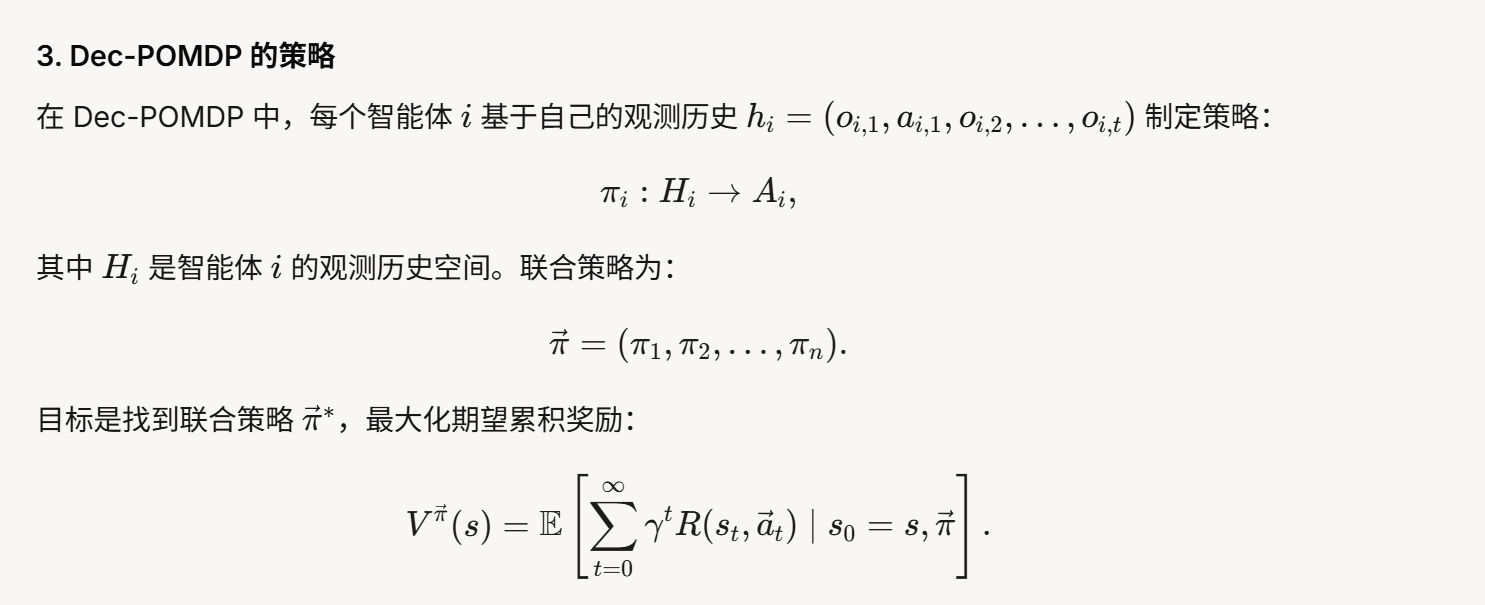
在多智能体场景中,例如多个机器人协作完成任务,每个智能体都有自己的观测和动作,无法直接知道其他智能体的状态或动作。这种情况被建模为 Dec-POMDP。Dec-POMDP 扩展了 POMDP,考虑多个智能体在去中心化(无中央控制器)的情况下如何协作或竞争。