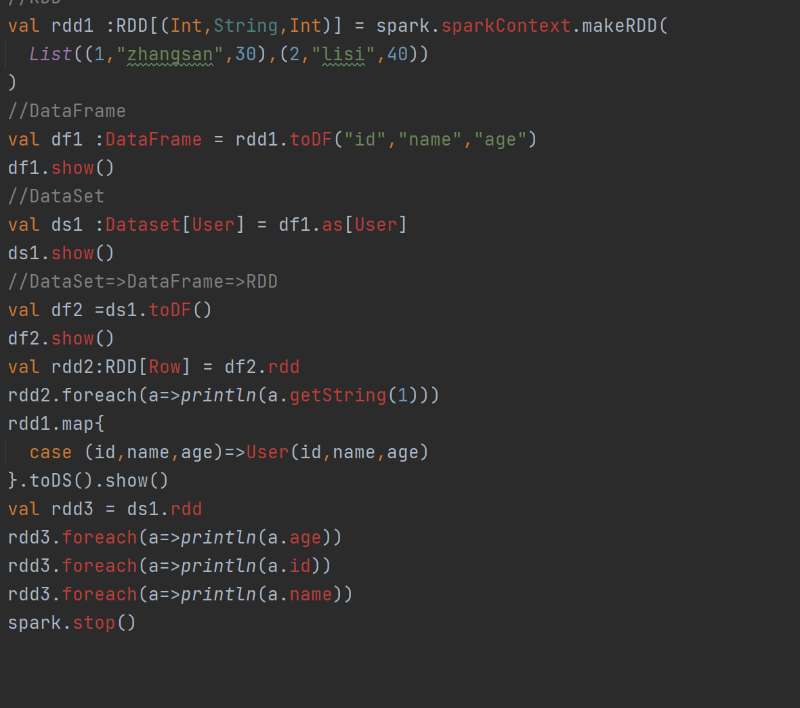
Spark-SQL核心编程语言

利用IDEA开发spark-SQL

创建spark-SQL测试代码
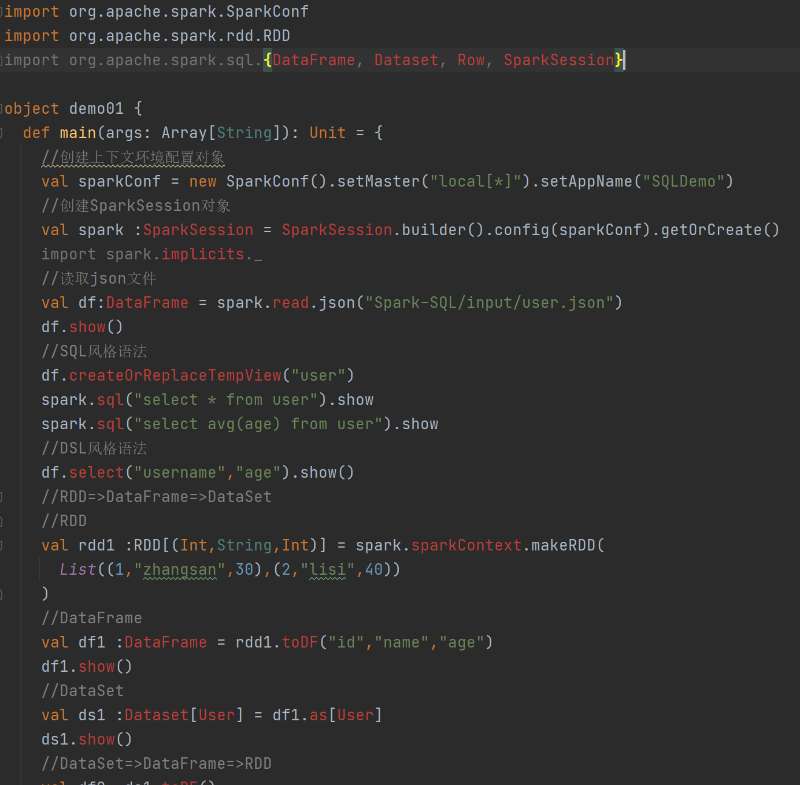
自定义函数UDF
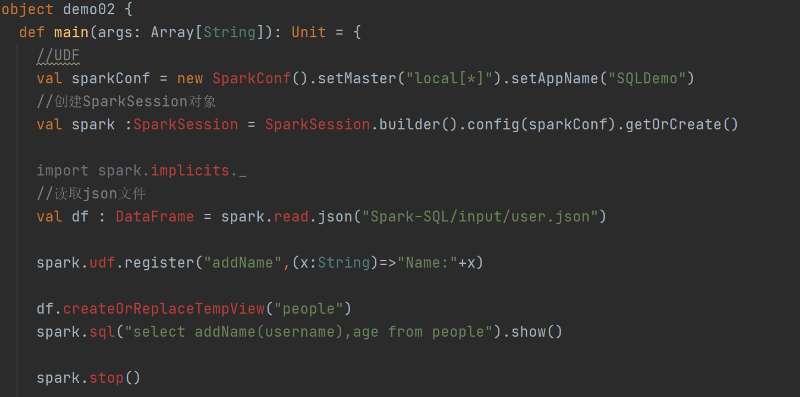
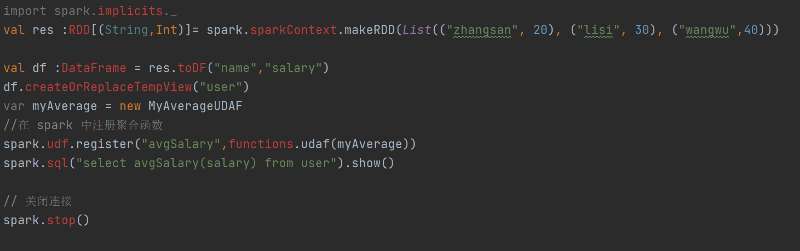
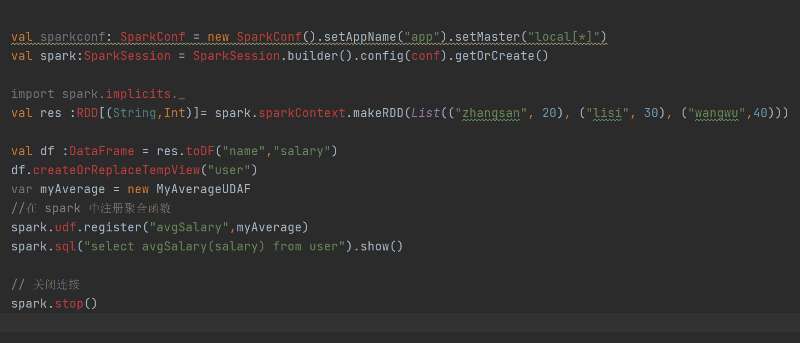
自定义聚合函数UDAF

强类型的 Dataset 和弱类型的 DataFrame 都提供了相关的聚合函数, 如 count(),

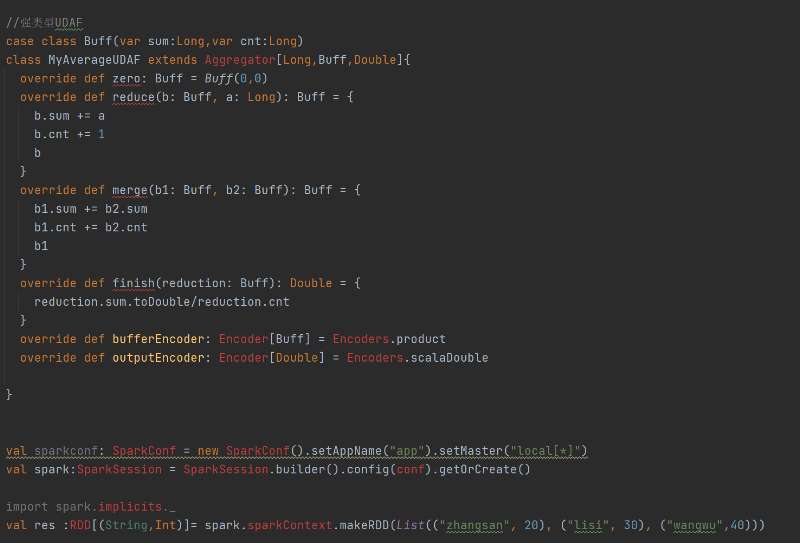
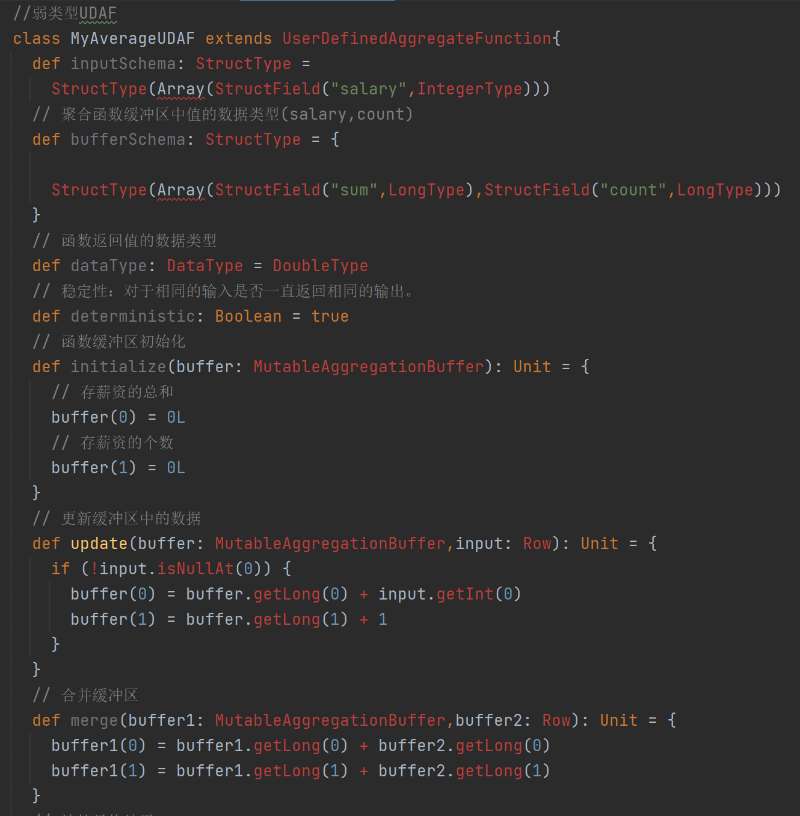
countDistinct(),avg(),max(),min()。除此之外,用户可以设定自己的自定义聚合函数。Spark3.0之前我们使用的是UserDefinedAggregateFunction作为自定义聚合函数,从 Spark3.0 版本后可以统一采用强类型聚合函数 Aggregator

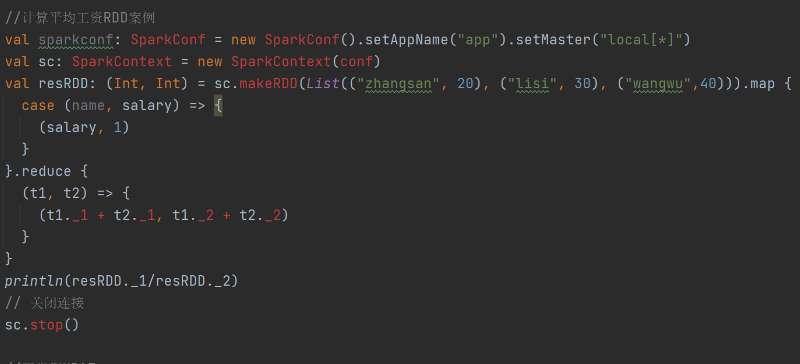
案例:计算平均工资

实现方式一:RDD
实现方式二:强类型UDAF
实现方式三:弱类型UDAF
相关推荐
freejackman2 天前
【架构篇】双遍历 + 多栈协同:手撸 SQL 血缘引擎的架构思考
java·大数据·数据库·hive·sql·架构·spark
陈年老古董2 天前
Spark 3.1.3 集群搭建 + Spark-SQL 整合 Hive 记录
hive·sql·spark
乌恩大侠3 天前
「AI-RAN」Aerial,使用ORAN C1模式
人工智能·5g·spark·o-ru·ai-ran
测试盐3 天前
spark作业日志定位过程
java·hadoop·spark
IT研究室3 天前
最新大数据毕业设计选题推荐-基于大数据的Kaggle竞赛团队协作模式与效能可视化分析-大数据-Spark-Hadoop-Bigdata
大数据·spark·课程设计
棣廷5 天前
初识Spark Core
大数据·分布式·spark
磁场转动100万匹8 天前
Spark Core 核心原理:从 RDD 到分布式计算
大数据·分布式·spark
ha_lydms10 天前
AnalyticDB MySQL 技术架构
大数据·hadoop·mysql·adb·spark·dataworks·1024程序员节
红海云10 天前
两台DGX Spark部署DeepSeek的实战边界
大数据·分布式·spark