数据加载与保存
通用方式:
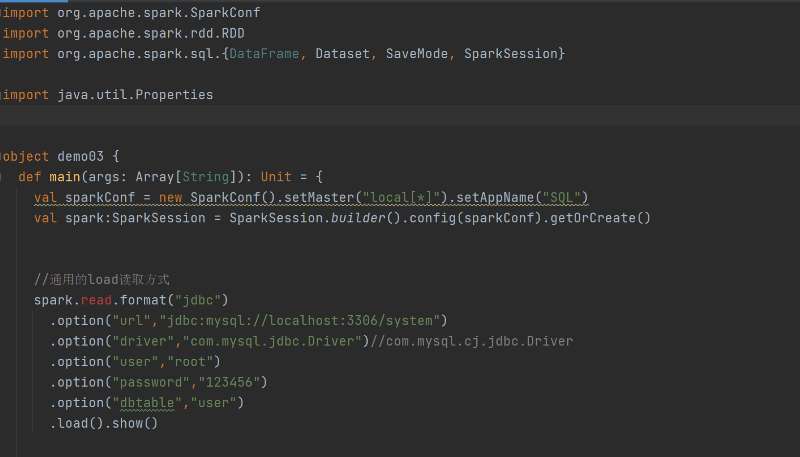
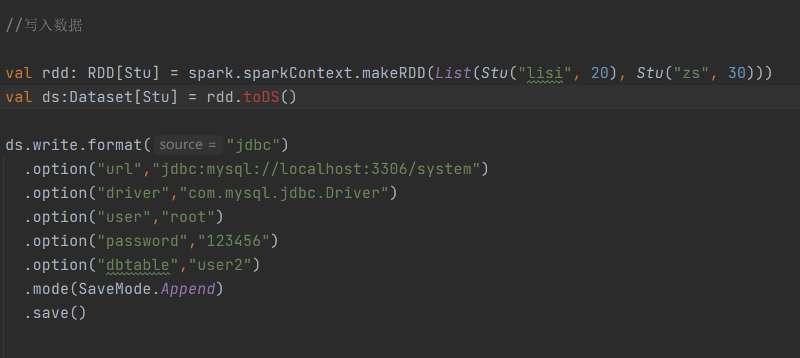
通过 spark.read.load 和 df.write.save 实现数据加载与保存。可利用 format 指定数据格式,如 csv 、 jdbc 等; option 用于设置特定参数,像 jdbc 格式下的数据库连接信息; load 和 save 则分别指定数据路径。保存时还能使用 SaveMode 包含 ErrorIfExists 、 Append 、 Overwrite 、 Ignore 等模式 。
Parquet:
作为默认数据源,Parquet是列式存储格式,适合存储嵌套数据。加载和保存数据时,若为Parquet文件,无需指定 format ,按默认方式操作即可。
JSON:
Spark SQL可自动推测JSON数据集结构,加载为 DatasetRow 。但要求JSON文件每行是一个JSON串,通过 spark.read.json() 加载 。
CSV:
读取CSV文件时,可配置列表信息,如设置分隔符、推断数据类型、指定表头,使用 format("csv") 结合 option 设置相关参数。
- MySQL:
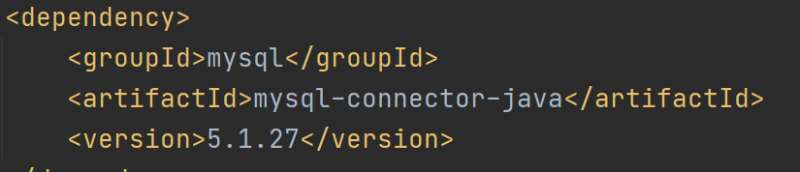
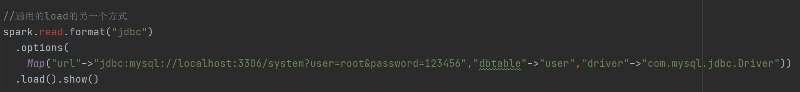
借助JDBC,Spark SQL能从MySQL读取数据创建 DataFrame ,计算后也可写回。操作前需导入 mysql-connector-java 依赖,按特定语法编写代码实现数据读写。
代码案例
导入依赖
Spark-SQL连接Hive
内嵌Hive:
使用Spark内嵌Hive无需额外配置,可直接使用,但实际生产中较少采用。
外部Hive:
在spark-shell中连接外部Hive,需将 hive-site.xml 拷贝到 conf/ 目录并修改连接地址,把MySQL驱动复制到 jars/ 目录,拷贝 core-site.xml 和 hdfs-site.xml 到 conf/ 目录,最后重启 spark-shell 。- Spark beeline:Spark Thrift Server兼容HiveServer2,部署后可用beeline访问。连接步骤与连接外部Hive类似,需配置相关文件并启动Thrift Server,再用 beeline -u jdbc:hive2://node01:10000 -n root 连接 。- Spark-SQL CLI:在Spark目录下,将MySQL驱动放入 jars/ , hive-site.xml 放入 conf/ ,运行 bin/ 目录下的 spark-sql.cmd 即可启动,能直接执行SQL语句。
代码操作Hive:
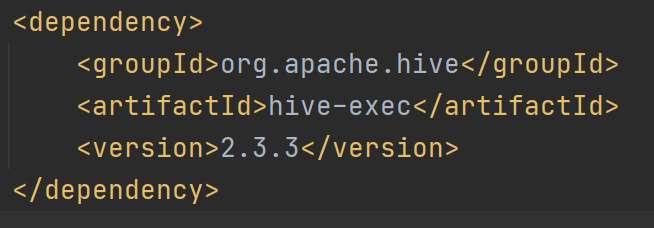
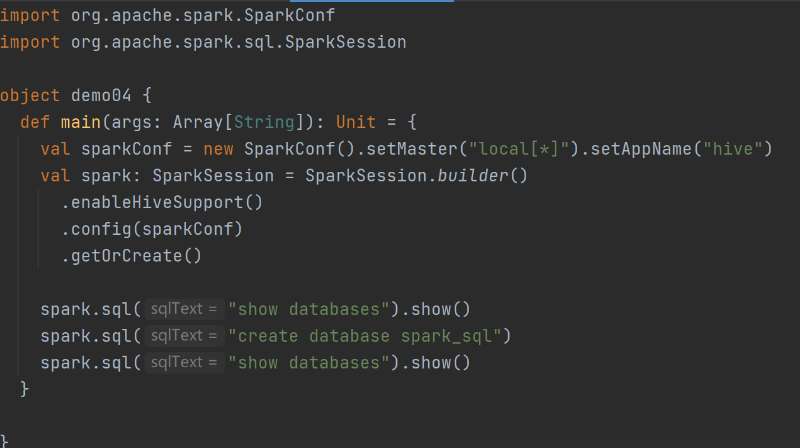
先导入 spark-hive_2.12 和 hive-exec依赖,将hive-site.xml拷贝到resources目录中,在代码中启用hive支持
代码案例
导入依赖