技术栈
Spark-SQL 四(实验)
Gvemis⁹
2025-04-22 17:34
用idea实验hive的常用代码
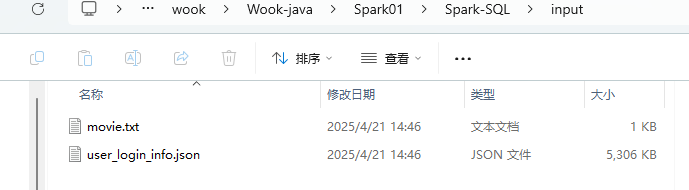
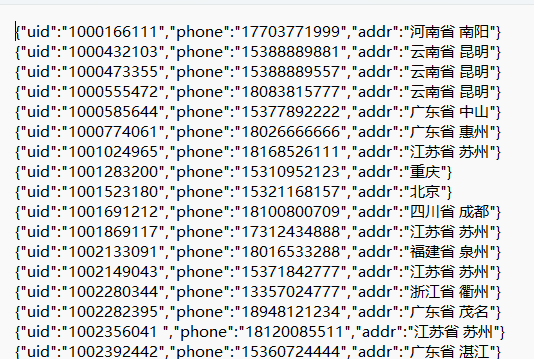
将数据放到项目·的目录下
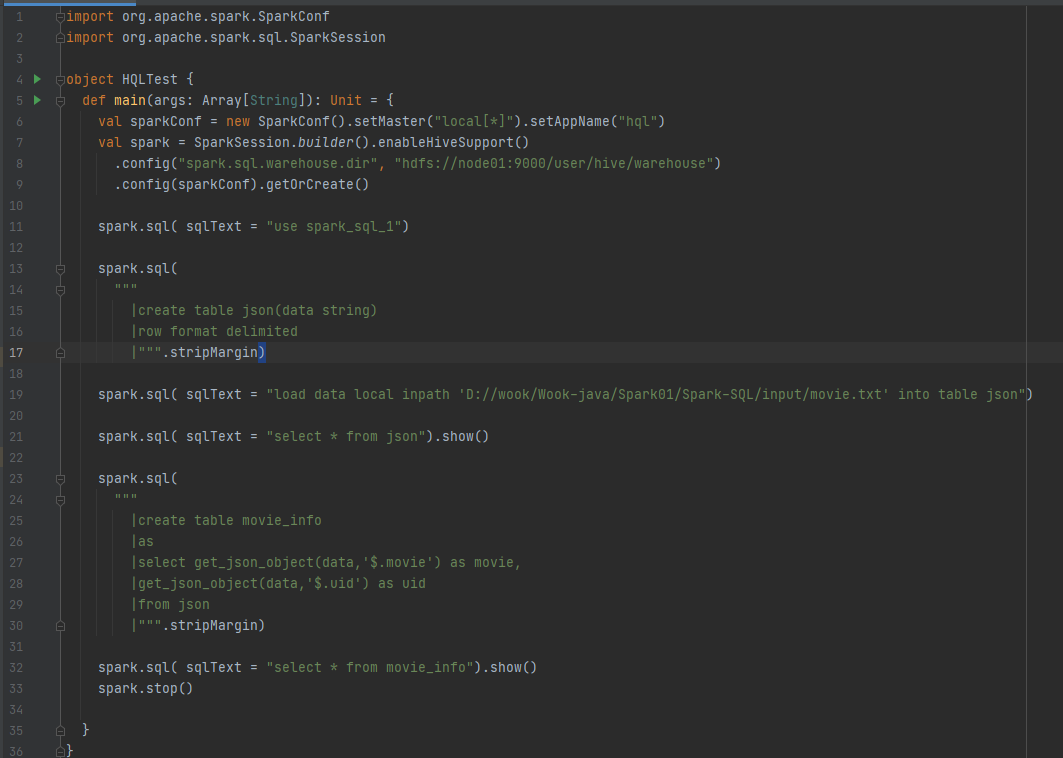
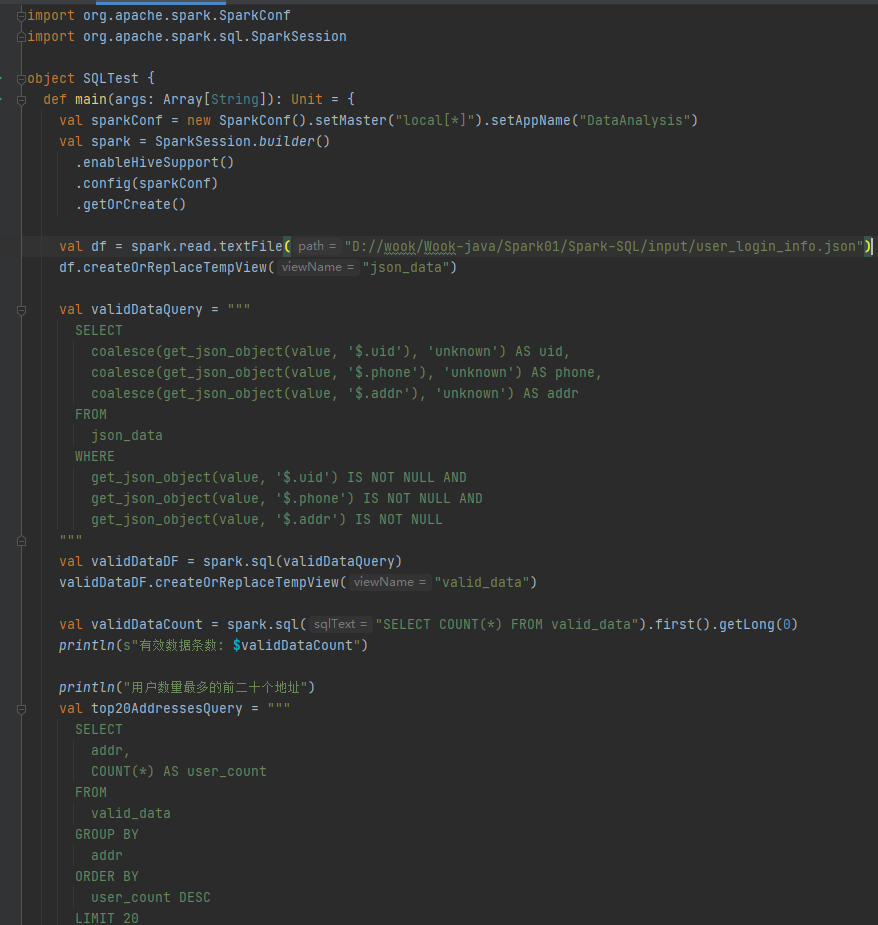
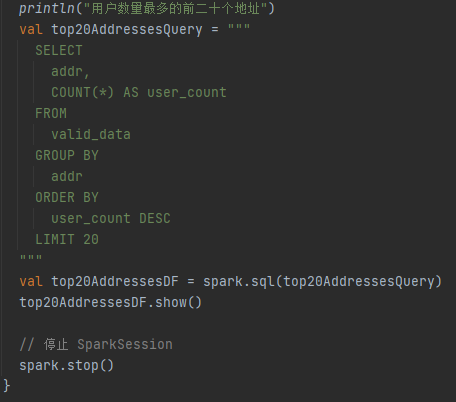
代码实现
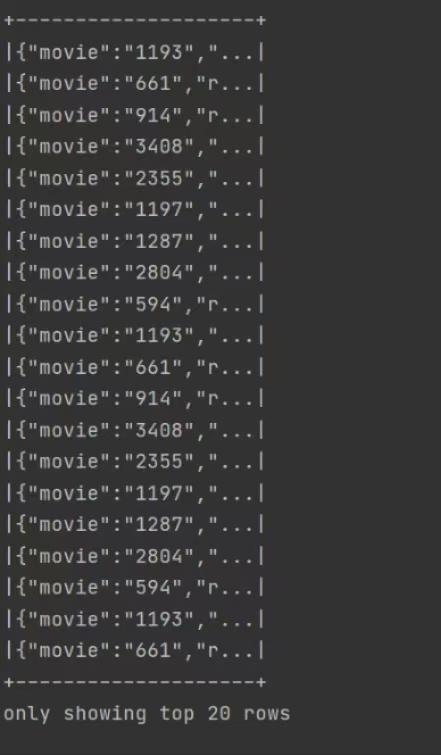
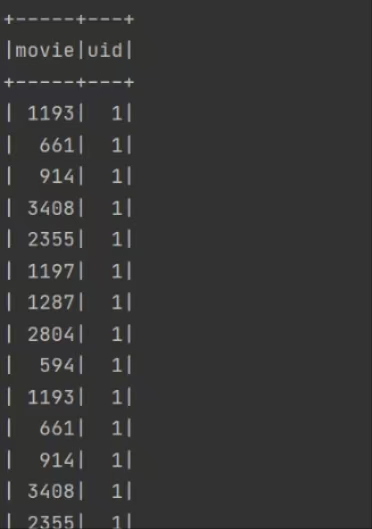
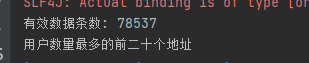
运行结果:
实验
统计
有效数据条数
及
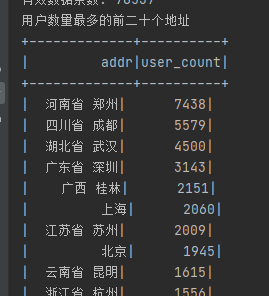
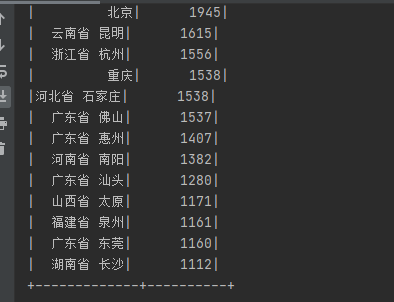
用户数量最多的前二十个地址
将数据放到Spark-SQL/input目录下
代码实现:
运行结果:
大数据
分布式
spark
上一篇:
Redis客户端连不上?可以通过以下方法排查,亲测可用!
下一篇:
Spark SQL概述(专业解释+生活化比喻)
相关推荐
阿里云大数据AI技术
1 小时前
EMR Serverless Ray:让 AI 推理融入数据处理
人工智能
·
spark
TDengine (老段)
1 小时前
TDengine IDMP 十大实用功能(9)
大数据
·
数据库
·
人工智能
·
物联网
·
时序数据库
·
tdengine
·
idmp
播播资源
2 小时前
同账户实测 11 个多模态模型:图像 0.03 元起、竖屏视频 8 元一条,最贵和最便宜差 267 倍
大数据
·
人工智能
·
深度学习
全栈陈序员
4 小时前
Git】从入门到精通(八)—— git log:查看提交历史
大数据
·
git
·
elasticsearch
演艺大赏
5 小时前
NiFi 从 3 台扩到 25 台:三轮扩容后我才明白,证书必须全量重签、安装包绝对不能拷
大数据
做科研的周师兄
5 小时前
【R语言实战】MixSIAR 氢氧同位素水源解析全流程:从混合空间校验到贝叶斯 MCMC 收敛诊断(后附完整代码)
java
·
大数据
·
开发语言
方方洛
5 小时前
ray教程-25-附录E-端到端实战案例
人工智能
·
分布式
·
机器学习
isfox
7 小时前
MapReduce 数据清洗:脏数据进来,干净数据出去,连 Reduce 都省了
大数据
Francek Chen
8 小时前
【大数据处理与分析】数据仓库Hive:09 Hive 编程实践
大数据
·
数据仓库
·
hive
·
hadoop
·
sql
其实防守也摸鱼
21 小时前
个人学习 Pwn 思路:从基础到漏洞利用的进阶路径
大数据
·
前端
·
人工智能
·
chrome
·
算法
·
安全
·
网络安全
热门推荐
01
国内可直接用、免费额度/永久免费的大模型API清单(含 SiliconFlow、火山、阿里、智谱、百度、Kimi、DeepSeek、DMXAPI 等)
02
如何新建文件夹? 电脑新建文件夹的4种方法
03
历年考研数学一、数学二、数学三真题试卷及答案PDF
04
几个好用的ip纯净度检测网站
05
GitHub 镜像站点
06
昇腾910B系列芯片完全指南:四款型号对比、服务器选型与大模型部署实战
07
苹果iPA游戏软件资源下载网站
08
蜘蛛磁力 搜索引擎大全,如何使用蜘蛛磁力查找磁力链接
09
Dify:一站式AI应用开发平台全解析与Windows部署指南
10
微信历史版本含下载地址( Windows PC | 安卓 | MAC )及设置微信不更新