Spark-SQL核心编程

  1. Spark-SQL连接Hive概述:Spark SQL编译时可选择包含Hive支持,包含后能支持Hive表访问、UDF、HQL等功能,且无需事先安装Hive,编译时引入Hive支持为佳。

  2. 连接方式

内嵌Hive:使用简单,直接可用,但实际生产中很少使用。

外部Hive:在spark-shell中连接外部Hive,需拷贝hive-site.xml到conf/目录并修改其中的url、将MySQL驱动拷贝到jars/目录、把core-site.xml和hdfs-site.xml拷贝到conf/目录,最后重启spark-shell。

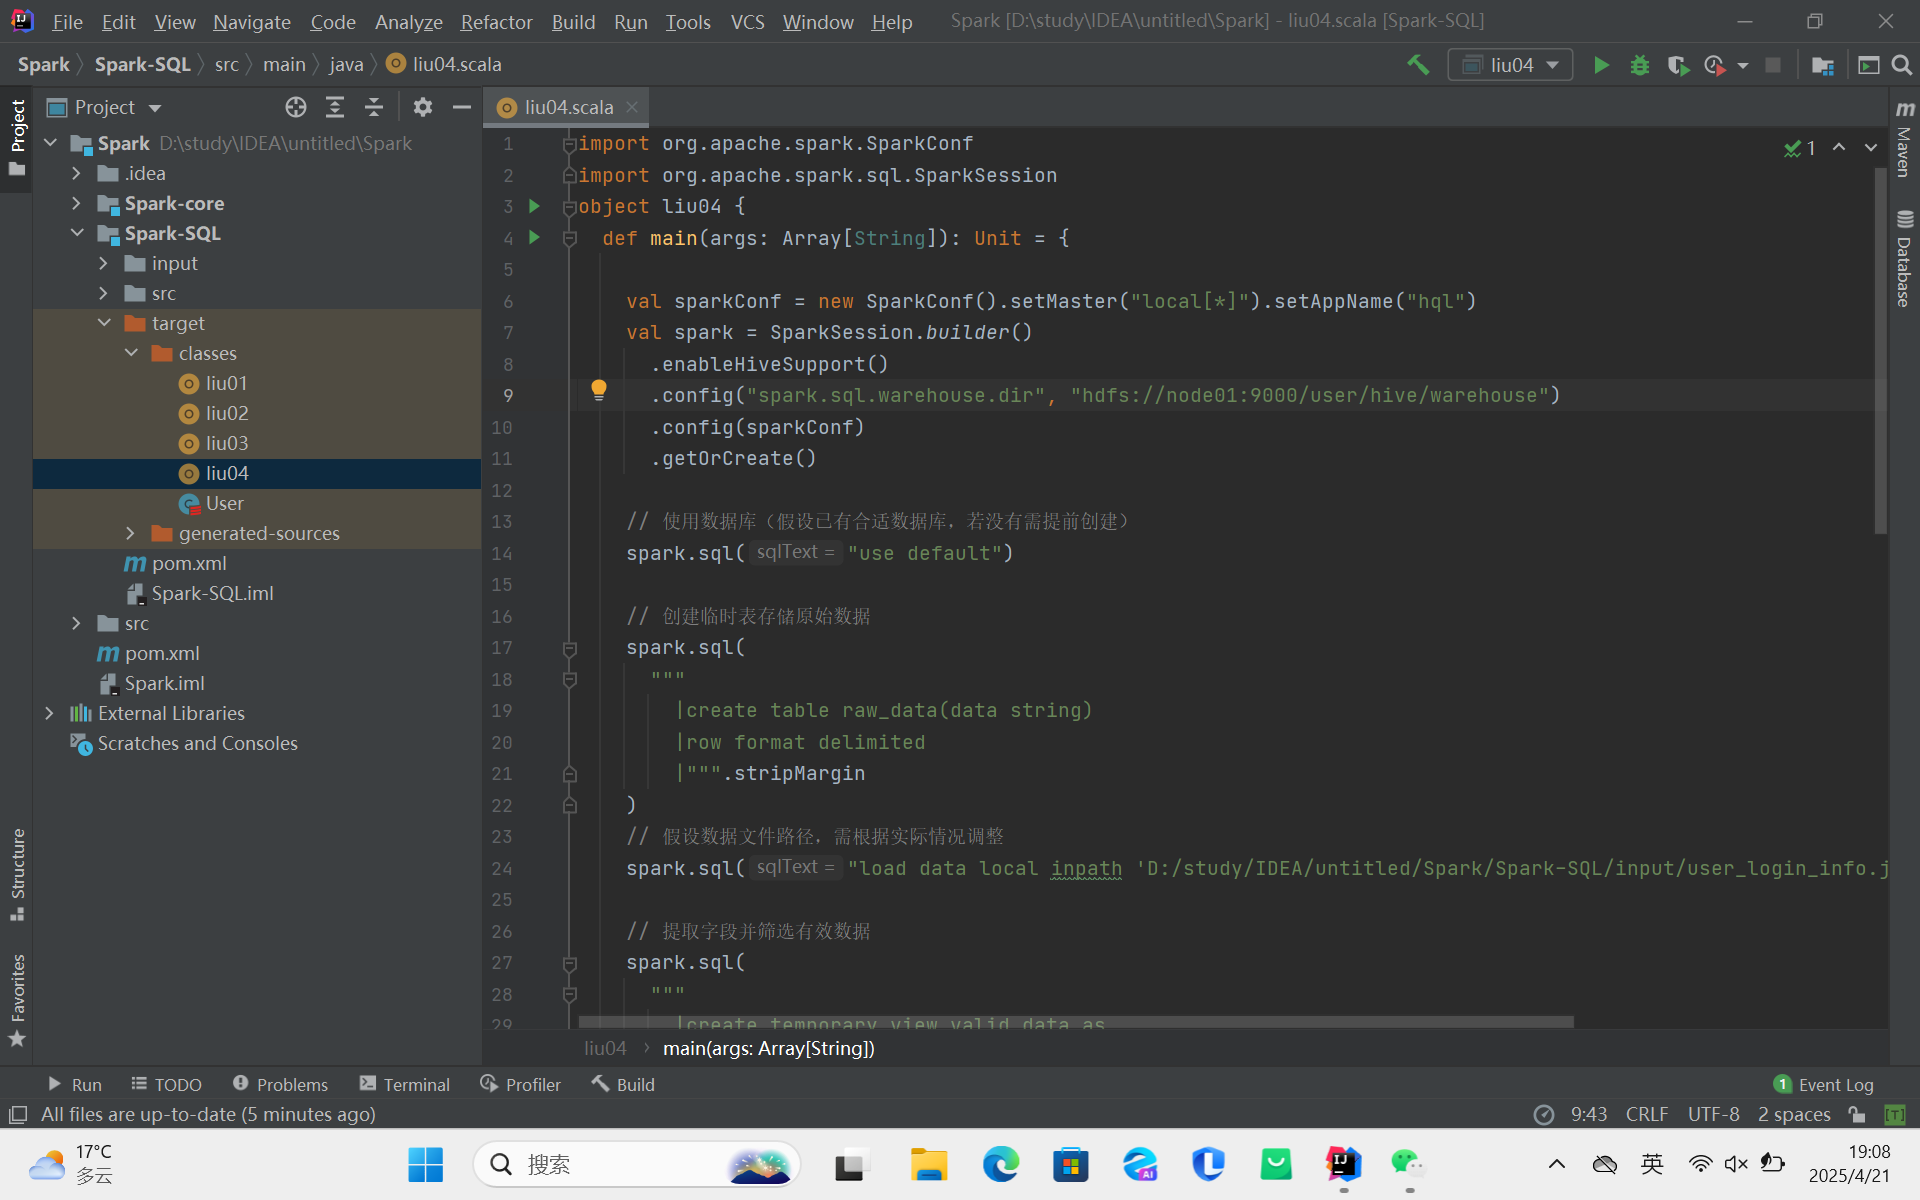
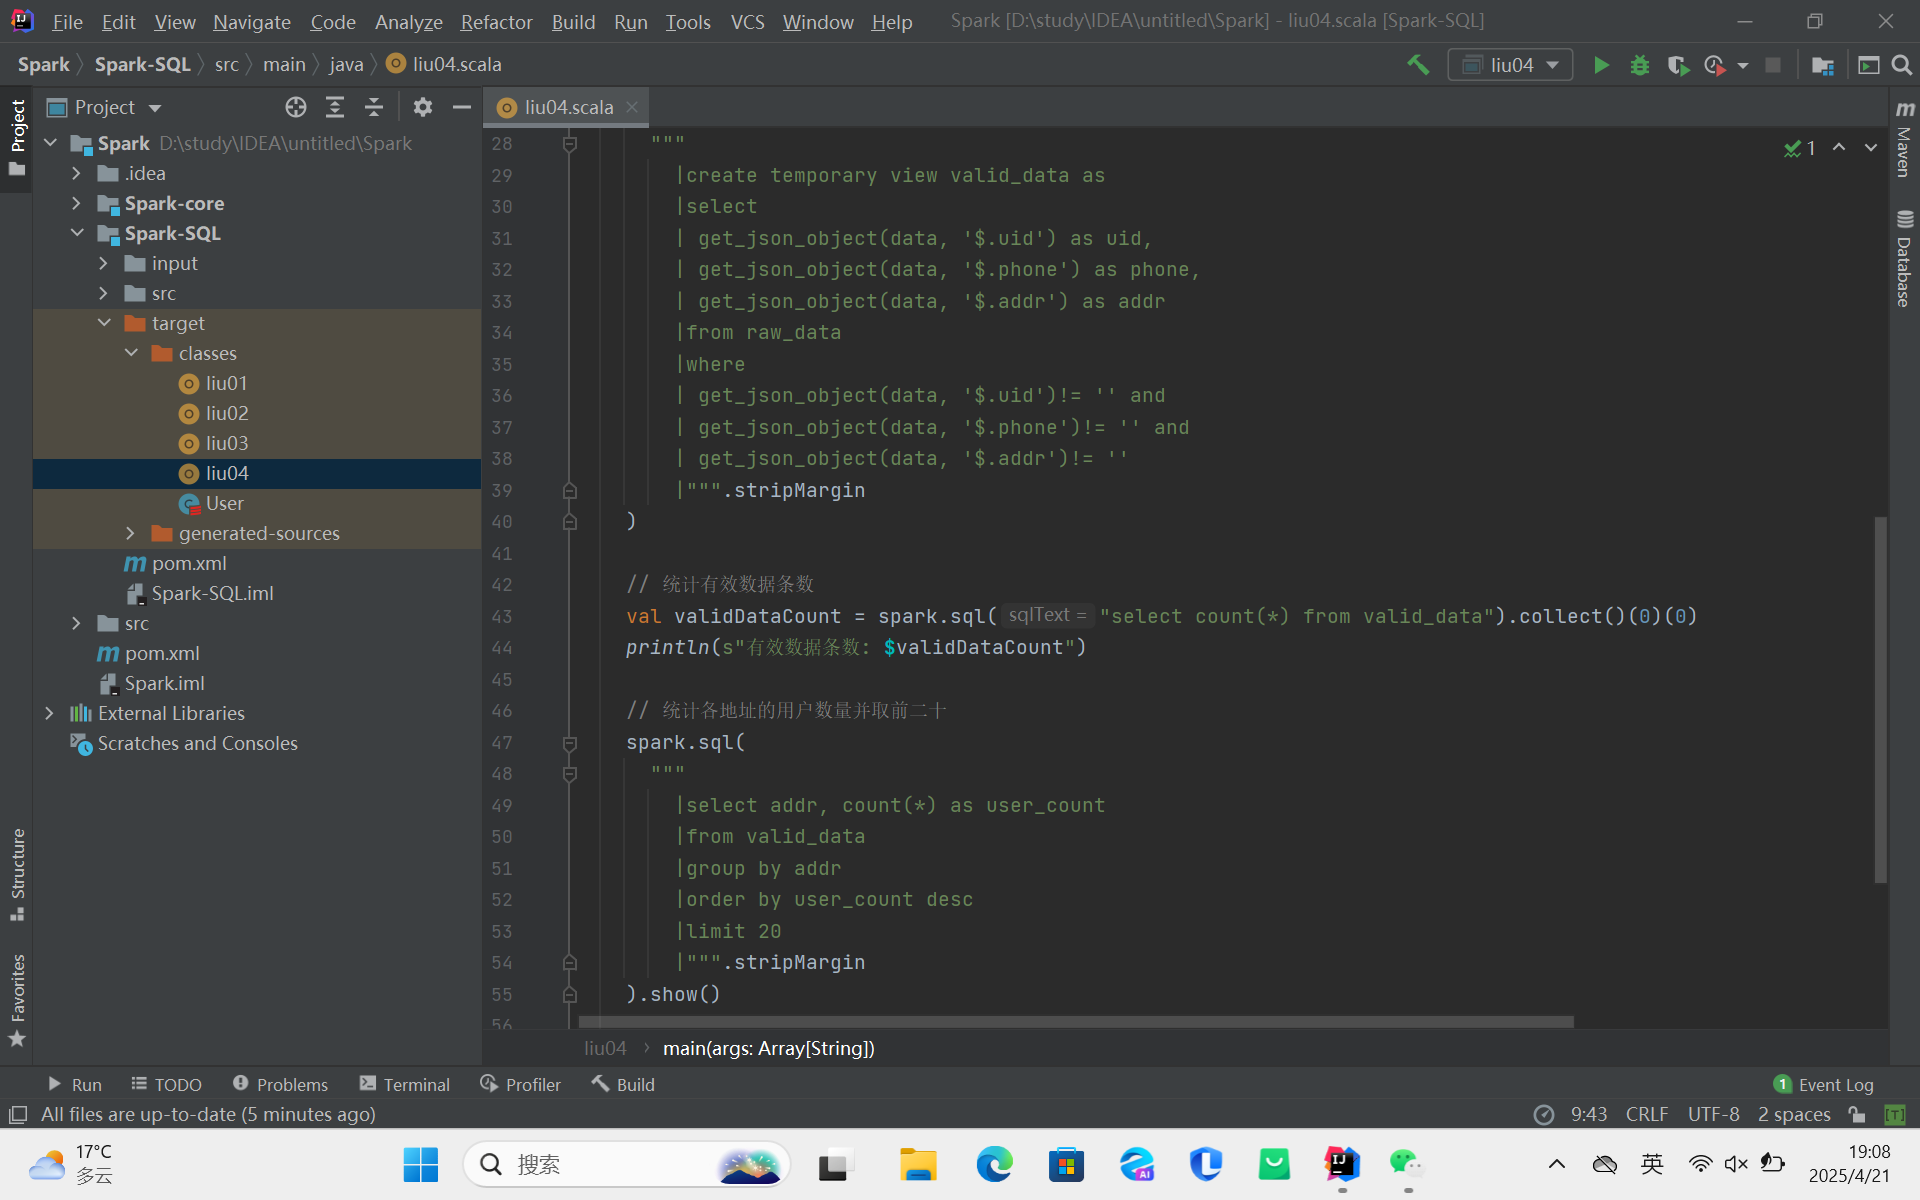
代码操作Hive:先导入spark-hive_2.12和hive-exec依赖;接着把hive-site.xml拷贝到项目resources目录;然后编写代码设置Spark配置、启用Hive支持。若报错,可设置HADOOP_USER_NAME解决;还可通过配置修改数据库仓库地址,解决数据库位置异常问题。
相关推荐
IT研究室42 分钟前
最新大数据毕业设计选题推荐-基于大数据的人工智能社交媒体情绪分析与可视化的设计与实现-大数据-Spark-Hadoop-Bigdata
大数据·人工智能·课程设计
Data-Miner1 小时前
离线AI制表:模型适配与脚本固化实操
大数据·数据库·人工智能·excel
梦想画家1 小时前
SQLMesh 告警实战:只用 YAML 配置和 SQL 模型,搭一套数据管道告警
大数据·数据开发·sqlmesh
段一凡-华北理工大学1 小时前
高炉炼铁机器视觉与智能识别十八讲~系列文章05:炉顶料面识别:装料分布判读与布料制度优化
大数据·人工智能·机器视觉·工业智能化·高炉炼铁智能化·高炉炉顶料面识别
sbjdhjd1 小时前
智能体开始“动手”之后:OpenAI越权事件、Anthropic算力资本化与开放权重模型竞逐 | AI与SI行业日报整理(9月29日—10月6日)
大数据·人工智能·经验分享·笔记·ai·chatgpt·开源
2601_962780912 小时前
数学与应用数学投递供应链计划岗,短板补齐与项目搭建方案
大数据
品牌常新2 小时前
GEO哪家好?2026年服务商选型与能力对比
大数据·人工智能
keke.shengfengpolang2 小时前
2027届数学专业转策略产品助理:从指标拆解到AB实验的知识补齐路径
大数据
ly76892 小时前
Elasticsearch 写入链路的 refresh、flush 与 translog 边界:为什么 bulk 吞吐会突然塌陷
大数据·elasticsearch·搜索引擎·translog·写入链路·bulk调优
python与大数据分析3 小时前
大模型 or Not?智慧农业落地,大小模型各有所长
大数据·人工智能