从0开始配置Spark的local模式
具体步骤:
1.启动虚拟机(开一台即可)
2.通过finalshell连接虚拟机,并将文件上传安装文件到 /opt/software下
3.解压spark安装文件到/opt/module下
tar -zxvf spark-3.3.1-bin-hadoop3.tgz -C /opt/module/
4.重命名,把解压后的文件夹改成spark-local。因为后续我们还会使用其他的配置方式,所以这里先重命名一次。mv是linux的命令,
mv spark-3.3.1-bin-hadoop3 spark-local
5.配置环境变量
① 打开etc/profile.d/my_env.sh文件中,补充设置spark的环境变量。
export SPARK_HOME=/opt/module/spark-local
export PATH=$PATH:$SPARK_HOME/bin:$SPARK_HOME/sbin
② 使用 source 命令让环境变量生效
root@hadoop100 module# cd /etc/profile.d
root@hadoop100 profile.d# source my_env.sh
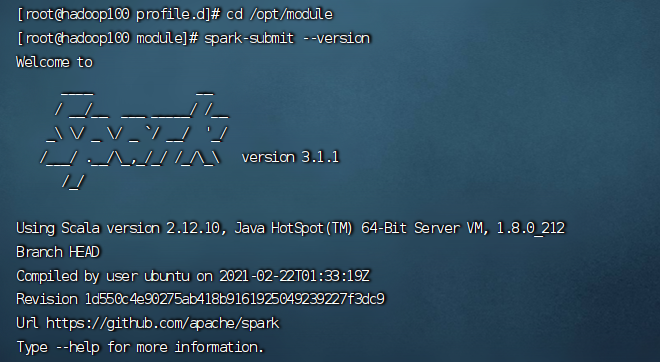
运行一下下面两行代码
root@hadoop100 profile.d# cd /opt/module
root@hadoop100 module# spark-submit --version
出现下列就是对的,成功了
现在我们使用单机模式运行第一个Spark程序
示例:
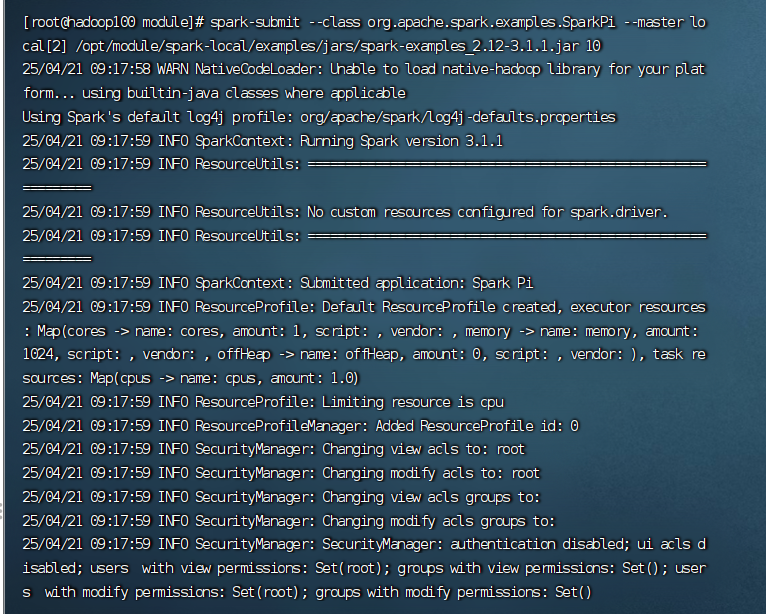
进入到spark-local,运行命令spark-submit命令。
spark-submit --class org.apache.spark.examples.SparkPi --master local2 /opt/module/spark-local/examples/jars/spark-examples_2.12-3.1.1.jar 10
结果展示:
查看运行任务详情
在任务还处于运行状态时,可以通过hadoop100:4040来查看。
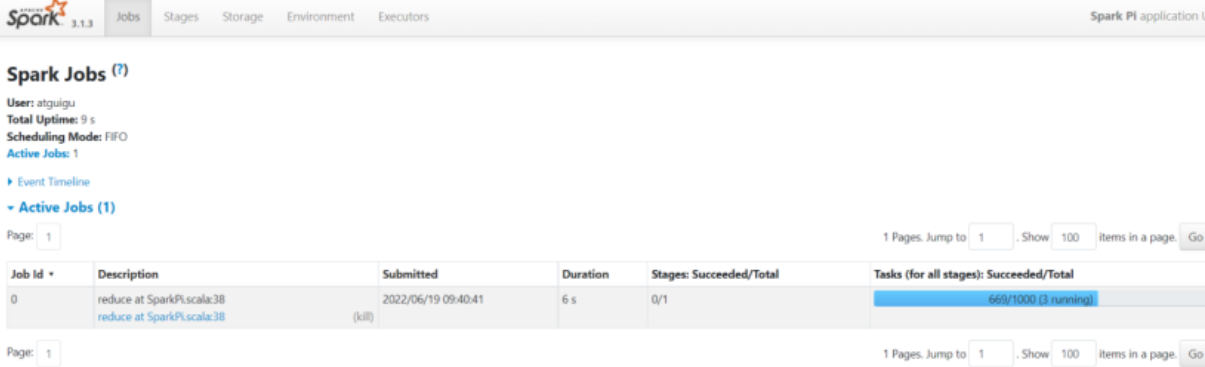 注:一旦任务结束,则这个界面就不可访问了。