1. 执行顺序
- spark-submit --config "spark.{driver/executor}.extraClassPath=someJar"提交的依赖包
- SystemClasspath -- Spark安装时候提供的依赖包
- spark-submit --jars 提交的依赖包
2. 依赖解释
-
提交任务时指定的依赖
Spark-submit --config "spark.{driver/executor}.extraClassPath=someJar"提交的依赖包
如指定driver或者executor上的包使用什么包,那个path是jar包的路径--conf spark.driver.extraClassPath=/root/.m2/repository/com/google/code/gson/gson/2.10.1/gson-2.10.1.jar \ --conf spark.executor.extraClassPath=/root/.m2/repository/com/google/code/gson/gson/2.10.1/gson-2.10.1.jar \ -
SystemClasspath
Spark安装时候提供的依赖包--spark环境的版本
如果只是在pom文件里面指定了要用什么版本,但是SystemClasspath 和指定版本不一样且没有配置spark.driver.extraClassPath时,会优先使用SystemClasspath
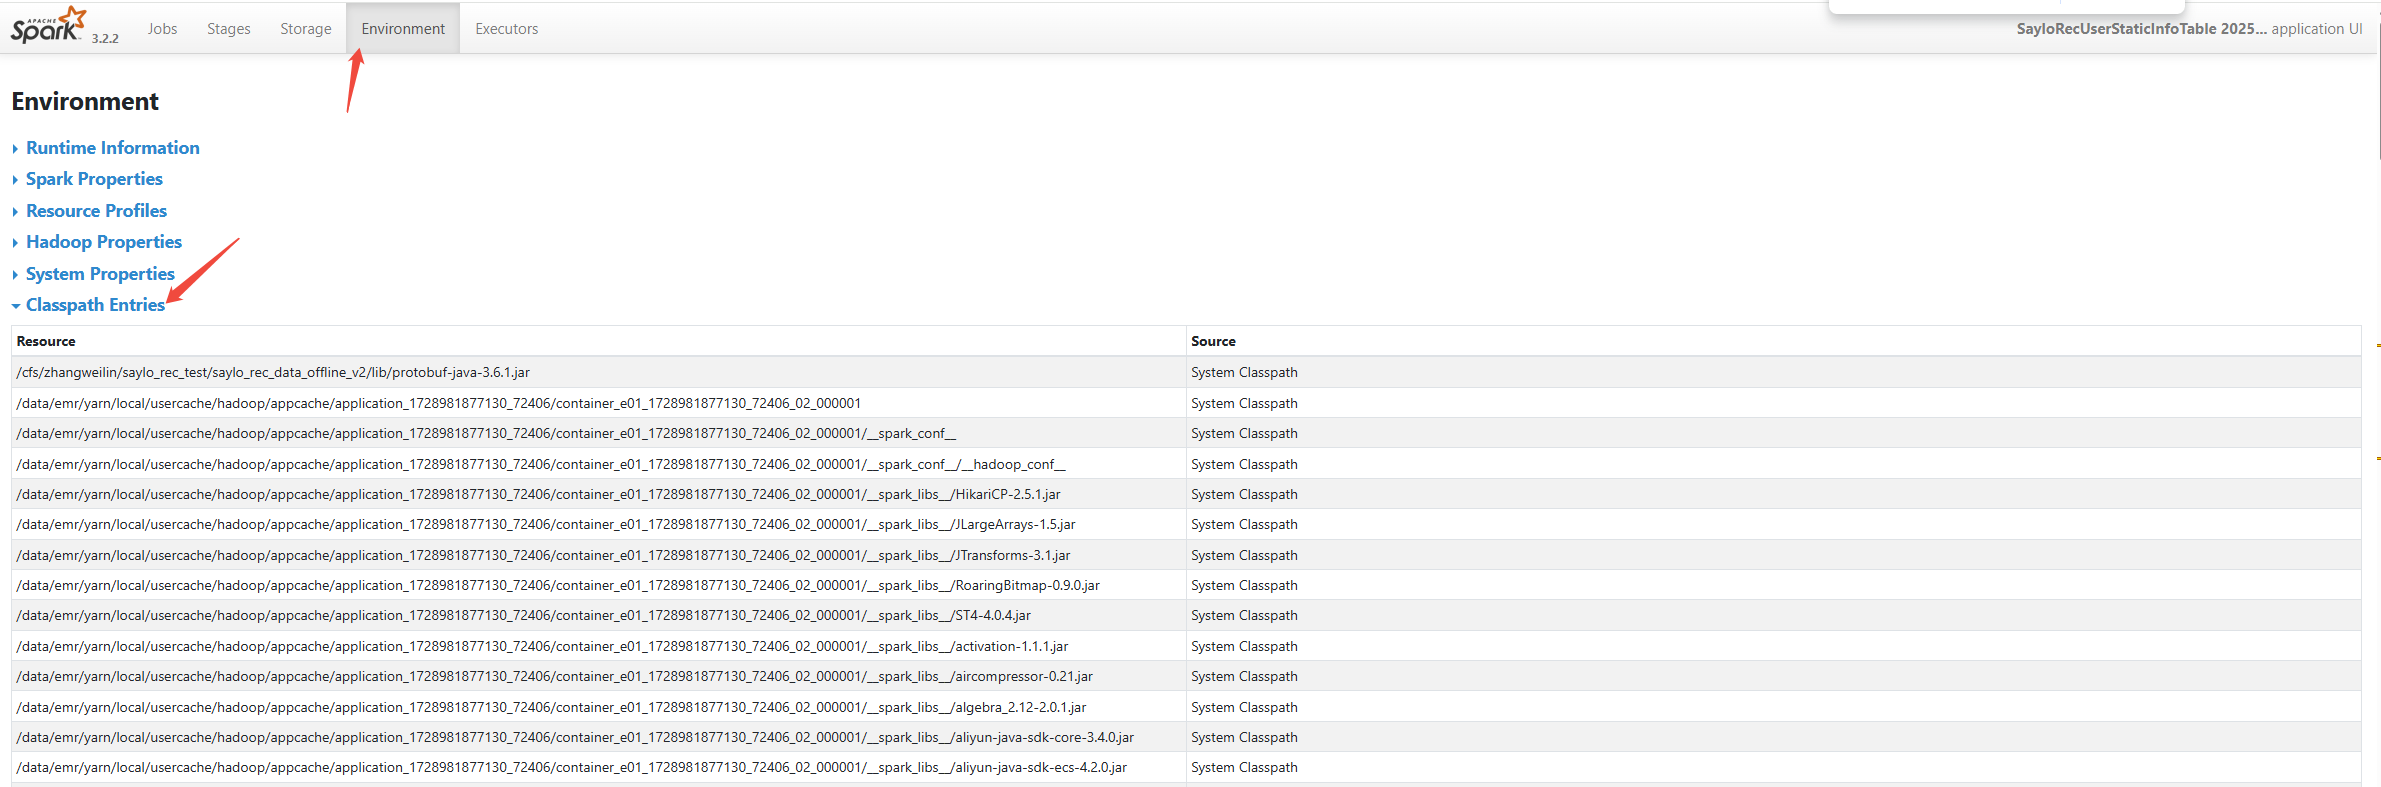
Spark-submit --jars 提交的依赖包
如果环境没有依赖的且不想打包到自己的项目jar里面时,可以使用该方式
如:
--jars /root/.m2/repository/com/google/code/gson/gson/2.10.1/gson-2.10.1.jar \
3. 完整的提交示例
su hadoop -c "/usr/local/service/spark/bin/spark-submit \
--class SayloRecUserStaticInfoTable \
--name 'SayloRecUserStaticInfoTable $DATE' \
--jars $PROJECT_ROOT/lib/protobuf-java-3.6.1.jar \
--conf spark.driver.extraClassPath=/root/.m2/repository/com/google/code/gson/gson/2.10.1/gson-2.10.1.jar \
--conf spark.executor.extraClassPath=/root/.m2/repository/com/google/code/gson/gson/2.10.1/gson-2.10.1.jar \
--conf spark.driver.extraClassPath=$PROJECT_ROOT/lib/protobuf-java-3.6.1.jar \
--conf spark.executor.extraClassPath=$PROJECT_ROOT/lib/protobuf-java-3.6.1.jar \
--conf spark.sql.broadcastTimeout=7200 \
--conf spark.executor.cores=4 \
--conf spark.executor.memory=2G \
--conf spark.local.dir=/data/tmp \
--conf spark.executor.local.dir=/tmp \
--num-executors 2 \
--master yarn \
--deploy-mode cluster \
$PROJECT_ROOT/target/saylo_rec_data_offline_v2-1.0.0-jar-with-dependencies.jar.jar \
dst_table=saylo.t_saylo_user_test \
date=\"$DATE\""