1 输入prompt 得到input id
input id: B,L # batch size , lenth
2 embeding之后得到 input_embeds: B,L,D # demensions
3 进入Transformer层
先通过linear层得到shape不变的 QKV
多头注意力 分割Dimension , kv变成 B,H,L,head_dim h是head,head_dim * head = Dimension
(如果有kvcache的话):
new key B, H, 1 head_dim
past key B,H,L_prev,dim
concat:B,H,L_prev+1,dim
Attn输出 B,L,D
outputs = self.transformer(input_ids, ...)
final_hidden_states = outputs0 # shape: B, L, D
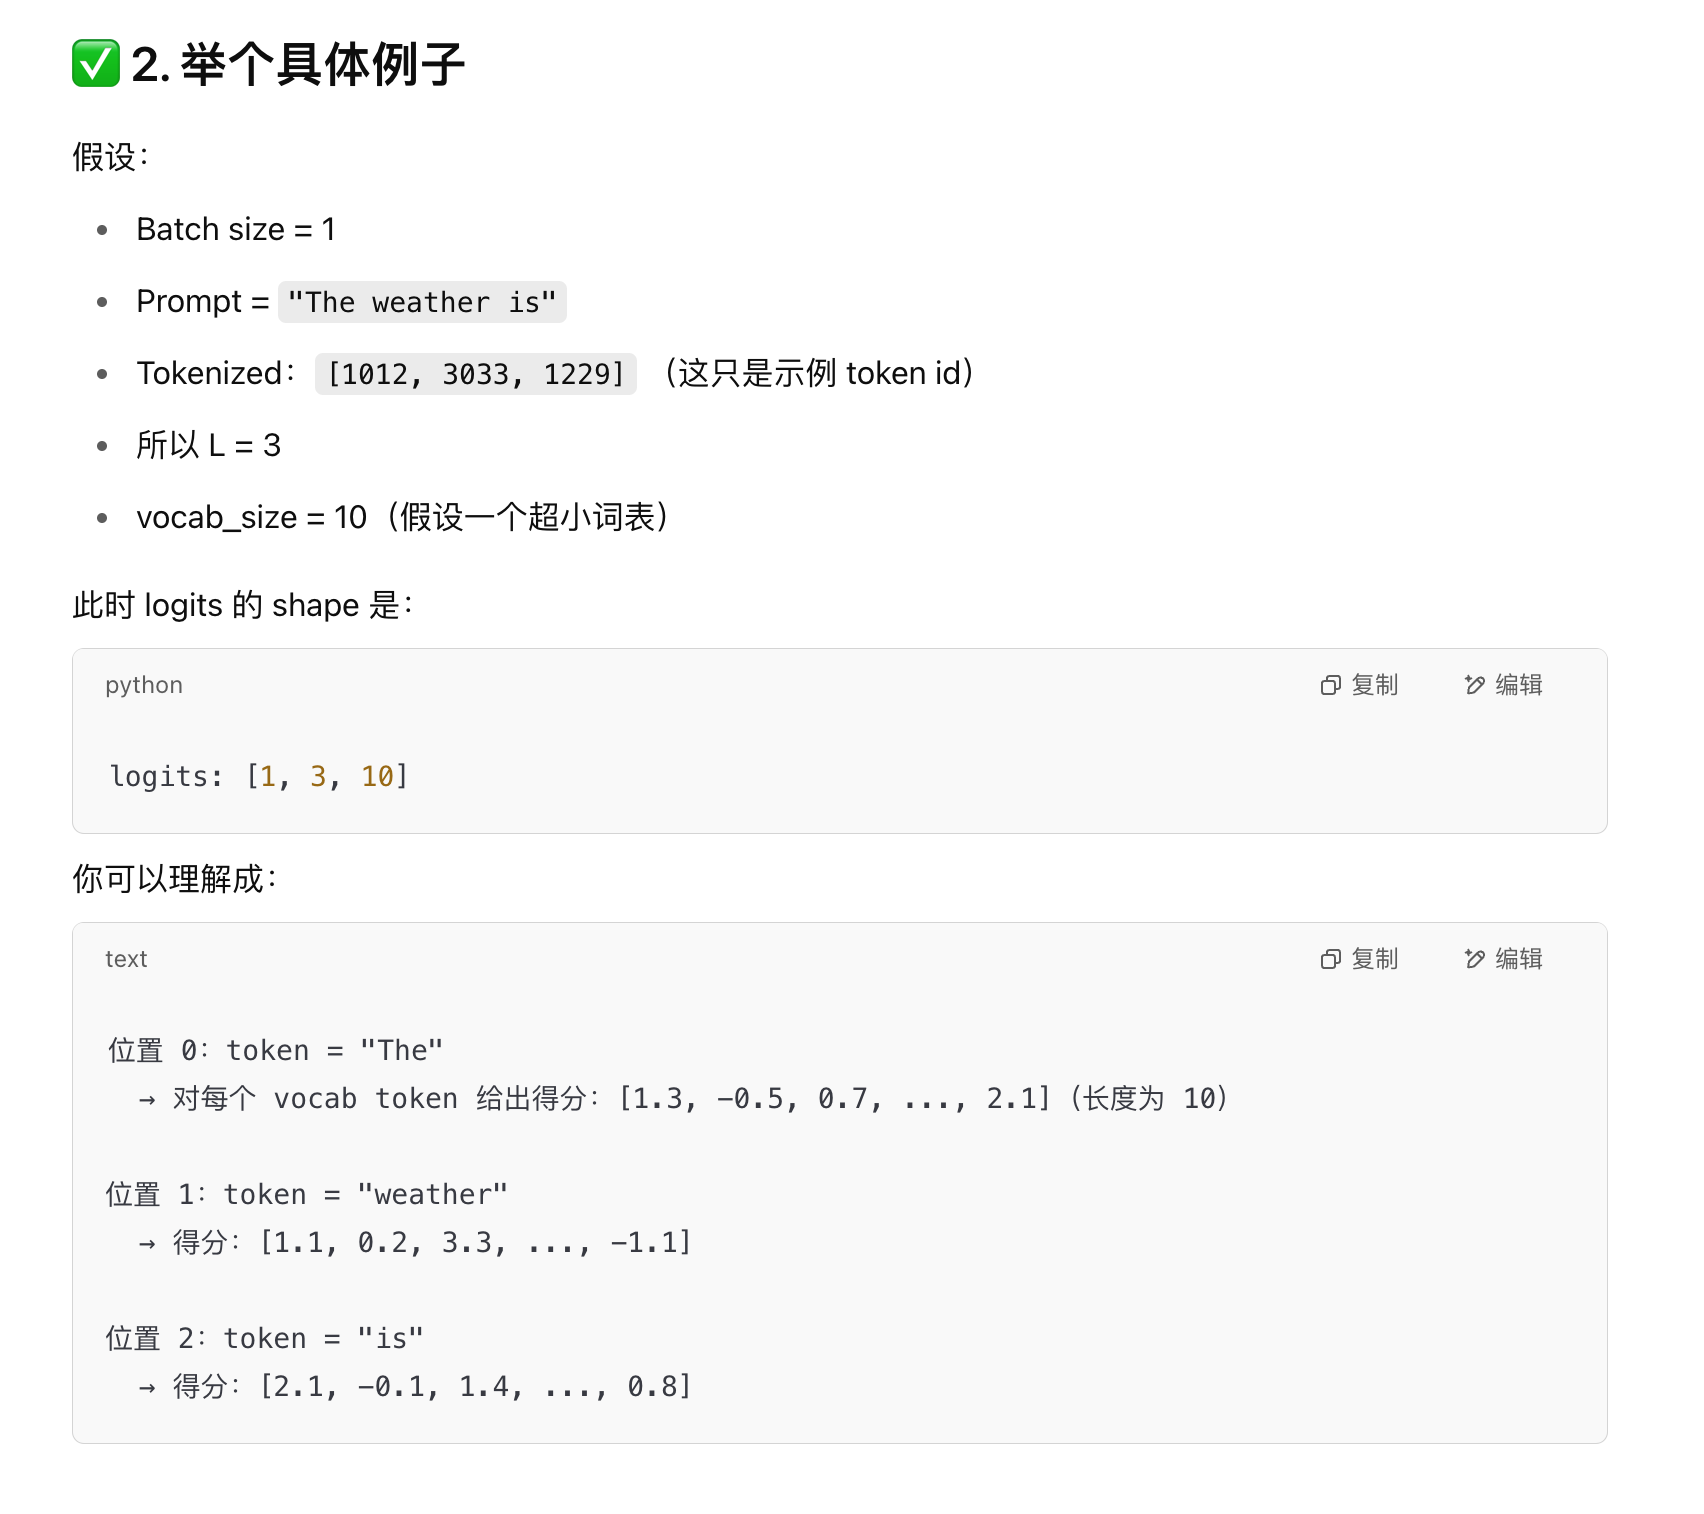
logits = self.lm_head(final_hidden_states) # shape: B, L, vocab_size
self.transformer 是由多层 Qwen2Block(带 attention + feedforward)堆叠组成,每层更新一次 hidden state。最终最后一层输出的 hidden state 就是 final_hidden_states。
logits = lm_head(final_hidden_states)
→ B, L, vocab_size
(值是每个位置对每个词的预测得分)
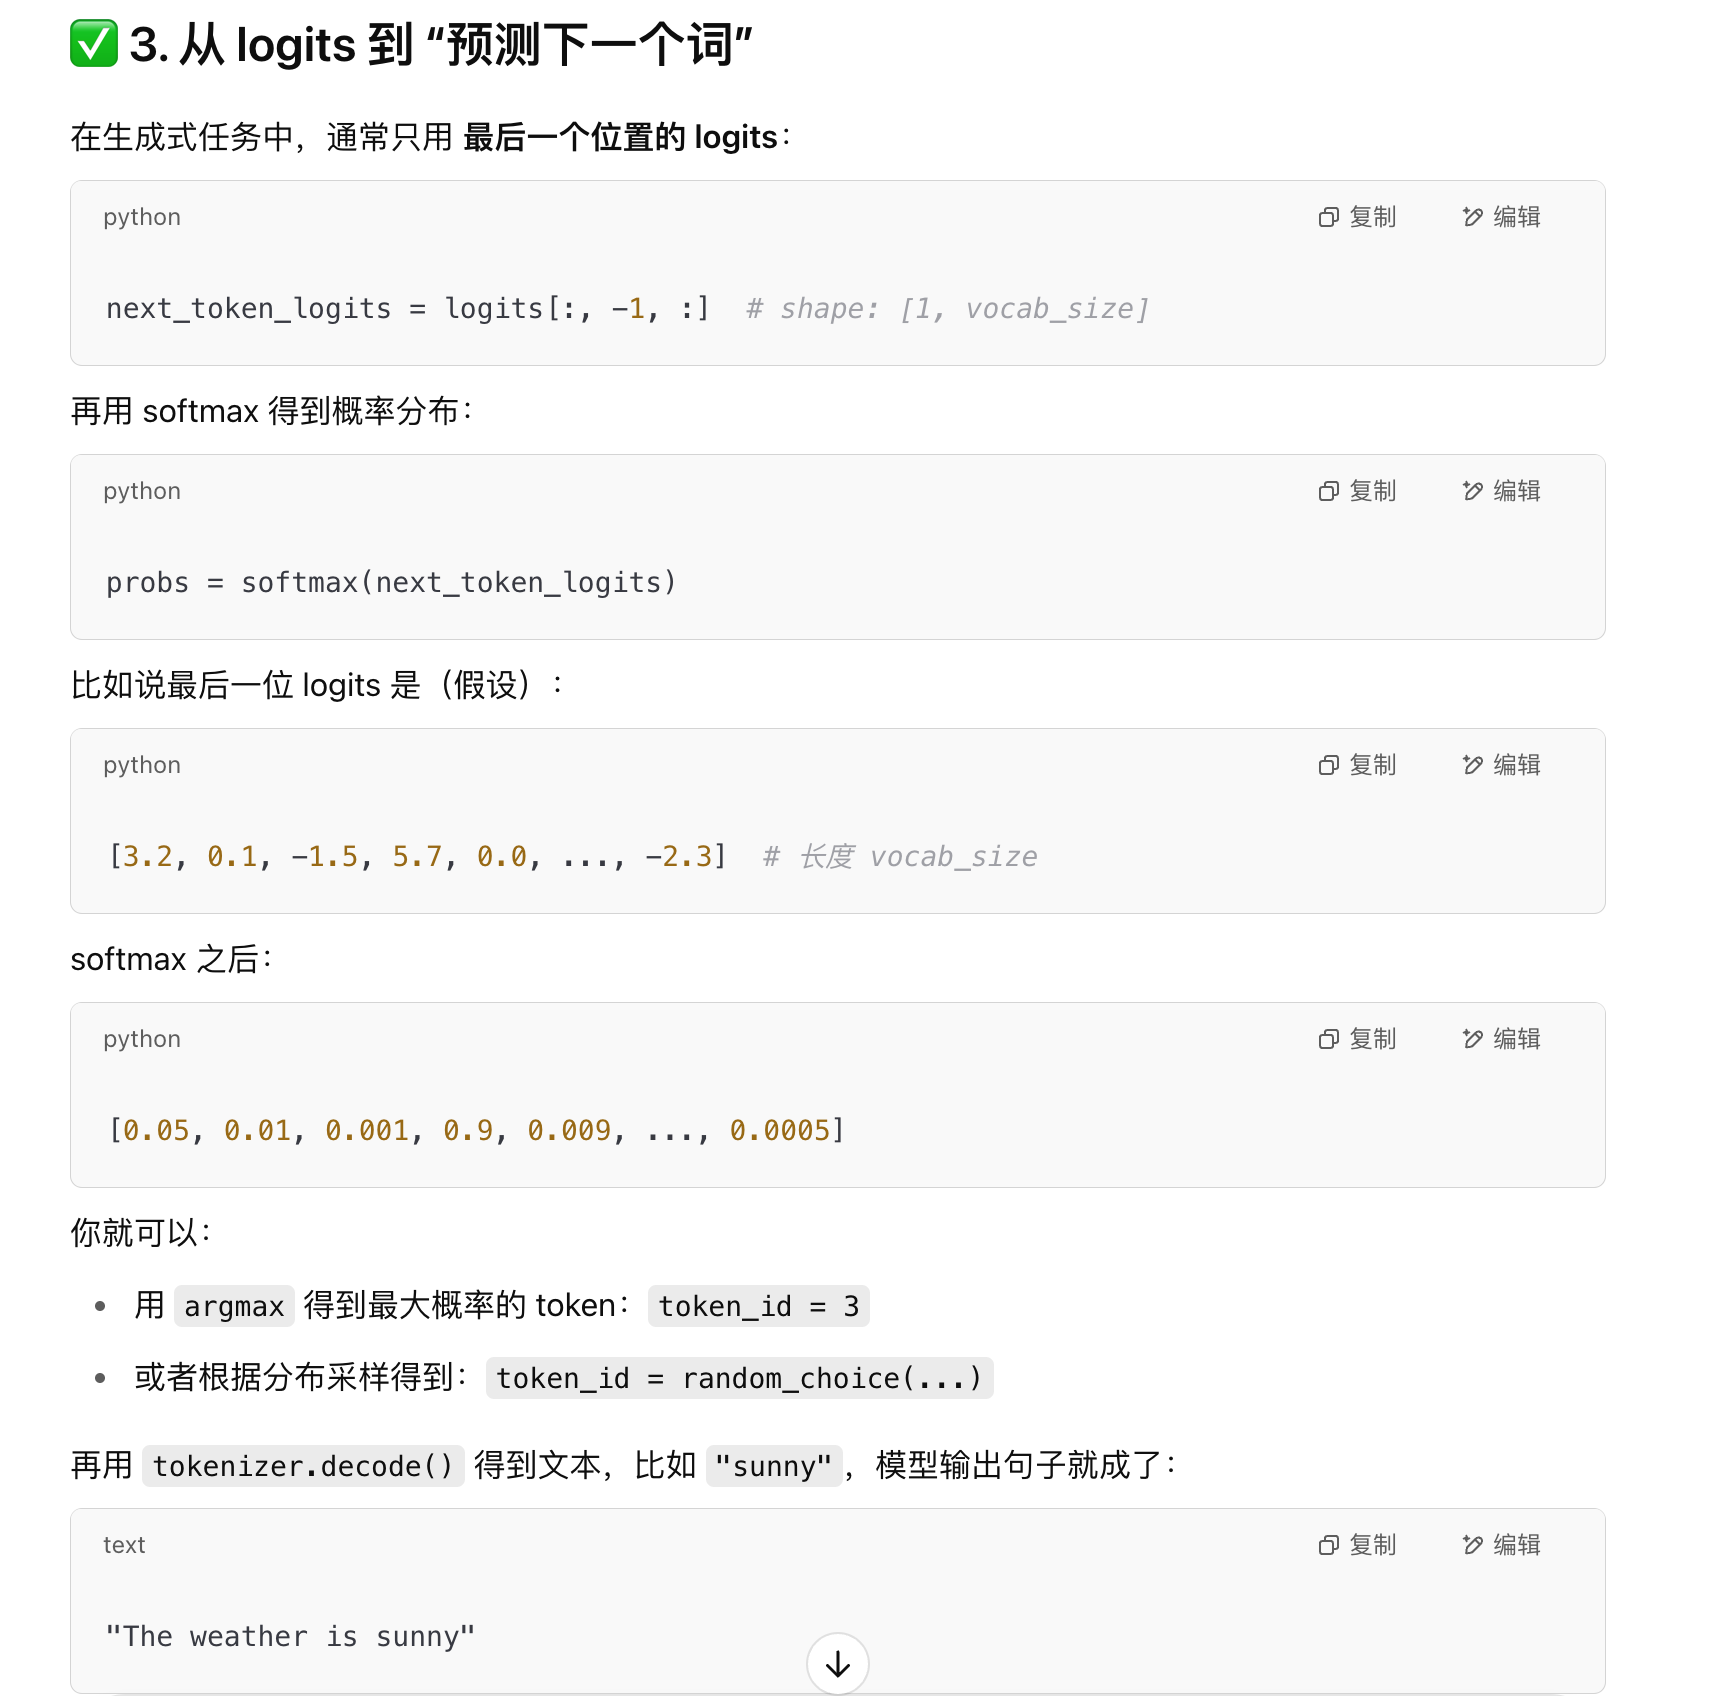
遇到到是哪个token_id之后 用tokenizer.decode()得到最终的词
lm_head是什么
语言建模头(Language Modeling Head)
一个线性层,将输出的hidden_states映射到词表维度
vocab_size = 151936, hidden_size = 4096
self.lm_head = nn.Linear(4096, 151936, bias=False)
得到logits之后还有一个sampling的过程
greedy sampling 直接取最大值
next_token = ops.argmax(next_token_logits, axis=-1) # B
Top-k / Top-p Sampling:
用 softmax 得到概率
probs = ops.softmax(next_token_logits, axis=-1) # B, vocab_size
根据策略采样
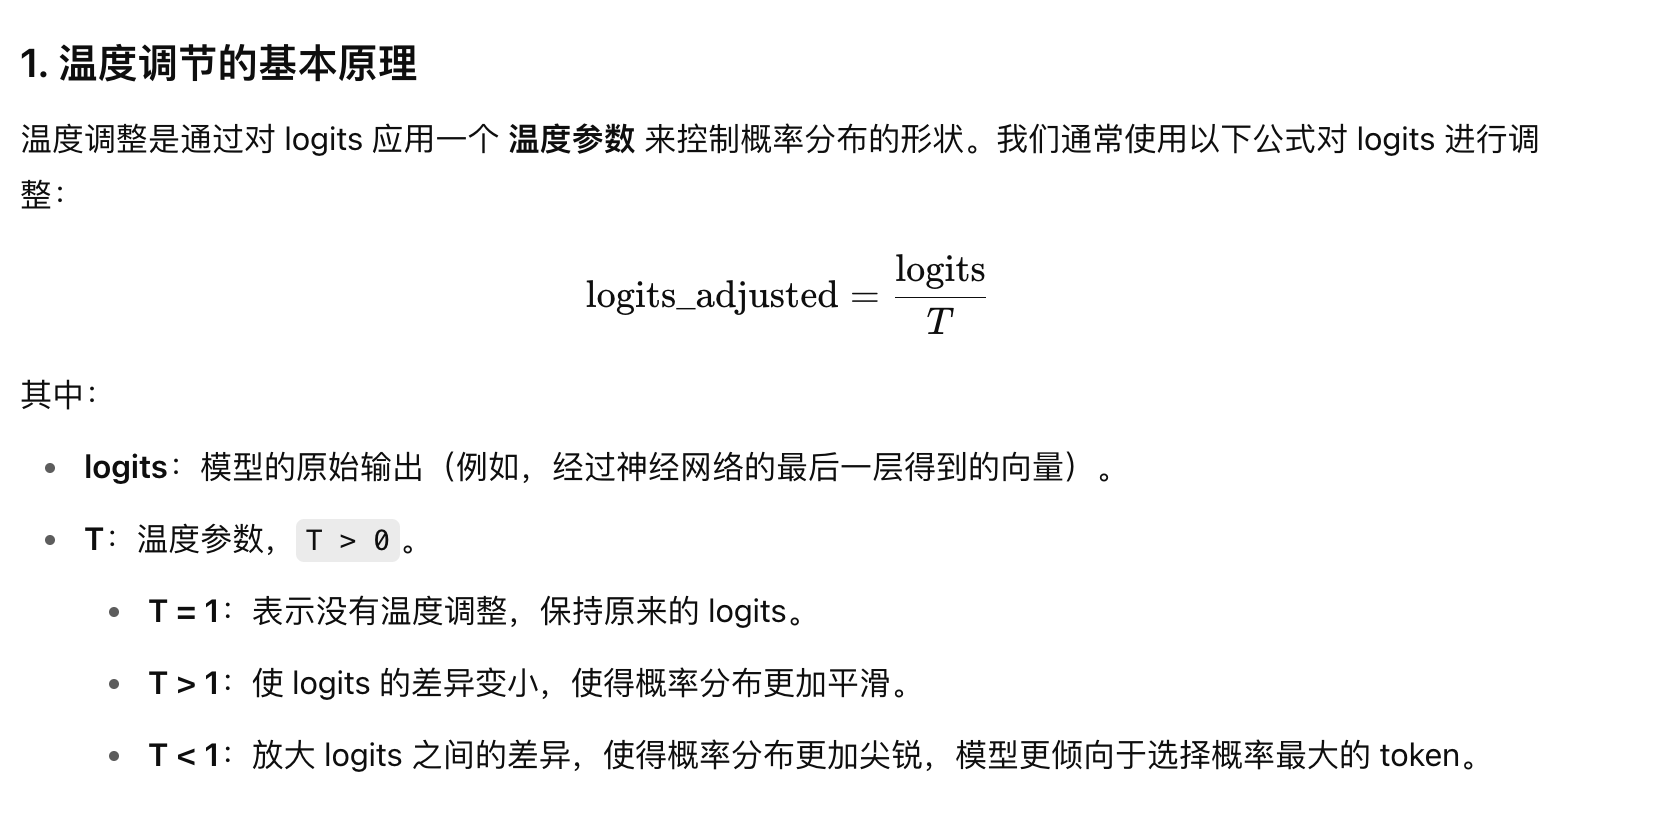
next_token = sample_from(probs, top_k=50, top_p=0.95, temperature=1.0)
top_k 取前k个概率大的
top_p 累积概率小于0.95