1. 导入依赖 :
<dependency>
<groupId>org.apache.spark</groupId>
<artifactId>spark-streaming-kafka-0-10_2.12</artifactId>
<version>3.0.0</version>
</dependency>
2.编写代码 :
创建SparkConf和StreamingContext。
定义Kafka相关参数,如bootstrap servers、group id、key和value的deserializer。
使用KafkaUtils.createDirectStream方法创建DStream,该方法接受StreamingContext、位置策略、消费者策略等参数。
提取数据中的value部分,并进行word count计算。
启动StreamingContext并等待其终止。
import org.apache.kafka.clients.consumer.{ConsumerConfig, ConsumerRecord}
import org.apache.spark.SparkConf
import org.apache.spark.streaming.{Seconds, StreamingContext}
import org.apache.spark.streaming.dstream.{DStream, InputDStream}
import org.apache.spark.streaming.kafka010.{ConsumerStrategies, KafkaUtils, LocationStrategies}
object DirectAPI {
def main(args: ArrayString): Unit = {
val sparkConf = new SparkConf().setMaster("local\*").setAppName("direct")
val ssc = new StreamingContext(sparkConf,Seconds(3))
//定义kafka相关参数
val kafkaPara :MapString,Object = MapString,Object(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG
->"node01:9092,node02:9092,node03:9092",
ConsumerConfig.GROUP_ID_CONFIG->"kafka",
"key.deserializer"->"org.apache.kafka.common.serialization.StringDeserializer",
"value.deserializer" -> "org.apache.kafka.common.serialization.StringDeserializer"
)
//通过读取kafka数据,创建DStream
val kafkaDStream:InputDStreamConsumerRecord\[String,String] = KafkaUtils.createDirectStreamString,String(
ssc,LocationStrategies.PreferConsistent,
ConsumerStrategies.SubscribeString,String(Set("kafka"),kafkaPara)
)
//提取出数据中的value部分
val valueDStream :DStreamString = kafkaDStream.map(record=>record.value())
//wordCount计算逻辑
valueDStream.flatMap(_.split(" "))
.map((_,1))
.reduceByKey(+)
.print()
ssc.start()
ssc.awaitTermination()
}
}
3.运行程序 :
开启Kafka集群。
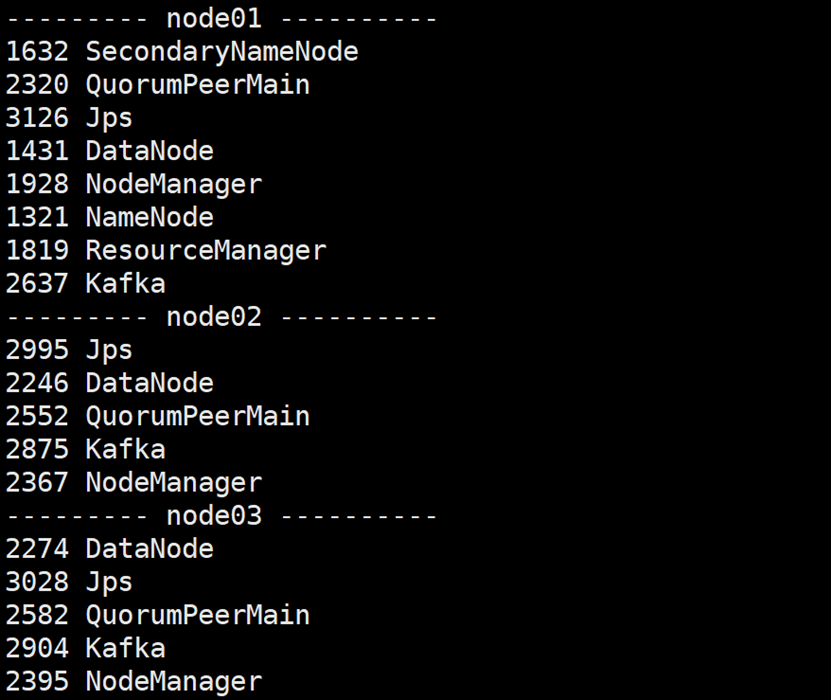
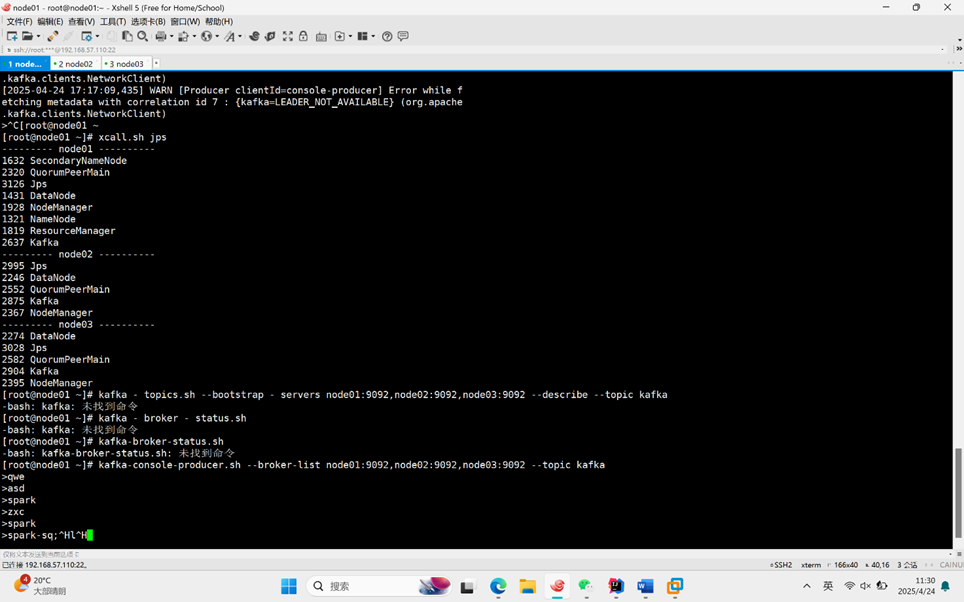
4.使用Kafka生产者产生数据。
kafka-console-producer.sh --broker-list node01:9092,node02:9092,node03:9092 --topic kafka
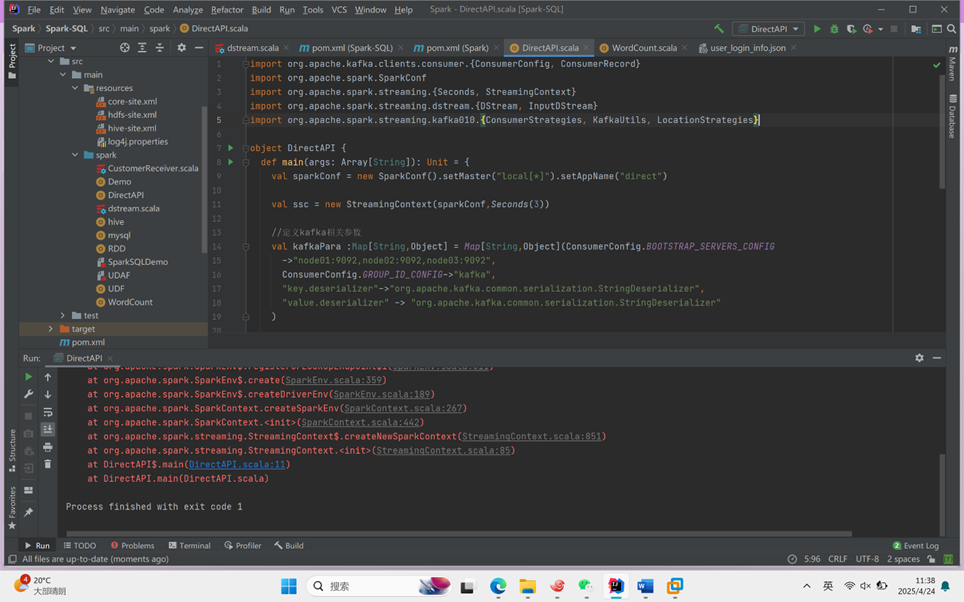
 5、运行Spark Streaming程序,接收Kafka生产的数据并进行处理。
6.查看消费进度 :
使用Kafka提供的kafka-consumer-groups.sh脚本查看消费组的消费进度。