flume整合Kafka和spark-streaming核心编程

flume整合Kafka

需求1:利用flume监控某目录中新生成的文件,将监控到的变更数据发送给kafka,kafka将收到的数据打印到控制台:

1.查看topic
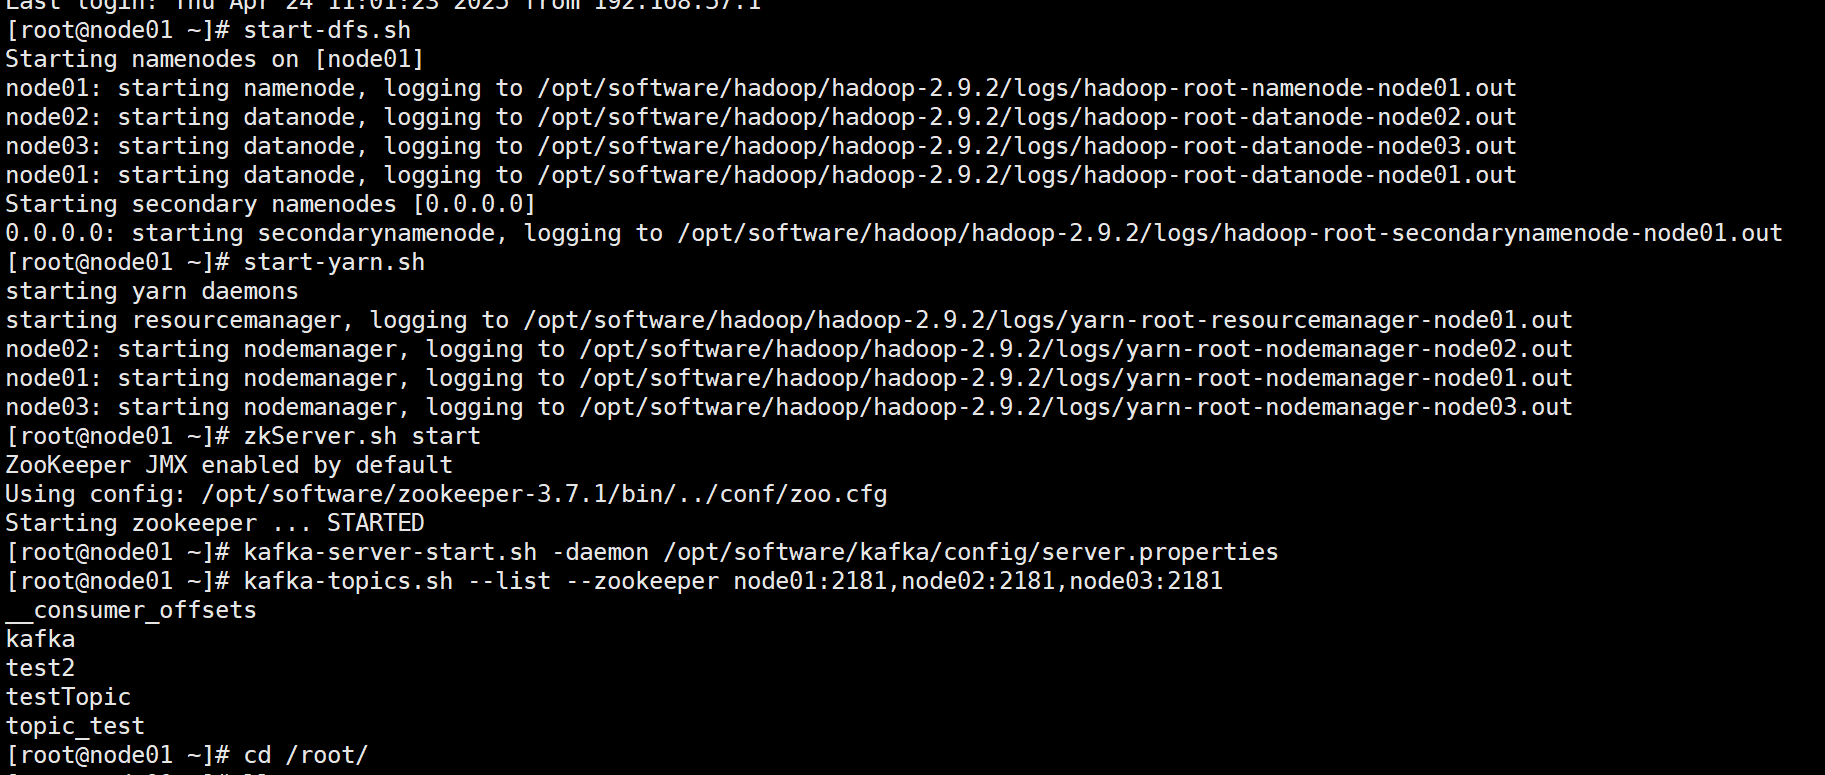
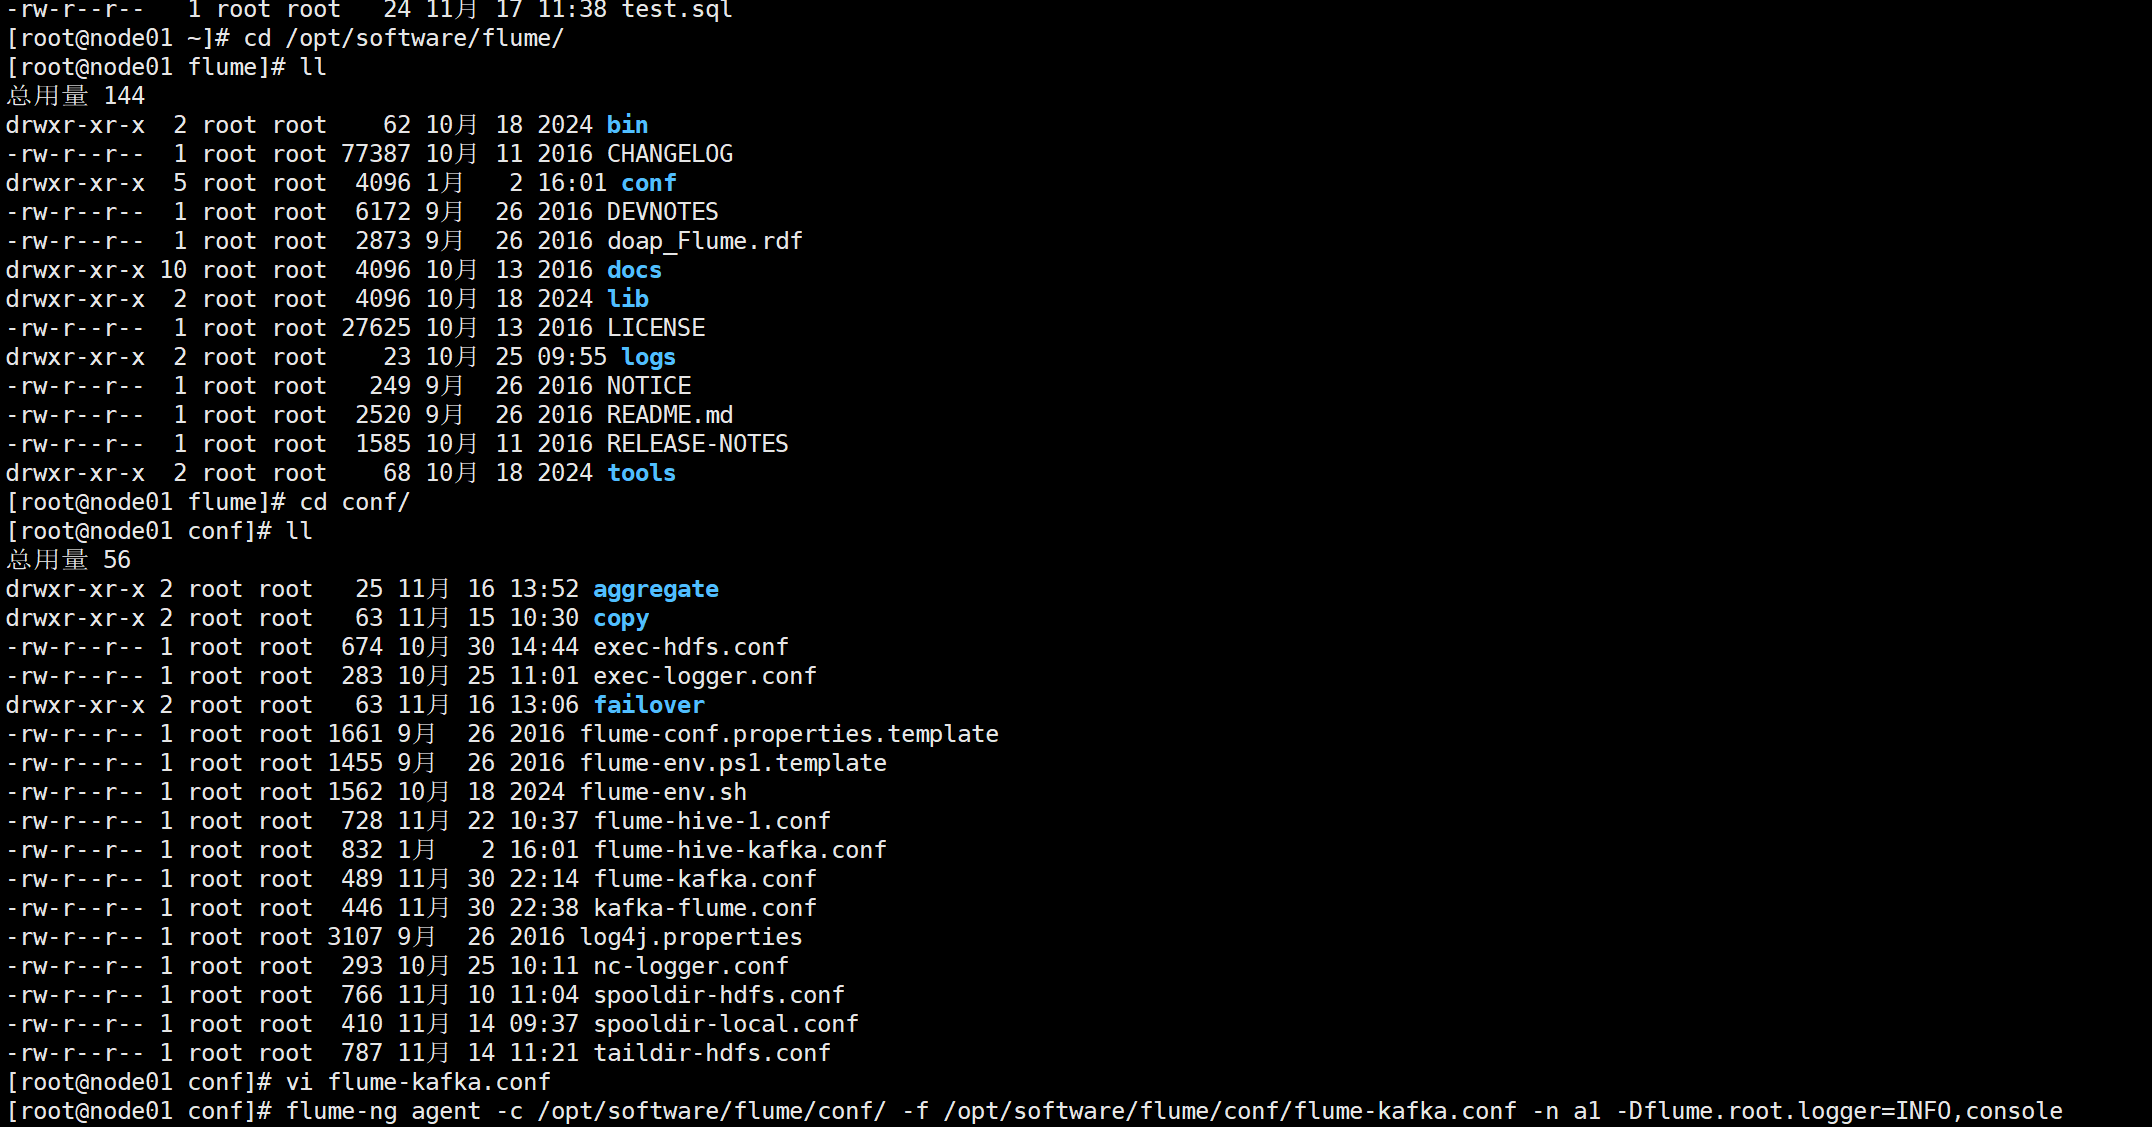
2.编辑flume-Kafka.conf,并启动flume
3.启动Kafka消费者

4.新增测试数据

5.查看Kafka消费者控制台

需求2:Kafka生产者生成的数据利用Flume进行采集,将采集到的数据打印到Flume的控制台上。

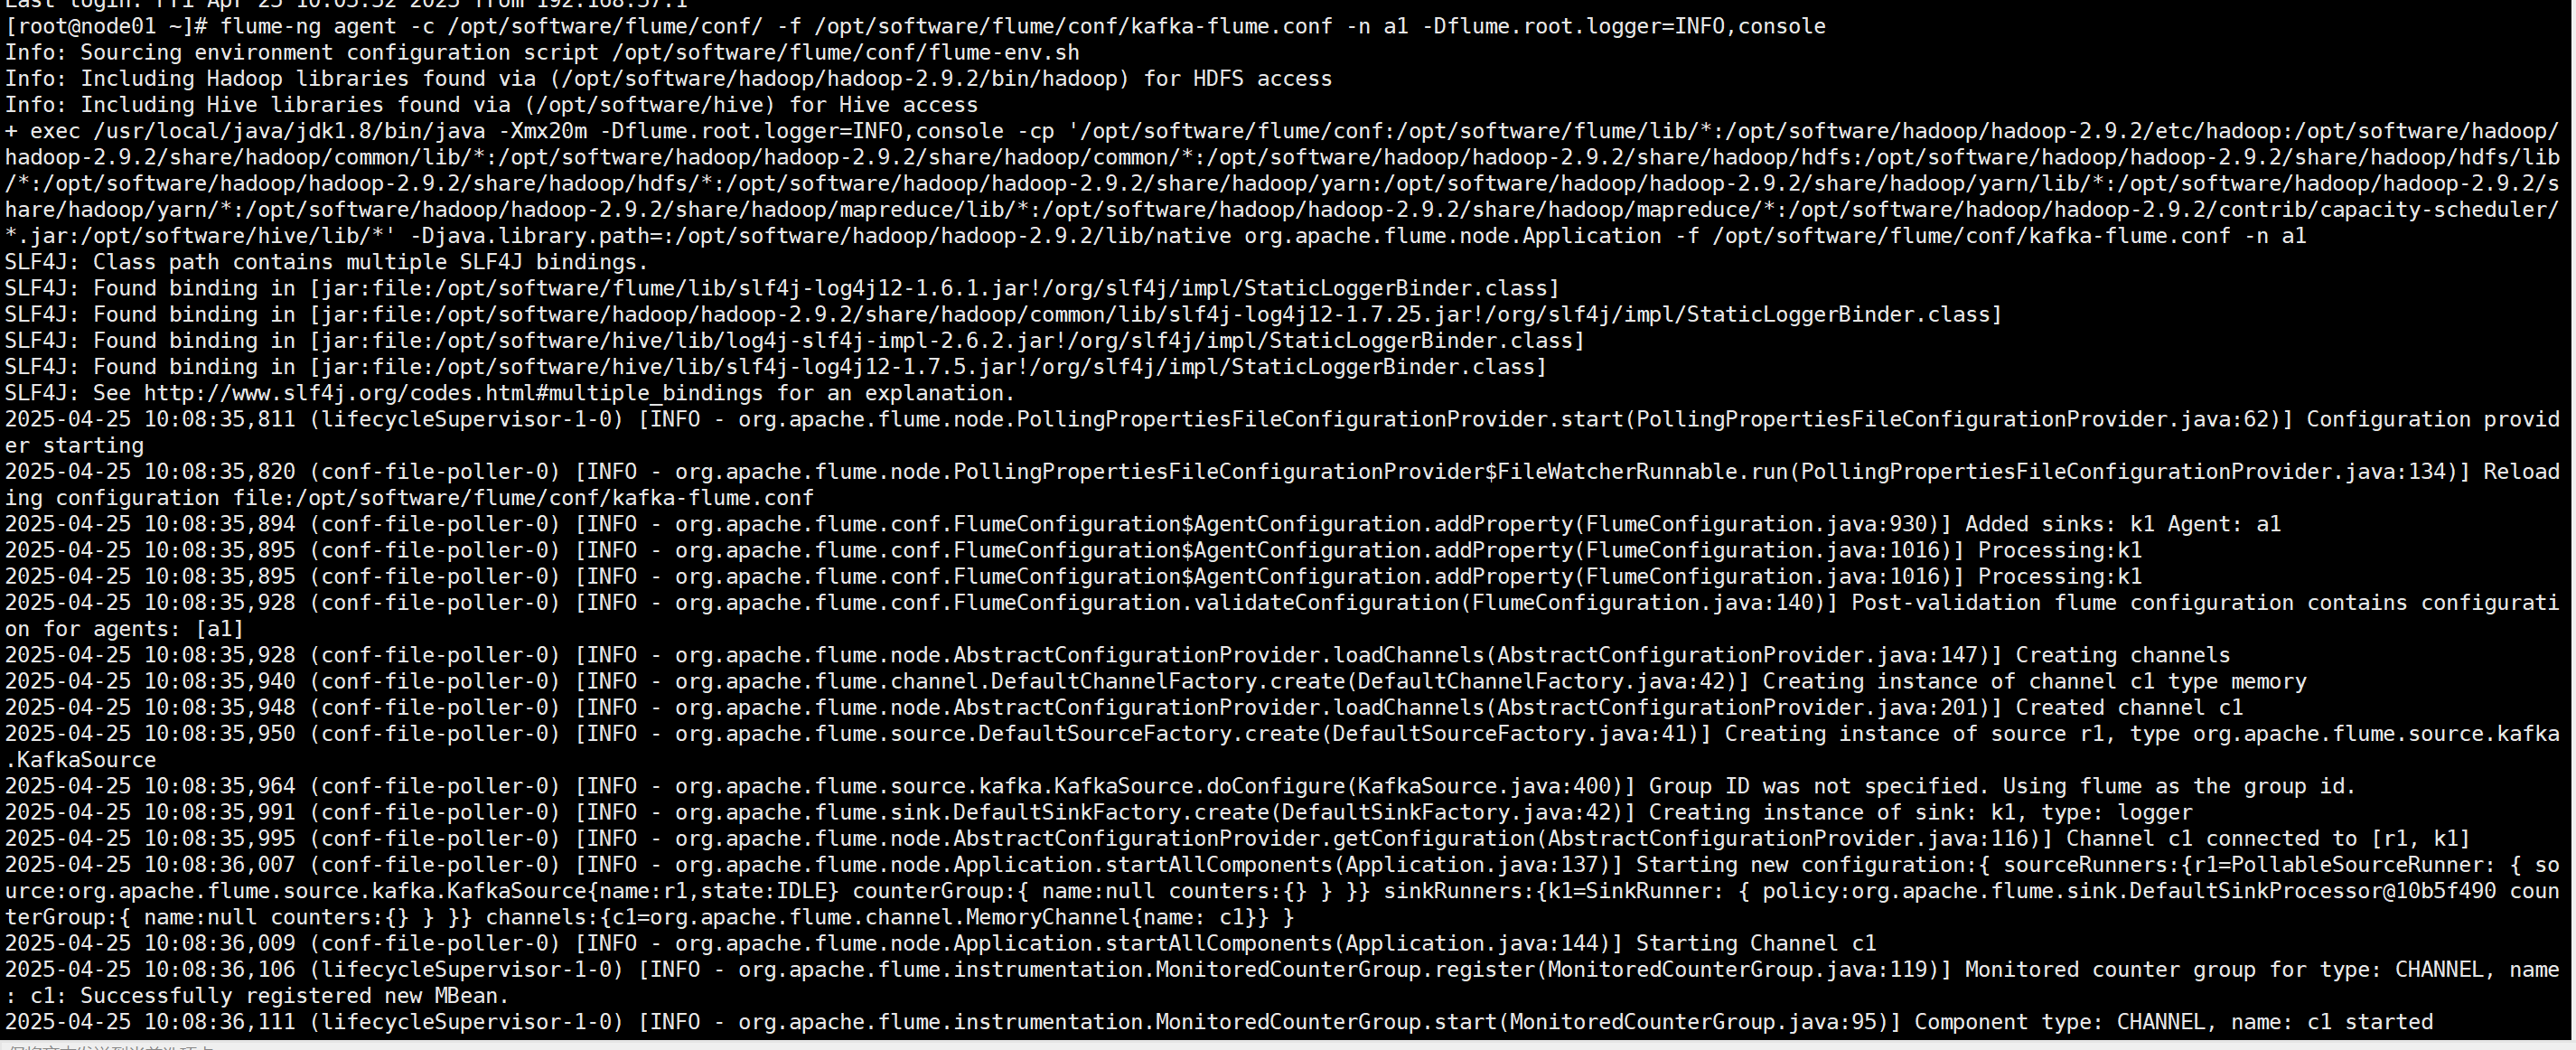
1编辑kafka-flume.conf,并启动flume
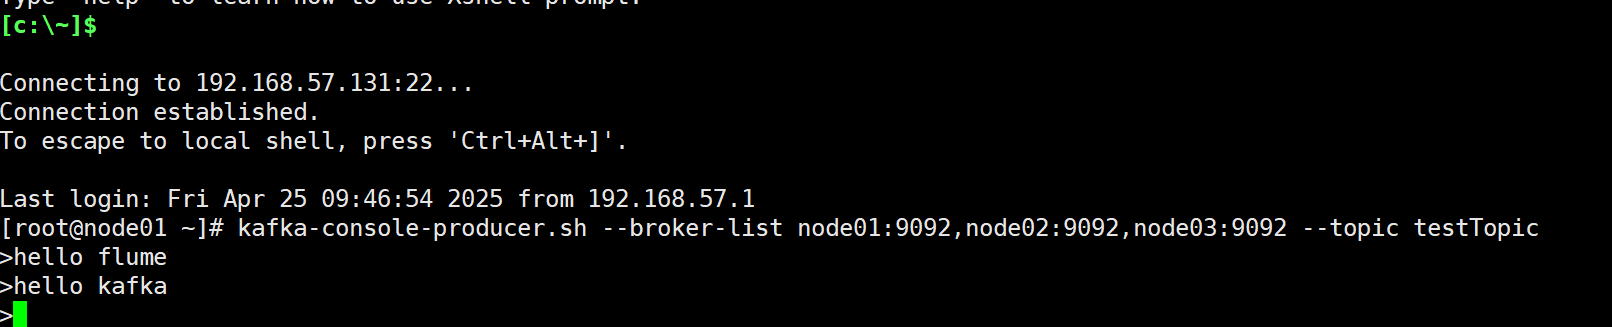
2.启动Kafka生产者,并在生产者种写入数据
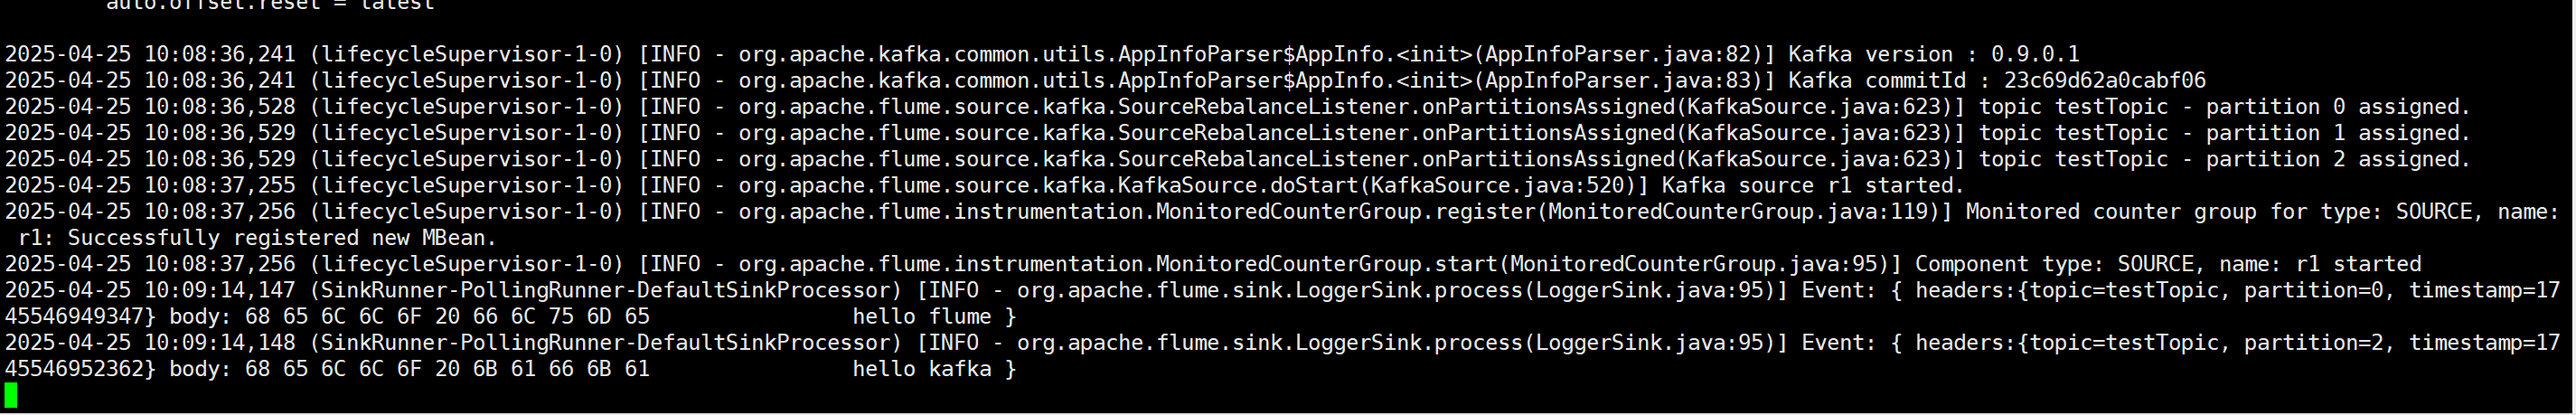
3.查看flume采集的数据
DStream转换

DStream 上的操作与 RDD 的类似,分为 Transformations(转换)和 Output Operations(输出)两种,此外转换操作中还有一些比较特殊的原语,如:updateStateByKey()、transform()以及各种 Window 相关的原语。

Transform

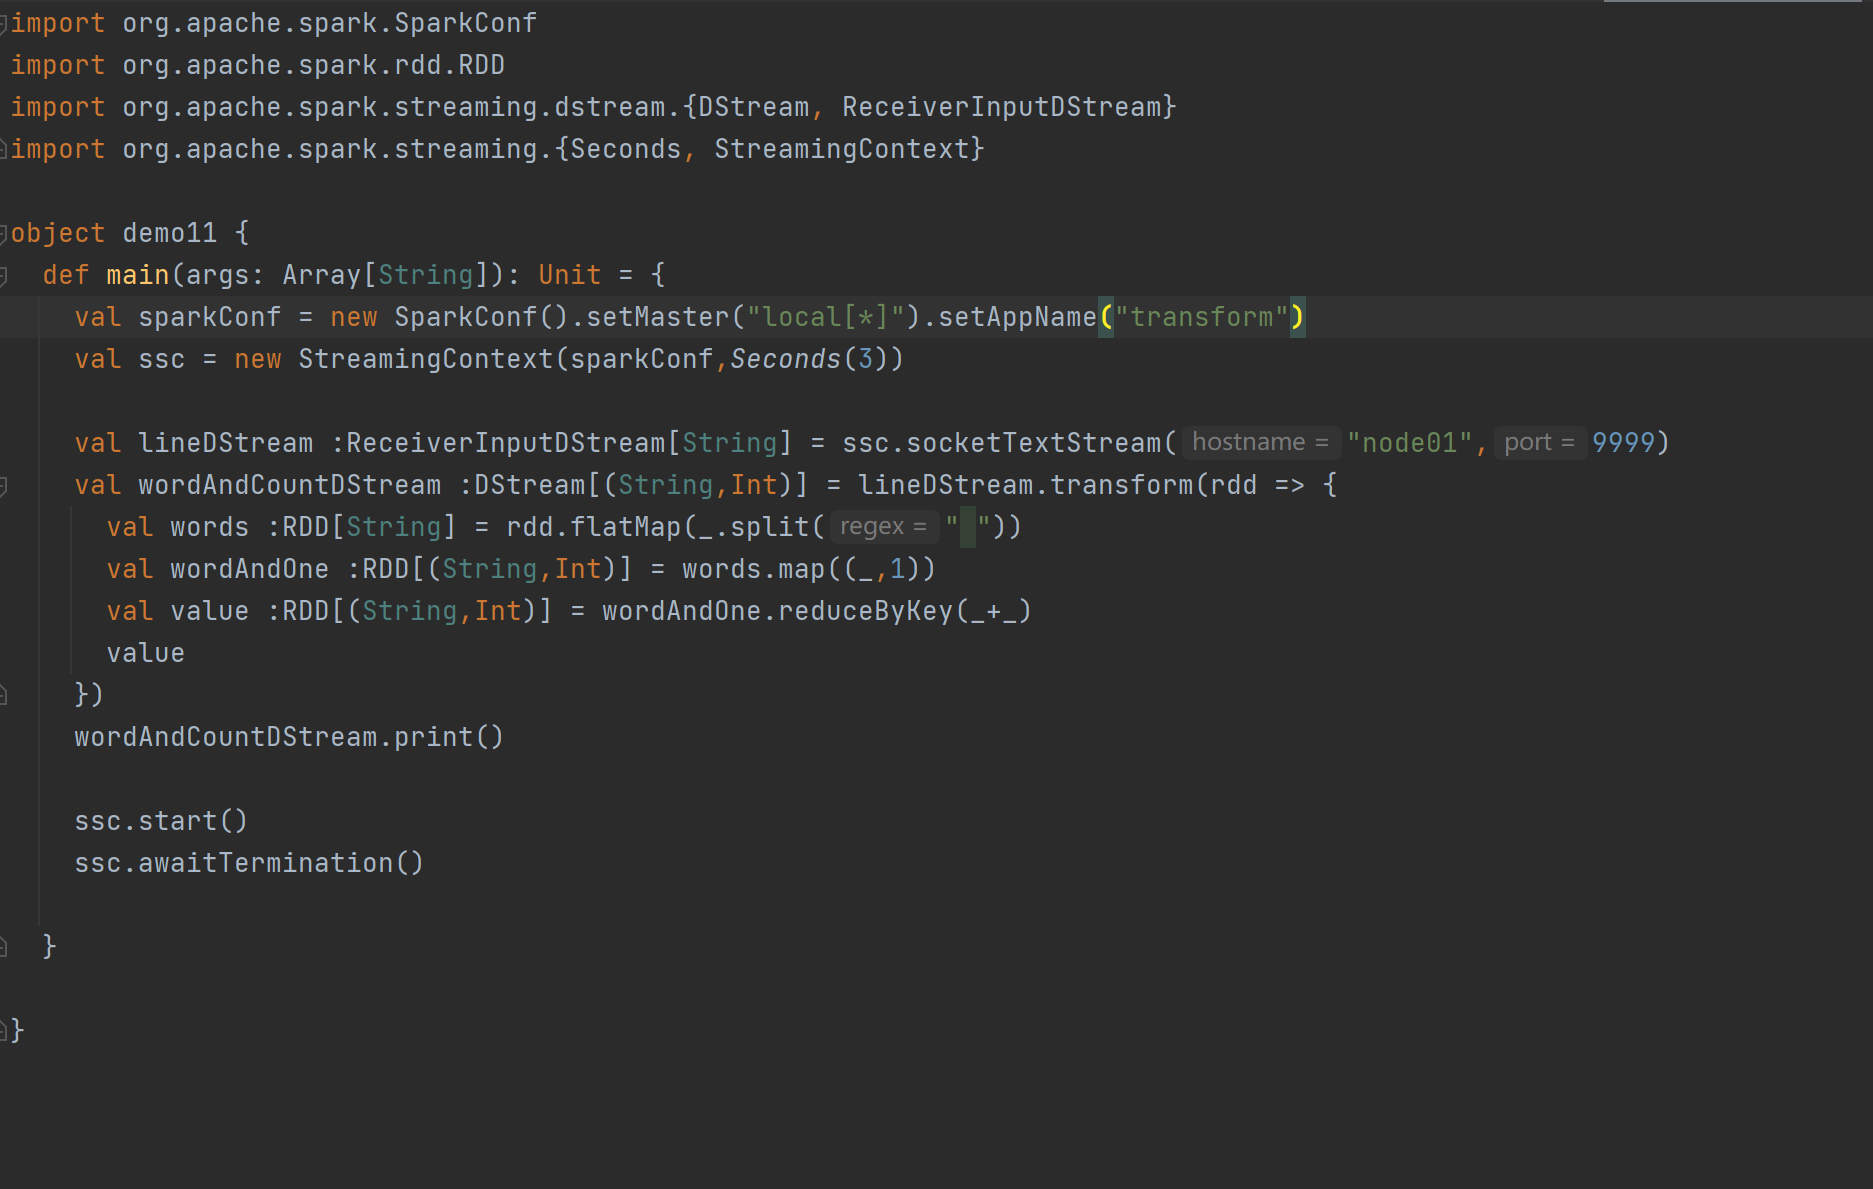
Transform 允许 DStream 上执行任意的 RDD-to-RDD 函数。即使这些函数并没有在 DStream的 API 中暴露出来,通过该函数可以方便的扩展 Spark API。该函数每一批次调度一次。其实也就是对 DStream 中的 RDD 应用转换。

代码案例
join

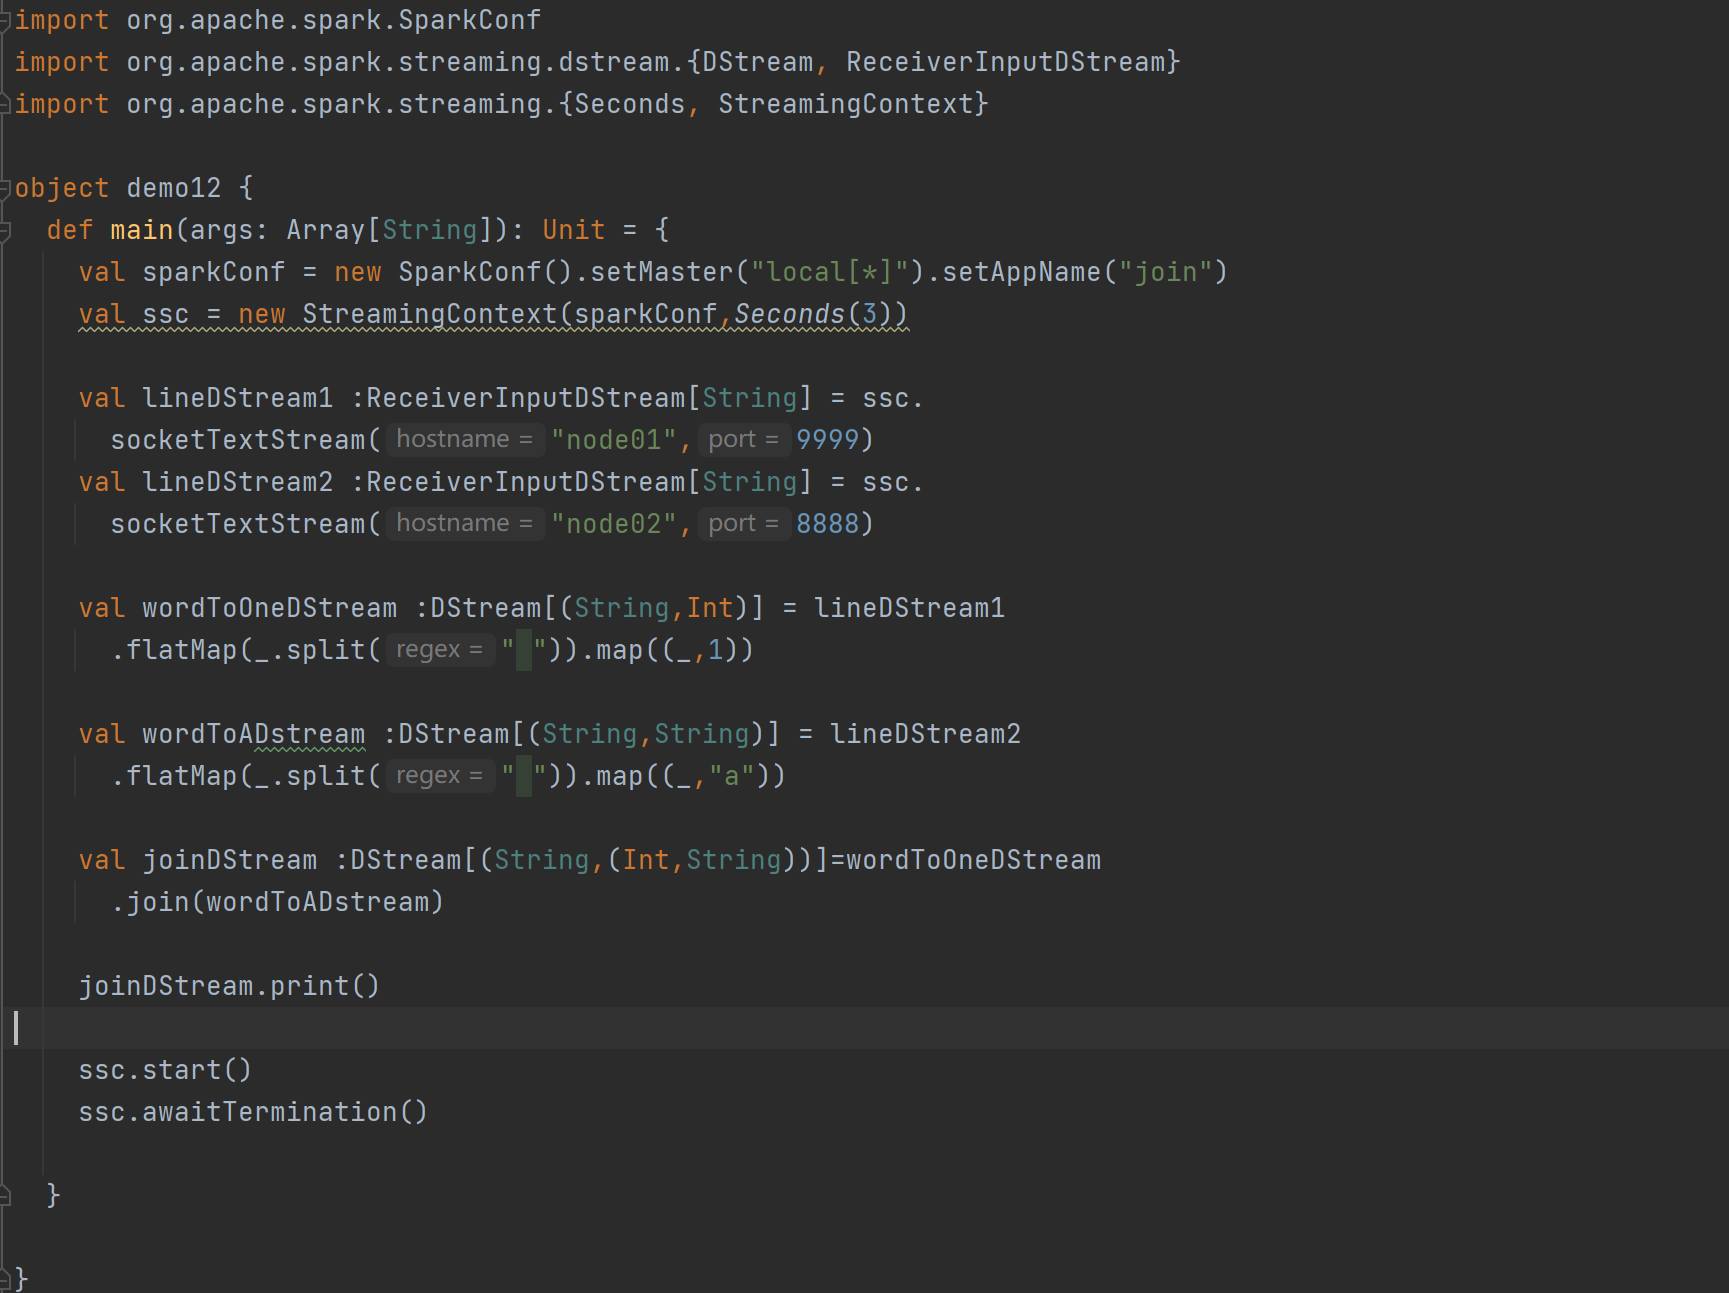
两个流之间的 join 需要两个流的批次大小一致,这样才能做到同时触发计算。计算过程就是对当前批次的两个流中各自的 RDD 进行 join,与两个 RDD 的 join 效果相同

代码案例
相关推荐
starzy199012 小时前
Kafka响应发送:字节是怎么真正写回客户端的
大数据·kafka
阳光不锈@14 小时前
三大主流消息队列架构设计思想剖析:从 RabbitMQ 到 RocketMQ 的改造实践
kafka·rabbitmq·rocketmq·rabbit改造rocket·去除rabbitmq·rabbitmq改造
ZealSinger18 小时前
Boot4升后Kafka retry属性怎么改
kafka·retry·boot4·升级踩坑
starzy199019 小时前
KafkaProducer 源码深度剖析:处理粘包问题的完美方案
大数据·kafka
MrWind灬1 天前
我给自己写了个 Kafka 桌面客户端:MrWindKafkaClient
kafka·pyqt
starzy19902 天前
KafkaProducer 源码深度剖析:与 Broker 建立连接
大数据·kafka
我不会起名字3222 天前
Kafka 重复消费:自动提交位点与手动提交的 3 个错位
kafka·消息队列·幂等·排查
ly76893 天前
Kafka 消费者重试与死信:Spring for Apache Kafka 的边界设计
spring·kafka·apache·并发消费·消费者重试·死信主题·位移提交
我不会起名字3224 天前
Kafka 顺序消息为什么乱了:分区数变化与重试的 3 类原因
kafka·消息队列·顺序·排查
每天一道题5 天前
Kafka 是如何工作的?从 Broker、Partition、Offset 到 Consumer Group
分布式·kafka