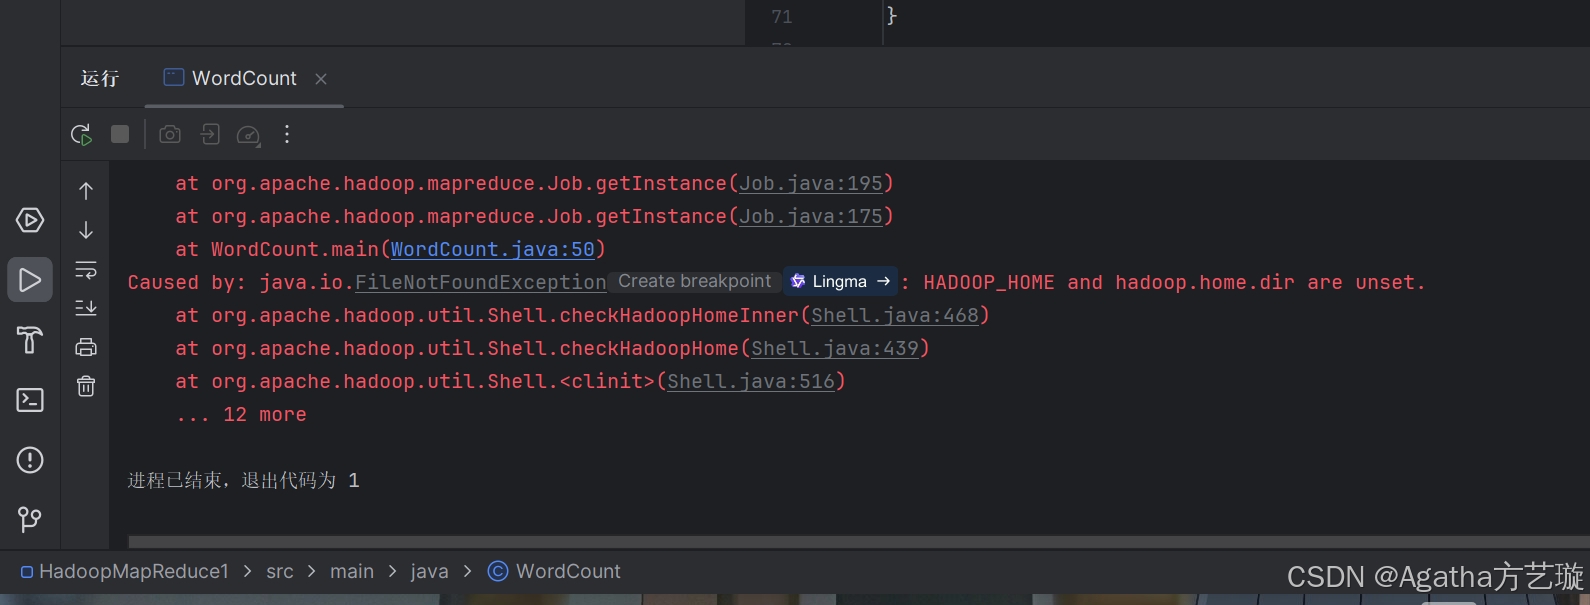
MapReduce报错 HADOOP_HOME and hadoop.home.dir are unset.

运行课程讲解内容出现这个报错:

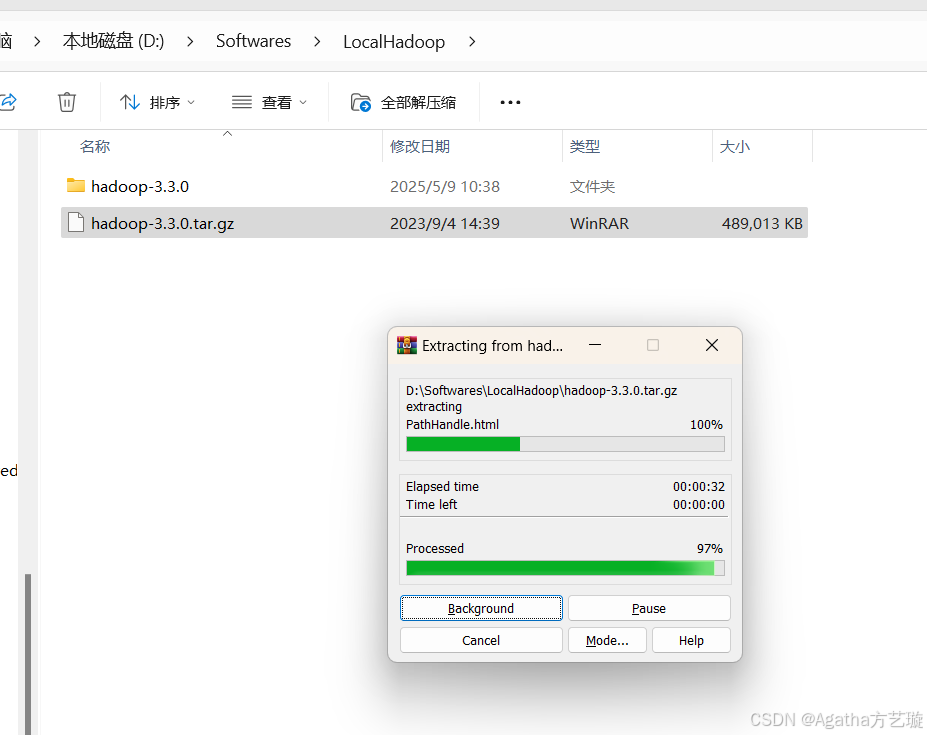
1、在电脑里解压之前发过的Hadoop安装包
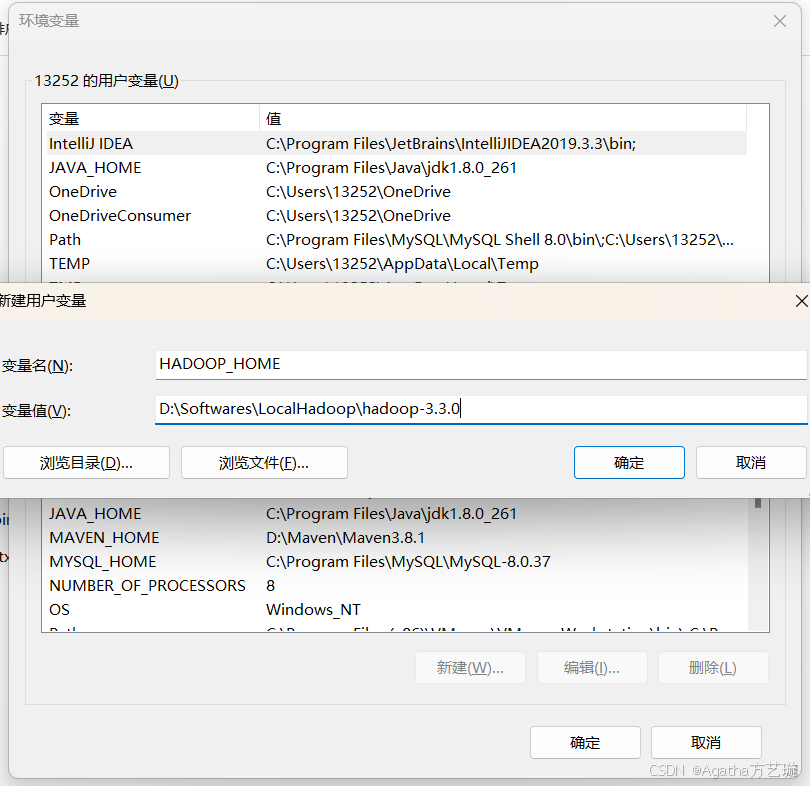
2、配置用户变量
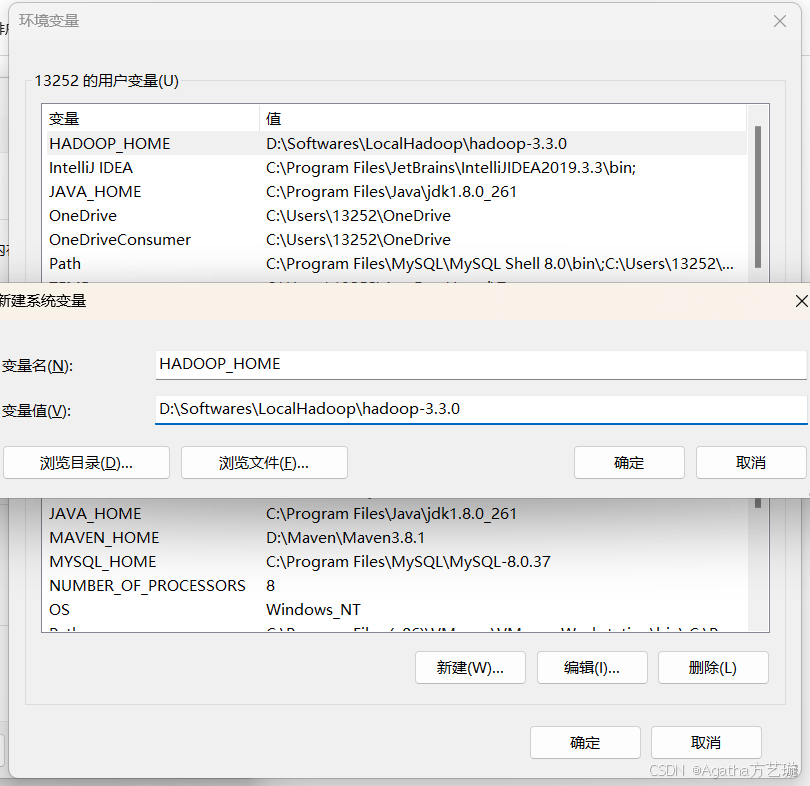
3、配置系统变量
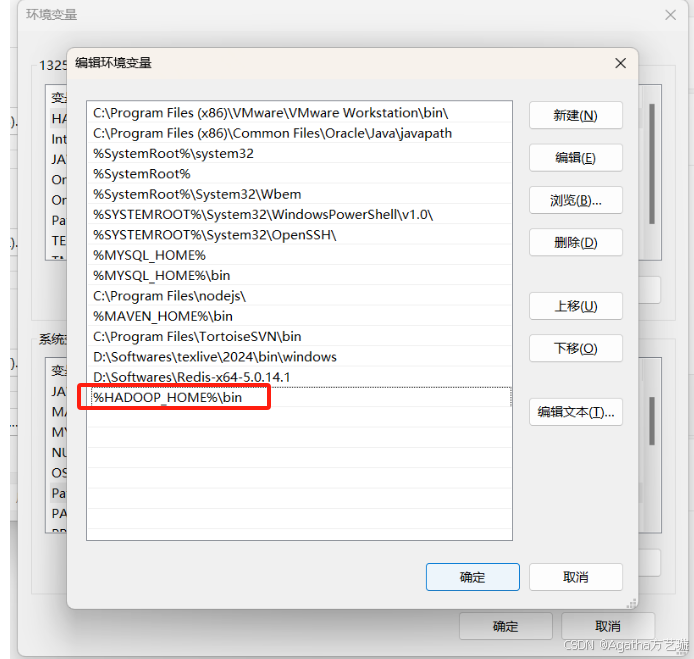
4、配置系统Path变量
5、下载链接的两个文件:

链接: https://pan.baidu.com/s/1aCcpGGR1EE4hEZW624rFmQ?pwd=56tv 提取码: 56tv

--来自百度网盘超级会员v7的分享

6、放到刚刚解压路径的bin文件夹里
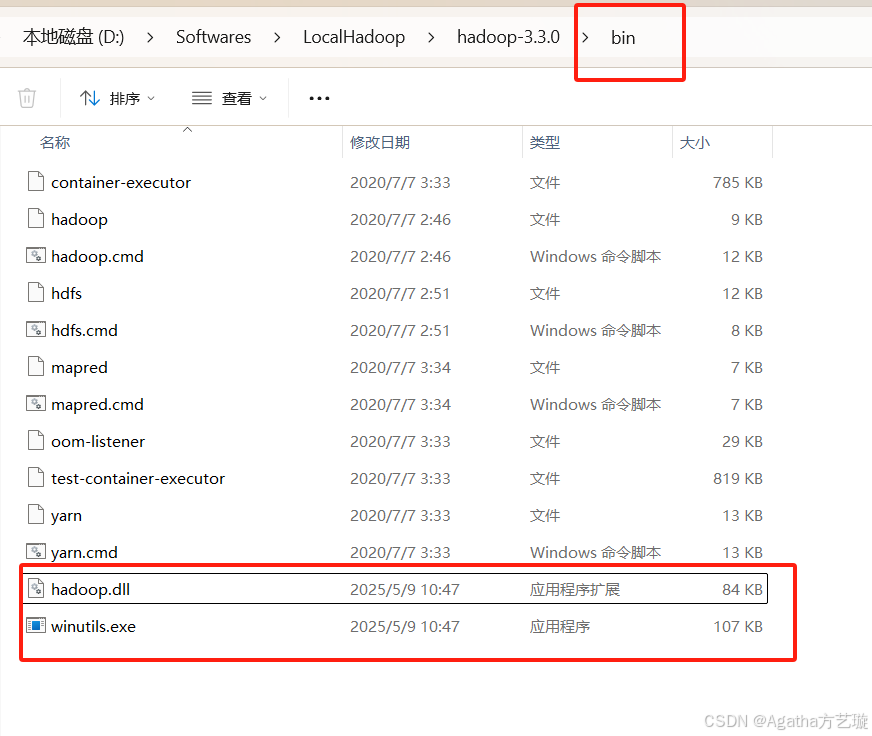
7、再把hadoop.dll复制一份放C:Windows\System32里

8、重启idea

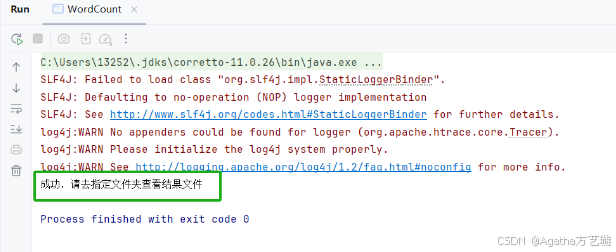
9、再运行代码就可以了
相关推荐
Leo.yuan3 小时前
2026年实时数据同步工具怎么选?GoldenGate、Striim、SeaTunnel、FineDataLink 5.0横评
大数据
sm_926787053 小时前
RFID 标签打印的技术实现要点与二次开发实践
java·大数据·前端·c++·编辑器
龙亘川3 小时前
AI 协同赋能城市治理:支撑政协数字化履职的技术路径探析
大数据·人工智能·智慧城市·开源软件·数据可视化
逸模3 小时前
BIM在连锁餐饮装修中的应用:不只是画三维图
大数据·数据库·人工智能·物联网·建模
liliangcsdn4 小时前
Deepseek R1与V4 Pro参数量对比
大数据
爱吃火鸡面呀4 小时前
DataX 实战:使用 HDFS Reader 读取 Hive ORC 表并输出到 Stream
hive·hadoop·hdfs
不开大的凯20774 小时前
AI权力游戏:同一天,两种答案,一场算力暗战
大数据·人工智能·ai·ai office
AI行业应用研究5 小时前
会务信息载体的演进:纸质、PDF 与结构化数据源的分发成本与版本一致性
大数据·人工智能·安全·小程序·架构·pdf
yumgpkpm5 小时前
CDP 7.3.1(Cloudera Runtime 7.3.1)VS Acceldata ODP 3.3.6.4 核心引擎详细版本对比
大数据·hive·hadoop·postgresql·zookeeper·spark·hbase