chroma 一步步使用
安装
bash
# 安装chromadb
pip install chromadb,sentence_transformers

# 不启动服务会出现sock.connect(sa)TimeoutError: timed out
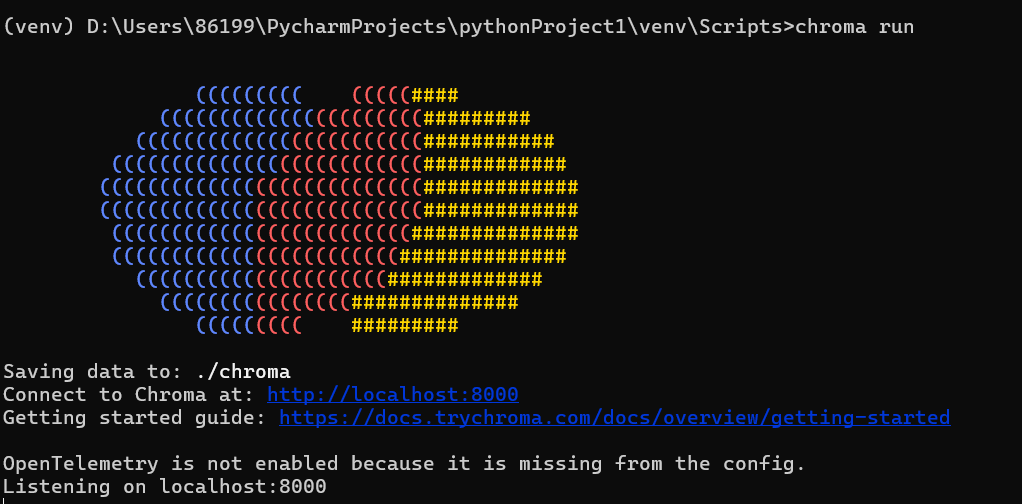
chroma run
服务启动后,您将看到类似以下输出:
建立连接
部署完成后,需要建立与Chroma服务的连接:
python
import chromadb

# 创建了临时客户端。程序终止时,您提取的任何数据都会丢失
client = chromadb.Client()
创建向量集合
chroma连接若直接创建集合("Collection"(集合)是存储向量的基本单位,类似于关系型数据库中的表),会使用内置的嵌入模型all-MiniLM-L6-v2。
python
# 首先导入embedding模型
from chromadb.utils import embedding_functions


collection = chroma_client.create_collection(name="my_collection")
collection.add(
    documents=[
        "关于深度学习技术的文档",
        "关于的爱情小说文档"
    ],
    ids=["id1", "id2"]
)
print(collection)
chroma默认使用欧氏距离计算向量相似度
查询文档
Chroma提供多种查询方式,满足不同场景需求:
1. 基于ID查询
当你知道确切的文档ID时,可以直接查询:
python
# 根据ID获取文档
result = collection.get(
    ids=["id1"]
)
2. 语义向量检索
RAG系统的核心功能是语义检索,基于查询与文档的语义相似度:
python
# 语义检索
# Chroma 默认会返回 10 条结果。这里我们只添加了 2 个文档,因此我们设置n_results=2
results = collection.query(
    query_texts=["如何使用向量数据库?"],
    n_results=2
)
print(results)
工程中优化
混合检索
Chroma还支持将全文匹配与向量检索结合:
python
# 全文匹配 + 向量检索
results = collection.query(
    query_texts=["检索技术的应用"],
    n_results=2,
    where_document={"$contains": "检索"},  # 文档必须包含"检索"一词
    include=["documents", "metadatas"]
)
Chroma支持将向量检索与元数据过滤结合,实现更精准的查询:
python
# 元数据过滤 + 向量检索
results = collection.query(
    query_texts=["大语言模型的应用"],
    n_results=2,
    where={"topic": "llm"},  # 仅检索topic为llm的文档
    include=["documents", "metadatas"]
)
元数据过滤支持多种操作符:
- 相等:
{"field": value} - 不等:
{"field": {"$ne": value}} - 大于/小于:
{"field": {"$gt": value}}或{"field": {"$lt": value}} - 范围:
{"field": {"$gte": min_value, "$lte": max_value}} - 复合条件:
{"$and": [condition1, condition2]}
调参:索引与性能优化
Chroma默认使用HNSW(分层可导航小世界图)作为向量索引算法,无需手动创建索引。但你可以通过元数据调整索引参数:
python
# 创建集合时设置HNSW参数
collection = client.create_collection(
    name="optimized_collection",
    embedding_function=embedding_func,
    metadata={
        "hnsw:space": "cosine",       # 相似度度量方式
        "hnsw:M": 16,                 # 每个节点的最大连接数
        "hnsw:ef_construction": 200,  # 构建索引时的搜索宽度
        "hnsw:ef": 100                # 查询时的搜索宽度
    }
)
关键参数解释:
M:控制图的连接度,值越大精度越高但内存消耗也越大ef_construction:影响索引质量,值越大精度越高但构建速度越慢ef:影响查询精度和速度,值越大召回率越高但查询速度越慢